
Les guides français sur l’IA en local vous préparent à une certaine échelle. Un modèle de 7 milliards de paramètres tourne sur une RTX 4060 ; un modèle de 24 milliards demande environ 48 Go de VRAM ; au-delà de 70 milliards, on parle de « cartes professionnelles ». C’est le plafond que décrivent presque tous les tutoriels. Kimi K3 le fait exploser : le modèle affiche 2 800 milliards de paramètres, soit une quarantaine de fois ce plafond de 70 milliards, et ses poids pèsent 1,56 To. Face à ce chiffre, la vraie question n’est plus « est-ce que je peux l’avoir » (les poids sont publics sur Hugging Face en ce moment même), mais « comment le faire tourner ». Voici ce que ça exige, route par route, chiffres à l’appui.
Mise à jour du 6 novembre 2026 : Moonshot a lancé Kimi K3.1 Pro le 23 octobre, une version post-entraînée de K3, et ses poids sont désormais sur Hugging Face sous moonshotai/Kimi-K3.1-Pro, sous licence maison. Nous n’avons pas vérifié les tailles de fichiers, les versions GGUF, le calcul mémoire ni la prise en charge de llama.cpp pour K3.1 Pro : rien dans ce guide n’est donc vérifié pour ce modèle. Tout ce qui suit concerne K3.
Petit avertissement en préambule, parce qu’il donne le ton. Le lendemain de la publication des poids par Moonshot, nous avons demandé à trois assistants comment faire tourner K3. Le 28 juillet 2026, recherche web coupée, Claude Opus 4.8 a répondu qu’il n’avait aucune information fiable sur l’existence d’un modèle nommé Kimi K3 et proposait de l’aide sur K2. Gemini 2.5 Flash a fait l’inverse : il insistait sur le fait que K3 était propriétaire, disponible uniquement dans le cloud, et que « la taille du téléchargement n’a pas d’importance puisque vous ne téléchargez pas les poids ». Seul ChatGPT, recherche activée, a répondu correctement. On y reviendra à la fin, car c’est le même mécanisme qui décide de ce que l’IA raconte sur votre produit.
Ce qu’il faut retenir
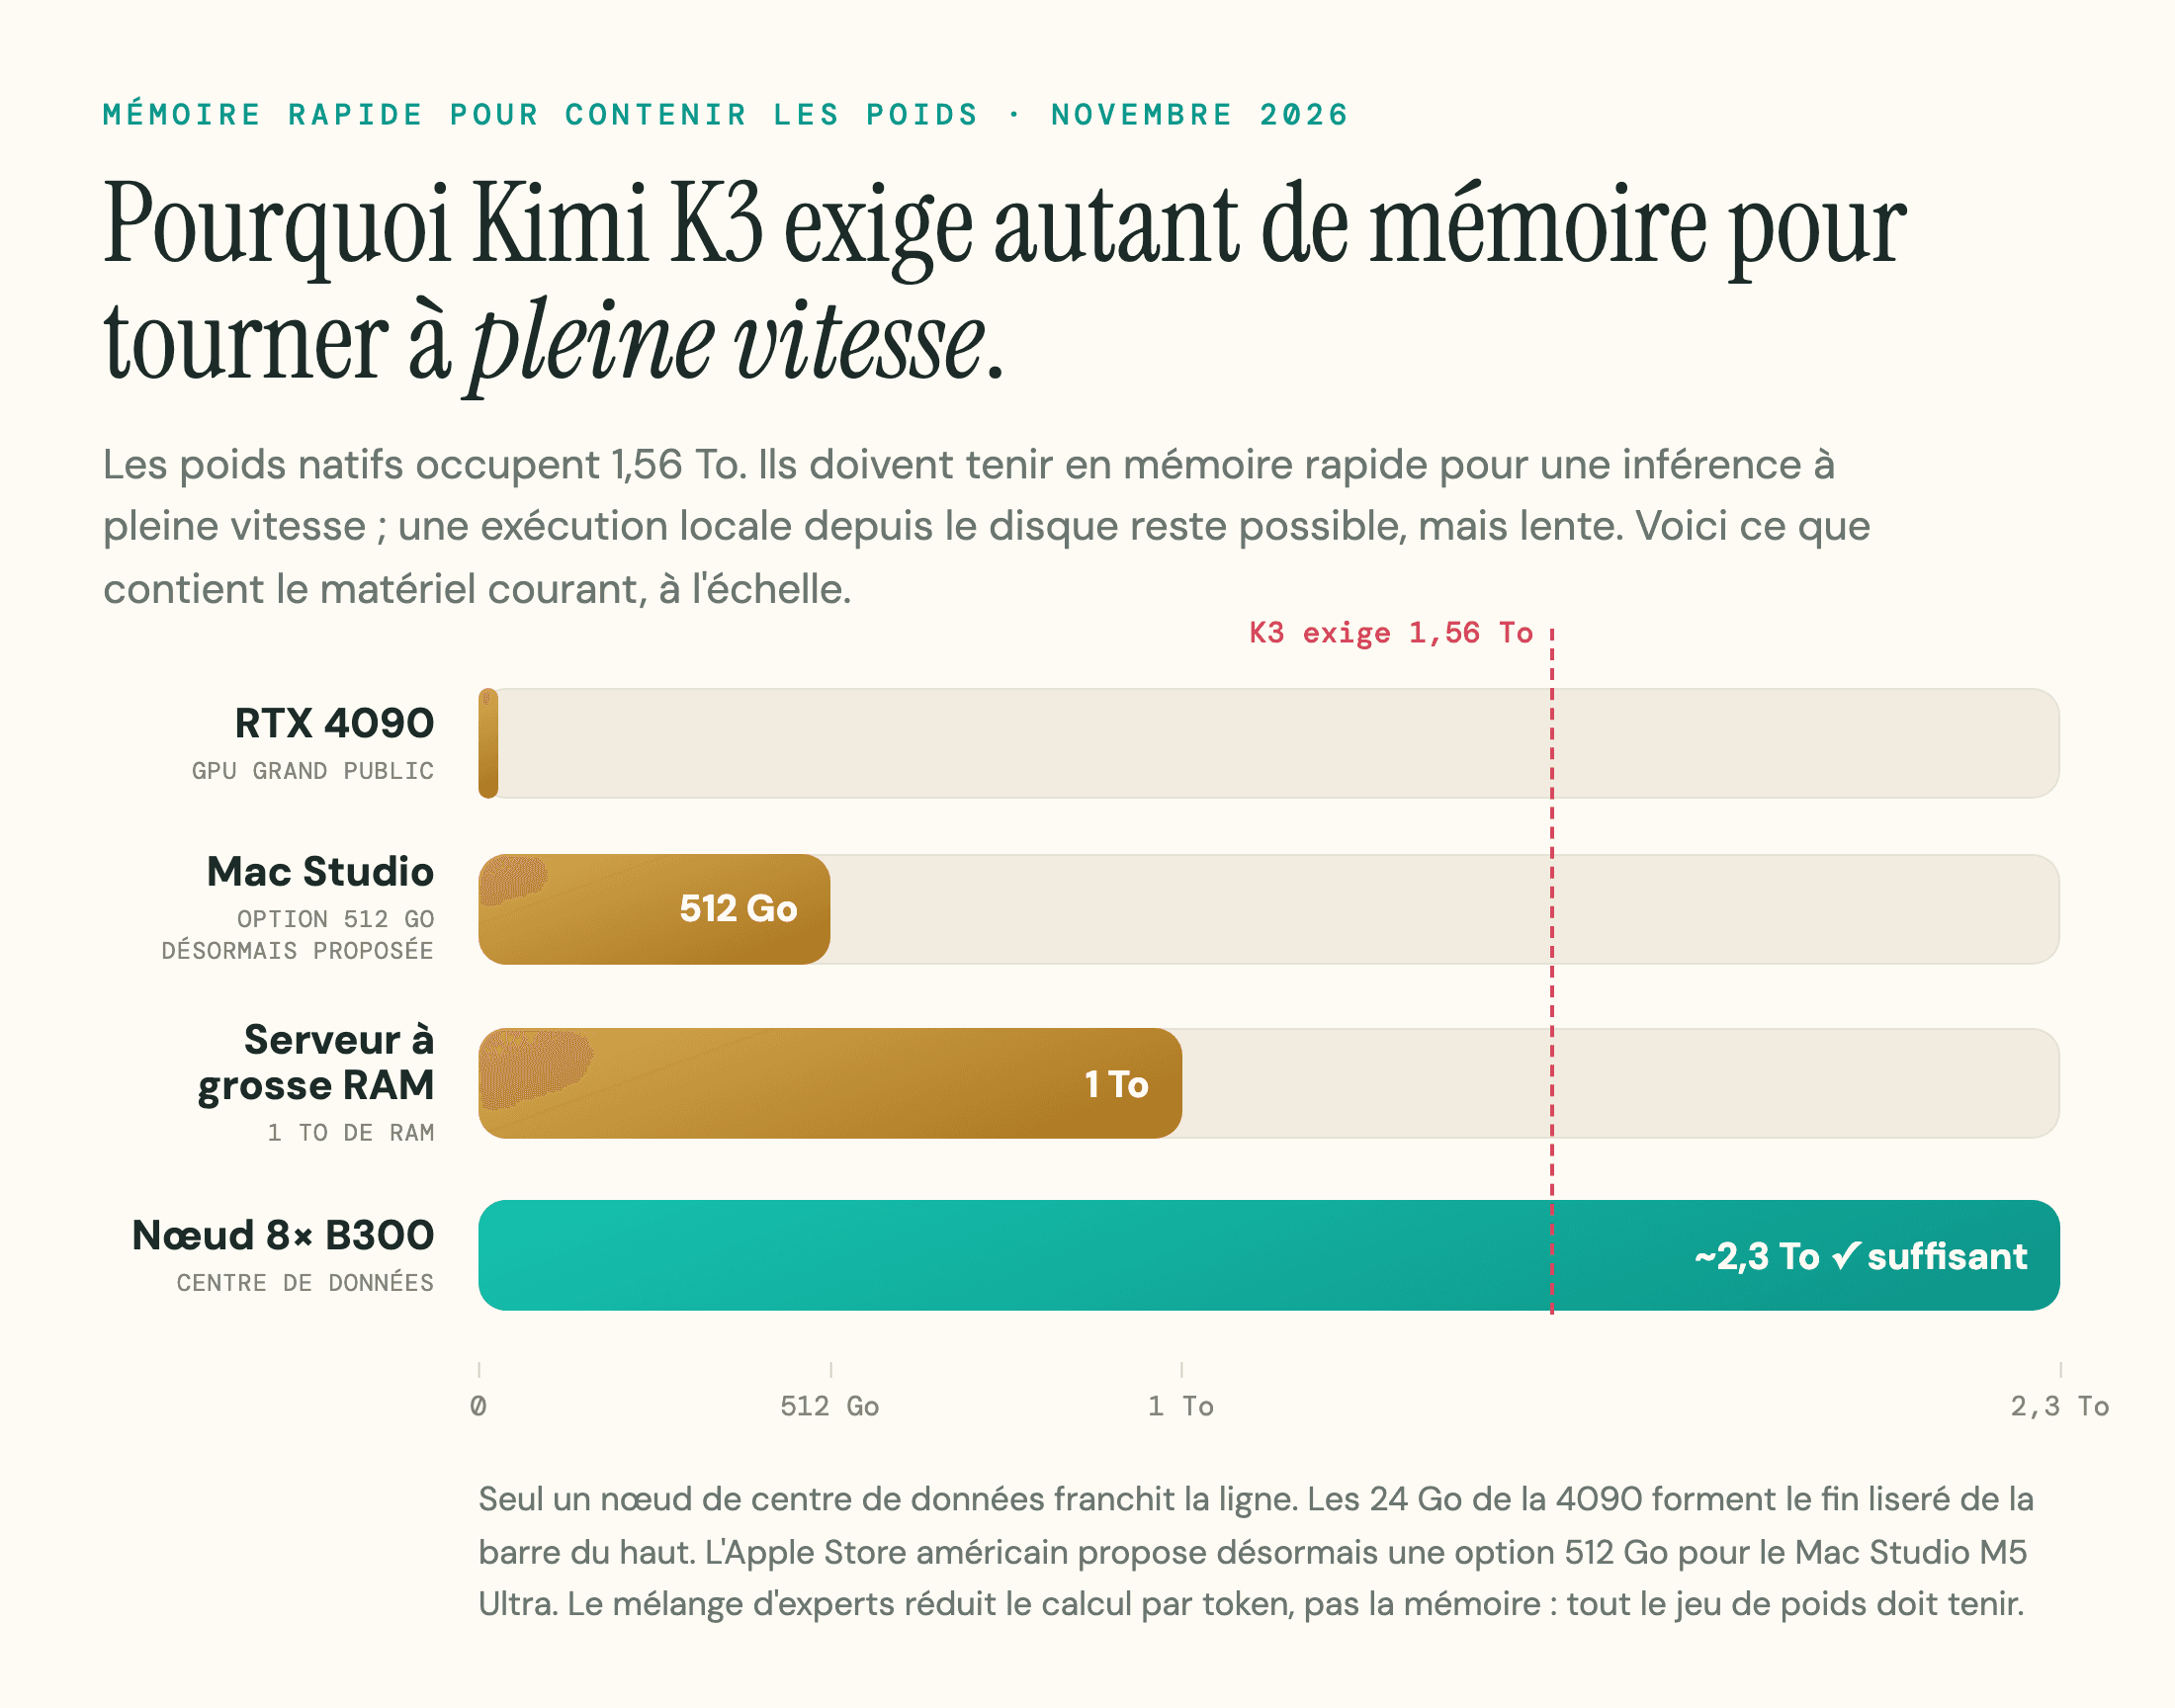
- Non, on ne fait pas tourner Kimi K3 sur une machine normale : ses 2 800 milliards de paramètres pèsent 1,56 To de poids, plus que la mémoire rapide de n’importe quel poste de travail, PC de jeu ou Mac pris seul.
- Il existe cinq routes, du simple appel à un fournisseur (la bonne réponse pour presque tout le monde, environ 3 $ / 15 $ le million de tokens pour K3) jusqu’à l’achat d’un rack à plusieurs centaines de milliers d’euros.
- La seule voie à pleine vitesse est de servir le modèle vous-même avec vLLM ou SGLang sur un nœud 8 GPU B300 (ou 16 B200), que le nœud soit acheté ou loué à l’heure. En France, Scaleway présente un tel nœud (2,3 To de VRAM, région Paris) ; disponibilité et tarif sont à confirmer chez eux.
- Au tarif électrique français (0,2001 €/kWh au 1er août 2026, au-dessus du tarif américain), l’auto-hébergement revient encore plus cher qu’aux États-Unis : entre 130 et 350 € le million de tokens en électricité seule sur une machine lente.
- La seule vraie raison de s’auto-héberger reste la résidence des données : des données sensibles que vous ne pouvez pas confier à un cloud américain, à cause du CLOUD Act. En dehors de ce cas, l’API est moins chère et plus rapide.
La réponse courte : peut-on faire tourner Kimi K3 en local ?
Pas sur une machine normale. Kimi K3, le plus grand modèle à poids ouverts jamais publié, est un modèle de 2 800 milliards de paramètres, et ses poids se téléchargent sous forme de 1,56 To répartis sur 96 fragments. Les faire tourner à pleine vitesse demande plus de mémoire rapide que n’en contient le moindre poste de travail, PC de jeu ou Mac. Moonshot recommande un déploiement de production sur un supernode d’au moins 64 accélérateurs, soit huit nœuds de 8 GPU ou plus, sans jamais avoir publié de configuration minimale viable.
Mais le « local » recouvre tout un éventail de configurations, depuis le simple fait de pointer votre éditeur vers un point d’accès hébergé jusqu’à l’achat d’un rack entier. La bonne question est de savoir laquelle de ces routes correspond à votre vraie contrainte : la confidentialité, le coût, la vitesse ou la curiosité.
| Route | Ce qu’il faut | Vitesse réaliste | Coût approximatif | Pour qui |
|---|---|---|---|---|
| 5. Passer par un fournisseur | Rien, une clé d’API | env. 29 à 465 tok/s selon l’hôte | K3 à 3 $ en entrée / 15 $ en sortie le million de tokens (K3.1 Pro : 2 $ / 10 $) | Presque tout le monde |
| 1. Louer un nœud capable | 8× B300 ou 16× B200, à l’heure | Comme la Route 2 | env. 70 à 160 $ de l’heure | Tester, jobs courts |
| 2. S’auto-héberger sur vLLM | Un nœud 8× B300 (ou 16× B200) | 111 tok/s en TP8, 331 avec décodage spéculatif (vLLM, mesuré sur GB300 NVL72) | Capex datacenter ou cloud | Structures avec une vraie infra GPU |
| 3. Déchargement CPU + RAM | Serveur à grosse RAM + 1 à 4 GPU | env. 10 tok/s en décodage, prefill lent | env. 5 000 à 65 000 € en une fois | Homelab, traitement de nuit |
| 4. Cluster de Mac Studio | 4 à 5× Mac Studio M5 Ultra 512 Go | env. 15 tok/s par analogie, non mesuré | env. 89 000 à 111 000 $ (4 à 5 × 22 299 $, prix catalogue Apple US au 1er novembre 2026) | Expériences en mémoire unifiée |
Les vitesses des lignes auto-hébergées sont le plafond atteignable sur le bon matériel ; une première installation restera en dessous. La plupart des gens devraient se rabattre sur un fournisseur (Route 5), ou sur un nœud loué (Route 1) pour tester d’abord. Le reste de ce guide explique pourquoi, et ce que coûtent les autres.
Pourquoi il faut autant de mémoire : le calcul
Le nombre qui décide de tout, c’est 1,56 To, la taille du dépôt Kimi K3 sur Hugging Face, réparti sur 96 fragments de poids. Un chiffre plus petit, autour de 594 Go, circule dans une partie des articles publiés au lancement. Ce n’est pas le modèle complet, c’est la taille de la quantification GGUF 1-bit d’Unsloth, et son dépôt en liste désormais de plus petites encore (UD-Q1_0 à 466 Go, UD-TQ1_0 à 509 Go, UD-TQ2_0 à 552 Go ; sa documentation recommande la version de 594 Go et ne publie aucun chiffre de précision pour les plus petites). L’arithmétique sur les poids complets écarte la pleine fidélité à ces tailles : 594 Go impliqueraient environ 1 200 milliards de paramètres en 4 bits, or K3 en compte 2 800 milliards, donc la route des poids officiels exige toujours de budgéter 1,56 To.
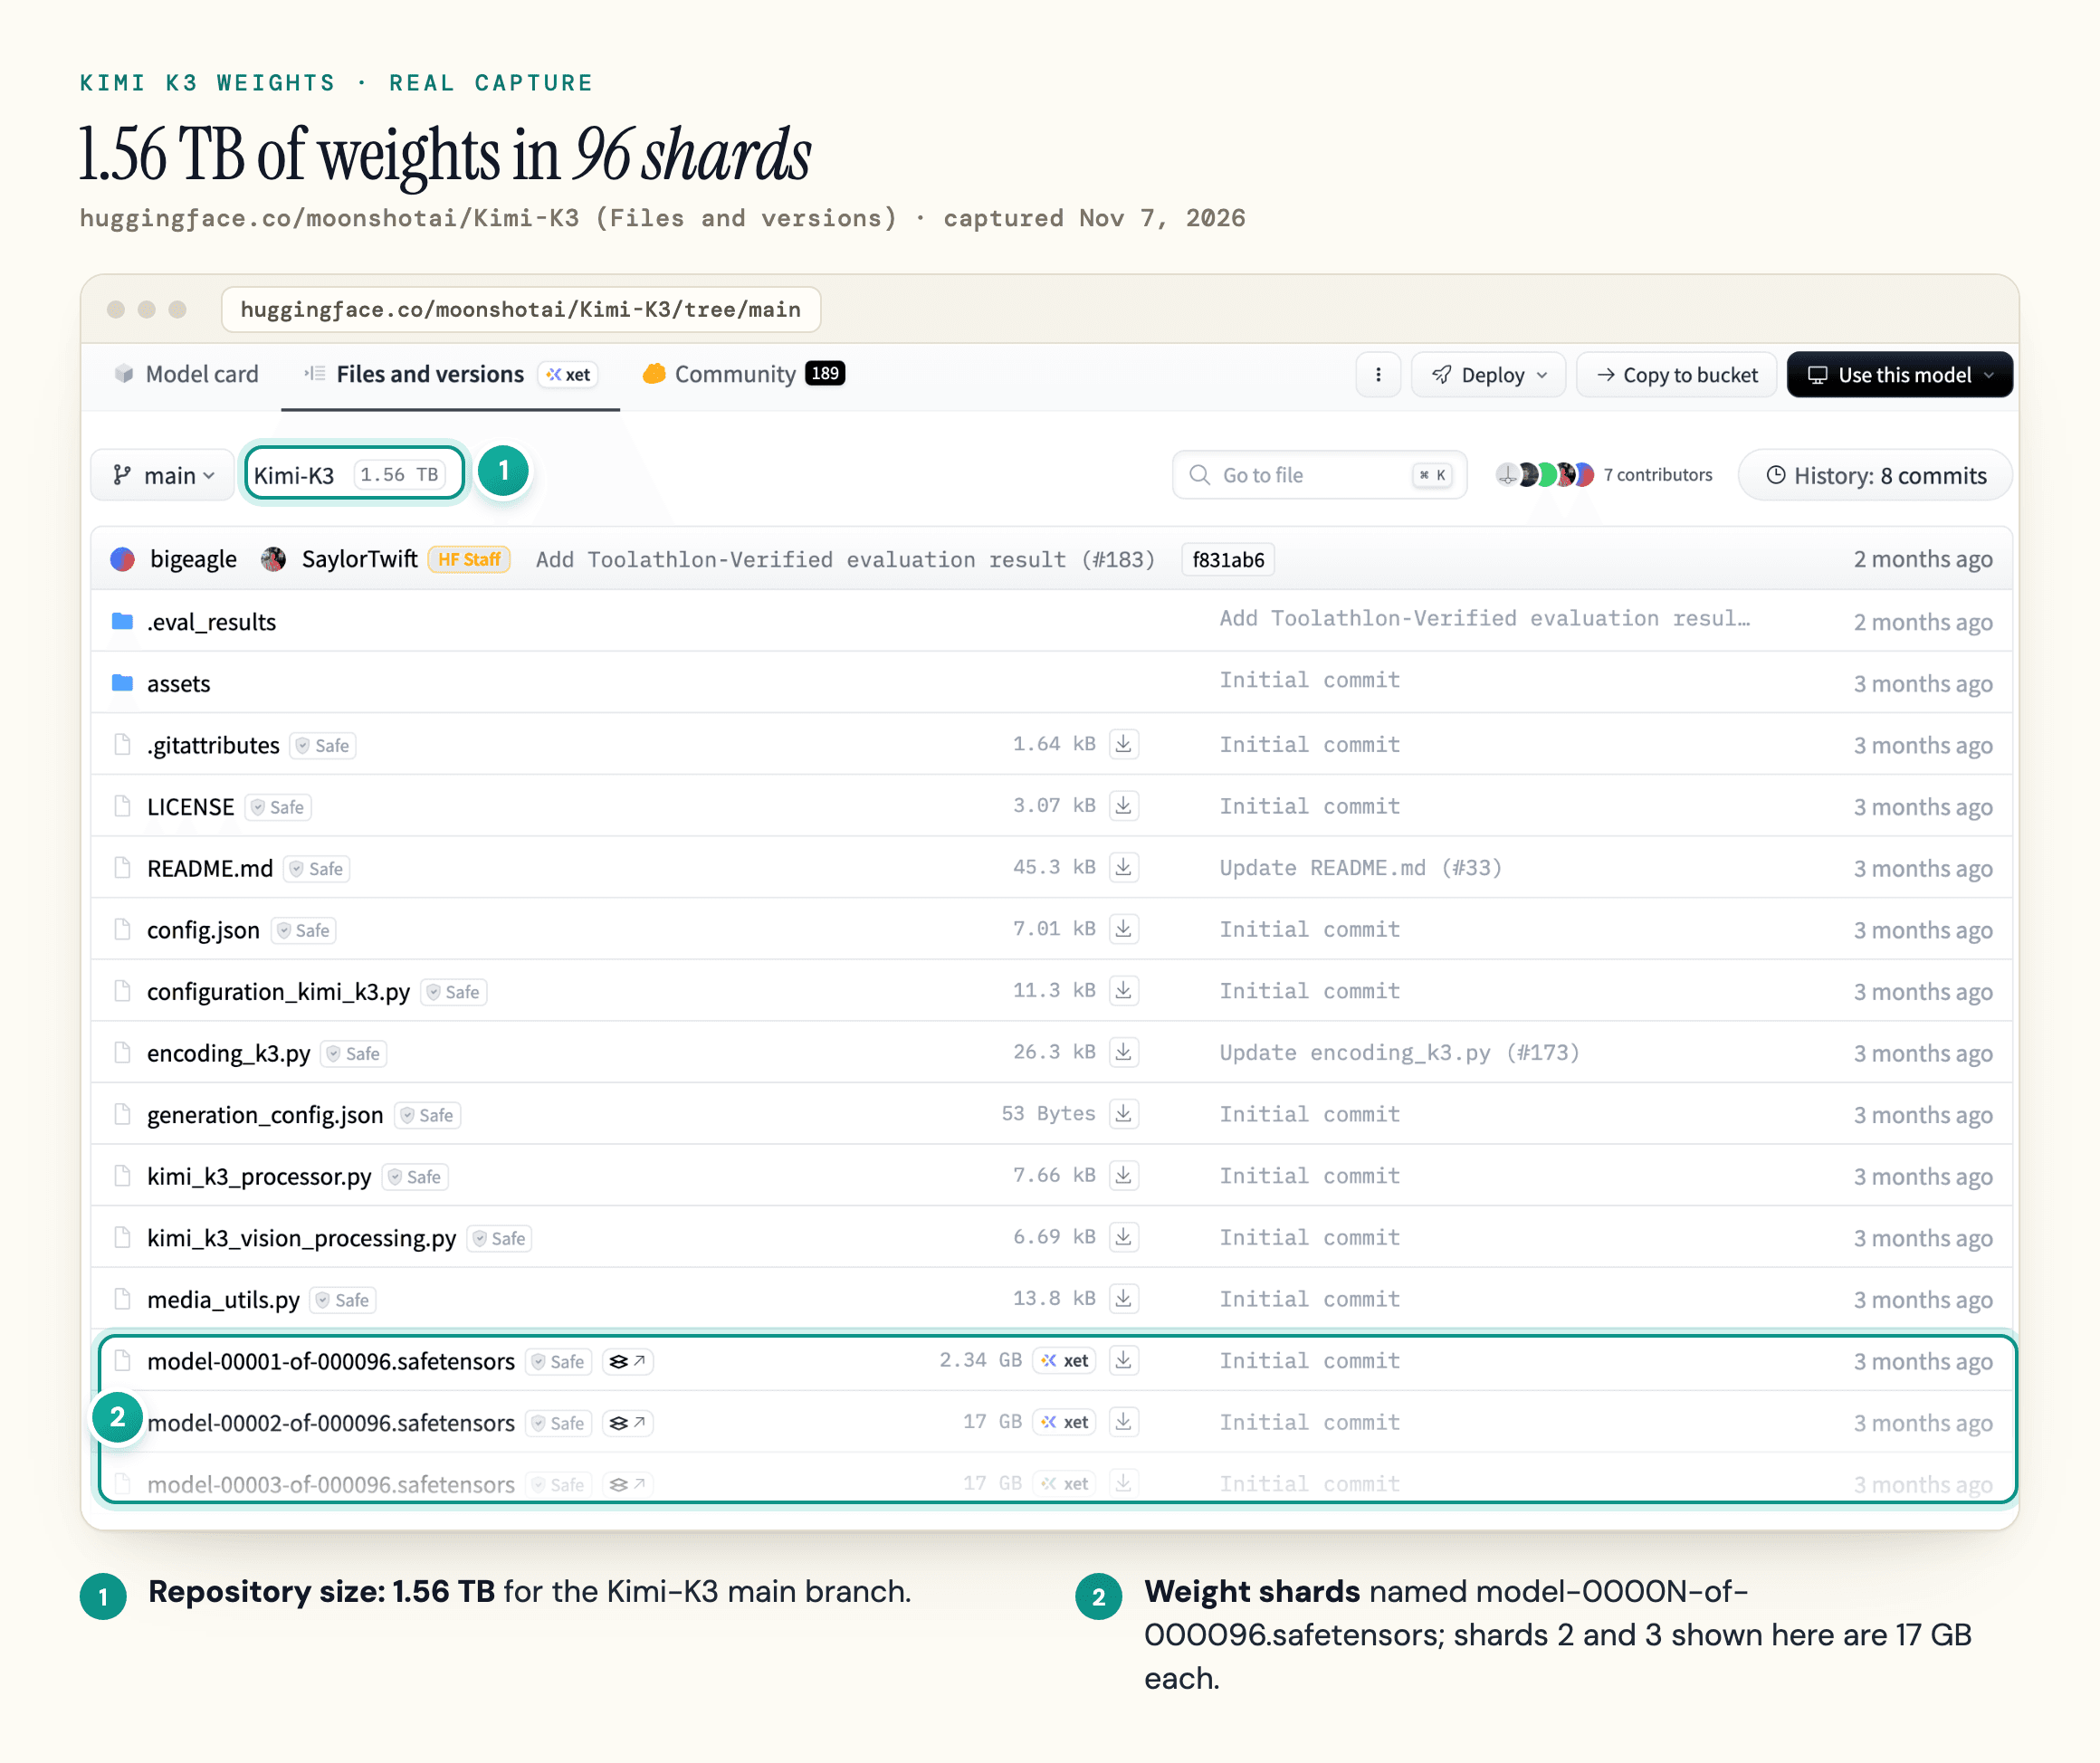
Le calcul naïf donne 2 800 milliards de paramètres × 4 bits, soit 1,4 To. Le dépôt réel pèse 1,56 To parce que le format MXFP4 stocke un facteur d’échelle partagé par bloc et que les couches hors experts dépassent les 4 bits. Comptez donc 1,56 To résidents rien que pour les poids, et 1,8 à 2 To une fois ajoutés le cache KV et les tampons de calcul. C’est le mur, et il ne rétrécit pas. Comme K3 est entraîné avec quantification intégrée en 4 bits (avec des activations MXFP8 en 8 bits), il n’y a pas de division gratuite par deux à espérer du passage habituel de 16 à 4 bits : une version 8 bits n’est pas plus petite que ce qui a été publié (la version Q8 sans perte d’Unsloth pèse les mêmes 1,56 To).
La conception en mélange d’experts est le second piège. K3 n’active que 16 de ses 896 experts routés (plus 2 experts partagés) par token, si bien qu’il calcule comme un modèle bien plus petit. Cela économise du calcul, pas de la mémoire. L’ensemble des poids doit rester résident, car n’importe quel token peut être routé vers n’importe quel expert. Un modèle creux allège la passe avant, mais l’empreinte mémoire, elle, ne bouge pas. Peu de guides francophones le disent clairement, et c’est pourtant ce mécanisme qui rend l’échelle de K3 compréhensible.
Vient ensuite la fenêtre de contexte. À 1 048 576 tokens, un contexte rempli ajoute une vraie pression mémoire au-dessus des poids. Le Kimi Delta Attention, la conception hybride qu’utilise K3, garde un état de taille constante sur la plupart des couches et adoucit ce coût, mais un job à long contexte exige quand même de prévoir une marge.
Un dernier point avant de construire quoi que ce soit : K3 est publié sous une licence Kimi K3 maison, qui autorise l’usage commercial mais n’est pas open source au sens de l’OSI. C’est un modèle à poids ouverts (open weights), ce qui n’est pas la même chose. Un opérateur qui propose le modèle en service (MaaS) et dont le chiffre d’affaires dépasse 20 millions de dollars sur douze mois glissants doit négocier un accord séparé avec Moonshot, et tout produit au-dessus de 100 millions d’utilisateurs mensuels ou de 20 millions de dollars de revenus mensuels doit afficher « Kimi K3 » dans son interface. Pour une équipe qui s’auto-héberge afin de servir des clients, ce n’est pas une anecdote, c’est un feu vert ou un feu rouge.
Route 1 : louer un nœud capable (essayer avant d’acheter)
Avant de dépenser un euro en matériel, louez le modèle pour une heure. C’est la route vers laquelle se tourne d’abord la communauté de l’inférence locale : au lancement, avant l’arrivée des fournisseurs tiers, plusieurs rapports faisaient état d’un point d’accès K3 hébergé par Moonshot qui limitait le débit en pleine tâche, si bien que la location était le moyen fiable d’évaluer le modèle avant de s’engager dans une machine.
Le piège, c’est ce que vous louez. Une machine 8× H100 (RunPod affiche un H100 SXM à 3,99 $ par GPU-heure, soit environ 32 $ pour huit) est la configuration par défaut vers laquelle les gens se tournent, mais 8× H100 totalisent 640 Go, une capacité insuffisante pour charger un modèle de 1,56 To dans l’un des formats de précision recommandés dans ce guide. Il vous faut le même plancher que la Route 2, un nœud 8× B300 ou 16× B200 : aux 8,99 $ par B300-heure et 7,99 $ par B200-heure affichés par RunPod, cela fait environ 72 $ et 128 $ de l’heure, et le plan 16 GPU B200 de Lambda (engagement de deux semaines minimum) affiche 9,86 $ par GPU-heure. Vous payez l’heure, pas les tokens, ce qui explique justement pourquoi cette route sert à mesurer plutôt qu’à produire.
L'équivalent souverain de la Route 1, en France
Un point que les guides américains n’abordent pas : où louer, quand vos données ne peuvent pas transiter par un cloud américain. Scaleway présente un nœud unique 8× B300 (2,3 To de VRAM, région Paris PAR-2, facturation à l’usage), qui franchit le plancher de 1,56 To et correspond exactement à la configuration de démarrage de vLLM. C’est l’équivalent européen et souverain des Routes 1 et 2. OVHcloud plafonne pour sa part à 8× H200 (1,1 To par instance, à Gravelines) : cela ne suffit pas à lui seul, il faudrait agréger plusieurs nœuds. Autrement dit, un nœud K3 capable est annoncé sur le sol français, mais chez un seul des deux grands fournisseurs (disponibilité et tarif à confirmer).
Chargez votre vrai cas d’usage, pas un exemple de démonstration. Testez sur le nœud loué votre longueur de contexte et votre nombre réel de requêtes simultanées, mesurez le débit et le temps jusqu’au premier token, puis décidez si posséder du matériel a du sens. Une heure de location coûte moins cher qu’une mauvaise machine. Si vous voulez seulement K3 dans votre éditeur, un fournisseur revient encore moins cher.
Route 2 : l’auto-héberger avec vLLM
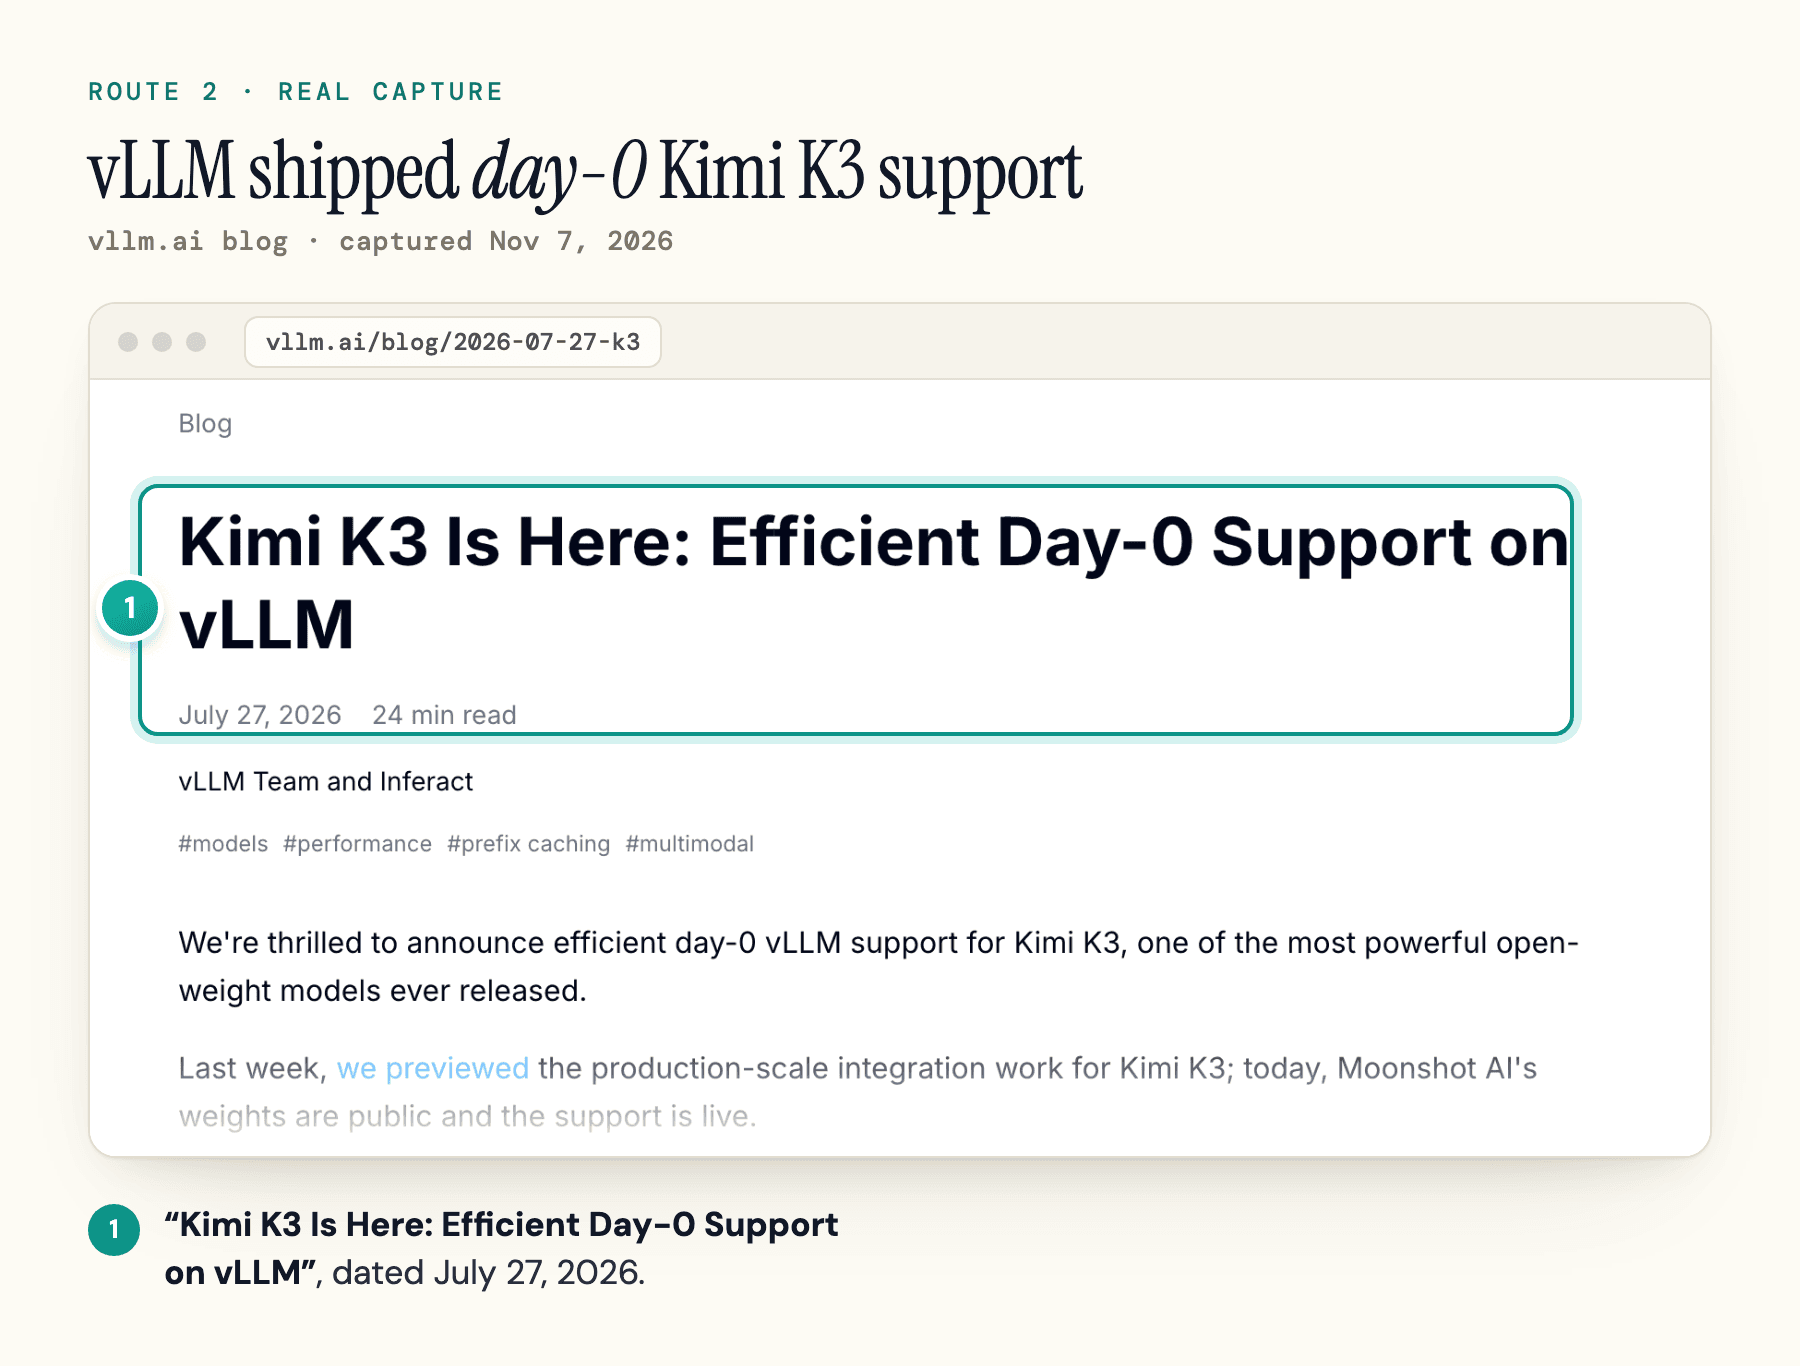
C’est la route pour laquelle Moonshot a conçu K3, et la seule qui atteint la pleine vitesse. vLLM a livré une prise en charge dès le jour zéro et propose la documentation la plus complète, mais ce n’est pas la seule voie : SGLang a livré sa propre prise en charge le même jour, le 27 juillet 2026, et Moonshot cite officiellement vLLM, SGLang et TokenSpeed. La pile de service est le moindre de vos soucis. Le matériel, non.
Le supernode de 64 accélérateurs de Moonshot est une recommandation de production ; la configuration minimale qui fait juste tenir les poids est différente. D’après l’équipe vLLM, la configuration minimale est un nœud 8× B300 (ou un GB300 NVL72), ou un minimum de 16× B200 ou GB200 sur la génération précédente, et le MI355X d’AMD embarque la prise en charge ROCm dès son lancement si vous n’êtes pas sur NVIDIA. Leur propre note est sans détour : le modèle « tient à peine dans un seul NVIDIA DGX B300 ». Aucun H100, H200 ni B200 seul ne le contient, donc tout déploiement réel est un cluster distribué, et l’interconnexion compte autant que les cartes. Le parallélisme tensoriel sur une interconnexion lente est une régression, pas une amélioration : sans RDMA à haute bande passante entre les nœuds, les échanges all-to-all se bloquent et le traitement des prompts s’effondre. Sur un GB300 NVL72, vLLM a mesuré 111 tokens par seconde et par utilisateur en parallélisme tensoriel de taille 8 (331 avec le décodage spéculatif DSpark), et 118 en TP16, montant à 370 avec DSpark.
La commande de service compte, car K3 a besoin de drapeaux que la plupart des guides de lancement oublient :
vllm serve moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-prefix-caching \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Quelques-uns sont faciles à manquer. Réglez --max-model-len bien en dessous du contexte complet d’un million (131072 est un bon point de départ ; augmentez-le une fois la marge du cache KV mesurée), sinon le serveur tente d’allouer le cache pour tout le contexte et sature la mémoire au premier lancement. --load-format fastsafetensors réclame l’installation séparée du paquet fastsafetensors. Le cache de préfixe est désactivé par défaut pour K3, car la conception du cache hybride se stabilise encore : passez le drapeau pour l’économie au prefill, mais validez la sortie sur des préfixes répétés avant de vous y fier en production. Les analyseurs kimi_k3 sont obligatoires pour l’usage d’outils et le raisonnement toujours actif de K3, et comme le gabarit de conversation est un programme Python plutôt qu’un fichier Jinja, faire confiance au code distant n’est pas optionnel. Un piège silencieux que les drapeaux ne couvrent pas : pour les conversations multi-tours, vous devez repasser l’intégralité du reasoning_content à chaque requête, sinon la qualité se dégrade au fil de l’échange sans la moindre erreur.
Les étapes réalistes :
- Provisionnez le cluster (8× B300 au minimum, ou 16× B200) avec une interconnexion RDMA rapide entre les nœuds.
- Récupérez l’image conteneur officielle de vLLM ; la chaîne de dépendances tire des bibliothèques en préversion comme FlashInfer, si bien que les installations sur machine nue sont pénibles.
- Téléchargez les poids depuis le dépôt officiel de Moonshot uniquement. Anticipez : 1,56 To sur 96 fragments, c’est plusieurs heures sur une ligne rapide et presque une journée sur une connexion domestique, il faut un disque de préparation distinct de celui d’exécution, et c’est aussi un prérequis pour la route homelab.
- Servez avec la commande ci-dessus, en démarrant bien en dessous du contexte de 1 million.
- Testez la charge avec votre niveau réel de requêtes simultanées avant d’y diriger du trafic de production.
Route 3 : décharger sur le CPU et la RAM (la voie homelab)
Si vous ne pouvez pas mettre 1,56 To en VRAM, vous pouvez en mettre l’essentiel en RAM système. C’est le schéma homelab : un serveur à grosse mémoire, environ 1 à 1,5 To de RAM DDR et un à quatre GPU, en gardant les couches de routage et d’attention plus le cache KV sur le GPU et en déchargeant les experts routés vers la RAM système. Le moteur pour ça, c’est llama.cpp en version mainline (prise en charge de K3 fusionnée le 15 août 2026) avec ses drapeaux de déchargement d’experts (-cmoe pour garder les experts sur le CPU, --no-mmap pour un meilleur débit au prix d’un chargement bien plus long). Les estimations de la communauté placent le décodage de K3 dans ce schéma autour de 10 tokens par seconde, ce qui semble utilisable.
Ça ne l’est pas pour du travail interactif, et la raison, c’est le prefill. Générer des tokens à 10 par seconde, ça passe ; traiter votre prompt, c’est là que ces machines s’effondrent. À environ 1 token par seconde de traitement de prompt, un contexte de 20 000 tokens prend près de six heures avant que le modèle réponde. Les jobs de nuit y survivent. Une boucle d’agent qui relit un grand contexte à chaque étape, non.
Le point de repère le plus clair vient de deltafin, une expérience open source qui lit les experts de K3 depuis le disque local à la demande sur un Apple M1 Max. La leçon tient dans le budget par token que publie l’auteur : le dépôt affiche aujourd’hui environ 3,4 secondes par token (0,29 tok/s). C’est une expérience qui évolue vite : profilez le chemin des entrées-sorties avant d’acheter un GPU plus rapide, car sur ce type de montage, l’essentiel du temps par token part à déplacer les poids hors du disque et à les décompresser ; le calcul lui-même est presque gratuit à côté.
Deux autres chiffres cadrent les attentes. La version 2-bit d’Unsloth pèse environ 861 Go, donc avec le cache KV et les tampons, il vous faut au moins 1 To de RAM pour tenter le coup. Et le vrai plafond, c’est la bande passante mémoire, qui plafonne le débit bien avant le nombre de cœurs ou la capacité : des assembleurs rapportent des machines à RAM identique qui diffèrent d’un facteur 3 sur le débit. Dimensionnez la plateforme sur ses canaux mémoire ; privilégiez un EPYC ou un Xeon avec assez de CCD et de cache L3 pour saturer le contrôleur et avec la prise en charge d’AVX-512, et évitez les pénalités NUMA du bi-socket là où un seul socket suffira.
Le mur électrique, version française
Une contrainte que les guides américains passent sous silence, et qui n’est pas qu’une question de facture. À 2 à 10 kW en continu selon la configuration, une telle machine tire environ 9 à 43 A en monophasé 230 V, et peut atteindre ou dépasser une puissance souscrite domestique standard de 6 ou 9 kVA. Il faut alors passer à au moins 12 kVA, souvent en triphasé, avec une intervention Enedis, un abonnement plus élevé et probablement un passage du Consuel. Côté coût, le tarif réglementé (Tarif Bleu d’EDF) est à 0,2001 €/kWh TTC au 1er août 2026 (option Base, 6 kVA, délibération CRE 2026-147), soit environ 0,22 $, au-dessus de la fourchette américaine de 0,10 à 0,15 $. En clair : en France, faire tourner K3 chez soi coûte encore plus cher en électricité qu’aux États-Unis.
Si votre besoin réel est une IA en local souveraine, et non ce modèle géant précis, le bon outil n’est probablement pas K3. Un petit modèle Mistral, du même écosystème que Vibe (ex-Le Chat) de Mistral, tourne sur du matériel que vous possédez déjà : Mistral Small 3 (24 milliards de paramètres, licence Apache 2.0) se fait tourner en local via Ollama ou llama.cpp, avec une quantification Q4_K_M autour de 14 Go, là où K3 exige un datacenter. Notre guide pour faire tourner un LLM en local couvre l’outillage sur du matériel que vous avez déjà.
Route 4 : un cluster de Mac Studio, est-ce possible ?
Apple Silicon est le candidat évident pour un modèle gourmand en mémoire, car un Mac Studio à 512 Go de mémoire unifiée tient bien plus que le moindre GPU seul. Apple vend le Mac Studio en M5 Max ou M5 Ultra, et au 1er novembre 2026 son Apple Store américain permet de configurer un M5 Ultra à 512 Go : cette option fait passer la puce au M5 Ultra à 36 cœurs CPU et 80 cœurs GPU et chiffre cette configuration à 22 299 $ (prix catalogue Apple US). Une seule machine ne suffit de toute façon pas. Pour atteindre les quelque 2 To de mémoire agrégée que réclame K3, il faut compter quatre à cinq Mac Studio de 512 Go câblés ensemble, soit environ 89 000 à 111 000 $ à ce prix catalogue, avant taxes, câbles et réseau.
C’est là que le plan rencontre la physique, et la physique, c’est la latence, pas la bande passante des poids. Les outils de cluster comme EXO ou mlx.distributed découpent le modèle couche par couche, si bien que chaque machine garde ses propres couches et leurs experts résidents ; ce qui traverse le lien, c’est un petit vecteur d’activation à chaque frontière de pipeline, à chaque token. Thunderbolt est bien plus lent que la bande passante mémoire locale de chaque machine, et les allers-retours se sérialisent sur quatre ou cinq sauts. Ce qui coûte vraiment, ce sont les temps d’attente entre les machines, accumulés à chaque aller-retour.
Ce cluster peut-il charger le modèle ? Probablement, à condition de disposer de plus de 2 To de mémoire agrégée utilisable. Est-ce un assistant de code pratique ? Personne n’a encore publié d’exécution de K3 sur un cluster de Mac. Le point de repère le plus proche est un montage de génération précédente à deux Mac, 1 To combiné, qui rapportait environ 15 tokens par seconde sur d’autres grands modèles, plus la projection de son propriétaire d’un K3 fortement quantifié à un débit similaire avec, selon ses mots, un prefill « catastrophique ». Prenez ces 15 tokens par seconde pour une analogie, à confirmer par une vraie mesure. Pour la plupart des gens, un cluster de Mac est une expérience fascinante, pas un poste de travail.
Route 5 : passer simplement par un fournisseur
Pour l’immense majorité des cas d’usage, la façon de faire tourner Kimi K3 « en local » consiste à pointer vos outils locaux vers un point d’accès hébergé et à continuer de travailler. K3 était disponible sur OpenRouter via l’API de Moonshot depuis la mi-juillet ; dans les jours qui ont suivi la publication des poids, des fournisseurs indépendants comme Together AI et Modal l’y servaient aussi. Vous ajoutez une clé d’API à Cursor, VS Code ou vos propres scripts, et K3 répond depuis le cluster de quelqu’un d’autre. La vitesse varie beaucoup selon l’hôte : au 18 octobre 2026, Artificial Analysis recense 17 fournisseurs, d’une médiane d’environ 29 tokens par seconde (le plus lent) à environ 465 (le plus rapide), et le point d’accès de Moonshot lui-même, autour de 43 tokens par seconde, est le deuxième plus lent.
Il vaut la peine d’être précis sur ce que changent les poids ouverts, car la version qui circule l’exagère. L’argument le plus solide des discussions au moment du lancement, c’est que le gain n’est pas l’inférence sur ordinateur portable, que presque personne ne peut faire, mais l’option d’une multitude d’hôtes indépendants. Cela a fait baisser les prix des petits modèles ouverts. Sur K3, cet écart est désormais visible, comme le documente notre analyse du tarif de l’API Kimi : la plupart des 17 fournisseurs d’Artificial Analysis restent à 3 $ en entrée et 15 $ en sortie, mais au 18 octobre 2026 OpenRouter liste 15 de ses 26 points d’accès K3 avec un prix d’entrée ou de sortie plus bas, de DeepInfra à 2,85 $ et 14,25 $ jusqu’à Relace à 0,25 $ et 8,00 $, et Artificial Analysis affiche Makora à environ 1,53 $ et 12,75 $ et LithosAI à 2,40 $ et 12,00 $. Plusieurs des moins chers servent des versions fp4 ou fp8 : comparez la quantification et les conditions de routage avant de choisir un hôte. Ce que vous obtenez aujourd’hui, c’est la durabilité, puisqu’une version ne peut pas être retirée en silence, et l’option de la résidence des données pour les équipes qui en ont besoin. Pour K3, l’API de Moonshot revient à 3,00 $ le million de tokens en entrée (0,30 $ le million pour les tokens servis depuis le cache), et 15,00 $ le million en sortie. Son modèle plus récent, K3.1 Pro, est listé à 2,00 $, 0,20 $ et 10,00 $, et ses poids sont désormais sur Hugging Face, mais nous n’avons pas vérifié ce que demande son auto-hébergement.
Kimi K3 en auto-hébergement : est-ce que ça en vaut la peine ?
Pour la plupart des gens, non. Deux conditions le rendent rentable, et il vous en faut au moins une : des données que vous êtes légalement tenu de garder en interne, ou un cluster GPU déjà existant et déjà amorti. En l’absence des deux, l’économie se retourne vite contre vous.
La façon la plus claire de le voir, c’est le coût par token. Les praticiens qui font le calcul aboutissent à une fourchette de 80 à 200 $ le million de tokens en électricité seule, avant le matériel : une machine à fort déchargement qui produit des tokens lentement, de l’ordre de 1 token par seconde, en tirant 2 à 5 kW aux tarifs américains proches de 0,10 à 0,15 $ le kWh. Au tarif français d’environ 0,20 € le kWh, cette fourchette grimpe encore, vers 130 à 350 € le million de tokens. L’API de Moonshot et ses hôtes tiers se situent bien en dessous. Le chiffre exact varie avec votre charge : les jobs limités par le décodage reviennent moins cher, tandis que ceux limités par le prefill se situent dans le haut de la fourchette, mais faire tourner K3 chez soi pour économiser de l’argent revient, pour la plupart des charges, plus cher que l’API une fois compté le matériel qu’il a aussi fallu acheter.
La seule vraie raison de s'auto-héberger : la résidence des données
En dehors d’un cluster déjà amorti, le seul argument qui tienne est réglementaire, et il est plus fort en France qu’aux États-Unis. Le CLOUD Act américain de 2018 permet aux autorités des États-Unis de contraindre un fournisseur américain à donner accès aux données, même hébergées sur une instance située dans l’UE. Pour un avocat (secret professionnel), un acteur de la santé (données soumises à l’hébergement HDS), un service public ou un OIV, cela peut suffire à exclure une API grand public américaine et à imposer un traitement sur une infrastructure maîtrisée. Deux bémols, cependant. D’abord, s’auto-héberger n’est pas automatiquement « plus conforme au RGPD » qu’une API hébergée dans l’UE par un prestataire lui-même conforme : la résidence des données est un moyen, pas une case à cocher magique. Ensuite, à l’échelle de K3, cette voie souveraine repasse par un nœud de datacenter (le nœud Scaleway de la Route 1, ou une machine achetée) : le « local sur mon poste » n’existe pas pour ce modèle.
Les deux cas légitimes d’auto-hébergement sont donc étroits. Si vous disposez d’une véritable infrastructure GPU et d’une obligation de conserver les données en interne, faites tourner K3 de façon non interactive, comme un job de nuit où le mur du prefill n’a pas d’importance. Et tranchez la décision selon l’échelle avant de dimensionner quoi que ce soit : une installation par lots pour un seul utilisateur est un problème compris entre 5 000 et 65 000 € (les prix actuels de la DDR poussent les configurations réalistes à 1 To et plus vers la moitié haute), tandis que servir une équipe avec un contexte complet et de vrais accès concurrents réclame environ 3 To de mémoire répartis sur les GPU, pour les poids plus le cache KV, et se chiffre de 300 000 € à plusieurs millions.
Un budget fixe impose aussi une question plus dure que le « comment » : à capacité mémoire égale, faites-vous tourner K3 en 2 bits, une quantification punitive, ou un modèle de pointe plus petit, exploité confortablement en 4 ou 8 bits, sur la même machine ? La communauté n’a pas tranché. Un camp qualifie un K3 en 2 bits de lobotomie ; un autre soutient que ses 104 milliards de paramètres actifs devraient mieux tenir que la plupart des modèles en Q2 ; personne n’a publié de chiffres de mémoire, de vitesse et de qualité côte à côte au moment d’écrire ces lignes. Traitez-le comme une question ouverte, et si la réponse n’est pas évidemment K3, les modèles de pointe plus petits de notre classement des meilleurs LLM open source vous donneront bien plus de capacité utile par euro de matériel.
L’option patiente que la communauté ne cesse d’évoquer, c’est d’attendre. Les prix de la mémoire sont assez élevés pour que les assembleurs parlent de « RAMageddon », avec des coûts d’acquisition en entreprise en hausse de 50 à 80 % selon les estimations depuis fin 2025, certains reportant leurs machines à 2028 ou plus tard. Et une version distillée de K3, de 100 à 600 milliards de paramètres, exécutable sur bien moins de matériel, est l’issue qu’attendent beaucoup.
Foire aux questions
Quelle configuration ou quel PC pour faire tourner Kimi K3 en local ?
Aucune configuration domestique ne convient à la précision MXFP4 native des poids officiels. Même un Mac Studio de 512 Go reste loin des 1,56 To dont les poids officiels ont besoin, et une RTX 4090 (24 Go de VRAM) n’en couvre qu’environ un soixante-cinquième. La quantification GGUF 1-bit de 594 Go recommandée par Unsloth (environ 79 % de concordance des prédictions top-1 avec la version sans perte) ne tient pas non plus dans 512 Go, et sa plus petite version, UD-Q1_0 à 466 Go, laisse peu de marge pour le cache KV et n’a aucun chiffre de précision publié. Ce sont des modèles fortement dégradés, pas celui que ce guide teste. Le plancher réel pour la précision native est un nœud de datacenter, 8× B300 (2,3 To) ou 16× B200. Un cluster de quatre à cinq Mac Studio de 512 Go peut tenir les poids en précision native, mais le lien Thunderbolt entre eux est bien plus lent que la mémoire interne de chaque machine, donc l’interconnexion fixe la vitesse. Personne n’a publié d’exécution de K3 sur un cluster de Mac ; l’analogie la plus proche, un montage de génération précédente testé sur d’autres grands modèles, tournait autour de 15 tokens par seconde.
Ollama et llama.cpp gèrent-ils Kimi K3 ?
llama.cpp, oui ; Ollama, toujours pas en local. llama.cpp en version mainline a obtenu la prise en charge de K3 via une fusion le 15 août 2026, le lendemain de la première publication de ce guide, donc les dépôts GGUF n’exigent plus de compilation depuis une branche annexe. Une suite le 8 septembre 2026 (PR #28466) a activé le rollback d’état récurrent de K3 pendant le décodage spéculatif, une fonctionnalité de performance de service que vLLM et SGLang avaient déjà dès leur lancement au jour zéro. Les quantifications GGUF dynamiques d’Unsloth vont d’une version de 466 Go jusqu’à une version Q8 sans perte de 1,56 To ; sa version 1-bit de 594 Go recommandée affiche environ 79 % de concordance des prédictions top-1 avec la version sans perte. L’étiquette « cloud » d’Ollama route toujours vers les serveurs d’Ollama plutôt que de tourner en local, et il n’existe pas encore de build Ollama dédié, donc llama.cpp, directement ou via l’application Studio d’Unsloth, est la voie pour le faire tourner en local aujourd’hui.
Quelle taille fait le téléchargement de Kimi K3 ?
Le dépôt officiel pèse 1,56 To sur 96 fragments de poids, en précision native MXFP4 4 bits. Le chiffre de 594 Go souvent répété n’est pas un chiffre à part ou erroné : c’est la taille de la quantification GGUF dynamique 1-bit d’Unsloth (UD-IQ1_S), qui affiche environ 79 % de concordance des prédictions top-1 avec la version sans perte dans le test d’Unsloth. Comme K3 a été entraîné avec quantification intégrée en 4 bits, il n’y a pas de division gratuite par deux à espérer du passage habituel de 16 à 4 bits ; la version 2-bit d’Unsloth (UD-Q2_K_XL) pèse encore environ 861 Go, et sa version Q8 sans perte atteint les 1,56 To complets. Les quantifications communautaires sous 4 bits sacrifient de la qualité pour réduire la taille plutôt que de compresser un original gonflé, et le dépôt liste aussi trois versions plus petites (466 à 552 Go).
Quelle est la façon la moins chère de faire tourner Kimi K3 ?
Un fournisseur hébergé, de loin. L’API de Moonshot facture 3 $ le million de tokens en entrée pour K3 (2 $ pour le plus récent K3.1 Pro), et de nombreux hôtes concurrents listés sur OpenRouter et chez Artificial Analysis facturent moins. Aux tarifs américains, l’auto-hébergement peut revenir entre 80 et 200 $ le million de tokens sur une machine lente une fois l’énergie comptée, avant même le matériel, et davantage au tarif français. L’inférence locale bon marché d’un modèle de 2 800 milliards de paramètres n’existe pas à ce jour.
Ce que le lancement de K3 dit sur la recherche par IA
La question difficile est celle qui a ouvert cet article. N’importe quel assistant répondant à partir de ses seules données d’entraînement continuera de se tromper sur K3 pendant des mois, car un modèle ne peut pas connaître une sortie postérieure à sa date de coupure, et la recherche web ne le sauve que si le moteur peut atteindre la page. Le problème n’a rien d’anecdotique. C’est le même mécanisme qui décide si les moteurs de recherche par IA décrivent correctement votre propre produit, vos prix et votre dernière nouveauté, ou s’ils répètent quelque chose de périmé. Et l’enjeu est désormais concret en France : les Aperçus IA (AI Overviews) et le Mode IA de Google y sont déployés depuis le 22 juillet 2026, donc ce qu’une IA raconte sur votre marque dans la recherche est une réalité française, pas une échéance lointaine. Savoir si les moteurs vous décrivent correctement, et à quelle fréquence ils vous citent, c’est précisément ce que mesure la visibilité IA.
Commencez par éliminer la partie du problème sur laquelle vous pouvez agir : savoir si les robots d’exploration des IA atteignent bel et bien votre contenu. Notre score de préparation IA le mesure en une requête, pour qu’un défaut d’accessibilité facile à corriger ne soit pas ce qui vous tient à l’écart de la réponse.
Sources
- Fiche du modèle Kimi K3 - Moonshot AI / Hugging Face -
huggingface.co/moonshotai/Kimi-K3 - Prise en charge de Kimi K3 dès le jour zéro - Blog vLLM, juillet 2026 -
vllm.ai/blog/2026-07-27-k3 - SGLang et Miles ajoutent la prise en charge de Kimi K3 dès le jour zéro - LMSYS, 27 juillet 2026 -
lmsys.org/blog/2026-07-27-kimi-k3-day0-support - Kimi K3 : Open Frontier Intelligence (rapport technique) - arXiv -
arxiv.org/abs/2607.24653 - Présentation de Kimi K3.1 Pro (post-entraîné à partir de K3) - Moonshot AI, octobre 2026 -
kimi.ai/blog/kimi-k3-1-pro - Tarifs d’inférence des modèles (prix K3 et K3.1 Pro) - documentation développeurs de Moonshot AI, consultée le 24 octobre 2026 -
platform.kimi.ai/docs/pricing/chat - Liste des fournisseurs Kimi K3 - OpenRouter -
openrouter.ai/moonshotai/kimi-k3 - Benchmarks de vitesse de sortie des fournisseurs Kimi K3 - Artificial Analysis, octobre 2026 -
artificialanalysis.ai/models/kimi-k3 - deltafin (streaming des experts de Kimi K3 sur Apple Silicon) - GitHub -
github.com/gavamedia/deltafin - Nœud GPU 8× B300 (2,3 To de VRAM), région Paris - Scaleway -
scaleway.com/en/b300-sxm - Tarif réglementé de vente d’électricité (Tarif Bleu), grille au 1er août 2026 - CRE / EDF
- Mistral Small 3 (24B, Apache 2.0), exécutable en local - Mistral AI -
mistral.ai/news/mistral-small-3 - Retours de praticiens - fils r/LocalLLaMA, r/LocalLLM, r/kimi, juillet 2026
- Quantifications GGUF et benchmarks de Kimi K3 - Documentation Unsloth -
unsloth.ai/docs/models/kimi-k3 - Liste des fichiers du dépôt Kimi-K3-GGUF - Unsloth / Hugging Face -
huggingface.co/unsloth/Kimi-K3-GGUF - Configurations et prix du Mac Studio - Apple Store américain, consulté le 1er novembre 2026 -
apple.com/shop/buy-mac/mac-studio - Tarifs du cloud GPU - RunPod et Lambda -
runpod.io/pricing,lambda.ai/pricing - model: add Kimi-K3 text model (PR #26185, fusionnée le 15 août 2026) - llama.cpp / GitHub -
github.com/ggml-org/llama.cpp/pull/26185 - model: support Kimi-K3 recurrent-state rollback (PR #28466, fusionnée le 8 septembre 2026) - llama.cpp / GitHub -
github.com/ggml-org/llama.cpp/pull/28466