
Pregunta a los grandes asistentes de IA qué es DeepSeek V4 y cada uno te dará una respuesta distinta, casi todas equivocadas. Sin búsqueda web, ChatGPT lo despacha como «rumores y especulación sobre la hoja de ruta», Gemini se sitúa en 2025 y afirma que ese modelo no existe, y Claude prefiere no responder. Con la búsqueda activada apenas mejora: ChatGPT aterriza en el anuncio de la vista previa de abril y concluye que V4 no ha salido de esa fase, algo que dejó de ser cierto semanas antes de verificar esta frase. Volvió a pasar apenas unas semanas después: DeepSeek reemplazó su propio modelo Flash el 10 de septiembre de 2026 y lo actualizó de nuevo el 17 de octubre, y buena parte de la web sigue describiendo el modelo que existía el día anterior. En español el problema es peor: las páginas mejor posicionadas para «deepseek v4» siguen con precios de la vista previa de abril, o son sitios clon que prometen el modelo «sin registro».
En una línea: DeepSeek V4 es la familia actual de modelos de pesos abiertos del laboratorio chino DeepSeek, ahora un modelo Flash rápido y con visión (V4.1 Flash, desde el 10 de septiembre, actualizado el 17 de octubre) y un buque insignia Pro, disponible de forma general desde agosto de 2026 bajo licencia MIT. Aquí tienes la versión completa, contrastada con fuentes primarias a noviembre de 2026: qué es DeepSeek V4 ahora que se ha lanzado y ha pasado ya por toda una generación de Flash, cuánto cuesta realmente una vez que tienes en cuenta lo que oculta el precio de catálogo, si las cifras de rendimiento aguantan una mirada independiente y si puedes usarlo en un trabajo real. Cuando un número es una afirmación de DeepSeek y no una medición externa, lo decimos, porque en un modelo tan nuevo esa distinción lo es casi todo.
Lo que debes saber
- DeepSeek V4 es la familia de modelos de pesos abiertos de DeepSeek con licencia MIT, en dos versiones: V4.1-Flash (rápido, barato y desde el 10 de septiembre con visión nativa) y V4-Pro (el buque insignia), ambas con una ventana de contexto de 1 millón de tokens (384K de salida máxima).
- El buque insignia V4-Pro alcanzó la disponibilidad general el 13 de agosto de 2026, tras una vista previa abierta el 24 de abril. La ficha del modelo ya publicado es DeepSeek-V4-Pro-0813 («la versión oficial de DeepSeek-V4-Pro, que sustituye a la vista previa»); el repositorio original de V4-Pro en Hugging Face sigue hablando de vista previa.
- En la API, V4.1-Flash es barato: desde 0,15 $ de entrada y 0,60 $ de salida por millón de tokens en horas valle (más bajo que antes del 10 de septiembre; la actualización del 17 de octubre no lo cambió), y V4-Pro se mantiene en 0,66 $ / 1,98 $: DeepSeek anunció y luego canceló un plan para fusionar V4-Pro con el precio de Flash. La ficha de DeepSeek en la App Store describe su app como gratuita.
- En rendimiento medido es un modelo casi de frontera, no de frontera. El organismo estadounidense CAISI midió 74 % en SWE-bench frente al 80,6 % que declara DeepSeek, y calcula un retraso de unos ocho meses respecto a los líderes; según el Intelligence Index v4.3.2 de Artificial Analysis, V4.1-Flash incluso superaba a V4-Pro.
- Usar la API o la app alojada envía tus prompts a servidores en China, una transferencia internacional que, bajo el RGPD, obliga a pensárselo dos veces. Los pesos abiertos permiten autoalojar el modelo y esquivar esa cuestión.
Qué es DeepSeek V4 (y qué cambió con la versión general)
DeepSeek V4 es la familia actual de modelos de pesos abiertos de DeepSeek, el laboratorio chino con sede en Hangzhou. Su buque insignia V4-Pro alcanzó la disponibilidad general el 13 de agosto de 2026, tras una vista previa de varios meses que se abrió el 24 de abril, y sigue siendo el modelo de DeepSeek para el razonamiento y la programación más exigentes. El nivel Flash se ha movido tres veces en esa misma ventana: una actualización oficial (V4-Flash-0731) justo antes de la disponibilidad general de Pro, el 31 de julio, luego un cambio de arquitectura completo, DeepSeek-V4.1-Flash, el 10 de septiembre de 2026, que retiró V4-Flash-0731 por completo, y después DeepSeek-V4.1-Flash-1017 el 17 de octubre, una actualización con el mismo identificador de API. Si lees una explicación que todavía llama «vista previa» a V4, o que describe Flash sin mencionar V4.1, está desactualizada. La ficha que conviene leer es la de DeepSeek-V4-Pro-0813, que se define como «la versión oficial de DeepSeek-V4-Pro, que sustituye a la vista previa»; el repositorio original de V4-Pro en Hugging Face sigue con la etiqueta de vista previa (volvemos a ello en la sección de rendimiento).
V4 no es un único modelo. DeepSeek-V4-Pro es el buque insignia, pensado para razonamiento difícil, trabajo con agentes y programación exigente: un modelo de mezcla de expertos (MoE) de 1,6 billones de parámetros con 49 000 millones activos. DeepSeek-V4.1-Flash es el caballo de batalla rápido y barato para todo lo demás: un modelo MoE de 552 000 millones de parámetros (más 196 000 millones adicionales en lo que DeepSeek llama su componente Engram), con una nueva arquitectura codificador-decodificador causal, y solo 8000 millones de parámetros activos en la entrada y 16 000 millones en la salida. Ambos modelos traen una ventana de contexto de un millón de tokens con hasta 384K de salida, y ambos se publican como pesos abiertos bajo licencia MIT: puedes descargarlos y ejecutarlos tú mismo.
Varias cosas cambiaron al pasar V4 de vista previa a versión general, y más cambiaron de nuevo el 10 de septiembre. DeepSeek retiró los antiguos alias deepseek-chat y deepseek-reasoner el 24 de julio. Actualizó Flash a la compilación DeepSeek-V4-Flash-0731 el 31 de julio. El 16 de agosto de 2026 hizo efectiva la subida de precios «significativa» que venía anunciando, sustituyendo la tarifa plana de todo el día por la división entre horas valle y horas pico. Luego, el 10 de septiembre, retiró V4-Flash-0731 por completo, junto con la variante experimental V4-Flash-Vision-Exp, y los reemplazó con V4.1 Flash, con un nuevo identificador de API (deepseek-flash) y un precio más bajo. El 17 de octubre actualizó ese modelo a V4.1-Flash-1017: los modelos de la web y la app, la API (mismo identificador, mismos precios) y los pesos abiertos pasaron a la nueva versión. El anuncio de septiembre dijo que DeepSeek estaba «retirando gradualmente V4-Pro», con todas las peticiones a deepseek-v4-pro redirigidas a V4.1 Flash a partir de las 04:00 UTC del 14 de septiembre. Su registro de cambios revirtió esa decisión después, «en respuesta a la demanda de los usuarios», y a 25 de octubre, seis semanas después de ese cambio, la página de precios en vivo sigue mostrando V4-Pro como su propio modelo, con precio separado, así que trátalo como vigente, no retirado, hasta que DeepSeek diga lo contrario.
El límite más claro que acaba de cambiar: V4 solo admitía texto, sin imágenes, audio ni video como entrada, la diferencia más clara frente a ChatGPT, Gemini y Claude. Esa brecha ahora está medio cerrada. V4.1 Flash tiene visión nativa, el primer modelo Flash de DeepSeek de disponibilidad general que lee imágenes, en sustitución de la compilación experimental V4-Flash-Vision-Exp. V4-Pro sigue sin tenerla. Si tu trabajo necesita leer una captura o un gráfico y estás eligiendo entre los niveles de DeepSeek, eso ahora inclina la balanza hacia Flash en vez de Pro, algo que antes solo era cierto por precio.
La gama V4: Flash frente a Pro
Flash y Pro no son simplemente una versión reducida y otra de mayor tamaño; son configuraciones de mezcla de expertos distintas y con precios muy diferentes, y Flash acaba de cambiar de arquitectura por completo. La regla práctica sobre cuál usar también cambió tras el lanzamiento: según las propias cifras de DeepSeek, el nuevo Flash ya es lo bastante potente como para superar a Pro, costando solo una fracción de su precio.
| Modelo | Tamaño (total / activo) | Mejor para | Precio API (por 1M de tokens) |
|---|---|---|---|
| V4.1-Flash | 552 000 M + 196 000 M / 8000 M en entrada, 16 000 M en salida | Chat, extracción, clasificación, resumen, bucles de agente de gran volumen, casi toda la programación, ahora también entrada con imágenes | 0,15 $ entrada / 0,60 $ salida en horas valle, hasta 0,30 $ / 1,20 $ en pico |
| V4-Pro | 1,6 billones / 49 000 M activos | Razonamiento difícil, análisis complejo de varios pasos, la programación más exigente | 0,66 $ entrada / 1,98 $ salida en horas valle, hasta 1,32 $ / 3,96 $ en pico |
Ambos usan un diseño de mezcla de expertos, y por eso el número de parámetros activos es una fracción del total: el modelo guarda una cantidad enorme de parámetros, pero solo enciende una porción pequeña para cada token. Ese es el truco detrás de su bajo costo de funcionamiento. V4.1 Flash lleva la idea más lejos con una división asimétrica: solo 8000 millones de parámetros activos al leer tu prompt y 16 000 millones al escribir la respuesta, sobre una arquitectura codificador-decodificador causal que separa ambas tareas en lugar de usar una sola pila densa para las dos.
Por defecto, usa Flash para casi todo. Es tan barato que, a volúmenes normales, la factura es un error de redondeo, y la medición independiente respalda la afirmación de DeepSeek de que la renovación de septiembre es un salto real: Artificial Analysis puntuaba a V4.1 Flash en 39 en su Intelligence Index v4.3.2, en el puesto 9 de los 120 modelos grandes (más de 150 000 millones de parámetros) de pesos abiertos de su clase de comparación, muy por encima de la mediana de esa clase (19); esa puntuación correspondía a la compilación del 10 de septiembre, y en la v5 la actualización del 17 de octubre (V4.1 Flash 1017) puntúa 33. Reserva Pro para el trabajo que de verdad lo necesita, razonamiento difícil y la programación más exigente, donde la mejora de calidad compensa un costo de token entre 3 y 4 veces mayor (3,3x en salida, 4,4x en entrada; Flash se abarató el 10 de septiembre, así que la brecha se amplió). Si no sabes si una tarea necesita Pro, seguramente no; empieza en Flash y sube solo cuando choques con un muro.
El cambio del 10 de septiembre importa más que la actualización del 31 de julio. DeepSeek-V4-Flash-0731, la compilación de esa actualización anterior, es la que provocó la oleada de análisis del tipo «Flash acaba de mejorar» de julio y agosto; una variante de alto razonamiento se colocó séptima en la clasificación general, y tercera entre modelos de pesos abiertos, en el Frontend Code Arena a finales de julio. V4.1 Flash retira esa compilación por completo en lugar de solo ajustarla, y las propias cifras de referencia de DeepSeek lo sitúan por delante de V4-Pro, no solo por delante del Flash anterior. En pruebas de programación publicadas por DeepSeek, V4.1 Flash puntuó 90,6 en Terminal-Bench 2.1 frente al 82,7 de V4-Flash-0731, y 74,2 en DeepSWE v1.1 frente al 54,4 anterior, superando a Claude Opus 5 (89,1 / 74,0) y GPT-5.6 Sol (88,8 / 73,0) en esas dos pruebas concretas. La misma tabla incluye una tercera prueba, Terminal-Bench 4.0, donde V4.1 Flash no gana (31,2, frente al 51,8 de Opus 5 y el 39,9 de GPT-5.6 Sol), algo que conviene saber antes de leer «supera a Claude y GPT-5.6» como una afirmación general. La actualización del 17 de octubre, V4.1-Flash-1017, volvió a subir la tabla del propio DeepSeek: Terminal-Bench 4.0 de 31,2 a 42,3 (por delante del 39,9 de GPT-5.6 Sol, aún por detrás del 51,8 de Opus 5) y DeepSWE v1.1 de 74,2 a 77,0. Los rivales de esa tabla siguen siendo Opus 5 y GPT-5.6 Sol, no los más recientes Opus 5.5 o GPT-6.1 Sol. Trátalo todo con cautela: son cifras que DeepSeek eligió publicar sobre su propio modelo frente a rivales concretos, no una repetición independiente de un laboratorio externo como las de CAISI más abajo. Si mediste Flash antes del 17 de octubre, vuelve a medirlo; el modelo detrás del nombre, tanto si lo llamas deepseek-flash como con el alias antiguo deepseek-v4-flash, ha cambiado tres veces ya.
La ventana de 1 millón de tokens es real, pero con pérdidas
La función estrella es la ventana de contexto de un millón de tokens, y lo interesante no es la cifra, sino cómo DeepSeek la hizo asequible. V4 usa un diseño de atención híbrida que combina lo que DeepSeek llama Compressed Sparse Attention y Heavily Compressed Attention. Al máximo del millón de tokens, el informe técnico indica que V4-Pro requiere alrededor del 27 % del cómputo de inferencia por token y alrededor del 10 % de la memoria de caché KV de la generación anterior, DeepSeek-V3.2. Es una victoria de ingeniería real, y por eso V4 puede ofrecer una ventana de 1M a un precio que un modelo denso no alcanzaría.
Hay un segundo cambio que interesa a quien construye agentes: en las conversaciones con herramientas, V4 conserva su razonamiento de un turno a otro en lugar de descartarlo cuando llega un mensaje nuevo, y los flujos de varios pasos se sostienen mejor. Esto impone una obligación a quien usa la API: tienes que devolver ese razonamiento anterior en cada petición, o la API rechaza la llamada.
Y aquí está la trampa que la ficha técnica se calla. Una ventana barata de ejecutar se comporta como si tuviera pérdidas, y lo notas como si el modelo «ignorara» cosas. Quien ejecuta V4 con entradas largas informa, de forma constante, de que el modelo parece olvidar instrucciones colocadas cerca del principio de un prompt largo, y algunos dicen que la caída empieza bastante antes del tope del millón. DeepSeek no ha publicado un desglose de recuperación por posición, y el informe técnico no llama «con pérdidas» a la compresión, pero la explicación más plausible es esa misma compresión de atención que abarata la ventana.
En cualquier caso, la solución es un hábito de trabajo, no un informe de errores. Coloca tus instrucciones importantes cerca del final del prompt, no enterradas al principio, y repite cualquier condición que deba cumplirse sí o sí. Trata la ventana de 1M como una memoria de trabajo grande, fuerte para «encuentra el pasaje relevante» y más débil para sostener una regla que enunciaste decenas de miles de tokens antes. Usada así, la ventana de contexto es una ventaja real; confiar en ella a ciegas es donde V4 decepciona.
¿Es tan bueno como dicen?
Las cifras propias de DeepSeek son buenas. La ficha original de vista previa de V4-Pro (deepseek-ai/DeepSeek-V4-Pro, de abril) declara un 80,6 % en SWE-bench Verified, un 93,5 % en LiveCodeBench y un 90,1 % en GPQA Diamond, y enmarca sus resultados de conocimiento como un récord entre modelos de código abierto; la ficha del modelo ya publicado, V4-Pro-0813, presenta otra tabla (por ejemplo 87,9 en Terminal-Bench 2.1 y 62,7 en DeepSWE) que omite esas tres. Conviene conocerlas. También son cifras del propio fabricante, con un modo «Max» de alto esfuerzo, y son justo las que deberías contrastar con alguien independiente.
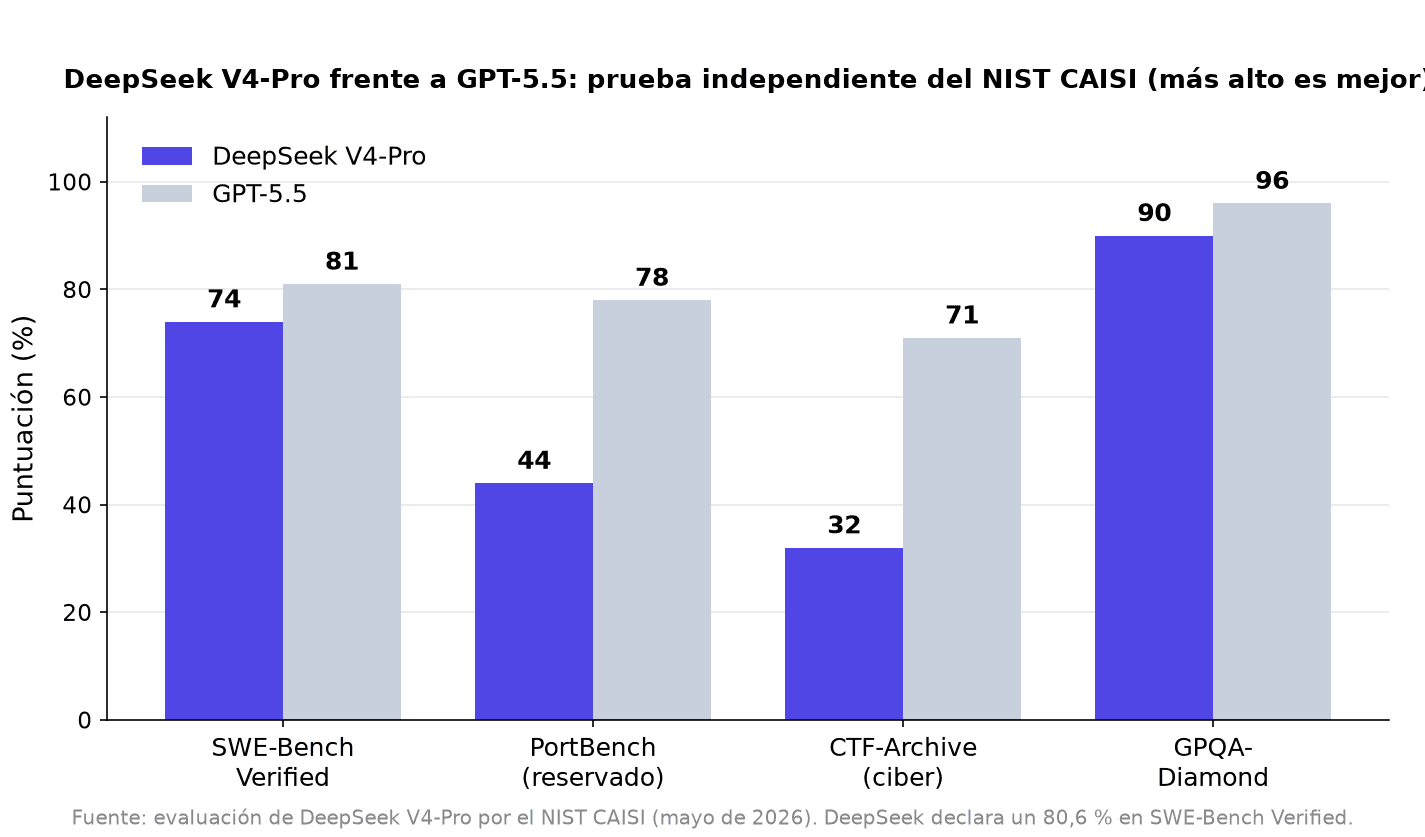
Las evaluaciones independientes cuentan una historia más matizada, y cambiante: Artificial Analysis, que aplica su propia batería, situó el 18 de octubre de 2026 a V4-Pro en un Intelligence Index de 36, antes de su paso a la v5 el 27 de octubre, en el puesto 12 de los 120 modelos grandes (más de 150 000 millones de parámetros) de pesos abiertos de su clase de comparación, por encima de la mediana de esa clase (19) pero no en la frontera; esa puntuación ha bajado desde la medición original de V4-Pro a medida que Artificial Analysis añade y vuelve a puntuar más modelos, un recordatorio de que una puntuación del Index solo vale para el día en que se consulta. V4.1 Flash puntúa más alto, 39, y queda en el puesto 9 de esa misma clase, ambas cifras verificadas en vivo el 18 de octubre de 2026: según los números de Artificial Analysis en esa fecha, el nivel Flash, más barato, superaba a Pro, una confirmación independiente de la afirmación del propio fabricante de que «V4.1 Flash supera a V4-Pro», no solo un resultado ajustado. En el índice v5.0.1 vigente (consultado el 16 de noviembre de 2026), V4 Pro 0813 puntúa 23, que Artificial Analysis califica de inferior a la media de su clase de comparación, mientras que V4.1 Flash 1017 puntúa 33, así que Flash sigue por encima de Pro; las dos versiones del índice usan escalas distintas, de modo que no conviene comparar el 36 con el 23. El organismo de normas de IA del Gobierno de EE. UU., CAISI, fue más lejos con V4-Pro en concreto: repitió las pruebas estrella de DeepSeek y añadió otras reservadas.
| Prueba (evaluación de CAISI) | DeepSeek V4-Pro | GPT-5.5 |
|---|---|---|
| SWE-Bench Verified | 74 % | 81 % |
| PortBench (programación reservada) | 44 % | 78 % |
| CTF-Archive (ciberseguridad) | 32 % | 71 % |
| GPQA-Diamond | 90 % | 96 % |
Un par de cosas saltan a la vista. Primera, CAISI midió a V4-Pro en un 74 % en SWE-bench Verified, frente al 80,6 % que publica DeepSeek, y afirmó sin rodeos que «DeepSeek V4 puntúa mejor en las evaluaciones que DeepSeek se hace a sí misma que en las de CAISI». Es la brecha entre benchmark de fabricante y medición independiente en una sola frase. Segunda, la lectura general de CAISI es que las capacidades de V4 van por detrás de la frontera unos ocho meses, con las mayores diferencias en programación reservada y ciberseguridad, donde la contaminación de los datos de entrenamiento no puede inflar la nota.
Un par de matices para ser justos. Los resultados de matemáticas de CAISI van en sentido contrario, con V4-Pro en un 97 % en OTIS-AIME-2025, casi a la par de los modelos estadounidenses. Y CAISI hizo sus pruebas en abril, sobre la compilación de vista previa, no sobre el modelo general; las propias cifras de DeepSeek de vista previa a versión general muestran mejoras notables solo por reentrenamiento, y parte de la brecha probablemente sea deriva entre compilaciones y no pura inflación, y todavía nadie ha publicado una repetición independiente del modelo lanzado.
Nada de esto convierte a V4 en un mal modelo. En costo por tarea, CAISI lo comparó con GPT-5.4 mini, el modelo barato estadounidense más cercano, y lo encontró más barato en cinco de siete pruebas, aunque entre un 53 % menos y un 41 % más caro según la tarea, una ilustración directa del impuesto de los tokens de razonamiento que vemos más abajo. Una evaluación independiente y puntuada de Kilo, fabricante de herramientas de programación, colocó a V4-Pro en 77 sobre 100, entre Claude Opus 4.7 (91) y Kimi K2.6 (68), aunque ese test es anterior a los buques insignia actuales de Claude y Kimi.
El resumen honesto: V4 es un modelo de la clase de frontera en precio y casi de frontera en capacidad, más fuerte en matemáticas, razonamiento y recuperación en contexto largo, y claramente por detrás de los líderes cerrados en la programación más difícil del mundo real, la ciberseguridad, el trabajo multimodal y los bucles de agente más largos. Si una página te dice que sencillamente supera a GPT-5.5 y a Claude, te está vendiendo las cifras del fabricante, no las mediciones independientes. Esa cautela aplica doblemente a V4.1 Flash: se lanzó el 10 de septiembre de 2026, demasiado reciente para que le hayan hecho un test independiente al estilo CAISI de sus propios benchmarks de programación, así que su afirmación de superar a Pro se apoya en las cifras del propio DeepSeek más una puntuación independiente del Intelligence Index, no en el mismo nivel de escrutinio externo que V4-Pro ha acumulado durante meses.
Cuánto cuesta DeepSeek V4 de verdad
La ficha de DeepSeek en la App Store describe su app como gratuita. La cuestión del dinero empieza en la API, y es donde V4 se gana su fama de «el barato». Estas son las tarifas actuales por millón de tokens. Para un desglose de costos más completo, consulta nuestra guía de precios de DeepSeek.
| Modelo | Entrada (sin caché) | Entrada (con caché) | Salida |
|---|---|---|---|
| V4.1-Flash (valle) | 0,15 $ | 0,003 $ | 0,60 $ |
| V4.1-Flash (pico) | 0,30 $ | 0,006 $ | 1,20 $ |
| V4-Pro (valle) | 0,66 $ | 0,022 $ | 1,98 $ |
| V4-Pro (pico) | 1,32 $ | 0,044 $ | 3,96 $ |
Los precios se publican en dólares. DeepSeek no publica en qué moneda cobra la recarga ni cómo trata el IVA (su centro de ayuda solo describe facturas chinas al 6 %): presupuesta con la cifra en dólares y confirma el tratamiento fiscal con tu asesor antes de darlo por hecho. Varias trampas separan ese precio de catálogo de tu factura real.
Las tarifas principales de Flash cambiaron dos veces, y a Pro casi lo fusionan con Flash. El 16 de agosto de 2026, DeepSeek sustituyó su tarifa plana de todo el día por la división valle/pico de la tabla, aplicada a ambos modelos: las horas pico (hoy de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excluyendo festivos oficiales chinos) se cobran al doble exacto de la tarifa valle en todas las columnas, mientras que los fines de semana y festivos chinos se facturan siempre a tarifa valle. Luego, el 10 de septiembre de 2026, la nueva arquitectura V4.1 Flash reemplazó a V4-Flash-0731 por completo, a un precio más bajo que el de agosto, mientras que el precio de V4-Pro se mantuvo igual. Ese día, el anuncio de DeepSeek dijo que estaba «retirando gradualmente V4-Pro», con una redirección a Flash prevista para el 14 de septiembre, y su registro de cambios lo revirtió a los pocos días «en respuesta a la demanda de los usuarios». Resultado neto: Flash se abarató, Pro sobrevive por ahora a su precio anterior, y la brecha entre ambos se amplió.
El modo de razonamiento está activado por defecto, y se factura a la tarifa de salida. Antes de responder, V4 genera tokens de razonamiento internos, y cuentan como salida aunque nunca los veas. Una respuesta corta puede producir en silencio miles de tokens facturados antes de la primera palabra visible. Si tu factura es más alta de lo que sugería el catálogo, casi siempre es por esto. Desactiva el razonamiento para el trabajo rutinario (clasificación, extracción, respuestas cortas) y déjalo activado solo donde el razonamiento se gane su costo.
Los aciertos de caché son donde está el verdadero ahorro. Cuando el principio de una petición coincide con algo procesado hace poco (un prompt de sistema reutilizado, un documento que envías una y otra vez), esos tokens se facturan a la tarifa con caché, y la entrada de Flash cae de 0,15 $ a 0,003 $ en horas valle (o de 0,30 $ a 0,006 $ en pico), un descuento de alrededor del 98 %. El uso de caché es automático y gratis: no marcas nada como cacheable, solo mantienes la parte estable de tu prompt al principio. Estructura los prompts para reutilizar un prefijo común y la misma carga de trabajo puede costar una fracción de la cifra anunciada. Tampoco hay un recargo aparte por contexto largo: un prompt de un millón de tokens se factura a la misma tarifa por token que uno corto, a la hora que sea.
Cómo acceder a V4: app, API o autoalojamiento
Hay varias vías de entrada, y la más barata no siempre es la obvia.
La app de DeepSeek, que su ficha de la App Store describe como gratuita, es la vía sin pago. La API directa es la vía de pago más barata y la que conviene para construir. OpenRouter y otros revendedores son cómodos, pero enrutan a servidores de terceros cuyas tarifas difieren de las oficiales, por lo que el precio que veas ahí puede no coincidir con el de la tabla. Si el costo es la prioridad, ve directo, aunque la propia API de DeepSeek puede saturarse bajo carga, parte de la razón por la que existen los revendedores.
Antes de construir sobre la API, ojo con los clones. En la búsqueda en español, la primera posición para «deepseek v4» suele ocuparla una página no oficial que promete el modelo «sin registro», y varias de esas páginas mostraban precios de la vista previa ya caducados. Empresas de seguridad han documentado además campañas de malware con sitios web falsos de DeepSeek. El acceso oficial es chat.deepseek.com y api-docs.deepseek.com: verifica la dirección, y trata como desactualizada cualquier página que muestre una tarifa plana sin distinguir valle y pico.
Si construyes sobre la API, la migración es lo que te va a dar problemas, y ya ha pasado dos veces. Los nombres de modelo originales, deepseek-chat y deepseek-reasoner, que apuntaban a los modos sin razonamiento y con razonamiento de deepseek-v4-flash, se retiraron el 24 de julio de 2026 a las 15:59 UTC, y el código que aún los llama ahora falla. Después, deepseek-v4-flash y la posterior variante experimental deepseek-v4-flash-vision-exp (añadida el 21 de agosto) se plegaron en el nuevo deepseek-flash el 10 de septiembre de 2026, pero de forma más silenciosa: deepseek-v4-flash y deepseek-v4-flash-vision-exp siguen, según la página de precios de DeepSeek, «aceptados» aunque retirados, con las peticiones atendidas por el modelo Flash actual (ahora V4.1-Flash-1017) al precio de Flash; la página no da fecha de fin. deepseek-v4-pro no formó parte de esa fusión y no cambió.
| Nombre antiguo (retirado) | Llama ahora a | A qué corresponde |
|---|---|---|
deepseek-chat | deepseek-flash | Flash, modo sin razonamiento |
deepseek-reasoner | deepseek-flash | Flash, modo de razonamiento |
deepseek-v4-flash (sigue aceptado) | deepseek-flash | Ahora enruta a V4.1 Flash, facturado al nuevo precio, más bajo, de V4.1 Flash |
deepseek-v4-flash-vision-exp (sigue aceptado) | deepseek-flash | La compilación experimental de visión se retiró; la visión nativa ahora viene de serie en V4.1 Flash |
El cambio directo tiene dos trampas ahora, no una. Primera: deepseek-reasoner nunca fue el modelo de razonamiento de la gama Pro; antes de retirarse el 24 de julio correspondía a Flash en modo de razonamiento, no a Pro, y esa distinción se mantiene hoy: el modo de razonamiento de deepseek-flash tampoco es razonamiento de nivel Pro. Si quieres razonamiento del nivel de Pro tienes que pedir deepseek-v4-pro de forma explícita. Segunda: desde el 10 de septiembre, el código que todavía apunta a deepseek-v4-flash no está ejecutando el modelo con el que lo probaste la última vez, sino V4.1 Flash en silencio, una arquitectura distinta con visión nativa, a un precio más bajo. Para la mayoría de casos de uso eso es una mejora directa, pero si tienes análisis de la salida o evaluaciones ajustados a las peculiaridades del modelo anterior, vuelve a probarlo antes de asumir que nada cambió.
El autoalojamiento es la verdadera vía de escape, y ahora con una salvedad de hardware mayor que antes. Como los pesos tienen licencia MIT, puedes ejecutar V4 en tus propias máquinas, la respuesta más limpia a cualquier duda sobre residencia de datos. En la práctica, V4-Pro, con 1,6 billones de parámetros, queda fuera del alcance de un particular y es difícil incluso para equipos bien financiados; pide un servidor multi-GPU con cientos de gigabytes de memoria incluso cuantizado. El nivel Flash solía ser el objetivo fácil de autoalojamiento, cuando era V4-Flash-0731 con 284 000 millones de parámetros. V4.1 Flash, el modelo que lo reemplazó, es una descarga bastante mayor: 552 000 millones de parámetros base más 196 000 millones adicionales en su componente Engram, con el repositorio de Hugging Face indicando unos 510 GB de pesos, aunque solo entre 8000 y 16 000 millones de parámetros estén activos por token en el momento de la inferencia. El bajo número de parámetros activos mantiene barato el cómputo de inferencia una vez cargados los pesos, pero igualmente necesitas tener el modelo completo en memoria o en almacenamiento rápido para cargarlo, así que V4.1 Flash es un autoalojamiento más difícil que el Flash anterior, no más fácil. Cuenta con un nodo multi-GPU de mucha memoria servido con vLLM o SGLang, no con la vía de aficionado de llama.cpp o LM Studio, y espera que las configuraciones cuantizadas de una sola GPU vayan más ajustadas que con el Flash anterior. Si has ejecutado Kimi K3 en local, las limitaciones te sonarán, solo que a mayor escala.
¿Se puede usar en el trabajo?
Esta es la pregunta que decide la mayoría de las adopciones profesionales, y la respuesta realmente es «depende», no un sí o un no.
Si usas la API o la app alojadas de DeepSeek, tus prompts van a servidores en China. Para muchas empresas, contratistas públicos y sectores regulados, eso por sí solo es un freno absoluto, y no pocos lo restringen del todo. Es una decisión de enrutamiento y jurisdicción, separada de cualquier cosa sobre la calidad del modelo.
Hay una vía intermedia que hacen posible los pesos abiertos: contratar V4 con un proveedor occidental. Azure AI Foundry, Fireworks y Together sirven los niveles Flash y Pro de DeepSeek desde su propia infraestructura, algunos con regiones en la UE: tus prompts nunca tocan los servidores de DeepSeek y obtienes un contrato de empresa y un compromiso de residencia de datos sin tener que montar un clúster de GPU (comprueba con cada proveedor si ofrece V4.1 Flash, y qué versión, antes de firmar). Pagas un margen sobre las tarifas directas de DeepSeek; ese es el precio de la jurisdicción.
O autoaloja. Como V4 tiene licencia MIT, un equipo que no pueda enviar datos a ningún sitio que no controle puede ejecutar el modelo en su propia infraestructura, de modo que los prompts nunca salen de la organización y no se aplican el registro de datos ni las condiciones de la app alojada. Un matiz que el autoalojamiento no resuelve: los rechazos políticos y el sesgo de alineación están entrenados en los pesos, de ahí que un V4 autoalojado siga esquivando o desviando las preguntas sensibles igual que el alojado. El autoalojamiento resuelve la cuestión de la residencia de los datos, no la de si el modelo responderá con franqueza. El cuadro más amplio de confianza, incluido cómo trata DeepSeek los datos en sus propios servidores, lo cubrimos en nuestra explicación de DeepSeek.
Y en España, ¿qué dice el RGPD? Enviar datos personales a la API o la app alojadas de DeepSeek es una transferencia internacional a China sin decisión de adecuación de la UE, exactamente el terreno que regulan los artículos 44 a 49 del RGPD. No hay prohibición general: hasta la fecha, ningún gobierno de España ni de Latinoamérica ha vetado DeepSeek a los particulares. En España, la organización de consumidores OCU trasladó en febrero de 2025 una reclamación a la Agencia Española de Protección de Datos (AEPD), que no ha publicado ninguna resolución; en Europa, Italia sí bloqueó la app y Alemania pidió su retirada de las tiendas por el traslado de datos. Para un uso profesional con datos de clientes, el criterio prudente es el de siempre con cualquier IA de consumo: no metas ahí datos personales o confidenciales, o ejecuta los pesos abiertos en tu propia infraestructura.
DeepSeek V4 frente a la competencia
El marco que mantiene las ideas claras es que V4 es un modelo que puedes descargar, mientras que ChatGPT, Gemini y Claude son productos que te alquilan acceso a un modelo cerrado. En precio bruto por token, V4 juega en otra liga: cuesta alrededor de un orden de magnitud menos que los buques insignia occidentales, aunque la diferencia se estrecha en el costo por tarea completada una vez cuentas los tokens de razonamiento.
Frente a los líderes cerrados actuales de OpenAI, Google y Anthropic (incluido Claude Opus 5.5), la disyuntiva es la de siempre: costo y apertura a cambio de pulido, confiabilidad ante tareas variadas y ventaja en la programación con agentes más difícil. La brecha multimodal se estrechó el 10 de septiembre ahora que V4.1 Flash lee imágenes, pero no se cerró: ninguno de los dos modelos admite audio ni video como entrada, y ninguno genera imagen o video. Desde el 13 de noviembre de 2026 DeepSeek sí vende API aparte de voz a texto y de texto a voz (la de voz a texto acepta clips de hasta 120 segundos), pero son servicios independientes, no modalidades del modelo, terreno donde los líderes cerrados son productos multimodales completos. Frente a los otros modelos chinos de pesos abiertos, V4 es el especialista en razonamiento y precio, Kimi K3 tira más hacia lo agéntico y Qwen juega la carta de la amplitud y la cobertura multilingüe. Para un cara a cara, nuestra guía sobre los modelos chinos comparados los pone en una sola tabla, y el ranking de los mejores LLM open source lo compara con el resto del campo.
Rarezas y trampas que conviene conocer
Algunas cosas que los benchmarks nunca mencionan siguen sorprendiendo a la gente.
V4 no siempre sabe que es V4. Pregúntale qué modelo es y puede responder V3; lo que dice de sí mismo no es de fiar. No uses la respuesta del propio modelo para comprobar qué versión ejecutas; comprueba el nombre de API que llamaste.
El trabajo creativo y exploratorio retrocedió un poco. Quien escribe ficción o hace generación de ideas sin un rumbo fijo informa de un sesgo de positividad más marcado y un tono más difícil de dirigir que el de V3.2. Es una queja concreta de un público concreto, no un fallo de los que acaban en titulares, pero si tu caso de uso es la escritura creativa, pruébalo antes de cambiarte.
El seguimiento de instrucciones en agentes está en disputa. Algunos desarrolladores dicen que V4 rebasa los límites definidos explícitamente en arquitecturas de agente; otros no ven nada. El arreglo consensuado es de arquitectura: dale un orquestador claro y definiciones de herramientas precisas y acotadas, en lugar de confiar en una instrucción libre y larga.
R2 sigue sin llegar. El modelo de razonamiento por el que la gente sigue preguntando, DeepSeek-R2, se esperaba en 2025 por informaciones de prensa y no ha aparecido; el modo de razonamiento integrado de V4 es la respuesta de DeepSeek por ahora. Trata cualquier afirmación sobre R2 como un rumor hasta que exista una ficha del modelo.
Qué significa DeepSeek V4 para tu visibilidad en la IA
Vuelve al principio. La razón por la que esos asistentes dieron respuestas contradictorias y casi todas erróneas sobre V4 no es que V4 sea oscuro; es un lanzamiento de sobra cubierto. Es que los asistentes solo están tan al día como las fuentes que pueden alcanzar, y la mayoría no se había puesto al corriente.
Ese es el juego entero para cualquiera que quiera que la IA lo represente con precisión. Cuando un modelo, un producto o un dato son nuevos, los motores recurren al material desfasado que encuentran. En la práctica, que te citen bien se reduce a las disciplinas poco glamurosas que esta página intenta encarnar: fecha tus afirmaciones, atribuye cada cifra a su fuente, pon la respuesta directa junto al encabezado y revisa con regularidad los datos volátiles. Ese es el fundamento de la optimización para motores generativos (GEO).
Y no es teoría en este caso. A fecha del 23 de agosto de 2026, la búsqueda en Google en España para «deepseek v4» muestra un resumen «Vistas creadas con IA» que se apoya, entre otras fuentes, en esa página clon «sin registro» de la primera posición y en videos de la vista previa de abril. El propio motor está citando material obsoleto porque es lo que encuentra bien estructurado. Las respuestas desactualizadas vienen de fuentes desfasadas o inalcanzables, de ahí que el primer movimiento sea asegurarte de que los motores puedan siquiera alcanzar e interpretar tus páginas. Haz una comprobación gratuita de preparación para la IA para ver dónde se bloquean o tropiezan los rastreadores de IA en tu sitio, antes de que el próximo lanzamiento vuelva a hacer urgente la pregunta.
Preguntas frecuentes
¿DeepSeek V4 ya salió o sigue en vista previa?
Salió. El buque insignia V4-Pro alcanzó la disponibilidad general el 13 de agosto de 2026, cerrando una vista previa que arrancó el 24 de abril. Las explicaciones y respuestas de IA que todavía lo llaman vista previa están desactualizadas; la ficha del modelo ya publicado es DeepSeek-V4-Pro-0813, mientras que el repositorio original de V4-Pro en Hugging Face sigue con la etiqueta de vista previa.
¿Cuánto cuesta DeepSeek V4 al mes?
La ficha de DeepSeek en la App Store describe su app como gratuita. En la API tu factura sigue tu volumen de tokens, por lo que la respuesta honesta es calcularla con la tabla de arriba: multiplica tus tokens mensuales de entrada y salida por las tarifas de Flash, y recuerda que el modo de razonamiento añade tokens facturados de más. El uso individual suele quedar en unos pocos dólares al mes y escala desde ahí; Pro cuesta entre 3 y 4 veces Flash para el mismo volumen. Nuestra guía de precios de DeepSeek tiene ejemplos resueltos. Los aciertos de caché y desactivar el razonamiento para tareas simples son lo que más mueve la factura.
¿Puedo usar DeepSeek V4 en el trabajo?
A través de la API o la app alojadas, tus datos van a servidores en China, algo que muchas empresas y sectores regulados prohíben, y que en la UE cae bajo las reglas de transferencia internacional del RGPD (artículos 44 a 49). Los pesos abiertos con licencia MIT te permiten autoalojar el modelo y mantener los datos en casa, que es la vía habitual para el trabajo sensible.
¿Qué pasó con DeepSeek R2?
No ha salido. R2 se esperaba en 2025 y sigue sin lanzarse; el modo de razonamiento integrado de V4 es la oferta de razonamiento actual de DeepSeek. Trata cualquier afirmación sobre R2 como un rumor hasta que exista una ficha del modelo.
Fuentes
- Modelos y precios de la API de DeepSeek (tarifas actuales, nombres de modelo, soporte de visión) - DeepSeek, verificado en vivo el 16 de noviembre de 2026 -
api-docs.deepseek.com/quick_start/pricing - Registro de cambios (lanzamiento de V4.1 Flash, retiro de nombres, V4.1-Flash-1017, continuidad de V4-Pro) - DeepSeek API Docs -
api-docs.deepseek.com/updates - Lanzamiento de DeepSeek-V4.1-Flash-1017 (17 de octubre de 2026) - DeepSeek API Docs -
api-docs.deepseek.com/news/news261017 - DeepSeek - AI Assistant (ficha de la App Store: «for free!») - Hangzhou DeepSeek Artificial Intelligence Co., Ltd, consultada el 16 de noviembre de 2026 -
apps.apple.com/us/app/deepseek-ai-assistant/id6737597349 - Presentando DeepSeek-V4.1-Flash (arquitectura, benchmarks, anuncio de lanzamiento) - DeepSeek, 10 de septiembre de 2026 -
deepseek.com/en/news/deepseek-v4-1-flash - Lanzamiento de la versión general de DeepSeek-V4-Pro (13 de agosto de 2026) - DeepSeek -
api-docs.deepseek.com/news/news260813 - Ficha del modelo DeepSeek-V4-Pro-0813 (versión oficial que sustituye a la vista previa) y ficha original de la vista previa (benchmarks de abril) - DeepSeek en Hugging Face -
huggingface.co/deepseek-ai/DeepSeek-V4-Pro-0813,huggingface.co/deepseek-ai/DeepSeek-V4-Pro - Informe técnico de DeepSeek-V4 (atención híbrida, eficiencia en contexto largo) - arXiv -
arxiv.org/abs/2606.19348 - Evaluación de DeepSeek V4 Pro por el CAISI (benchmarks independientes, retraso respecto a la frontera) - NIST, mayo de 2026 -
nist.gov/news-events/news/2026/05/caisi-evaluation-deepseek-v4-pro - DeepSeek V4 Pro, análisis de inteligencia, rendimiento y precio (índice independiente) - Artificial Analysis -
artificialanalysis.ai/models/deepseek-v4-pro - DeepSeek V4.1 Flash 1017 (índice de inteligencia independiente, v5.0.1), consultado el 16 de noviembre de 2026 - Artificial Analysis -
artificialanalysis.ai/models/deepseek-v4-1-flash-1017 - Lanzamiento del conjunto completo de API de aplicación (13 de noviembre de 2026) y guía de voz a texto - DeepSeek API Docs -
api-docs.deepseek.com/news/news261113,api-docs.deepseek.com/guides/asr - Probamos DeepSeek V4 Pro y Flash (análisis puntuado independiente) - Kilo -
blog.kilo.ai/p/we-tested-deepseek-v4-pro-and-flash - DeepSeek V4 Flash y V4 Pro en Microsoft Foundry (alojamiento occidental, residencia en EE. UU. y la UE) - Microsoft -
techcommunity.microsoft.com/blog/azure-ai-foundry-blog/introducing-deepseek-v4-flash-and-v4-pro-in-microsoft-foundry/4515174 - La OCU pide a la AEPD que investigue DeepSeek - Infobae, febrero de 2025 -
infobae.com/espana/agencias/2025/02/03/ocu-denuncia-los-posibles-riesgos-de-deepseek-y-pide-a-proteccion-de-datos-que-investigue