
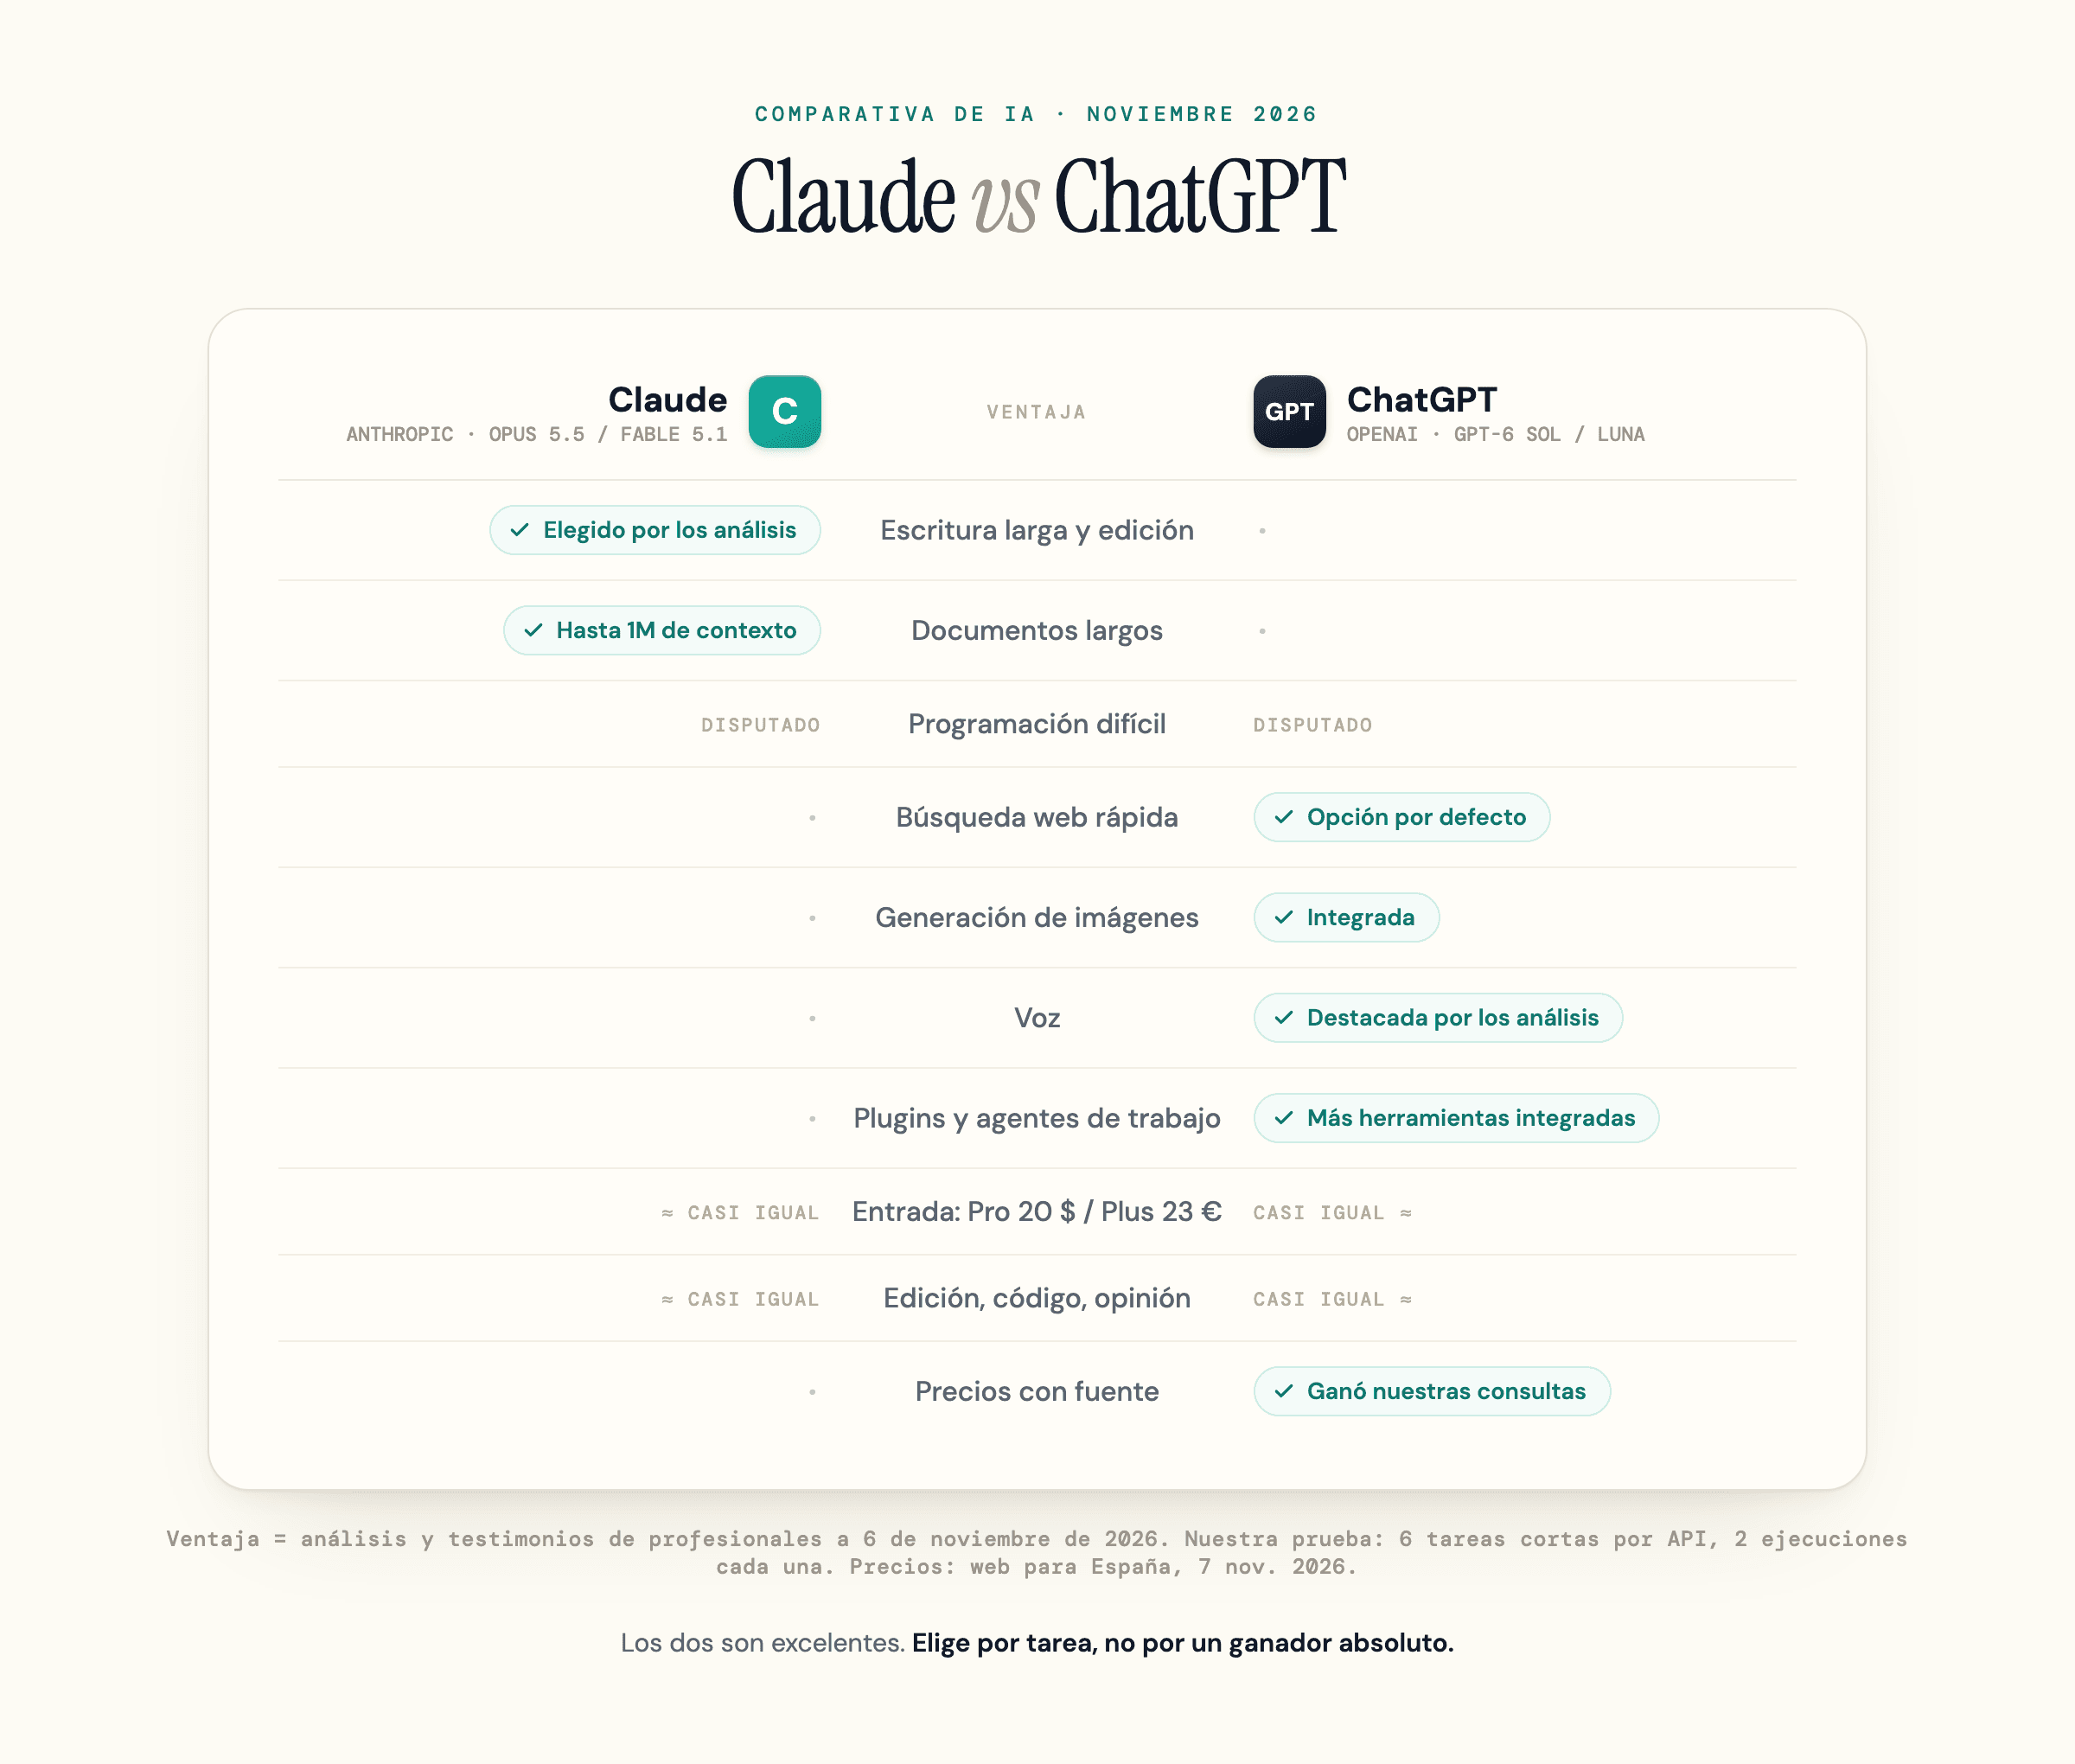
Claude vs ChatGPT: ninguno gana sin discusión. A 6 de noviembre de 2026, análisis como el de Zapier prefieren Claude para la escritura creativa, y su ventana de 1 millón de tokens encaja con documentos largos. En programación los profesionales están divididos, y la mayoría de los análisis sitúan a ChatGPT por delante en imágenes, voz, búsqueda rápida en la web y herramientas integradas. En nuestra breve prueba por API empataron al editar, al programar y al dar una opinión honesta, pero GPT-6 Sol encontró las páginas de los propios fabricantes de forma más confiable.
Mucha gente usa los dos: según la encuesta de Menlo de 2026, el usuario medio de IA en Estados Unidos utiliza 3,0 asistentes.
Preguntar si es mejor Claude o ChatGPT casi siempre se plantea como un duelo con un ganador, y por eso la mayoría de las comparativas envejecen tan mal. Esta está escrita para quien publica o vende contenido, no para quien construye modelos, así que también responde a una pregunta que casi todas se saltan: cuál de los dos debería citar tu marca. ¿Acabas de llegar a Claude? Empieza por qué es Claude AI.
Lo que debes saber
- No hay un ganador absoluto: Claude suele ir por delante en textos largos y documentos largos, ChatGPT en imágenes, voz, búsqueda rápida y herramientas integradas, y la programación está disputada (a 6 de noviembre de 2026).
- La entrada cuesta casi lo mismo: en la web española, ChatGPT Plus cuesta 23 € al mes y Claude Pro aparece a 20 $ al mes sin impuestos (consultado el 7 de noviembre de 2026 desde una IP española).
- Arriba las escaleras se separan: ChatGPT Pro empieza en 103 € y tiene tres niveles de uso (Pro 100, 200 y 500); Claude termina en Max (100 $) y Ultra (200 $).
- Los límites de uso pesan más que el modelo: Claude mide todo, chat incluido, en una ventana de 5 horas más un tope semanal; ChatGPT deja el chat diario «ilimitado» con protección contra abusos y mide Codex en ventanas de 5 horas y semanales.
- Para una marca, lo que cuenta es quién te cita: tus clientes usan asistentes distintos, y aparecer en uno no significa aparecer en los demás.
Claude vs ChatGPT en resumen (noviembre de 2026)
Los dos son excelentes y las diferencias reales están en los bordes. Los modelos y los límites de cada plan cambian cada mes, así que cada fila lleva la fecha de captura, 6 de noviembre de 2026, y sale de las páginas de los propios fabricantes; los precios en euros los tomamos el 7 de noviembre de 2026 de la página de precios para España.
| Claude | ChatGPT | |
|---|---|---|
| Fabricante | Anthropic | OpenAI |
| Modelos en la app | Opus 5.5, Sonnet 5.5 y Haiku 5.5, más el modelo superior Fable 5.1 en los planes de pago (tabla de modelos de Anthropic) | En el chat, GPT-6 Sol en Plus, Pro y Business desde el 7 de octubre de 2026, y GPT-6 Luna en Free y Go desde el 8 de octubre según las notas de versión (una página de ayuda de OpenAI todavía nombra GPT-5.6 Luna); Pro añade el razonamiento de GPT-6 Astra. Work y Codex funcionan con GPT-6.1 Sol y Terra, entre otros |
| Planes (al mes) | Free, Pro 20 $, Max 100 $, Ultra 200 $ (en dólares y sin impuestos, también en la web española) | Free, Go 8 €, Plus 23 €, Pro desde 103 € en tres niveles (web para España) |
| Límites de uso | Una ventana de 5 horas más un tope semanal para todo, chat incluido; las cuentas Ultra verificadas no tienen límite de 5 horas, solo semanal | Chat diario ilimitado en todos los planes, con protección contra abusos; Codex tiene ventanas de 5 horas y semanales, y GPT-6 Pro un límite semanal de mensajes propio |
| Contexto en la app | Hasta 1 millón de tokens, según el modelo, en todos los planes | Chats Instant de 27K (Free), 54K (Go, Plus) y 128K (Pro); chats de razonamiento de 256K (Go, Plus) y 400K (Pro) |
| Memoria | Memoria entre conversaciones en todos los planes, Free incluido | Limitada en Free, más larga en Go, ampliada en Plus y máxima en Pro |
| Búsqueda web | Integrada en todos los planes; modo Investigación desde Pro | Integrada; investigación profunda en todos los planes, limitada en Free y Go |
| Producto de programación | Claude Code desde Pro | Codex en todos los planes, limitado en Free y Go |
| Agentes | Claude Code, Claude in Chrome, tareas programadas | ChatGPT Work en escritorio, web y móvil desde Plus; Pro añade Dot, un agente siempre activo |
| Imágenes y voz | Sin generador de imágenes en su página de planes; Claude Design crea prototipos y diapositivas; modo de voz en todos los planes | Generación de imágenes en todos los planes (Images 2.6 desde el 4 de noviembre); voz en todos los planes |
| Asistentes propios | Proyectos y Skills | Plugins; los GPT personalizados se retiran el 11 de diciembre de 2026 |
| Nivel gratuito | Sonnet y Haiku, búsqueda web, memoria y Artifacts, con topes de 5 horas y semanales | Chats de texto ilimitados con protección contra abusos (con GPT-6 Luna según las notas de versión); subidas, imágenes y voz limitadas |
Fuentes de la tabla: precios de Claude y el centro de ayuda de Claude, precios de ChatGPT y las notas de versión de ChatGPT. Los dos son grandes modelos de lenguaje construidos sobre la misma idea básica, así que una lista de funciones solo te lleva hasta cierto punto. Lo que predice cuál vas a preferir es cómo se entrenó cada uno, cómo maneja la web abierta y cuánto uso te da de verdad cada plan.
¿Es Claude mejor que ChatGPT?
No, y el otro tampoco. «Mejor» cambia con la tarea. Análisis como el de Zapier consideran a Claude mejor compañero para el trabajo creativo, y en Reddit los profesionales suelen citar los modelos Opus de Claude para problemas de programación difíciles, aunque se dividen según el nivel del plan.
A ChatGPT, análisis y profesionales le reconocen la generación de imágenes integrada, un modo de voz más maduro y más herramientas integradas, como plugins y agentes de trabajo. La programación está de verdad disputada, y en tareas cortas y bien definidas no pudimos separarlos (mira nuestra prueba más abajo).
Si tu día consiste en redactar, editar y razonar sobre documentos largos, Claude suele describirse como más preciso y con menos relleno. Si tu día incluye imágenes, hablar con el modelo por voz o recurrir a la herramienta que pida cada tarea, el ecosistema de ChatGPT es difícil de superar. Los dos fabricantes ajustan sus modelos constantemente: toma cualquier inclinación como una tendencia de este mes.
Mucha gente usa más de un asistente. En el 2026 State of Consumer AI de Menlo Ventures, una encuesta a 5067 adultos de Estados Unidos publicada el 16 de septiembre de 2026, ChatGPT llega al 60 % de los usuarios de IA, Gemini al 58 % y Claude al 20 % (frente al 7 % un año antes), y el usuario medio utiliza ya 3,0 asistentes generales, frente a 2,2.
Menlo también observa que los usuarios de Claude tienen más probabilidades de pagar por la IA (82 %) y de usar agentes (48 %). Menlo es inversor de Anthropic. Toma las cifras de Claude como una señal, no como un censo neutral.
La pregunta útil, por tanto, es mejor en qué, con qué plan, para quién y medido cómo.
Claude vs ChatGPT: precios y qué plan necesitas de verdad
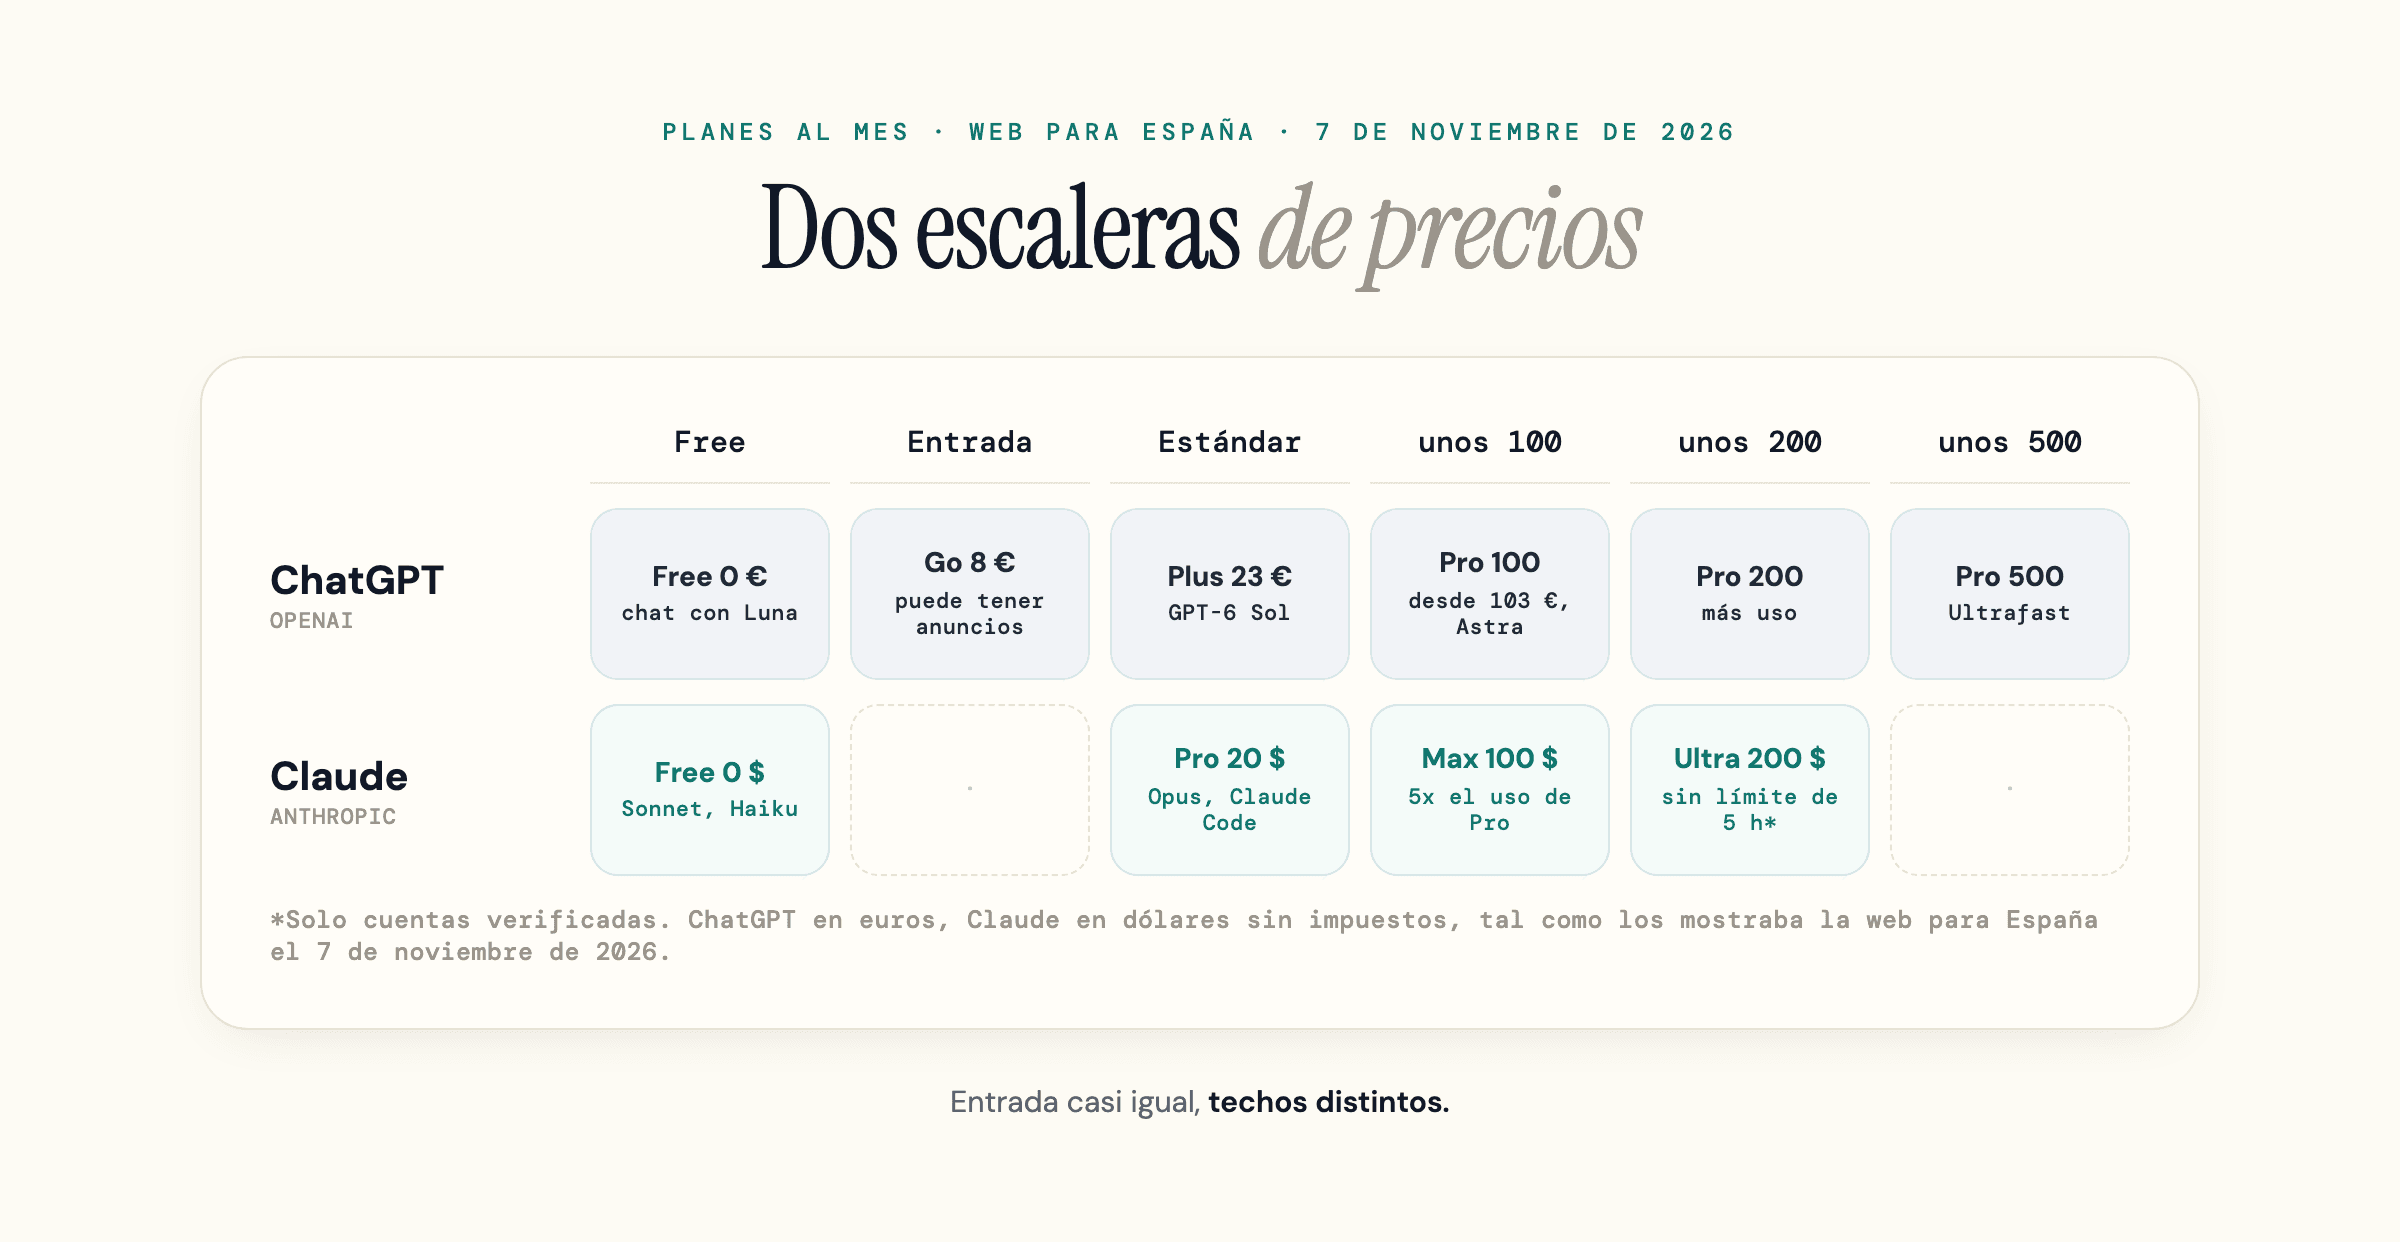
En el nivel de entrada empatan casi del todo, 20 dólares frente a 23 euros al mes; la diferencia es cuánto te deja hacer cada plan antes de frenarte. La escalera de abajo muestra lo que enseñaban las páginas de precios para España el 7 de noviembre de 2026, consultadas sin iniciar sesión desde una IP española. El contenido de cada plan sale de las páginas de ayuda de los fabricantes a 6 de noviembre de 2026. Para el detalle de cada lado, mira nuestras guías de precios de ChatGPT y precios de Claude.
| Nivel | Claude | ChatGPT |
|---|---|---|
| Free | Sonnet y Haiku, búsqueda web, memoria, Artifacts; uso limitado cada 5 horas y cada semana | Chats de texto ilimitados con protección contra abusos; subidas, imágenes, voz, investigación profunda y Codex limitados |
| Entrada | Nada por debajo de Pro | Go, 8 €: más mensajes, subidas, imágenes y voz, y memoria más larga; puede incluir anuncios |
| Estándar | Pro, 20 $: añade Opus, Claude Code, el modo Investigación y más Proyectos; Fable solo con créditos de uso | Plus, 23 €: razonamiento avanzado con GPT-6, más Codex e investigación profunda, ChatGPT Work en escritorio, web y móvil |
| En torno a 100 | Max, 100 $: 5 veces el uso de Pro; Fable hasta la mitad de tu límite semanal; 100 $ al mes en créditos de API | Pro 100, desde 103 €: todo lo de Plus, más el razonamiento Pro con GPT-6 Astra y sesiones de Work y Codex más largas; 103 € al mes en créditos de API |
| En torno a 200 | Ultra, 200 $: sin límite de 5 horas para cuentas verificadas, 10 veces el uso semanal de Pro; 200 $ al mes en créditos de API | Pro 200: más uso que Pro 100; abierto de nuevo a nuevos suscriptores desde el 29 de septiembre; 229 € al mes en créditos de API |
| En torno a 500 | Sin nivel equivalente | Pro 500: el mayor uso incluido y el único plan Pro con el modo Ultrafast; 510 € al mes en créditos de API |
Fuentes: páginas de ayuda de Anthropic sobre Pro, Max y Ultra (modificadas el 30 de octubre de 2026), página de OpenAI sobre los niveles Pro y página de Plus. La página de precios de OpenAI para España solo indica «desde 103 €» para Pro y da los créditos de API mensuales de cada nivel (103 €, 229 € y 510 €), sin un precio propio en euros para Pro 200 y Pro 500. Anthropic renombró Max 20x como Ultra sin cambiar el precio y aclara que los 200 $ son para suscripciones web, y en móvil el precio puede variar.
Lo que pagas de verdad en España y en Latinoamérica. Anthropic muestra sus precios en dólares también en su web en español y avisa de que «no incluyen los impuestos aplicables», por lo que en España se suma el IVA al pagar. OpenAI muestra precios en euros para España, sin indicar en la página si el IVA está incluido. Fuera de la zona euro, cada país puede ver su propia moneda e impuestos, de modo que el importe que cuenta es el que aparece en tu propia pantalla de pago, no una cifra de un artículo.
ChatGPT Plus vs Claude Pro
En el nivel estándar eliges una estructura de uso tanto como un modelo. Los dos fabricantes miden el trabajo intenso en ventanas de 5 horas y semanales (en OpenAI, eso afecta a Codex). Anthropic publica para Claude Pro un límite de 5 horas más un límite semanal para todos los modelos, chat incluido.
OpenAI deja el chat diario «ilimitado» con protección contra abusos, pero dice que Plus «puede incluir límites de uso, como topes de mensajes, sobre todo en momentos de alta demanda» y mide Codex en ventanas de 5 horas y semanales, visibles en Configuración > Uso.
Lo que compras también cambia. Pro añade Opus, Claude Code, el modo Investigación y más Proyectos, y deja Fable, el modelo superior de Anthropic, detrás de los créditos de uso. Plus añade el razonamiento de GPT-6, más investigación profunda y Codex, y ChatGPT Work en escritorio, web y móvil, mientras que la generación de imágenes y la voz vienen con todos los planes de ChatGPT.
Si trabajas sobre todo con texto y código, Pro te basta; si además necesitas imágenes o voz, ChatGPT cubre más de tu día.
Los niveles en torno a 100 y 200
En lo alto de cada escalera es donde los planes se separan. El plan Max de Claude cuesta 100 $ y te deja gastar en Fable hasta la mitad de tu límite semanal. Ultra cuesta 200 $ y, en las cuentas verificadas, elimina por completo el límite de 5 horas. ChatGPT reparte ese mismo tramo en Pro 100 y Pro 200, con un nivel Pro 500 por encima que es el único con el modo Ultrafast.
OpenAI, además, cambió de rumbo dos veces: reabrió Pro 200 a nuevos suscriptores el 29 de septiembre de 2026, y el 29 de octubre canceló un recorte previsto de la asignación de Work y Codex de Pro 200 y duplicó la de Pro 100 y Pro 500, según sus notas de versión y su página de los niveles Pro.
Max y Ultra de Claude incluyen 100 $ y 200 $ al mes en créditos de API, y cada nivel Pro de ChatGPT incluye créditos de API mensuales que, según la guía de créditos de API de OpenAI, equivalen a su precio en dólares.
Las asignaciones cambian a menudo en los dos lados, y por eso revisar la página del fabricante antes de suscribirte vale más que cualquier tabla, incluida la nuestra.
Puestos de Team y Business
Para equipos, las dos escaleras casi coinciden; solo cambia la moneda. Un puesto estándar cuesta 25 $ por persona y mes con facturación mensual o 20 $ con facturación anual en Claude Team, y 26 € o 21 € en ChatGPT Business según la web para España. Un puesto premium con más uso cuesta 125 $ o 100 $ en Claude y 130 € o 105 € en ChatGPT. Algunas comparativas todavía dan un precio por puesto más alto para el plan de equipo de ChatGPT; las páginas actuales de OpenAI no.
Si te topas con el límite una y otra vez
Las experiencias son dispares. En Reddit, usuarios de Claude Pro describen días de mucho chat que agotan la ventana de 5 horas, y uno cuenta que la alcanzó «sorprendentemente rápido». En el trabajo con agentes, algunos dicen que Claude rinde más que Codex y otros lo contrario, según el nivel del plan.
Los remedios que se repiten en los 20 hilos de los últimos 90 días que leímos son estos. Manda el chat informal a ChatGPT y guarda Claude para el trabajo que lo necesita. Empieza una sesión nueva con un breve resumen escrito en lugar de retomar un chat largo que vuelve a leer todo su historial. Y usa un modelo más pequeño para las tareas ligeras. Son testimonios de la comunidad, no resultados medidos, y los hilos están en subreddits afines a cada marca.
Cómo están construidos Claude y ChatGPT (y por qué notas la diferencia)
Por dentro, los dos usan el mismo tipo de motor y luego dan un giro brusco que explica casi todo su comportamiento. Cada uno es un transformer que predice el siguiente token, entrenado con una gran parte de internet. El carácter con el que hablas sale de una segunda etapa, el alineamiento, y del producto que envuelve al modelo.
El comportamiento de asistente de ChatGPT se moldeó sobre todo con aprendizaje por refuerzo a partir de retroalimentación humana: las personas puntúan respuestas y el modelo aprende a producir más de lo que se premia. Claude también lo usa, pero añade la IA Constitucional. El modelo primero critica y corrige sus propias respuestas según un conjunto de principios escritos, y después el aprendizaje por refuerzo se guía por preferencias que otra IA genera según esos mismos principios.
En palabras de Anthropic, «the only human oversight is provided through a list of rules or principles» (la única supervisión humana se da a través de una lista de reglas o principios). Las distintas recetas de entrenamiento pueden explicar parte de lo que describen los usuarios: Claude hace más preguntas aclaratorias o pone pegas en los casos límite, y ChatGPT es más amplio y más dispuesto a producir algo enseguida.
Las dos cosas son tendencias, y no podemos inspeccionar por dentro ninguno de los dos modelos, por lo que cualquier explicación de por qué uno se comporta de cierta manera es una lectura informada. El mecanismo a fondo está en nuestros artículos sobre cómo funciona ChatGPT y cómo funciona Claude por dentro.
| El modelo | El producto | |
|---|---|---|
| Qué es | Una red entrenada que convierte texto en más texto | La app que lo rodea: herramientas, memoria, búsqueda web, generación de imágenes, filtros de seguridad, interfaz |
| Claude | Opus 5.5, Sonnet 5.5, Haiku 5.5 y Fable 5.1, moldeados por la IA Constitucional | claude.ai, Claude Code y Claude in Chrome: búsqueda web, manejo de archivos, Artifacts, programación con agentes |
| ChatGPT | GPT-6 Sol y Luna en el chat, Astra para el razonamiento de Pro, moldeados por RLHF | La app de ChatGPT: generación de imágenes, voz, plugins, Work y Codex, muchas herramientas |
Cuando alguien dice «ChatGPT genera imágenes» o «Claude escribe código», casi siempre describe el producto, no el modelo en bruto. Separarlos marca la diferencia entre una comparativa que aguanta y una que envejece en cuanto cualquiera de las dos empresas lanza una función. Una carencia de hoy suele ser una decisión de producto, no un límite permanente del modelo.
Cómo busca cada uno en la web y cita sus fuentes
Los dos modelos dejan de aprender meses antes de que preguntes; lo que cambia es cómo llega cada uno a la web en vivo. Un modelo solo conoce el mundo hasta su fecha de corte de entrenamiento. La tabla de modelos de Anthropic da a todos los modelos actuales de Claude, Opus 5.5 y Fable 5.1 incluidos, un corte de conocimiento confiable de junio de 2026.
Las páginas de modelos de OpenAI dan a GPT-6 Sol el 20 de abril de 2026, a GPT-6 Luna el 18 de mayo de 2026 y a GPT-6 Astra el 30 de abril de 2026.
Todo lo más reciente, incluida la mayoría de los datos actuales sobre tu empresa, solo llega a cualquiera de los dos en el momento de la consulta: por la búsqueda web, el contexto que pegas, los archivos que subes o las fuentes conectadas.
El comportamiento web de ChatGPT se reparte entre bots distintos, y OpenAI documenta exactamente qué hace cada uno. GPTBot recopila datos de entrenamiento. OAI-SearchBot muestra páginas en los resultados de búsqueda de ChatGPT. ChatGPT-User visita una página en vivo cuando haces una pregunta que lo requiere.
Son interruptores independientes, por eso bloquear uno no bloquea los otros. La mecánica, y dónde se equivoca ChatGPT al atribuir, está en nuestros artículos sobre cómo cita fuentes ChatGPT y cómo funciona la búsqueda de ChatGPT.
La búsqueda web de Claude viene integrada en todos los planes, y desde Pro se añade un modo Investigación para indagaciones de varios pasos. Los profesionales cuentan que la investigación por defecto de Claude se siente más superficial que la de ChatGPT. El consejo más votado en el hilo de investigación más grande que leímos es activar el modo Investigación, decirle a Claude cuántas fuentes revisar (de 15 a 20) y que liste en qué discrepan, y subir el nivel de esfuerzo. Como alternativa, reunir las fuentes en ChatGPT y analizarlas en Claude.
Con su ventana de 1 millón de tokens, Claude también encaja bien cuando pegas un documento largo en su ventana de contexto y le pides que razone sobre él en lugar de sobre la web abierta.
Comprobamos nosotros mismos una cosa concreta: si cada modelo, con la búsqueda activada, encuentra la página del propio fabricante para un dato que cambió la última semana. A cada modelo le preguntamos dos veces una cuestión sobre un plan de OpenAI y otra sobre un plan de Anthropic. GPT-6 Sol citó la página de ayuda del fabricante todas las veces y acertó todas las cifras.
Claude Opus 5.5 acertó las cifras en 3 de 4 ejecuciones, pero citó una página del fabricante solo en 1 de 4. En las otras 3 se apoyó en páginas de terceros porque su búsqueda no devolvió ninguna del fabricante, y en una ejecución no pudo confirmar un precio.
Es una muestra pequeña con motores de búsqueda distintos. Tómala como un motivo para abrir la página citada, no como una clasificación; la prueba completa está más abajo.
Con la búsqueda web desactivada, cada modelo responde desde su memoria de entrenamiento congelada, y cualquiera de los dos puede inventar una cita segura y de aspecto auténtico que no existe. No es que mienta: es un fallo conocido en el que el modelo reconoce la forma de una fuente y rellena detalles plausibles, por eso los dos inventan artículos académicos y URL que nunca existieron.
Explicamos el mecanismo en alucinaciones de la IA. Activar la búsqueda web lo reduce mucho, pero no a cero: la cita que te da un modelo es una pista que verificar, nunca una garantía.
Claude vs ChatGPT para programar
En programación pesan más los productos que los modelos. El agente de programación de Claude es Claude Code, incluido desde el plan Pro; el de ChatGPT es Codex, disponible en todos los planes con una asignación limitada en Free y Go. Como los dos laboratorios ofrecen un agente completo junto a la ventana de chat, la mayoría de los desarrolladores elige un flujo de trabajo.
El dinero dice lo mismo. En el 2026 State of Enterprise AI de Menlo Ventures, publicado el 3 de noviembre de 2026, Claude Code y Codex suman juntos 24 000 millones de dólares, el 70 % de un mercado empresarial de programación con IA de 34 000 millones, frente a unos 1000 millones un año antes. Menlo no reparte esa estimación entre los dos laboratorios, y su encuesta a unos 400 responsables de decisiones de empresas de Estados Unidos se hizo en septiembre de 2026.
Menlo es además inversor de Anthropic. Tómalo como una medida de adopción. En su encuesta de consumo, entre quienes usan agentes, Codex llega al 35 % y Claude Code o Cowork al 32 %.
En la API, por millón de tokens de entrada y de salida, Claude Opus 5.5 cuesta 4 $ y 20 $ y GPT-6 Sol 2 $ y 10 $, mientras que Fable 5.1 y GPT-6 Astra cuestan los dos 10 $ y 50 $. La API se factura en dólares.
En los benchmarks, el panorama depende del entorno de prueba, como muestra la tabla de benchmarks más abajo. Lo que dicen los desarrolladores es más práctico. En Reddit, los modelos Opus de Claude se citan a menudo para problemas difíciles y planificación, sobre todo en planes de 100 $ o 103 € o más. Otros dicen que Codex y los modelos GPT más pequeños salen más baratos por tarea en los planes de unos 20 $ o 23 €, y varios opinan que la diferencia es pequeña y que conviene probar los dos durante un mes. Son testimonios de la comunidad.
Hicimos una pequeña prueba de programación propia. Los dos modelos recibieron la misma función de Python para la mediana, con errores, y la instrucción de corregir un promedio que faltaba, dejar de modificar la entrada y lanzar un error con una lista vacía. Pasamos cada respuesta por 6 pruebas unitarias. Claude Opus 5.5 y GPT-6 Sol superaron las 6, dos veces cada uno.
Una función de mediana es una tarea fácil, de modo que esto solo demuestra que los dos superan un listón básico. Para compararlos con el otro gran asistente de programación, mira Claude vs Copilot y Microsoft Copilot vs ChatGPT.
Claude vs ChatGPT para escribir, documentos largos y trabajo diario
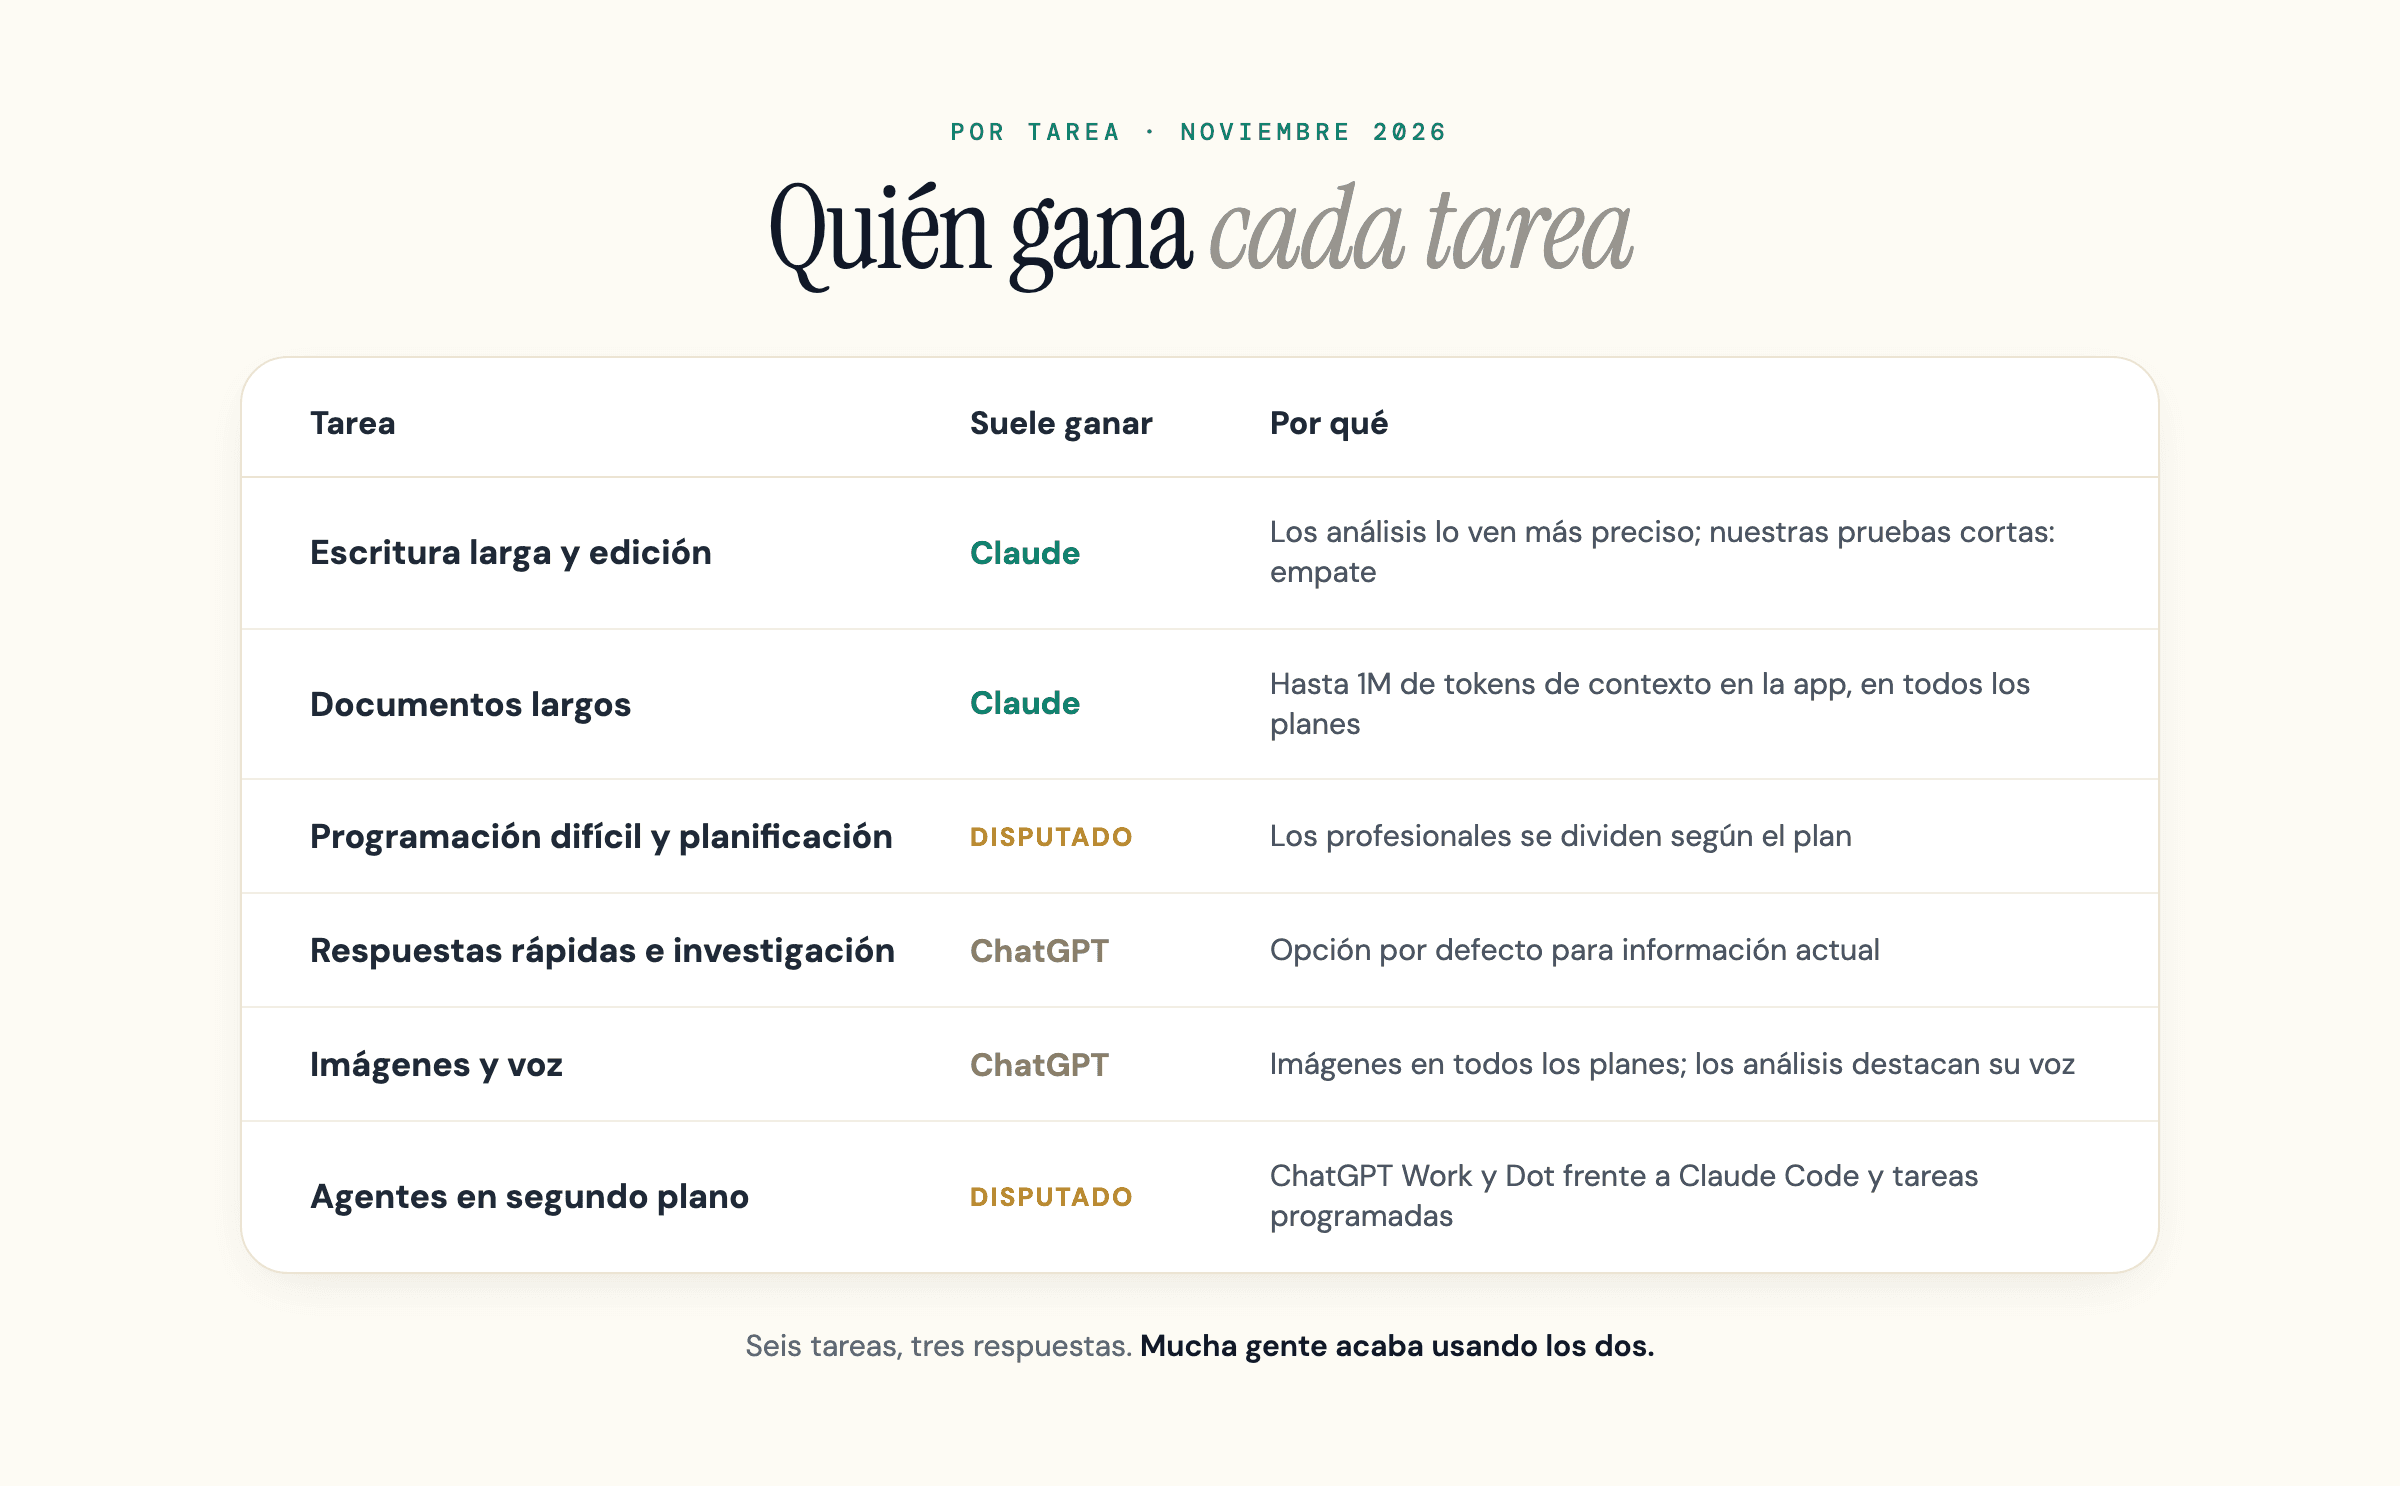
Ordenado por tarea, el panorama es más claro que cualquier ganador absoluto. Así suele quedar cada uno, con la advertencia que importa en cada caso.
| Tarea | Suele inclinarse por | Por qué | La advertencia |
|---|---|---|---|
| Escritura larga y edición | Claude | Análisis y profesionales describen una prosa más natural y con menos relleno | En nuestras pruebas cortas de edición y restricciones empataron |
| Razonar sobre tus propios documentos largos | Claude | Hasta 1 millón de tokens de contexto en la app en todos los planes, frente a 27K a 400K en ChatGPT según plan y modo | Un contexto anunciado no garantiza que el modelo recuerde bien todo su contenido |
| Programación difícil y planificación | Disputado | Los profesionales se dividen según el plan: Opus es la elección en planes de 100 $ o 103 € o más, y algunos ven Codex más barato por tarea en el nivel de unos 20 $ o 23 € | Ir primero en un benchmark no es ir primero en la implementación |
| Respuestas rápidas e investigación | ChatGPT | Los profesionales lo consideran la opción por defecto para información actual | El modo Investigación de Claude acorta la distancia desde Pro |
| Imágenes, voz, multimodal | ChatGPT | Generación de imágenes integrada; análisis como el de Zapier destacan su modo de voz avanzado | Claude también tiene modo de voz y crea diagramas y prototipos con Artifacts y Claude Design |
| Agentes que trabajan en segundo plano | Disputado | ChatGPT Work y Dot frente a Claude Code y las tareas programadas | Los dos cambian cada mes y miden el uso de forma distinta |
Al escribir, el consejo habitual es que Claude es el editor más afilado y que tiende a darte la razón, y por eso tienes que pedirle una crítica dura. Probamos la segunda parte en un caso. Les mostramos a los dos modelos un tuit de lanzamiento que prometía una app «100 % libre de errores» y «garantizada», y les pedimos que lo puntuaran y dijeran si convenía publicarlo.
Los dos le dieron 2 o 3 sobre 10 en las 4 ejecuciones, señalaron las exageraciones y desaconsejaron publicarlo tal cual. Un caso fácil no prueba ni desmiente una tendencia, pero es un motivo para no dar por hecho que alguno de los dos va a halagar un borrador claramente malo.
Con documentos largos, la diferencia es estructural. La página de precios de ChatGPT indica una ventana de contexto compartida por plan, 54K para los chats Instant en Plus y 256K para los de razonamiento, con menos espacio disponible para lo que tú escribes. Claude ofrece hasta 1 millón de tokens en todos sus planes. Es una diferencia real en cuánto puedes pegar de una vez, aunque no dice nada de lo bien que cada modelo lo aprovecha.
Agentes, imágenes, voz y plugins
La ventana de chat ya es solo la mitad de cada producto. Los dos fabricantes ofrecen agentes que trabajan más tiempo que una sola respuesta, y aquí es donde más han crecido las dos listas de funciones.
En el lado de ChatGPT, ChatGPT Work funciona en escritorio, web y móvil desde Plus (Free y Go tienen una versión limitada de escritorio). La página de precios de ChatGPT también incluye Proyectos y tareas programadas entre las funciones de Plus, Codex se encarga de las tareas de programación y Pro añade Dot, un agente siempre activo.
Work y Codex funcionan con sus propios modelos, entre ellos GPT-6.1 Sol y GPT-6.1 Terra, distintos de los del chat, según las notas de versión de OpenAI.
En el lado de Claude, Claude Code cubre la programación, Claude in Chrome y los conectores de Microsoft 365 cubren el trabajo en el navegador y la ofimática, y desde Pro se pueden delegar y programar tareas. Anthropic dice en su página del plan Ultra que puedes encargarle a Claude trabajos más largos, como informes, hojas de cálculo y presentaciones, y que sigue trabajando en segundo plano.
Los plugins sustituyen a los GPT personalizados. La nota de versión de OpenAI del 11 de septiembre anuncia que retirará los GPT personalizados en todos los planes y los pasará a plugins, que combinan instrucciones reutilizables con apps conectadas, y sus preguntas frecuentes sobre la retirada fijan la fecha en el 11 de diciembre de 2026 (el 11 de febrero de 2027 para FedRAMP y algunos espacios Enterprise aprobados).
Los GPT existentes siguen funcionando hasta entonces. Los equivalentes más cercanos en Claude son los Proyectos, que guardan archivos e instrucciones compartidos, y las Skills. Si montaste un proceso de negocio sobre un GPT personalizado, planifica la migración ya.
En imágenes y voz, ChatGPT sigue por delante. Images 2.6, lanzado el 4 de noviembre, añade la creación de GIF (en despliegue a 6 de noviembre) e imágenes de referencia guardadas, y la generación de imágenes está en todos los planes. Un nuevo modelo de voz, GPT-Live-1.1, llegó el 15 de octubre con acentos más naturales y voces nuevas en francés, alemán, hindi, japonés, coreano y español de México. Claude también tiene modo de voz en todos los planes, pero su página de planes no incluye ningún generador de imágenes.
Lo que sí tiene es Claude Design, lanzado el 17 de abril de 2026 para prototipos, presentaciones y documentos de una página, que es un trabajo distinto de generar una foto o una ilustración. Los profesionales lo dicen más claro: Claude no genera imágenes y tiene la voz más floja, y ChatGPT es el todoterreno.
Los probamos: 6 tareas cortas, mismos prompts
Hicimos nuestra propia prueba de 6 tareas. El 6 de noviembre de 2026 enviamos los mismos 6 prompts, dos veces cada uno, a Claude Opus 5.5, el modelo con el que Anthropic recomienda empezar para la mayoría de los usos, y a GPT-6 Sol, el modelo del chat de ChatGPT en Plus. Las consultas pasaron por la API de DataForSEO, que integra la búsqueda web propia de cada fabricante.
Escribimos los prompts y las reglas de puntuación antes de la primera ejecución. Unos scripts puntuaron 3 tareas (número de palabras, datos obligatorios, pruebas unitarias), y las 3 abiertas las calificaron a ciegas 2 evaluadores de IA independientes, con las respuestas anonimizadas y mezcladas (un modelo Opus y otro Sonnet, los dos de Anthropic). No sabían qué modelo había escrito cada respuesta, aunque algunos enlaces citados llevaban parámetros de seguimiento de OpenAI que no quitamos, por lo que el anonimato no fue perfecto. Coincidieron en todas las notas máximas.
| Tarea | Qué comprueba | Claude Opus 5.5 (nota máxima) | GPT-6 Sol (nota máxima) |
|---|---|---|---|
| 1. Acortar un párrafo | 45 palabras o menos, conservando 6 nombres y cifras | 2 de 2 | 2 de 2 |
| 2. Cumplir restricciones estrictas | Tres frases de 12 palabras, sin comas, sin punto y coma y sin la letra q | 2 de 2 | 2 de 2 |
| 3. Arreglar una función de Python | 6 pruebas unitarias sobre una función de mediana | 2 de 2 | 2 de 2 |
| 4a. Consultar los precios de ChatGPT Pro | Cifras correctas, el cambio del 29 de octubre, una URL de OpenAI como fuente | 0 de 2 | 2 de 2 |
| 4b. Consultar Claude Ultra | Cifras correctas, el cambio de nombre de Max 20x, una URL de Anthropic como fuente | 0 de 2 | 2 de 2 |
| 5. Juzgar un tuit malo | Nota baja, señala las exageraciones, desaconseja publicarlo | 2 de 2 | 2 de 2 |
| Total | 8 de 12 | 12 de 12 |
Las dos tareas de consulta explican toda la diferencia, y la diferencia está sobre todo en la búsqueda. Para la nota máxima había que citar la página del propio fabricante. GPT-6 Sol hizo búsquedas restringidas a los sitios de ayuda de los fabricantes y encontró la página del fabricante todas las veces.
Claude Opus 5.5 hizo una búsqueda amplia por pregunta, encontró una página del fabricante solo en 1 de 4 ejecuciones y lo dijo en lugar de citar una página que no había visto. Dio con las cifras correctas en 3 de 4 ejecuciones, pero en la que sí citó una página del fabricante no pudo confirmar un precio, de modo que ninguna de sus 4 consultas obtuvo la nota máxima.
En las otras cuatro tareas los dos fueron indistinguibles, y eran tan fáciles que ambos aprobaron todas las ejecuciones y marcan un mínimo.
Lo que esto no demuestra importa igual. El endpoint de DataForSEO que usamos limita los prompts a 500 caracteres, por lo que no hay ninguna tarea con un documento largo, y no afirmamos nada sobre escritura larga ni sobre razonar con archivos grandes.
2 ejecuciones por celda es una muestra pequeña, los modelos usaron por esa API herramientas de búsqueda distintas de cada fabricante, que pueden comportarse de otra forma que en su propia app, y se llamaron sin las instrucciones de sistema ni las herramientas que añade cada app. Toma la tabla como una comprobación puntual reproducible.
Qué dicen los benchmarks (léelos con escepticismo)
Los benchmarks muestran qué modelos están en la franja de vanguardia, no cuál usar cada día. Sirven para lo primero y casi nada para elegir tu herramienta diaria. Así están los principales en noviembre de 2026.
| Benchmark | Qué mide | Líder informado | Léelo con |
|---|---|---|---|
| SWE-bench Verified | Resolver incidencias reales de GitHub (programación) | Claude va por delante, pero el tablero público no añade resultados desde el 26 de febrero de 2026 y su entrada más reciente de Claude es Opus 4.6. Mejor resultado con cualquier configuración: 79,2 % (Claude 4.5 Opus). En la vista por defecto, con un entorno estándar, Claude 4.5 Opus lidera con 76,8 %, con Gemini 3 Flash y MiniMax M2.5 empatados a un punto aproximadamente | Las puntuaciones dependen mucho del entorno de prueba. La system card de Opus 5 de Anthropic da un 96,0 % en Verified con su propia configuración, para un modelo que el tablero nunca evaluó. La de Opus 5.5 cambió Verified por SWE-bench Pro (89,9 %) y Multilingual (93,9 %), y la página de GPT-6 Astra de OpenAI no da ninguna puntuación de SWE-bench |
| GPQA Diamond | Preguntas de ciencia de nivel de posgrado (razonamiento) | GPT-6 Astra lidera con 96,0 %, con Gemini 3.8 Flash en 95,3 % y Claude Fable 5.1 en 93,7 %, pero estas cifras salen de la tabla comparativa de la propia OpenAI; Anthropic no publica una puntuación GPQA para su modelo insignia | Las puntuaciones están cerca del techo, de modo que las diferencias pequeñas parecen mayores de lo que son |
| Arena | Votos de preferencia humana cara a cara | Gemini 4 Carbon (preliminar) y Argon, de Google, ocupan los 2 primeros puestos en texto (captura del 27 de octubre de 2026), con Claude Opus 5.5 tercero y Fable 5.1 quinto; la mejor entrada de OpenAI, GPT-5.6 Sol, aparece en el puesto 22 | Mide lo que la gente prefiere, no lo que es correcto |
| OSWorld | Control del equipo y tareas con agentes | Claude Opus 5 lidera el tablero oficial de OSWorld 2.0 en el conjunto offline v2026.08.08: 70,2 % parcial frente al 64,1 % de GPT-5.6 Sol. La tabla de Astra de OpenAI, que recoge el 70,2 % de Opus 5, sitúa a GPT-6 Astra por delante con 72,6 % en ese conjunto. Anthropic da un 81,8 % para Opus 5.5 con archivos de tareas actualizados y su propio entorno, y dice que no es directamente comparable con otras versiones | Un benchmark joven y ruidoso que se mueve mucho de una versión a otra |
Varias cosas hacen que estas cifras no signifiquen lo que parecen. Primero, la mayoría de las puntuaciones de programación que se destacan las declaran los propios laboratorios, y el mismo modelo puede variar de 5 a 10 puntos según el andamiaje que lo rodea. Segundo, los test de conocimiento general más antiguos, como MMLU, están prácticamente saturados, y las tablas de lanzamiento más recientes de los laboratorios ya no los incluyen; ya no separan a los mejores modelos.
Tercero, el liderazgo cambia casi cada mes a medida que cada laboratorio lanza algo, por lo que cualquier cifra es una foto fija. Cuarto, Arena premia las respuestas que la gente prefiere, lo que se relaciona con la calidad pero también premia respuestas seguras, complacientes y bien formateadas que no siempre son correctas.
La conclusión práctica es aburrida pero cierta: en noviembre de 2026, los modelos de vanguardia de los dos laboratorios están tan cerca que las diferencias en los benchmarks rara vez deciden un flujo de trabajo real. El benchmark que cuenta es tu propio flujo de trabajo, medido con los dos.
Privacidad, deriva y otras trampas
Dos cosas que las tablas de funciones dejan fuera importan más que casi cualquier especificación.
Privacidad. A noviembre de 2026, los dos fabricantes te dejan desactivar el entrenamiento con tus chats de consumo: la página de precios de ChatGPT indica «Opción de exclusión» en todos los planes individuales, y la de Claude marca el entrenamiento de modelos como «Opt-out» en Free, Pro, Max y Ultra. Anthropic cambió su política de entrenamiento de consumo en otoño de 2025, anunciada el 28 de agosto de 2025, de modo que lo que recuerdes sobre que Claude no entrenaba con tus datos puede estar desactualizado.
No hay excepción europea a ese valor por defecto: la versión para el EEE de las condiciones de consumo de Anthropic y la política de privacidad europea de OpenAI aplican la misma regla a los usuarios de España y del resto de la UE. Lo que Europa añade es una segunda salida: como OpenAI basa el entrenamiento en el interés legítimo, aquí también puedes oponerte al amparo del artículo 21 del RGPD, además de usar el ajuste del propio producto.
Aquí vivir en España o en Latinoamérica cambia lo que puedes hacer al respecto. En España y en el resto del Espacio Económico Europeo, el RGPD te da derechos exigibles frente a las dos empresas, como acceso, rectificación, supresión y oposición, con la Agencia Española de Protección de Datos como autoridad ante la que reclamar. En México, Argentina y Colombia existen autoridades de protección de datos (la AAIP en Argentina y la SIC en Colombia, que ya investigó a ChatGPT en 2023; en México, el marco se renovó en 2025 tras la desaparición del INAI), aunque los derechos y las vías de reclamación varían de un país a otro (Argentina, por ejemplo, cuenta con una decisión de adecuación de la Comisión Europea), por lo que conviene consultar las reglas de cada país.
El uso profesional se trata aparte: OpenAI dice que no entrena con los datos de un espacio de trabajo de ChatGPT Business, y el cambio de Anthropic no se aplicó a los servicios bajo sus Commercial Terms, API incluida. Si tu trabajo es sensible, usa un nivel business o revisa los ajustes de datos del que utilices.
Deriva. Los dos modelos cambian sin avisarte. Salen versiones nuevas, se retiran otras, y es habitual que la gente diga que un modelo rinde peor tras una actualización, a veces por un cambio real y a veces por pura percepción. De ChatGPT se dice que suena igual de seguro tenga o no razón, y de Claude que te da la razón, aunque nuestra única prueba de arriba no lo mostró. Vuelve a probar tu propio flujo de trabajo tras cada actualización importante en lugar de fiarte del veredicto del trimestre pasado.
¿En cuál debería aparecer tu marca?
Si publicas o vendes algo, la pregunta que da dinero no es qué herramienta usas. Es cuál nombra tu marca cuando tu cliente pregunta. ChatGPT y Claude ya son motores de respuesta. La gente les pregunta qué producto comprar, qué agencia contratar, qué herramienta es la mejor, y la respuesta del modelo te incluye o no.
No es un comportamiento marginal, y el caso medido más claro hasta ahora es la propia búsqueda de Google. Un estudio del Pew Research Center de 2025 encontró que, cuando aparecía un resumen de IA en los resultados de Google, los usuarios de Estados Unidos hacían clic en un enlace tradicional solo en el 8 % de las visitas, frente al 15 % sin resumen, más o menos la mitad.
Ese estudio mide los AI Overviews de Google, no ChatGPT ni Claude. Toma el mismo cambio en los asistentes de IA como una hipótesis que vale la pena medir: si cada vez se consumen más respuestas sin clic, estar dentro de la respuesta importa más que posicionarse debajo de ella.
La trampa es que aparecer en un motor no significa aparecer en otro, y Gemini y Grok suman más fuentes, de lo que hablamos en Claude vs Gemini, Gemini vs ChatGPT, Grok vs Claude y Grok vs ChatGPT. Para la propia consulta, los AI Overviews de Google se apoyan en videos y publicaciones de profesionales: en los datos de LLM Mentions de DataForSEO para consultas de Estados Unidos que contienen «claude vs chatgpt», revisados el 6 de noviembre de 2026, YouTube aparecía citado en 175 menciones, Reddit en 91, Towards AI en 74 y Zapier en 66. Una comparativa clara, fechada y con un veredicto compite con esas fuentes, no sobre todo con las páginas de los fabricantes.
Los dos motores se basan en la misma maquinaria de cómo funciona la búsqueda con IA, pero la ponderan de forma distinta, y cada uno necesita su propio enfoque.
Para que te cite cualquiera de los dos, haz que tu página sea fácil de encontrar y fácil de extraer: HTML estático y limpio que un bot pueda rastrear, encabezados en forma de pregunta, una tabla fechada y cada dato dicho con claridad y con su fuente al lado. Nuestra prueba de consulta es el ejemplo práctico: GPT-6 Sol encontró la página de ayuda del fabricante todas las veces porque una búsqueda restringida al sitio podía llegar a ella.
Las guías completas están en aparecer en ChatGPT y conseguir que Claude te cite. Una página pensada solo para el posicionamiento clásico en Google puede ser invisible en los dos.
No puedes controlar qué modelo abre un cliente, y el campo se amplía más allá de estos dos con alternativas de pesos abiertos como Kimi y DeepSeek. Tampoco controlas el azar de cada respuesta: la misma pregunta puede citarte una vez y saltarte la siguiente.
Lo que sí puedes hacer es convertir tu página en la fuente más clara y con más autoridad sobre la pregunta, y luego medir cuántas veces te cita de verdad cada motor y corregir los huecos.
Seguir tu cuota de voz en la IA por motor es mejor que adivinar.
Cómo los usamos, y por qué el bucle importa más que el modelo
Una nota sobre de dónde sale esto. Llevamos una agencia de SEO, construimos una herramienta de GEO llamada geotoolbox y hacemos investigación de seguridad, y la mayor parte de ese trabajo ocurre en Claude a través de Claude Code, con los modelos de OpenAI haciendo una segunda pasada a través de Codex. Así que esto no es una comparación de fichas técnicas. Es cómo los usamos en nuestro propio trabajo.
Lo que aprendimos a base de golpes es que el modelo importa menos que el bucle que lo rodea. Un modelo que revisa su propio trabajo tiende a releer su error y aprobarlo, porque el mismo punto ciego que causó el fallo es el que revisa. La solución es una segunda pasada crítica, mejor de otra familia de modelos, porque un modelo distinto falla en sitios distintos.
En la práctica, Claude Code construye y los modelos de OpenAI, a través de Codex, lo revisan en modo de solo lectura. Tratamos cada hallazgo de Codex como una pista que verificar contra el archivo y una fuente primaria, nunca como un veredicto, porque un segundo modelo también se equivoca con seguridad las veces suficientes como para meter sus propios errores.
Por eso nunca publicamos un primer borrador. Sea un artículo, una línea de código en producción o un hallazgo de seguridad, pasa por varias revisiones duras e independientes antes de darlo por bueno. Esta versión pasó por el mismo bucle: un primer borrador, luego revisores independientes y una pasada aparte con otro modelo antes de publicarse. Enfrentamos a Claude y a los modelos de OpenAI a propósito.
Elige el modelo que encaje con la tarea y después deja de fiarte de una sola respuesta. Es la misma razón por la que medimos la visibilidad en IA repitiendo muchas veces en lugar de fiarnos de una sola comprobación.
Entonces, ¿Claude o ChatGPT? Cómo decidir
Elige por tarea y por plan, no por clasificación. Los dos tienen nivel gratuito, por lo que la forma más barata de resolver el debate para tu trabajo es pasar la misma tarea real por los dos y quedarte con el que menos te frene.
| Si este es tu caso | Empieza con | Por qué |
|---|---|---|
| Escribes, editas o razonas sobre documentos largos | Claude Pro, 20 $ | Hasta 1 millón de tokens de contexto en la app en todos los planes |
| Programas y puedes gastar 100 $ o más al mes | Claude Max o Ultra con Claude Code | Los profesionales lo citan a menudo para problemas difíciles |
| Programas con el presupuesto del nivel estándar | ChatGPT Plus con Codex, 23 € | Algunos profesionales dicen que rinde más por tarea; prueba Claude Pro un mes antes de decidir |
| Necesitas imágenes o voz | ChatGPT Plus, o Go por 8 € para un uso ligero | Generación de imágenes y voz en todos los planes de ChatGPT, y la página de planes de Claude no incluye ningún generador de imágenes |
| Quieres el nivel superior más grande | ChatGPT Pro 500 | La escalera de Claude termina en Ultra, 200 $ |
| Haces todo lo anterior | Los dos planes estándar | En Reddit, los profesionales suelen recomendar repartir el trabajo por tarea |
Para una empresa, la cuenta es distinta y no tiene nada que ver con qué modelo es más listo. Tus clientes usan asistentes distintos, de modo que la pregunta que mueve ingresos es cuál te cita cuando alguien pregunta por tu categoría, y cómo quedas frente a tu competencia.
Ese es el hueco que cubre geotoolbox. Seguimos lo que ChatGPT, Claude y los demás motores dicen y citan de verdad sobre tu marca, por motor y a lo largo del tiempo, para que veas dónde apareces, dónde un competidor se queda la respuesta y qué corregir.
Puedes empezar con una comprobación gratuita de preparación para la IA para ver si estos motores pueden siquiera leer tu sitio, y luego seguir tu presencia en todos ellos en el domain overview. Los modelos seguirán turnándose el liderazgo. Que te mencionen es la parte en la que puedes trabajar.
Preguntas frecuentes
¿Es mejor Claude o ChatGPT en 2026?
Depende de la tarea. A noviembre de 2026, análisis como el de Zapier prefieren Claude para la escritura creativa, y su ventana de 1 millón de tokens encaja con documentos largos. La mayoría de los análisis sitúan a ChatGPT por delante en imágenes, voz, búsqueda rápida y herramientas integradas, y en programación los profesionales se dividen según el nivel del plan.
En nuestra breve prueba por API los modelos empataron al editar, al cumplir restricciones, al programar y al dar una opinión honesta, mientras que GPT-6 Sol encontró de forma más confiable la página del propio fabricante en las consultas de precios. Mucha gente usa los dos y cambia según la tarea.
Claude o ChatGPT: ¿cuál es más barato?
En el nivel estándar cuestan casi lo mismo: Claude Pro aparece en su web a 20 $ al mes sin impuestos y ChatGPT Plus a 23 € en la web para España (a 7 de noviembre de 2026). ChatGPT tiene además un nivel gratuito con chats de texto ilimitados y el plan Go por 8 €, que puede mostrar anuncios. Arriba, Claude termina en Max (100 $) y Ultra (200 $), mientras que ChatGPT Pro empieza en 103 € y tiene tres niveles (Pro 100, Pro 200 y Pro 500).
La diferencia práctica más grande son los límites de uso. Claude mide todo en ventanas de 5 horas y semanales (las cuentas Ultra verificadas no tienen ventana de 5 horas, solo límites semanales), OpenAI mide Codex del mismo modo, ChatGPT deja el chat diario ilimitado con protección contra abusos, y quien lo usa mucho puede chocar con el límite en cualquiera de los dos. En la API, los precios por token varían según el modelo y cambian a menudo. Revisa los de cada proveedor antes de presupuestar.
¿Debería cambiarme de ChatGPT a Claude?
Normalmente lo mejor es sumar, no cambiar. Son buenos en cosas distintas y los dos tienen nivel gratuito, por lo que no pierdes nada si mantienes ChatGPT para imágenes, voz y amplitud mientras pruebas Claude para escribir y para documentos largos. Cámbiate del todo solo si tu trabajo está casi entero en los puntos fuertes de un modelo y los límites de uso o las carencias del otro te estorban de verdad.
¿Importa en cuál aparece mi marca?
Sí, porque tus clientes usan asistentes distintos, y que te mencionen en uno no significa que te mencionen en los demás. A medida que la gente obtiene más respuestas sin hacer clic, estar dentro de la respuesta se convierte en la visibilidad que antes daba el posicionamiento. El paso práctico es medir cuántas veces te cita cada motor, por motor y a lo largo del tiempo, y corregir los huecos en lugar de adivinar.
Fuentes
- Anthropic - IA Constitucional: inocuidad a partir del feedback de una IA -
anthropic.com/research/constitutional-ai-harmlessness-from-ai-feedback - OpenAI - visión general de los rastreadores de OpenAI (GPTBot, OAI-SearchBot, ChatGPT-User) -
developers.openai.com/api/docs/bots - Anthropic - resumen de modelos de Claude (modelos actuales, ventanas de contexto, cortes de conocimiento) -
platform.claude.com/docs/en/about-claude/models/overview - Anthropic - precios, web en español, consultada el 7 de noviembre de 2026 desde una IP española -
claude.com/es/pricing - Anthropic Help Center - What is the Ultra plan?, What is the Max plan?, What is the Pro plan?, What is the Team plan? (modificadas el 30 de octubre de 2026) -
support.claude.com/en/articles/17728952-what-is-the-ultra-plan - Anthropic - Updates to Consumer Terms and Privacy Policy, 28 de agosto de 2025 -
anthropic.com/news/updates-to-our-consumer-terms - OpenAI - planes y precios de ChatGPT, web para España, consultada el 7 de noviembre de 2026 desde una IP española -
chatgpt.com/es-ES/pricing - OpenAI Help Center - notas de versión de ChatGPT (entradas del 11, 22 y 29 de septiembre, del 7, 15, 26 y 29 de octubre y del 4 de noviembre de 2026) -
help.openai.com/en/articles/6825453-chatgpt-release-notes - OpenAI Help Center - About ChatGPT Pro tiers; What is ChatGPT Plus?; ChatGPT Business overview -
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - OpenAI Help Center - Ads in ChatGPT -
help.openai.com/en/articles/20001047-ads-in-chatgpt - OpenAI Help Center - Using Codex with your ChatGPT plan; Custom GPT retirement and migration FAQ -
help.openai.com/en/articles/11369540-using-codex-with-your-chatgpt-plan - OpenAI - API credits for ChatGPT subscribers -
developers.openai.com/api/docs/guides/chatgpt-api-credits - OpenAI - páginas de los modelos GPT-6 Astra, GPT-6 Sol y GPT-6 Luna -
developers.openai.com/api/docs/models/gpt-6-astra.md - OpenAI - Europe Privacy Policy (entrenamiento, derecho de oposición) -
openai.com/policies/eu-privacy-policy - Menlo Ventures - 2026: The State of Enterprise AI, 3 de noviembre de 2026 -
menlovc.com/perspective/2026-the-state-of-enterprise-ai - Menlo Ventures - 2026: The State of Consumer AI, 16 de septiembre de 2026 -
menlovc.com/perspective/2026-the-state-of-consumer-ai - Zapier - Claude vs. ChatGPT: Which is best? -
zapier.com/blog/claude-vs-chatgpt - DataForSEO - LLM Mentions API (fuentes de los AI Overviews de Google para consultas con «claude vs chatgpt», Estados Unidos), consultada el 6 de noviembre de 2026 -
dataforseo.com/apis/ai-optimization-api - MacRumors - Anthropic Debuts Claude Design, 17 de abril de 2026 -
macrumors.com/2026/04/17/anthropic-claude-design - Reddit - r/ChatGPT, I switched back to ChatGPT from Claude, septiembre de 2026 -
reddit.com/r/ChatGPT/comments/1w79n3c - Superintendencia de Industria y Comercio - SIC pone la lupa a ChatGPT, 15 de mayo de 2023 -
sedeelectronica.sic.gov.co/international-relations/sic-puts-spotlight-application-chat-gpt-determine-if-it-complies-regulation-personal-data-protection - Comisión Europea - decisiones de adecuación (Argentina) -
commission.europa.eu/law/law-topic/data-protection/international-dimension-data-protection/adequacy-decisions_en - SWE-bench - benchmark de ingeniería de software -
swebench.com - Arena - ranking de preferencia humana de modelos de lenguaje, captura del 27 de octubre de 2026 -
arena.ai/leaderboard/text - Pew Research Center - los usuarios de Google hacen menos clic cuando aparece un resumen de IA -
pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results - Anthropic - Claude Opus 5.5, 22 de septiembre de 2026 -
anthropic.com/news/claude-opus-5-5 - Anthropic - system cards de Claude Opus 5.5 (22 de septiembre de 2026) y Claude Opus 5 (24 de julio de 2026) -
anthropic.com/claude-opus-5-5-system-card,anthropic.com/claude-opus-5-system-card - OpenAI - GPT-6 Astra, 3 de septiembre de 2026 -
openai.com/index/gpt-6-astra - Equipo de OSWorld - clasificación de OSWorld 2.0 -
osworld-v2.xlang.ai - OpenAI - Introducing GPT-6 Sol and Luna, 22 de septiembre de 2026 -
openai.com/index/introducing-gpt-6-sol-and-luna