
El SEO técnico decide si los buscadores pueden llegar a tus páginas, renderizarlas e indexarlas: es la base en la que se apoyan el contenido y los enlaces. En 2026 atiende a dos públicos. Por un lado, Googlebot, que renderiza JavaScript y alimenta tanto los resultados clásicos como las Vistas creadas con IA. Por otro, los rastreadores de IA de OpenAI, Anthropic y Perplexity, que a menudo leen solo el HTML que envía tu servidor.
Los sitios pierden visibilidad sin querer justo en las reglas que difieren: qué token de robots.txt controla el entrenamiento y cuál la búsqueda con IA, si un bot ejecuta JavaScript y qué ajuste te saca de las Vistas creadas con IA.
Lo que debes saber
- El SEO técnico hace que una página sea accesible, renderizable e indexable: para Google, eso quiere decir que Googlebot puede acceder a ella, que devuelve un código HTTP 200 y que tiene contenido indexable; cumplir esas tres condiciones únicamente la hace apta para aparecer.
- Googlebot ejecuta JavaScript y la mayoría de los rastreadores de IA no: según las mediciones publicadas, los de OpenAI, Anthropic y Perplexity leen sobre todo el HTML sin renderizar, con la excepción de OAI-SearchBot en algunos sitios.
- Bloquear GPTBot o ClaudeBot no te saca de la búsqueda de ChatGPT ni de Claude, y Google-Extended no cambia tu presencia en las Vistas creadas con IA: cada uso tiene su propio token.
- En España, las Vistas creadas con IA se muestran desde el 26 de marzo de 2025 y el Modo IA empezó a desplegarse el 8 de octubre de 2025: tus páginas deben estar indexadas y ser aptas para un fragmento, y el ajuste «IA generativa en la Búsqueda» de Search Console tiene que seguir activado.
- La ley española permite reservar el uso de tus contenidos frente a la minería de textos y datos con «medios de lectura mecánica u otros medios que resulten adecuados» (artículo 67 del Real Decreto-ley 24/2021). El texto no nombra el robots.txt, y en la búsqueda del CENDOJ del 15 de noviembre de 2026 no encontramos resoluciones españolas que lo aclaren.
¿Qué es el SEO técnico?
El SEO técnico es el conjunto de tareas que permite que los buscadores y los rastreadores de IA lleguen a tus páginas, las rendericen, las indexen y las muestren.
Para Google, una página debe ser accesible para Googlebot, devolver un código HTTP 200 y tener contenido indexable. Google llama a esto los requisitos técnicos de la Búsqueda, y cumplirlos solo hace que la página sea apta para aparecer.
El SEO se divide tradicionalmente en tres áreas:
| Área | Qué abarca | Tareas típicas | Quién suele encargarse |
|---|---|---|---|
| SEO técnico | Acceso, renderizado, indexación, estructura del sitio y velocidad | Reglas de robots.txt, códigos de estado, canonicals, sitemaps, Core Web Vitals, datos estructurados | SEO y un desarrollador |
| SEO on page | Lo que dice cada página y cómo está etiquetada | Cobertura del tema, etiquetas de título, encabezados, texto ancla de los enlaces internos | SEO y un redactor |
| SEO off page | Señales que llegan de otros sitios | Backlinks, menciones de marca, reseñas | SEO, relaciones públicas y alianzas |
Cómo procesan una página Google y los rastreadores de IA
Google funciona con un único pipeline. Procesa las páginas con JavaScript en tres fases: rastreo, renderizado e indexación; el renderizado queda en cola tras la primera descarga y se ejecuta en un Chromium sin interfaz. Las Vistas creadas con IA y el Modo IA toman sus enlaces de apoyo de ese mismo índice de la Búsqueda, y por eso Google dice que se les aplican los requisitos normales de la Búsqueda.
Cómo se reparten los rastreadores de IA según su uso
Las empresas de IA dividen su rastreo según el uso, y cada uso tiene su propio user-agent:
- Rastreadores de entrenamiento: recopilan páginas para entrenar modelos (GPTBot, ClaudeBot)
- Rastreadores de búsqueda: construyen el índice que alimenta un producto de búsqueda con IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot)
- Accesos a petición del usuario: cargan una página porque alguien preguntó por ella en ese momento (ChatGPT-User, Claude-User, Perplexity-User)
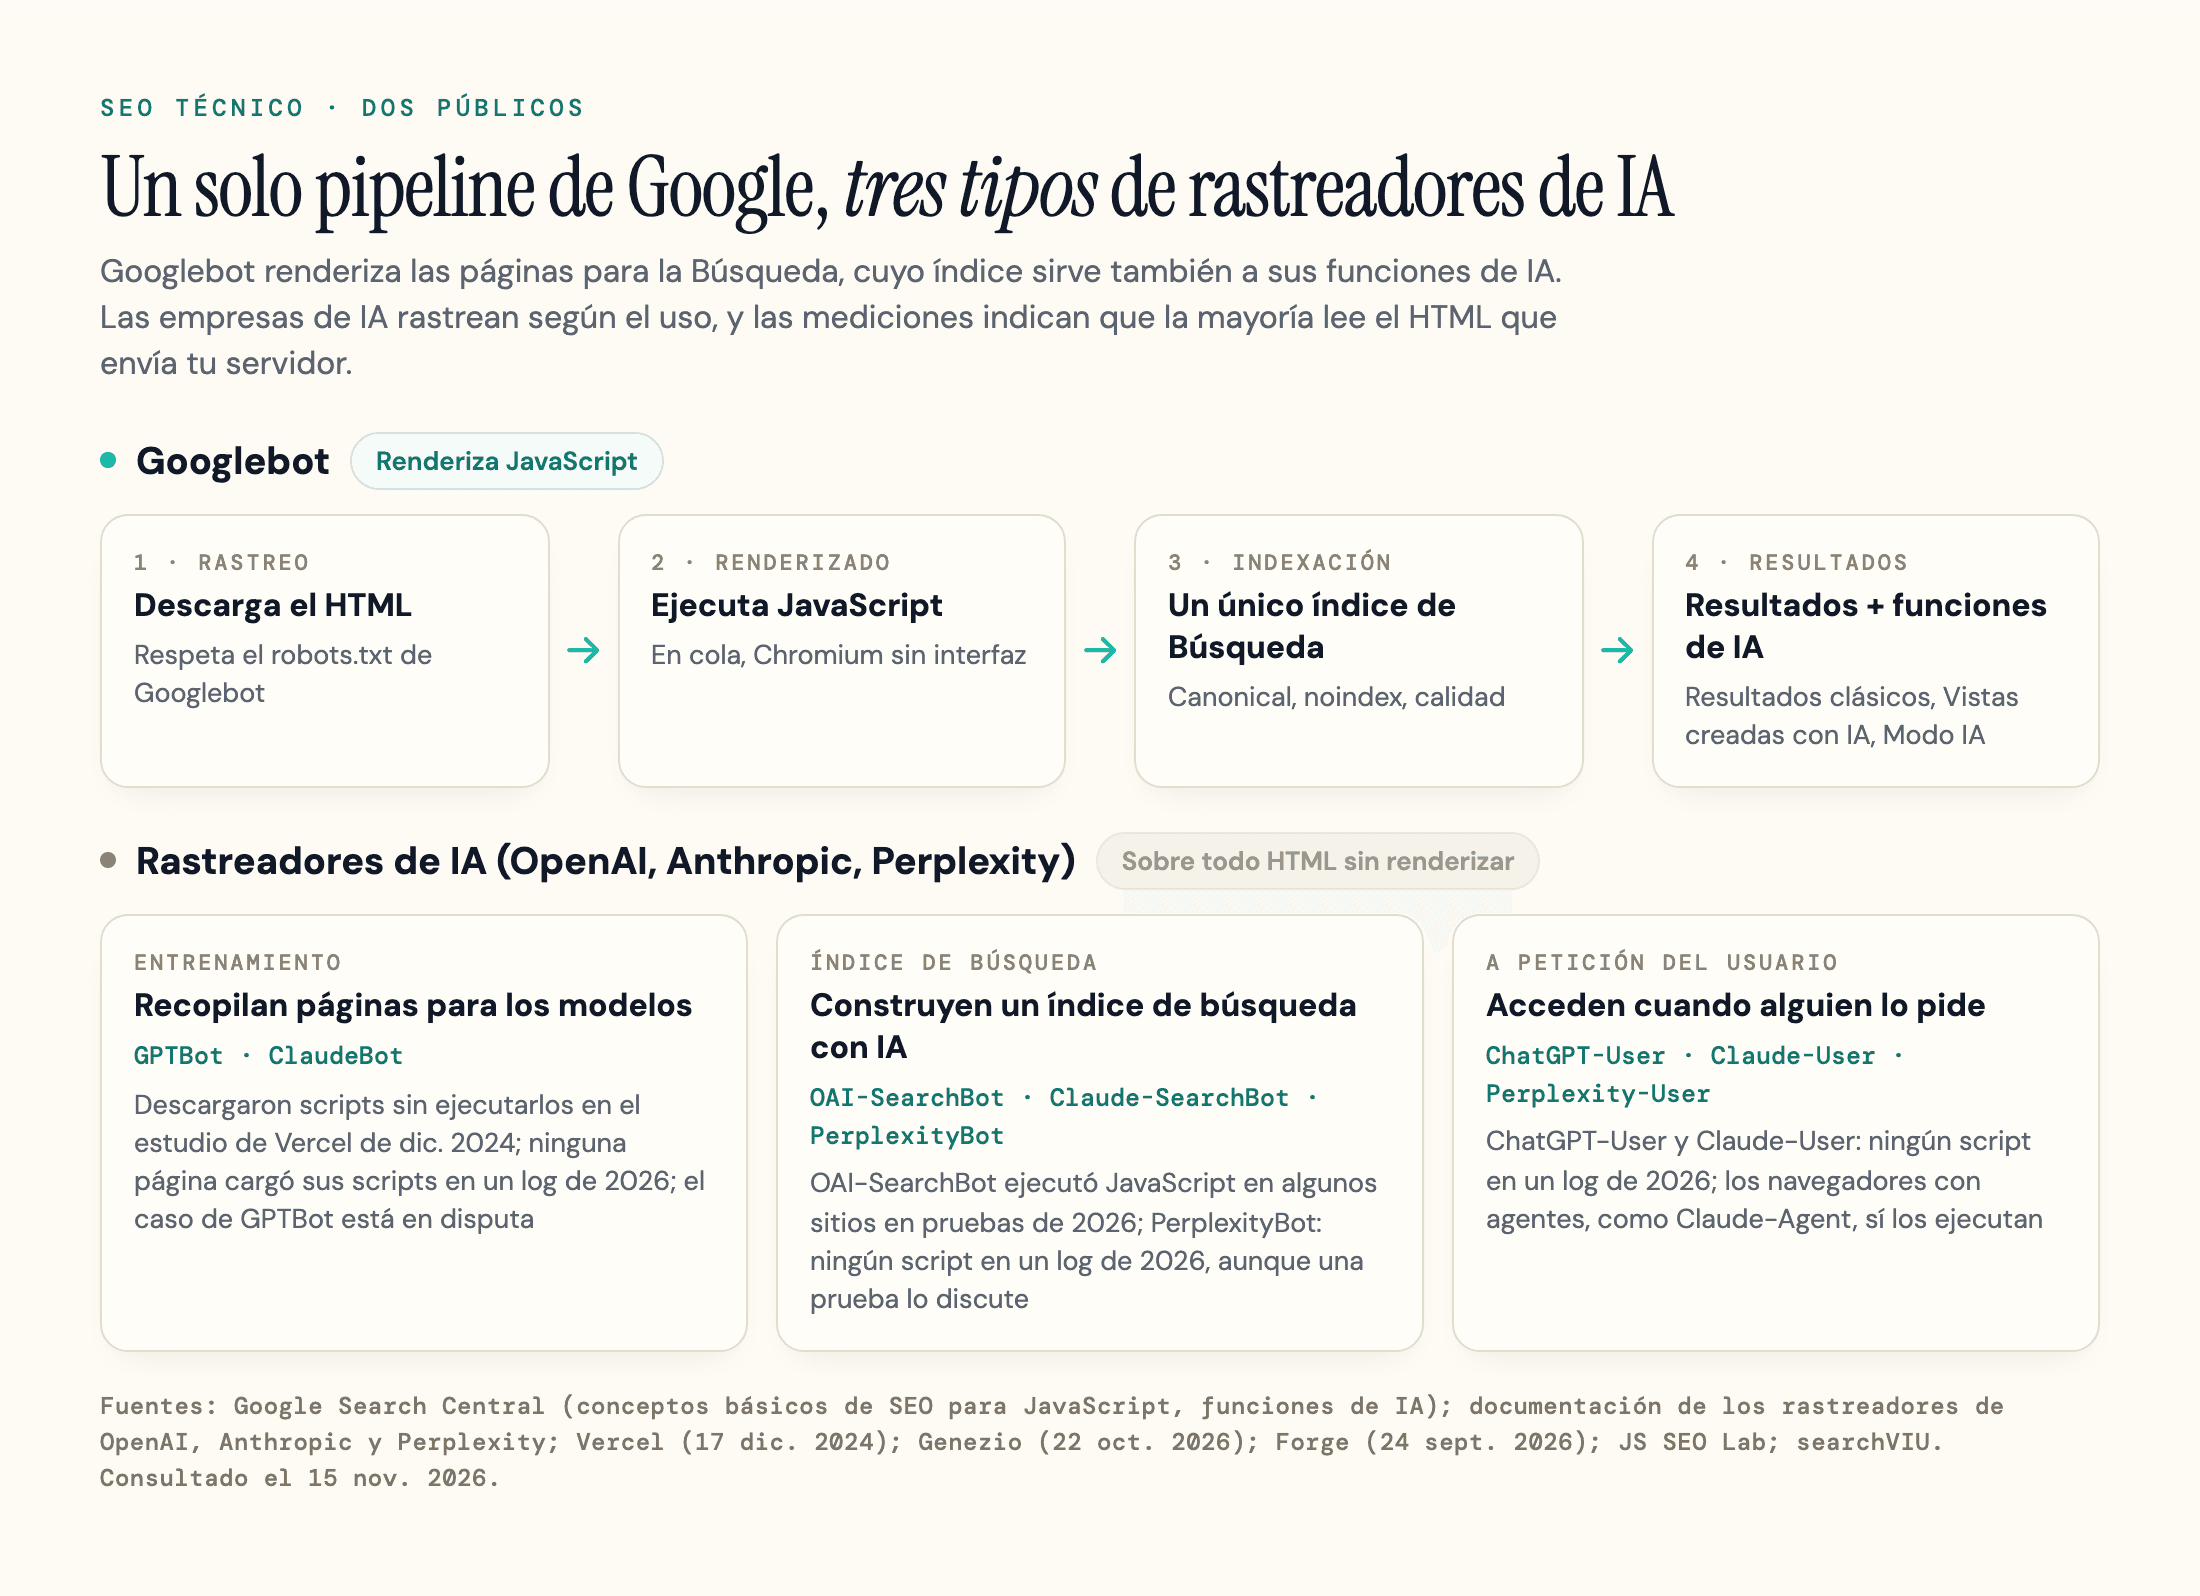
La diferencia práctica está en lo que lee cada uno. Googlebot indexa la página renderizada, mientras que las mediciones indican que los rastreadores de OpenAI, Anthropic y Perplexity leen sobre todo el HTML que envía tu servidor (el rastreador de búsqueda de OpenAI es una excepción en algunos sitios). Para ver cada user-agent, consulta nuestra lista de rastreadores de IA.
Google frente a los rastreadores de IA: la matriz de requisitos
Las funciones de IA de Google necesitan una página indexada y apta para un fragmento, además de un ajuste. Los proveedores de IA tienen sus propias reglas, y difieren en las dos cuestiones que más importan: qué token controla cada uso y si el rastreador ejecuta JavaScript.
La matriz se basa en la documentación de cada proveedor, consultada el 15 de noviembre de 2026, y en las pruebas independientes que recoge la sección de renderizado.
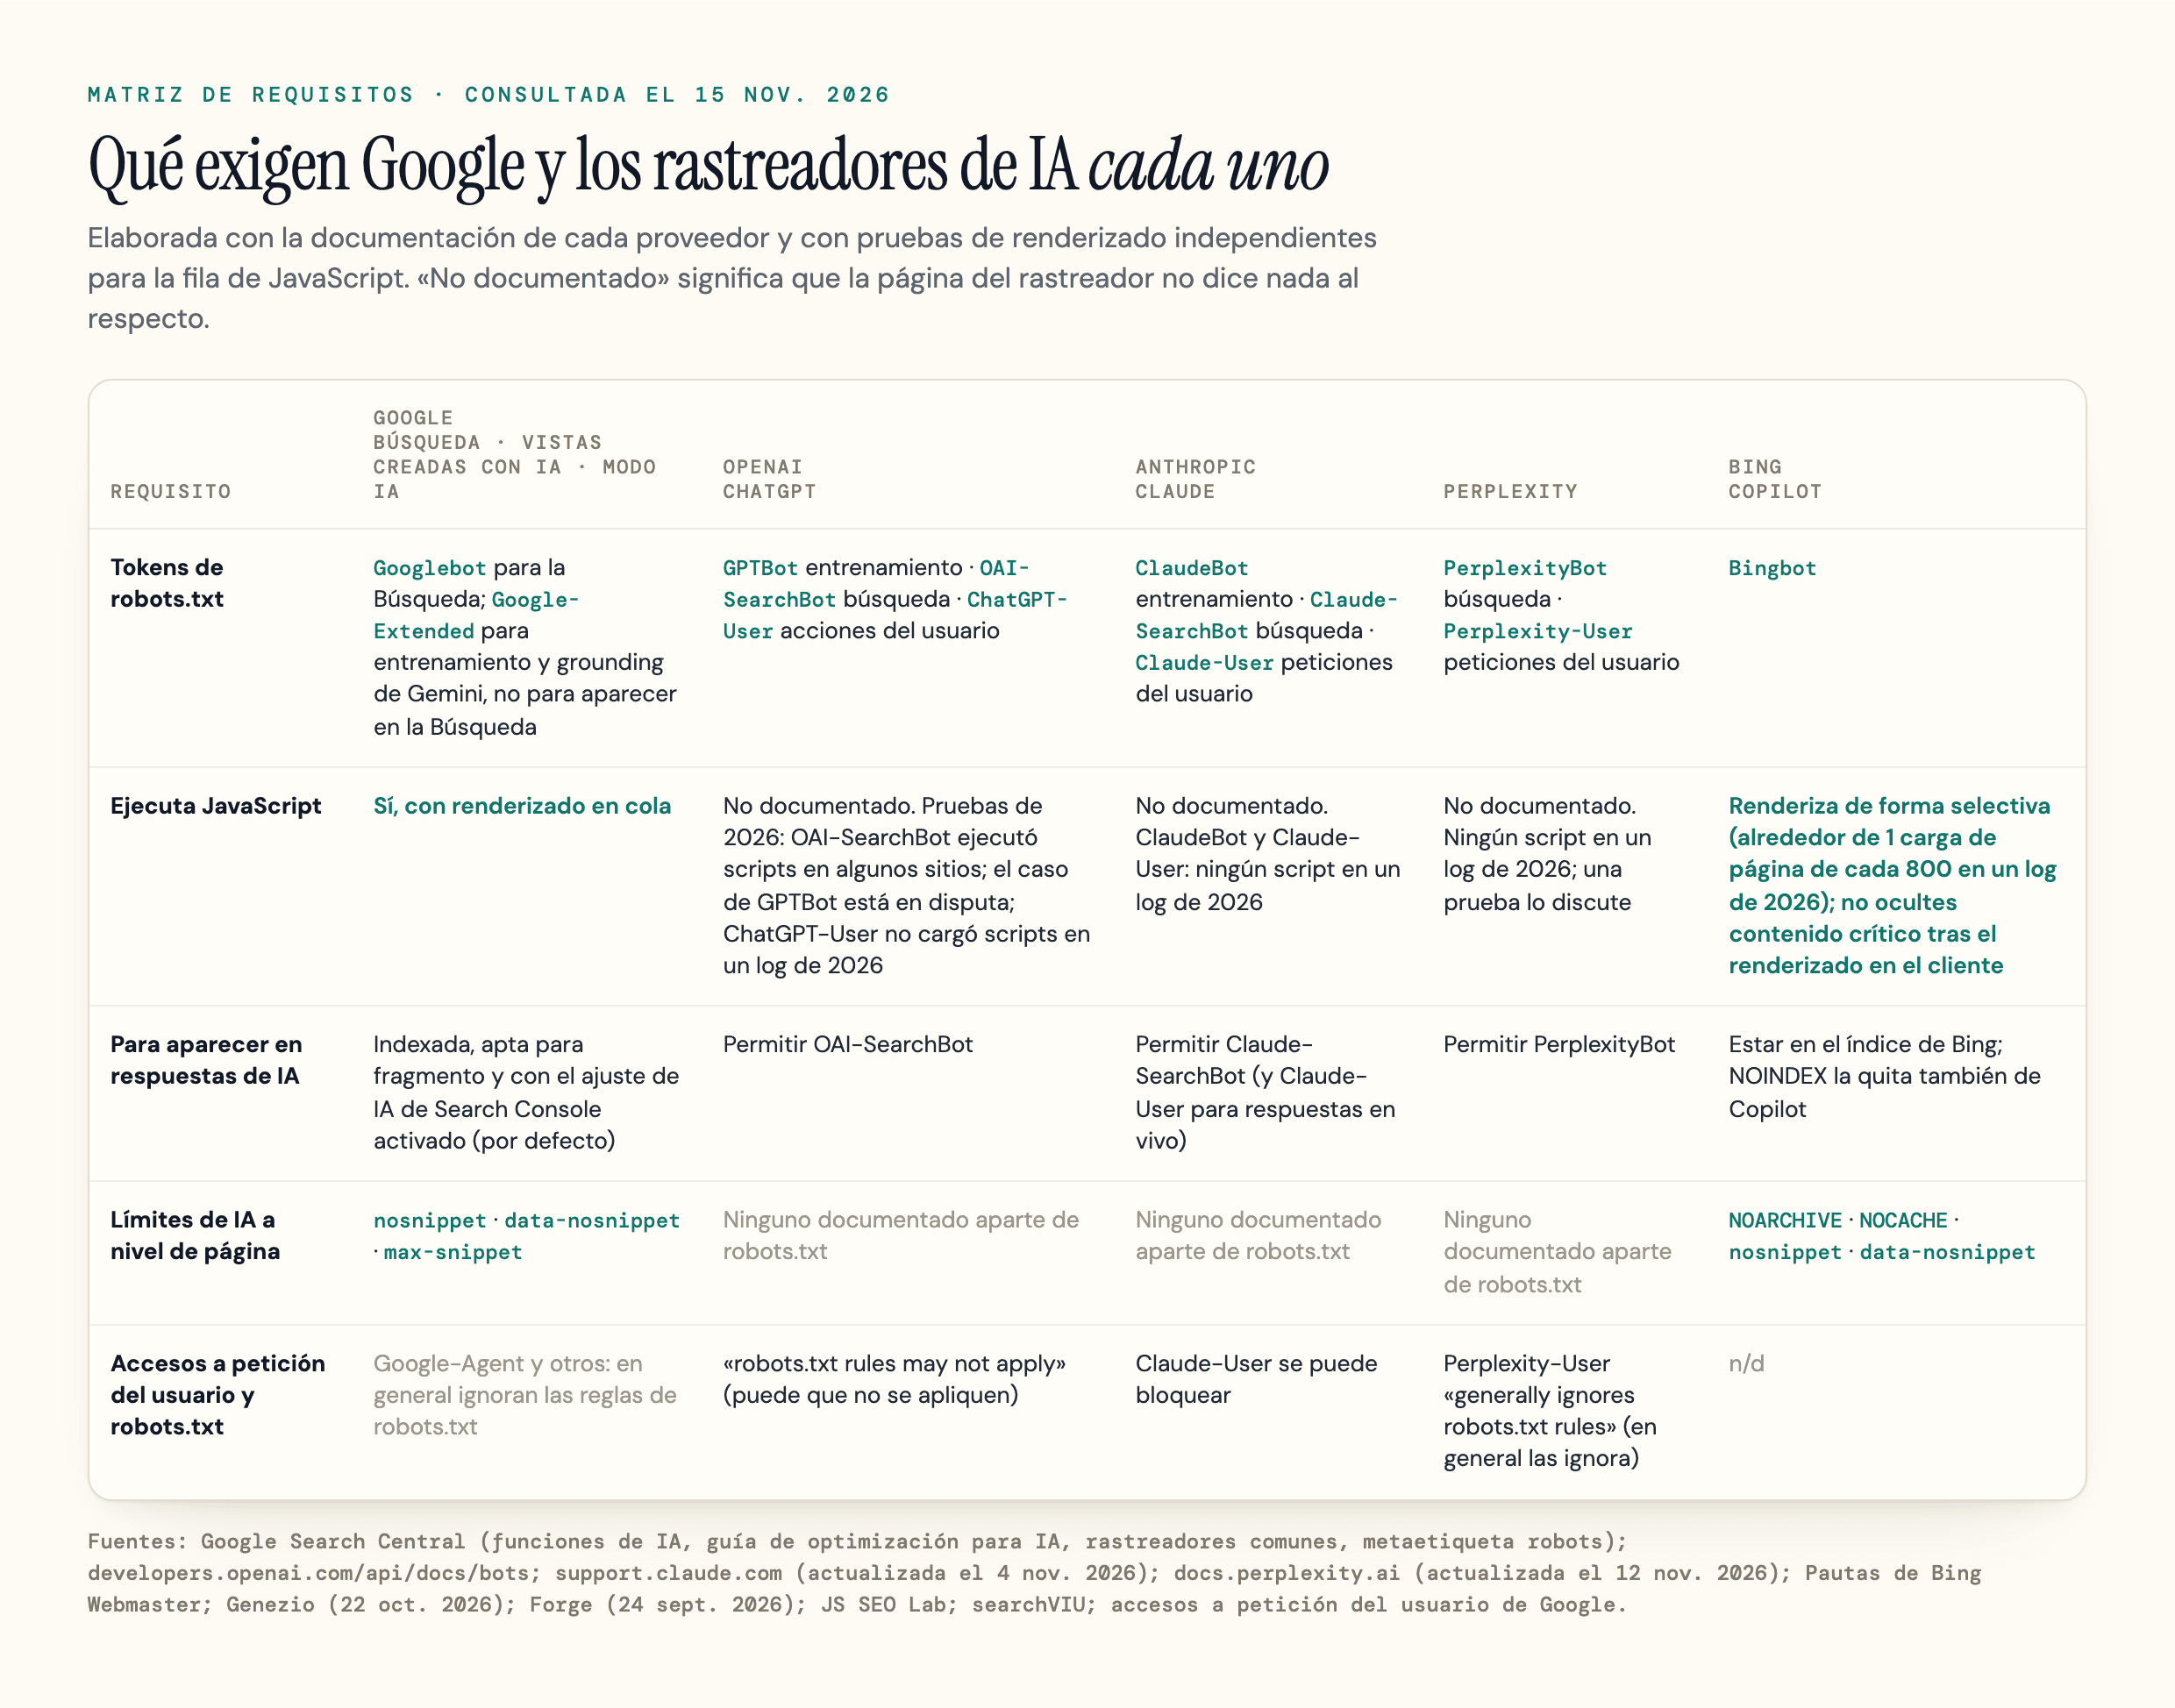
| Requisito | Google (Búsqueda, Vistas creadas con IA, Modo IA) | OpenAI (ChatGPT) | Anthropic (Claude) | Perplexity | Bing (Copilot) |
|---|---|---|---|---|---|
| Tokens de robots.txt | Googlebot para la Búsqueda; Google-Extended para el entrenamiento y el grounding de Gemini, no para aparecer en la Búsqueda | GPTBot (entrenamiento), OAI-SearchBot (búsqueda), ChatGPT-User (acciones del usuario) | ClaudeBot (entrenamiento), Claude-SearchBot (búsqueda), Claude-User (peticiones del usuario) | PerplexityBot (búsqueda), Perplexity-User (peticiones del usuario) | Bingbot |
| Ejecuta JavaScript | Sí, en un paso de renderizado en cola | No documentado. OAI-SearchBot ejecutó scripts en algunos sitios en pruebas de 2026; el caso de GPTBot está en disputa; ChatGPT-User no cargó scripts en un log de 2026 | No documentado. ClaudeBot y Claude-User no cargaron scripts al cargar una página en un log de 2026 | No documentado. PerplexityBot no cargó scripts en un log de 2026; una prueba de 2025 lo discute | Renderiza de forma selectiva (alrededor de 1 carga de página de cada 800 en un log de 2026); Bing pide que no se oculte contenido crítico tras el renderizado en el cliente |
| Para aparecer en respuestas de IA | Estar indexada, ser apta para un fragmento y mantener activado (es el valor por defecto) el ajuste «IA generativa en la Búsqueda» de Search Console | Permitir OAI-SearchBot | Permitir Claude-SearchBot (y Claude-User para las respuestas en vivo) | Permitir PerplexityBot | Estar indexada en Bing; NOINDEX quita la URL también de Copilot |
| Límites de IA a nivel de página | nosnippet, data-nosnippet, max-snippet | Ninguno documentado aparte de robots.txt | Ninguno documentado aparte de robots.txt | Ninguno documentado aparte de robots.txt | NOARCHIVE, NOCACHE, nosnippet, data-nosnippet |
| Accesos a petición del usuario y robots.txt | Google-Agent y otros accesos a petición del usuario suelen ignorar las reglas de robots.txt | ChatGPT-User: puede que las reglas de robots.txt no se apliquen | Claude-User se puede bloquear en robots.txt | Perplexity-User suele ignorar las reglas de robots.txt | n/d |
Qué muestra la matriz
Destacan tres patrones.
Primero, OpenAI y Anthropic separan el entrenamiento de la búsqueda, y Perplexity afirma que su rastreador no se usa para entrenar modelos.
Segundo, el HTML sin renderizar es la opción segura que comparten todos. Google renderiza, pero ChatGPT-User y Claude-User no cargaron scripts en el log de 2026 que citamos más abajo. Los navegadores con agentes, como el navegador Claude-Agent que usa Claude para completar tareas de los usuarios, son la excepción: un navegador ejecuta scripts.
Tercero, solo Google y Bing documentan controles a nivel de página para el uso de IA.
La guía de optimización para IA de Google añade un requisito: un sitio «debe estar incluido en las funciones de IA generativa de la Búsqueda en Search Console». Todos los sitios están incluidos por defecto, y una propiedad hereda el ajuste de su propiedad superior más cercana que lo haya cambiado; revisa también tu propiedad de dominio. La página de funciones de IA de Google, más antigua (diciembre de 2025), sigue diciendo: «No hay requisitos técnicos adicionales».
En España, Google muestra las Vistas creadas con IA desde el 26 de marzo de 2025 y empezó a desplegar el Modo IA el 8 de octubre de 2025. Para tus páginas valen las mismas reglas: estar indexadas, poder mostrarse con un fragmento y no estar excluidas con el ajuste «IA generativa en la Búsqueda» de Search Console (en el menú, Ajustes), que al 31 de agosto de 2026 ya estaba desplegado en todos los sitios web.
Rastreo: robots.txt, códigos de estado y presupuesto de rastreo
Rastrear significa que un bot puede pedir una URL y recibir una respuesta utilizable, y muchos problemas de SEO técnico empiezan aquí.
Por qué el robots.txt controla el rastreo y no la indexación
El robots.txt pide a los rastreadores que no entren en ciertas rutas; no saca una URL de Google. Google indica que una página bloqueada en robots.txt puede indexarse igualmente si otros sitios enlazan a ella. El propio estándar, el RFC 9309, lo dice así: «These rules are not a form of access authorization» (estas reglas no son una forma de autorización de acceso).
Protege con contraseña un sitio de pruebas o una página privada: ni el robots.txt ni noindex son medidas de seguridad. Para una página pública que solo debe quedar fuera de la Búsqueda, Google recomienda noindex. No bloquees además esa URL en robots.txt, porque Google tiene que rastrear la página para ver la etiqueta.
Nuestra guía de SEO para SaaS explica qué debe mantener fuera del índice un dominio de software: la aplicación, los entornos de pruebas y las versiones antiguas de la documentación.
Googlebot ignora crawl-delay, que su especificación de robots.txt no admite, mientras que Anthropic indica que sus bots lo respetan cuando sea apropiado.
Cada rastreador sigue el grupo que nombra su user-agent y, si no existe, el grupo *: solo tienes que nombrar los bots a los que quieres dar un trato distinto. Con los grupos del ejemplo de más abajo pides a OpenAI, Anthropic y Google que no entrenen con tus páginas (Google-Extended es un token de control, no un rastreador) y dejas a cada rastreador de búsqueda con sus reglas actuales.
Revisa también los grupos que ya tengas para estos bots: los rastreadores los combinan, y una línea Allow más específica sigue ganando a Disallow: /. El grupo de Google-Extended, además, saca tus páginas del grounding de Gemini Apps (las fuentes web en las que Gemini apoya sus respuestas); omítelo si quieres que las use.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
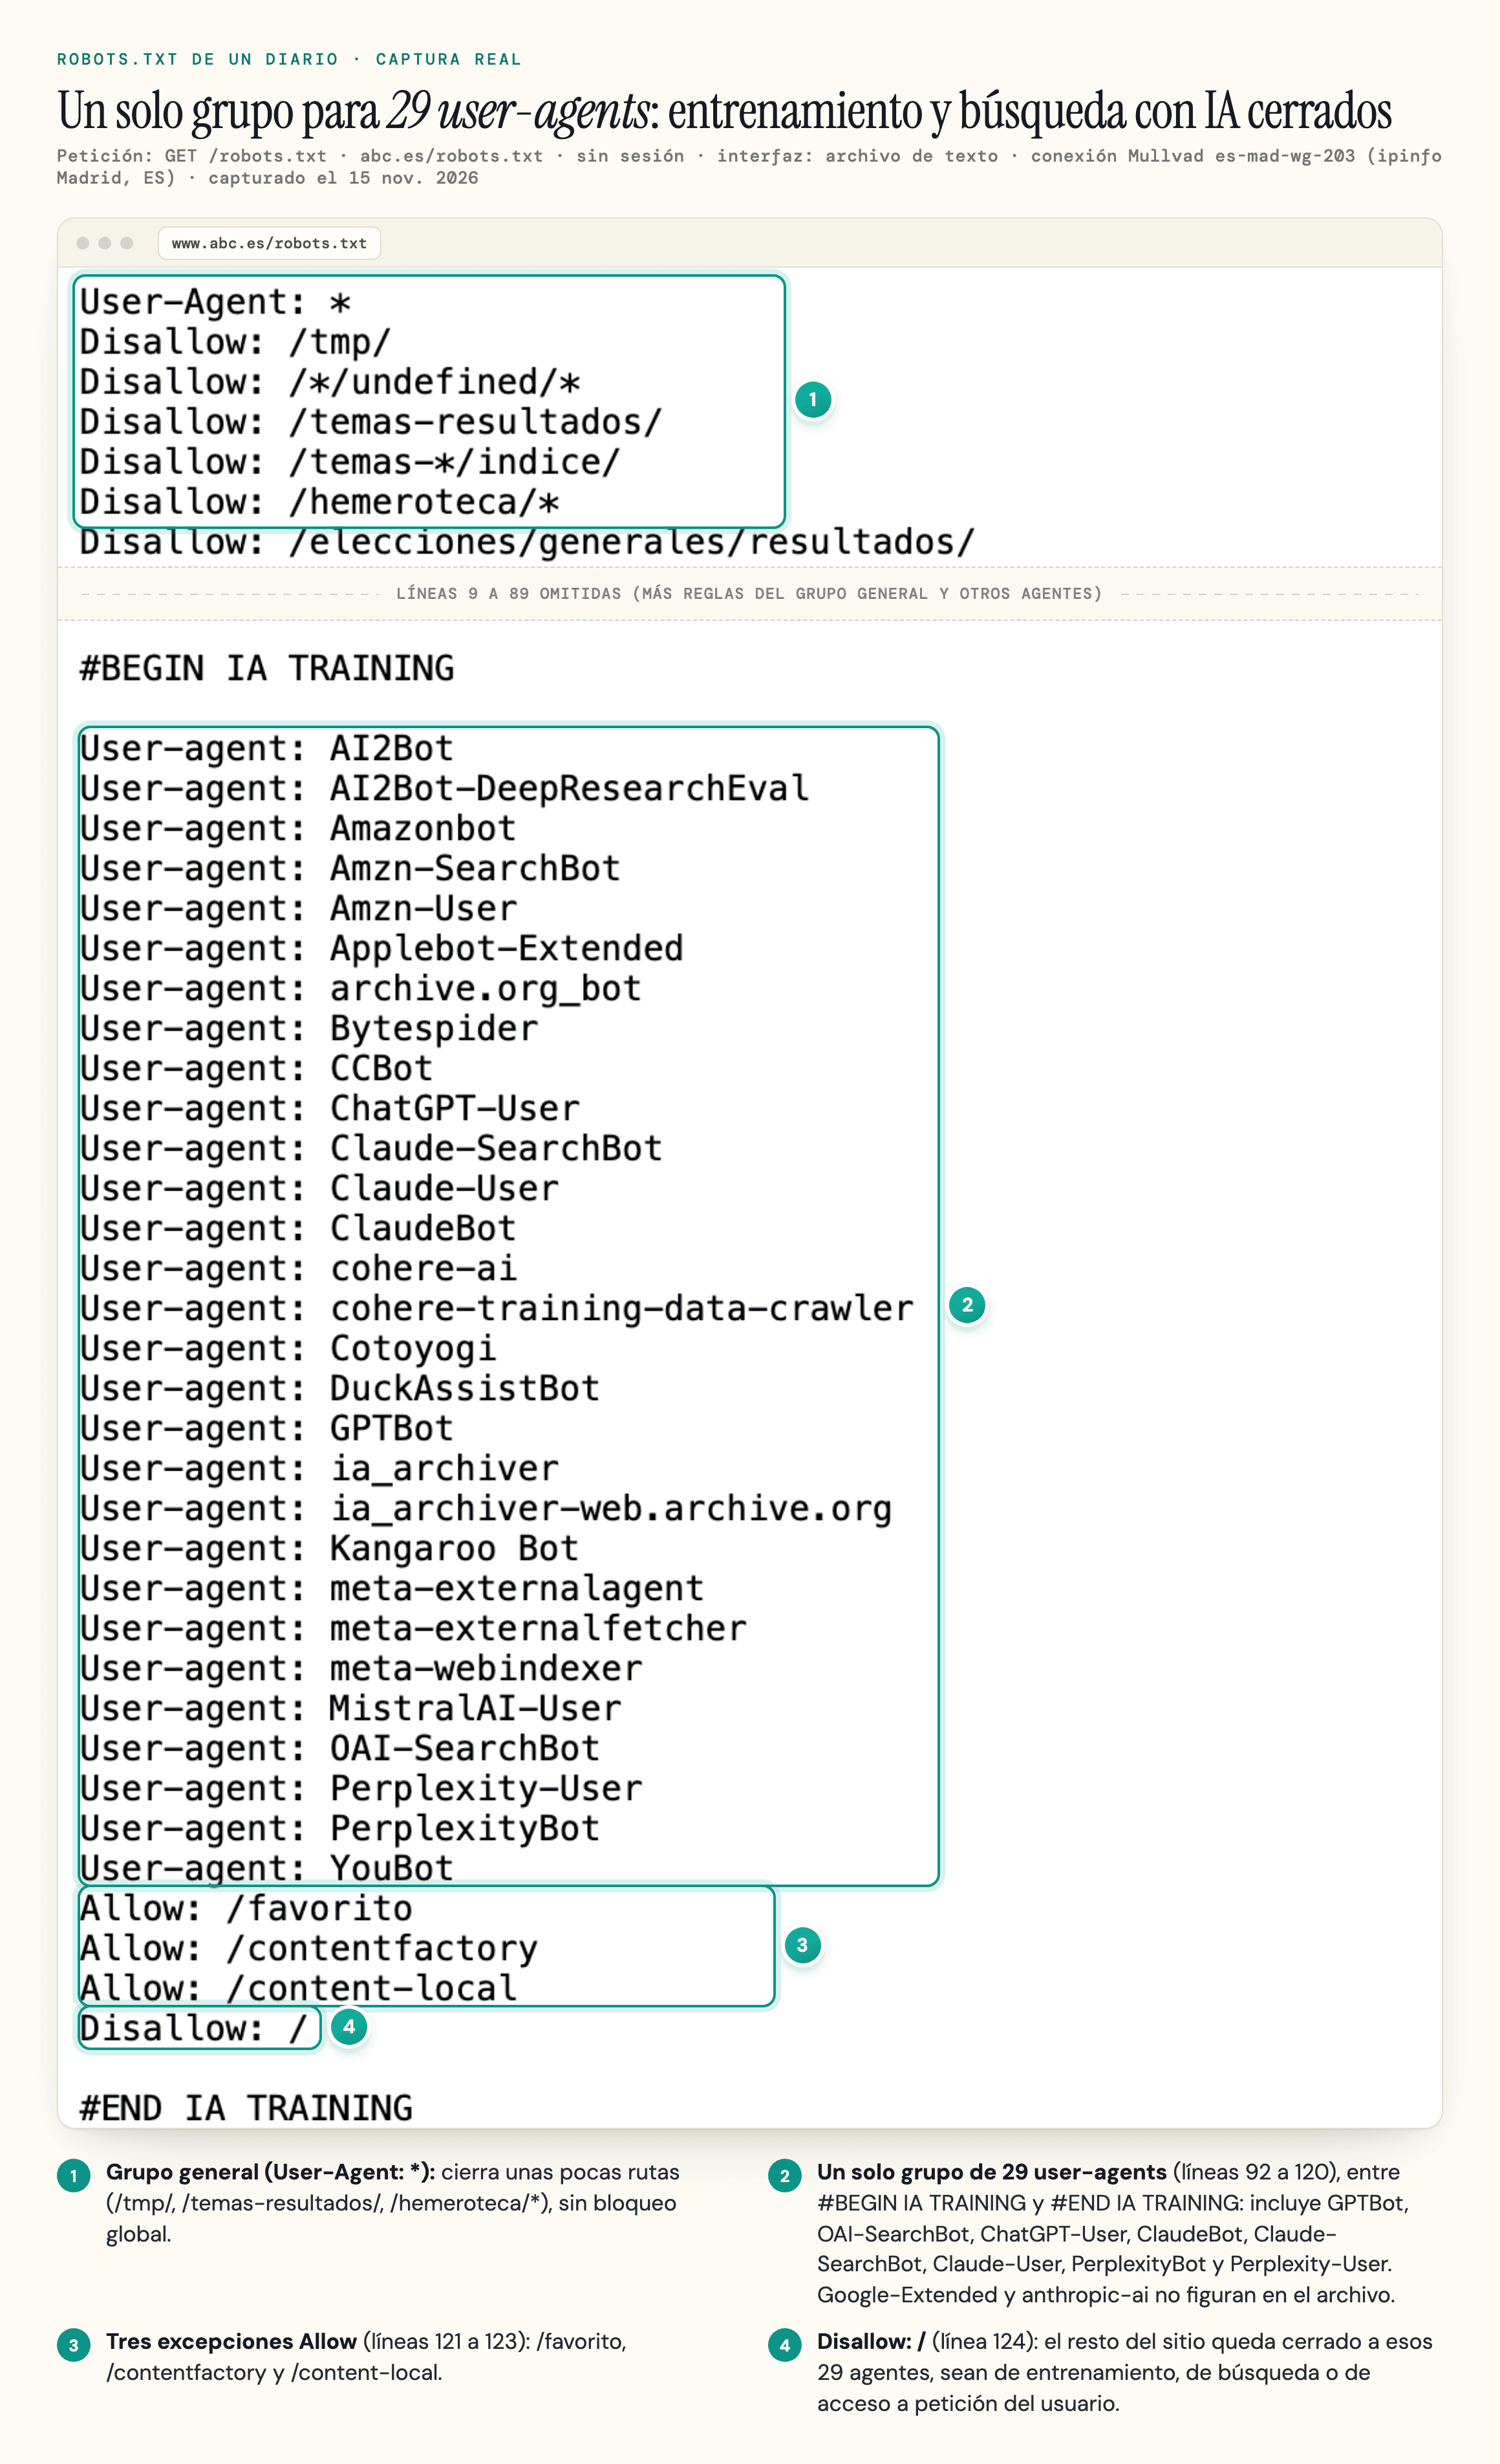
Para ver qué bots bloquea un robots.txt real en la ruta de la página de inicio, pega un dominio en nuestro AI Crawler Checker. La herramienta, que está en inglés, comprueba el robots.txt con 34 user-agents de rastreadores, en su mayoría bots de IA, y, cuando alguno está bloqueado, muestra la línea que lo bloquea.
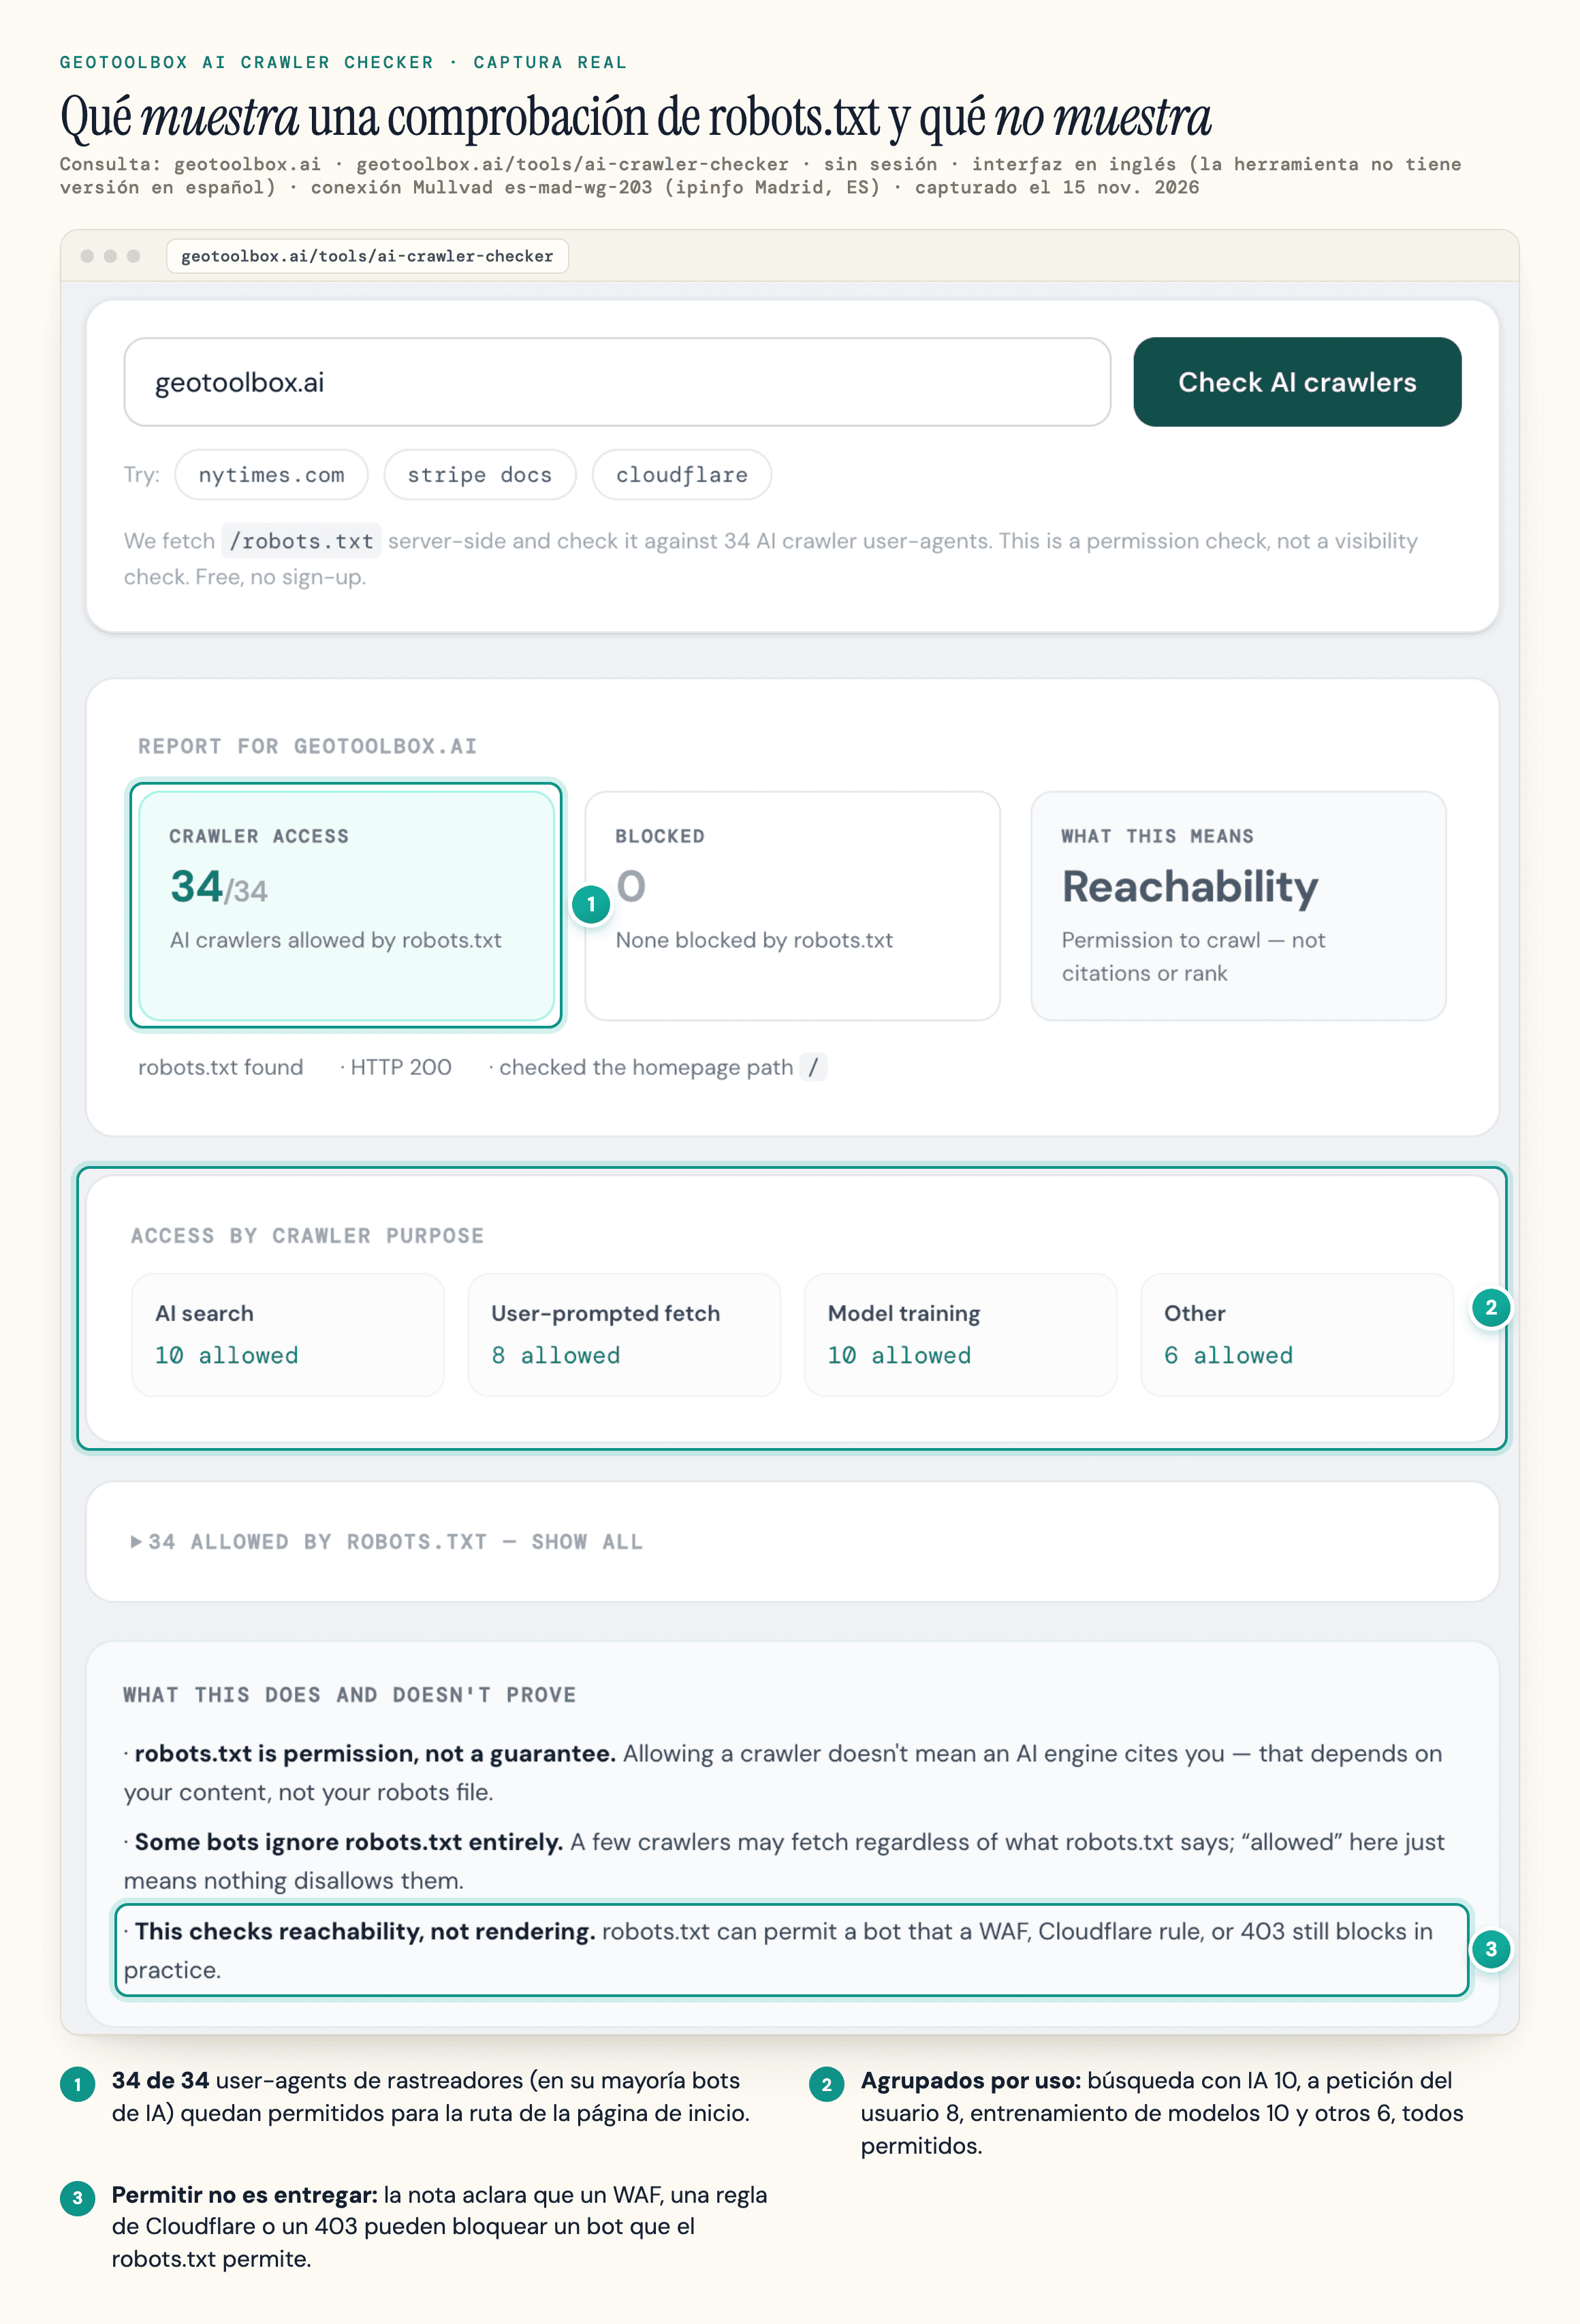
El código de estado del propio archivo también importa. Según el RFC 9309, un 4xx significa que un rastreador puede acceder a todo, mientras que un archivo inaccesible (un error del servidor) obliga a asumir que todo está bloqueado.
Tu CDN puede anular el robots.txt
Las reglas de bots del CDN y del firewall se aplican antes de que se lea el robots.txt: un archivo que permite OAI-SearchBot no sirve de nada si el CDN o el firewall devuelven un 403. Cloudflare, por ejemplo, empezó el 1 de julio de 2025 a preguntar a cada dominio nuevo si quería permitir los rastreadores de IA, con el bloqueo como opción por defecto. El 15 de septiembre de 2026 anunció ajustes predefinidos para los dominios nuevos que mantienen permitidos los rastreadores de búsqueda y que, en los sitios con publicidad, desautorizan el entrenamiento de IA y bloquean a los agentes en las páginas con anuncios; los sitios sin publicidad permiten los tres usos.
La documentación de rastreadores de Perplexity advierte a los propietarios de sitios de que quizá tengan que permitir sus bots de forma explícita en un firewall de aplicaciones web (WAF).
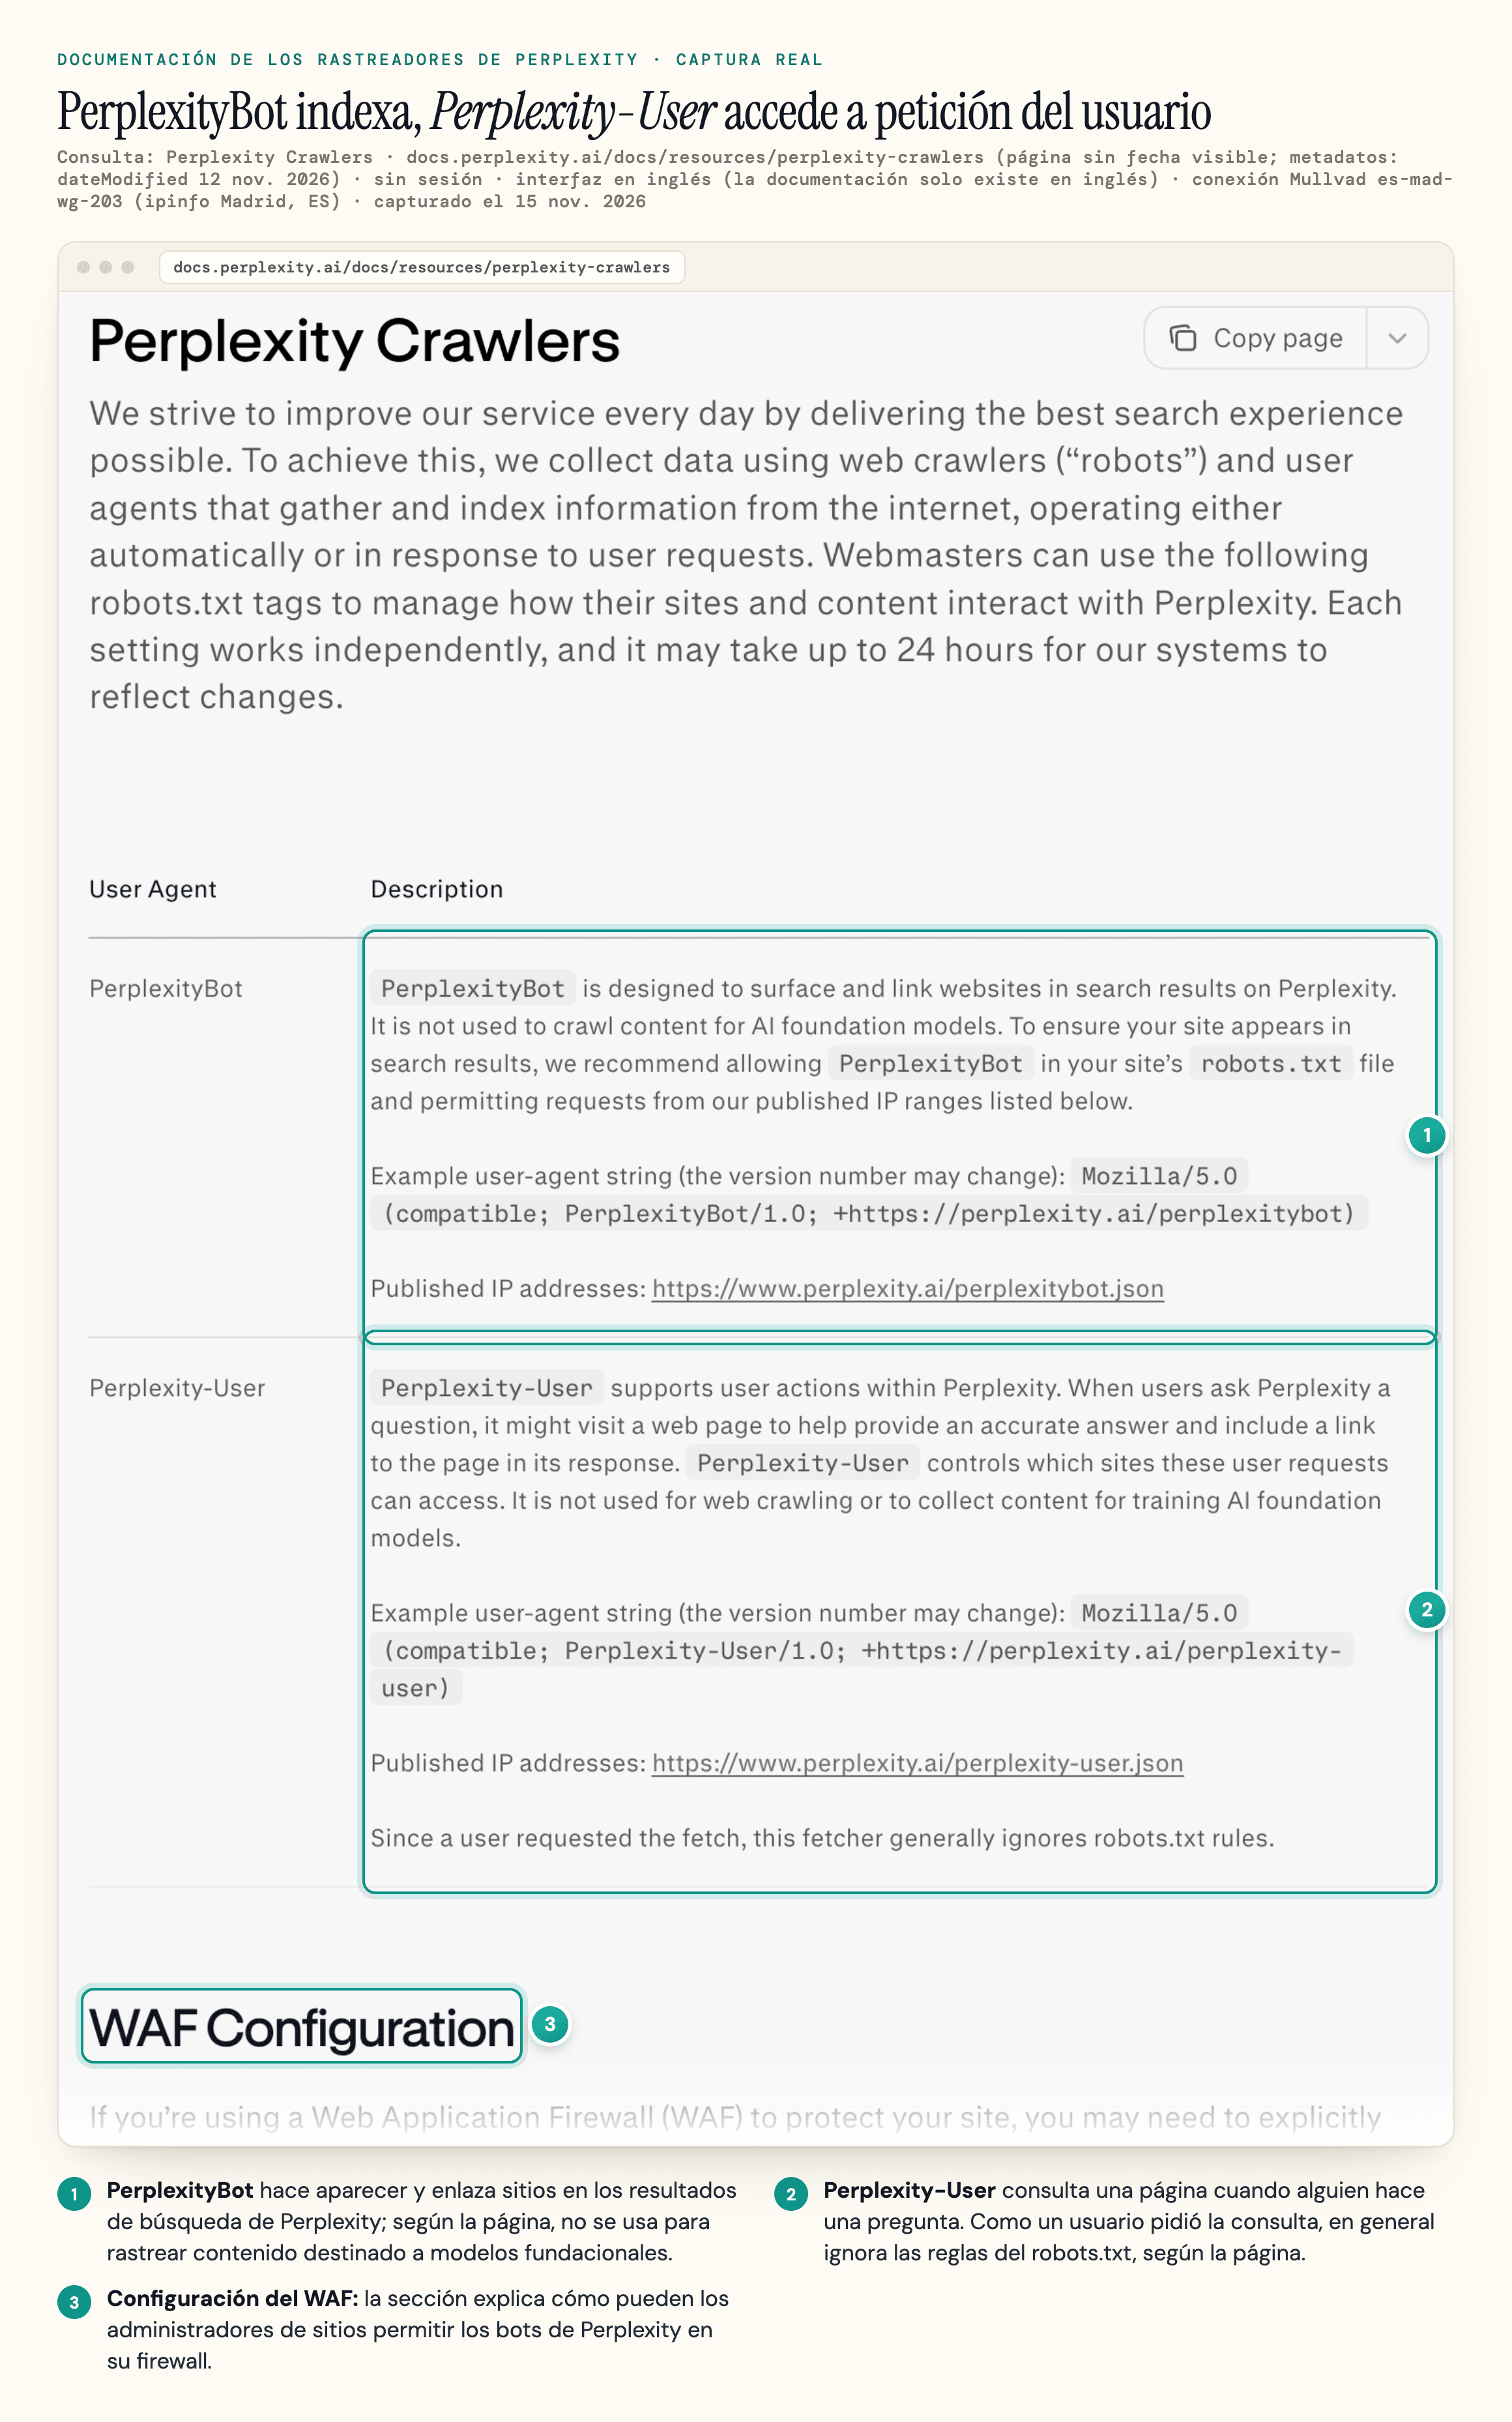
Por eso conviene probar qué recibe cada bot y no solo qué dicen las reglas. El escaneo Agent Readiness de geotoolbox hace peticiones a tu sitio con seis user-agents de rastreadores desde nuestro servidor e informa de los 403 y de los bloqueos del firewall. Un firewall que verifica los bots por dirección IP aún puede tratar de otra forma al rastreador real: confírmalo en los ajustes de bots de tu CDN o en sus logs.
El presupuesto de rastreo es un problema de sitios grandes
La guía de presupuesto de rastreo de Google está pensada para sitios con más de 1 millón de páginas únicas que cambian cada semana, con más de 10.000 que cambian a diario, o con una gran parte de las URL atascada en «Descubierta: actualmente sin indexar»; Google aclara que esas cifras son estimaciones aproximadas. Por debajo de esos tamaños, una página sin indexar suele tener otra causa, como contenido duplicado o escaso. Si publicas miles de páginas desde una misma plantilla, nuestra guía de SEO programático explica cómo conseguir que se rastreen y se indexen.
En un sitio de cualquier tamaño, desperdician rastreo las cadenas de redirecciones, los soft 404 («Las páginas con errores soft 404 se siguen rastreando, lo que consume parte del presupuesto») y los servidores lentos o con fallos. Google reduce su ritmo de rastreo cuando las respuestas se ralentizan o devuelven códigos 5xx o 429.
Renderizado: qué ve realmente cada rastreador
Si el texto principal de tu página solo aparece después de ejecutar JavaScript, Google normalmente lo verá, pero los rastreadores de OpenAI, Anthropic y Perplexity, en su mayoría, no.
Google renderiza en un segundo paso, en cola, que puede llegar más tarde que el rastreo. Las pautas de Bing piden no ocultar contenido crítico tras el renderizado en el cliente, porque el contenido que no se puede renderizar de forma confiable puede no indexarse ni elegirse para las respuestas con grounding.
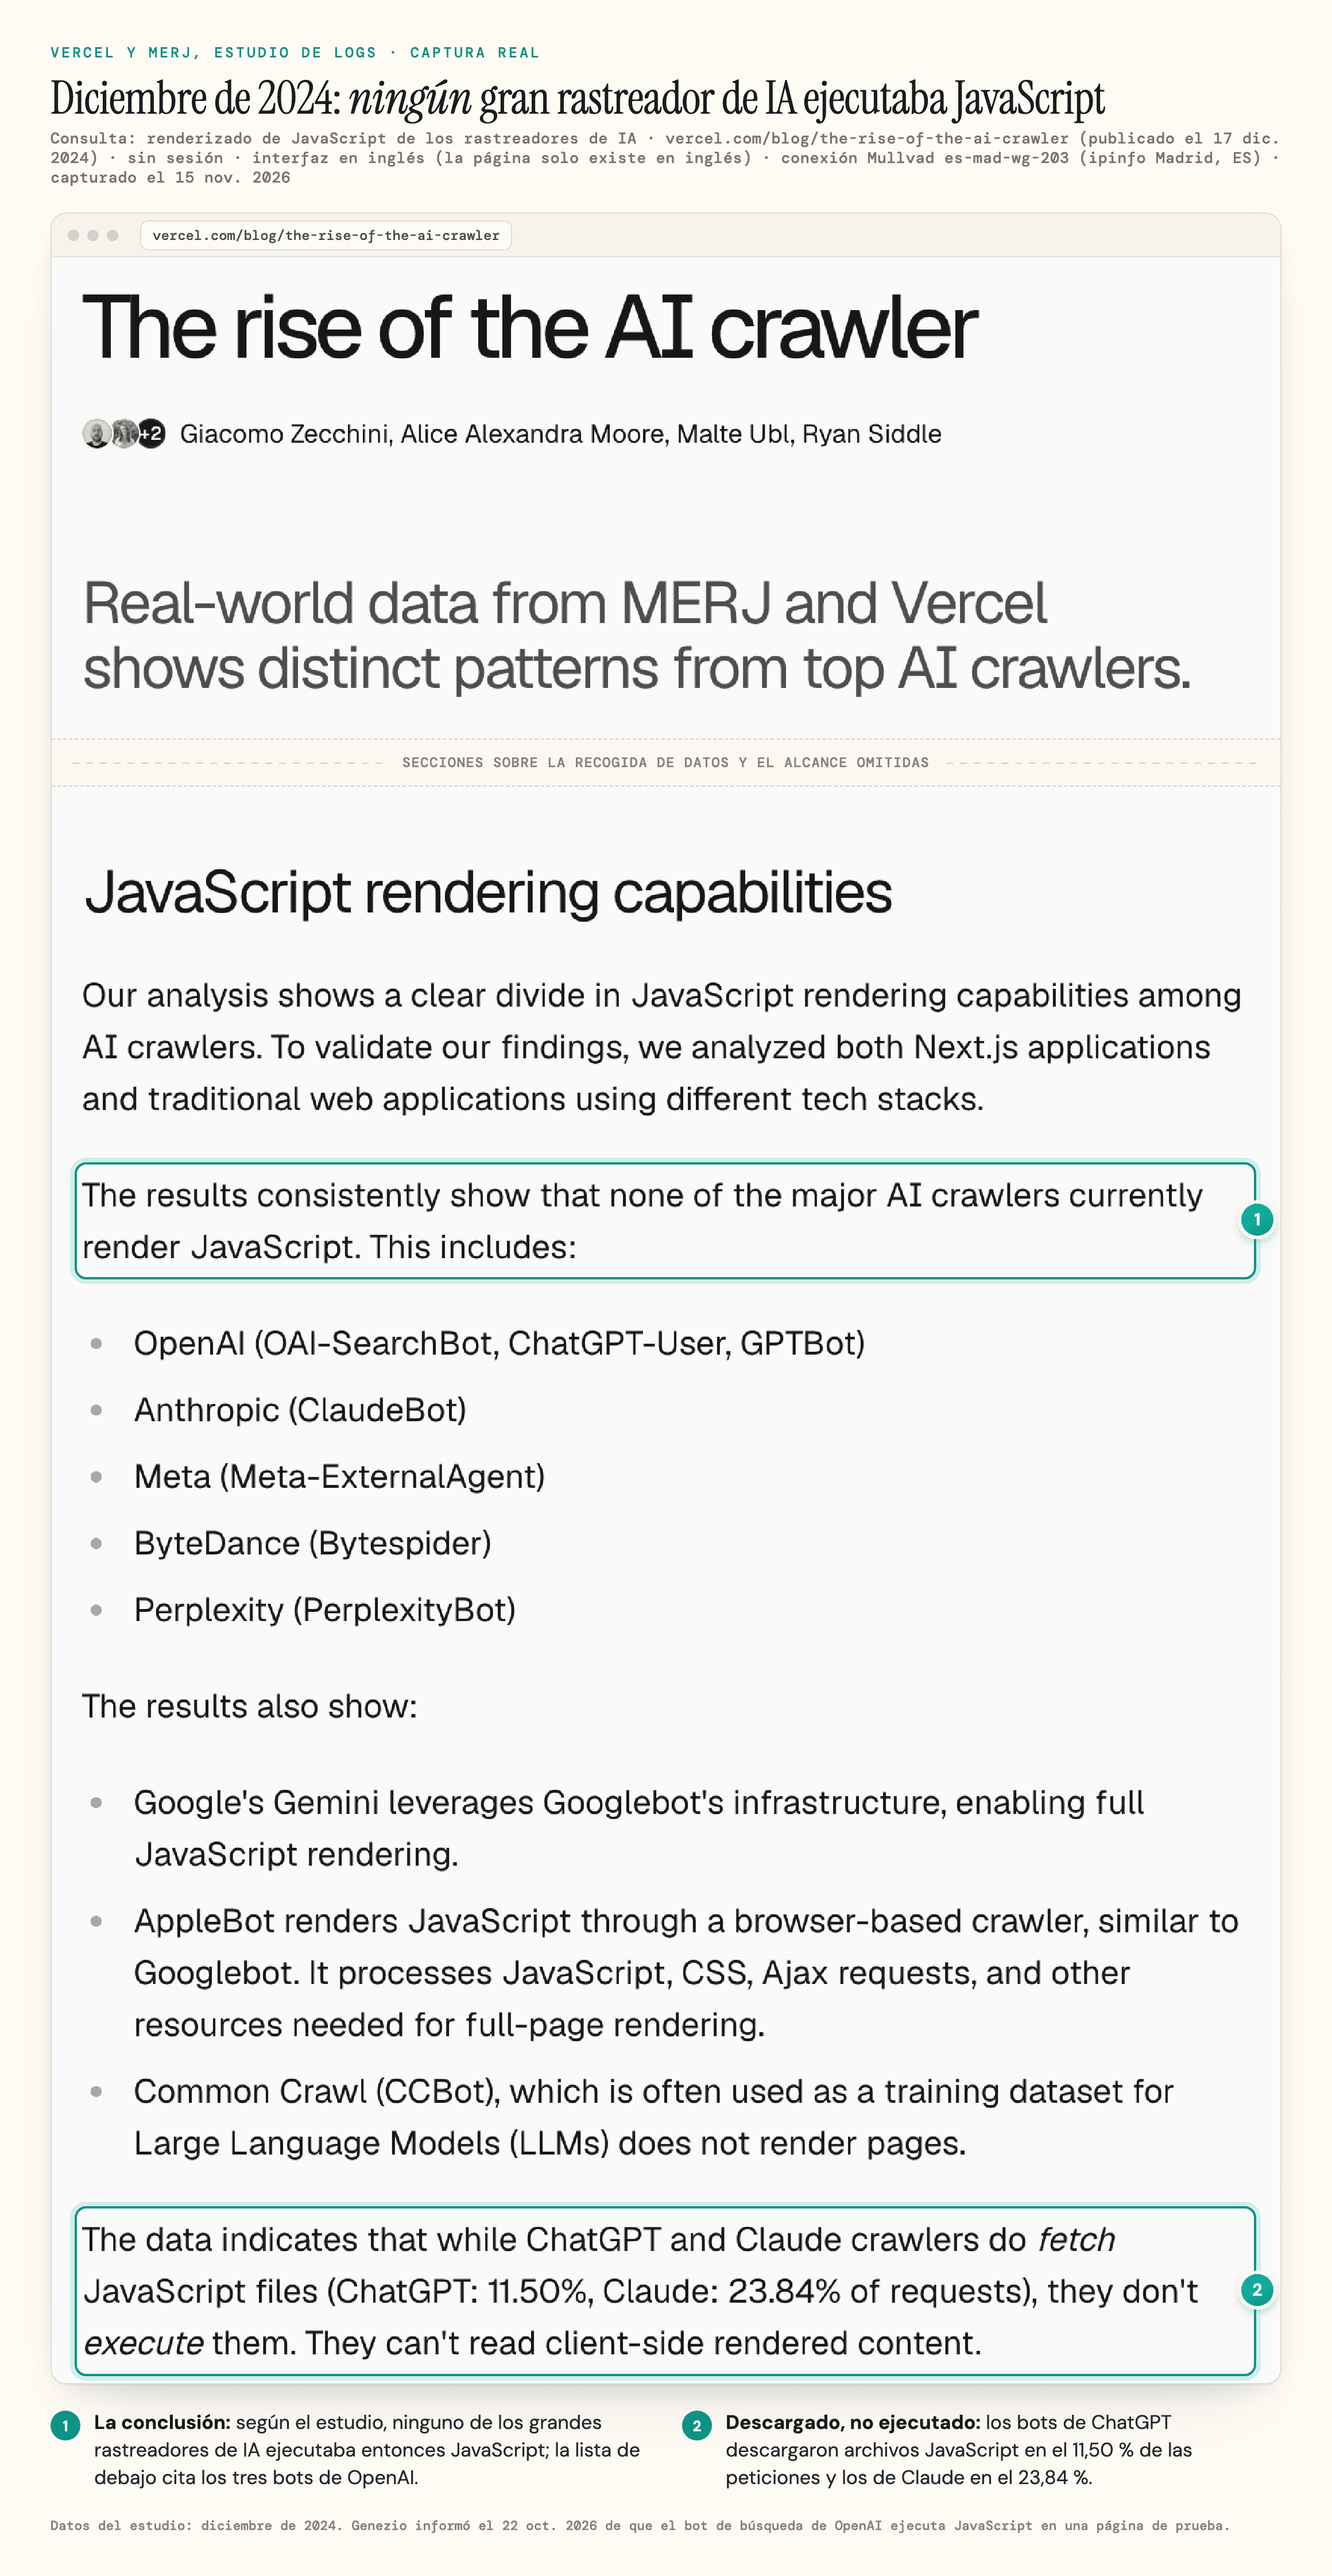
En diciembre de 2024, el análisis de logs de Vercel y MERJ sobre la red de Vercel concluyó que ninguno de los grandes rastreadores de IA renderizaba JavaScript. En nextjs.org, el rastreador de ChatGPT dedicó el 11,50 % de sus peticiones a archivos JavaScript y el de Claude el 23,84 %, sin ejecutarlos.
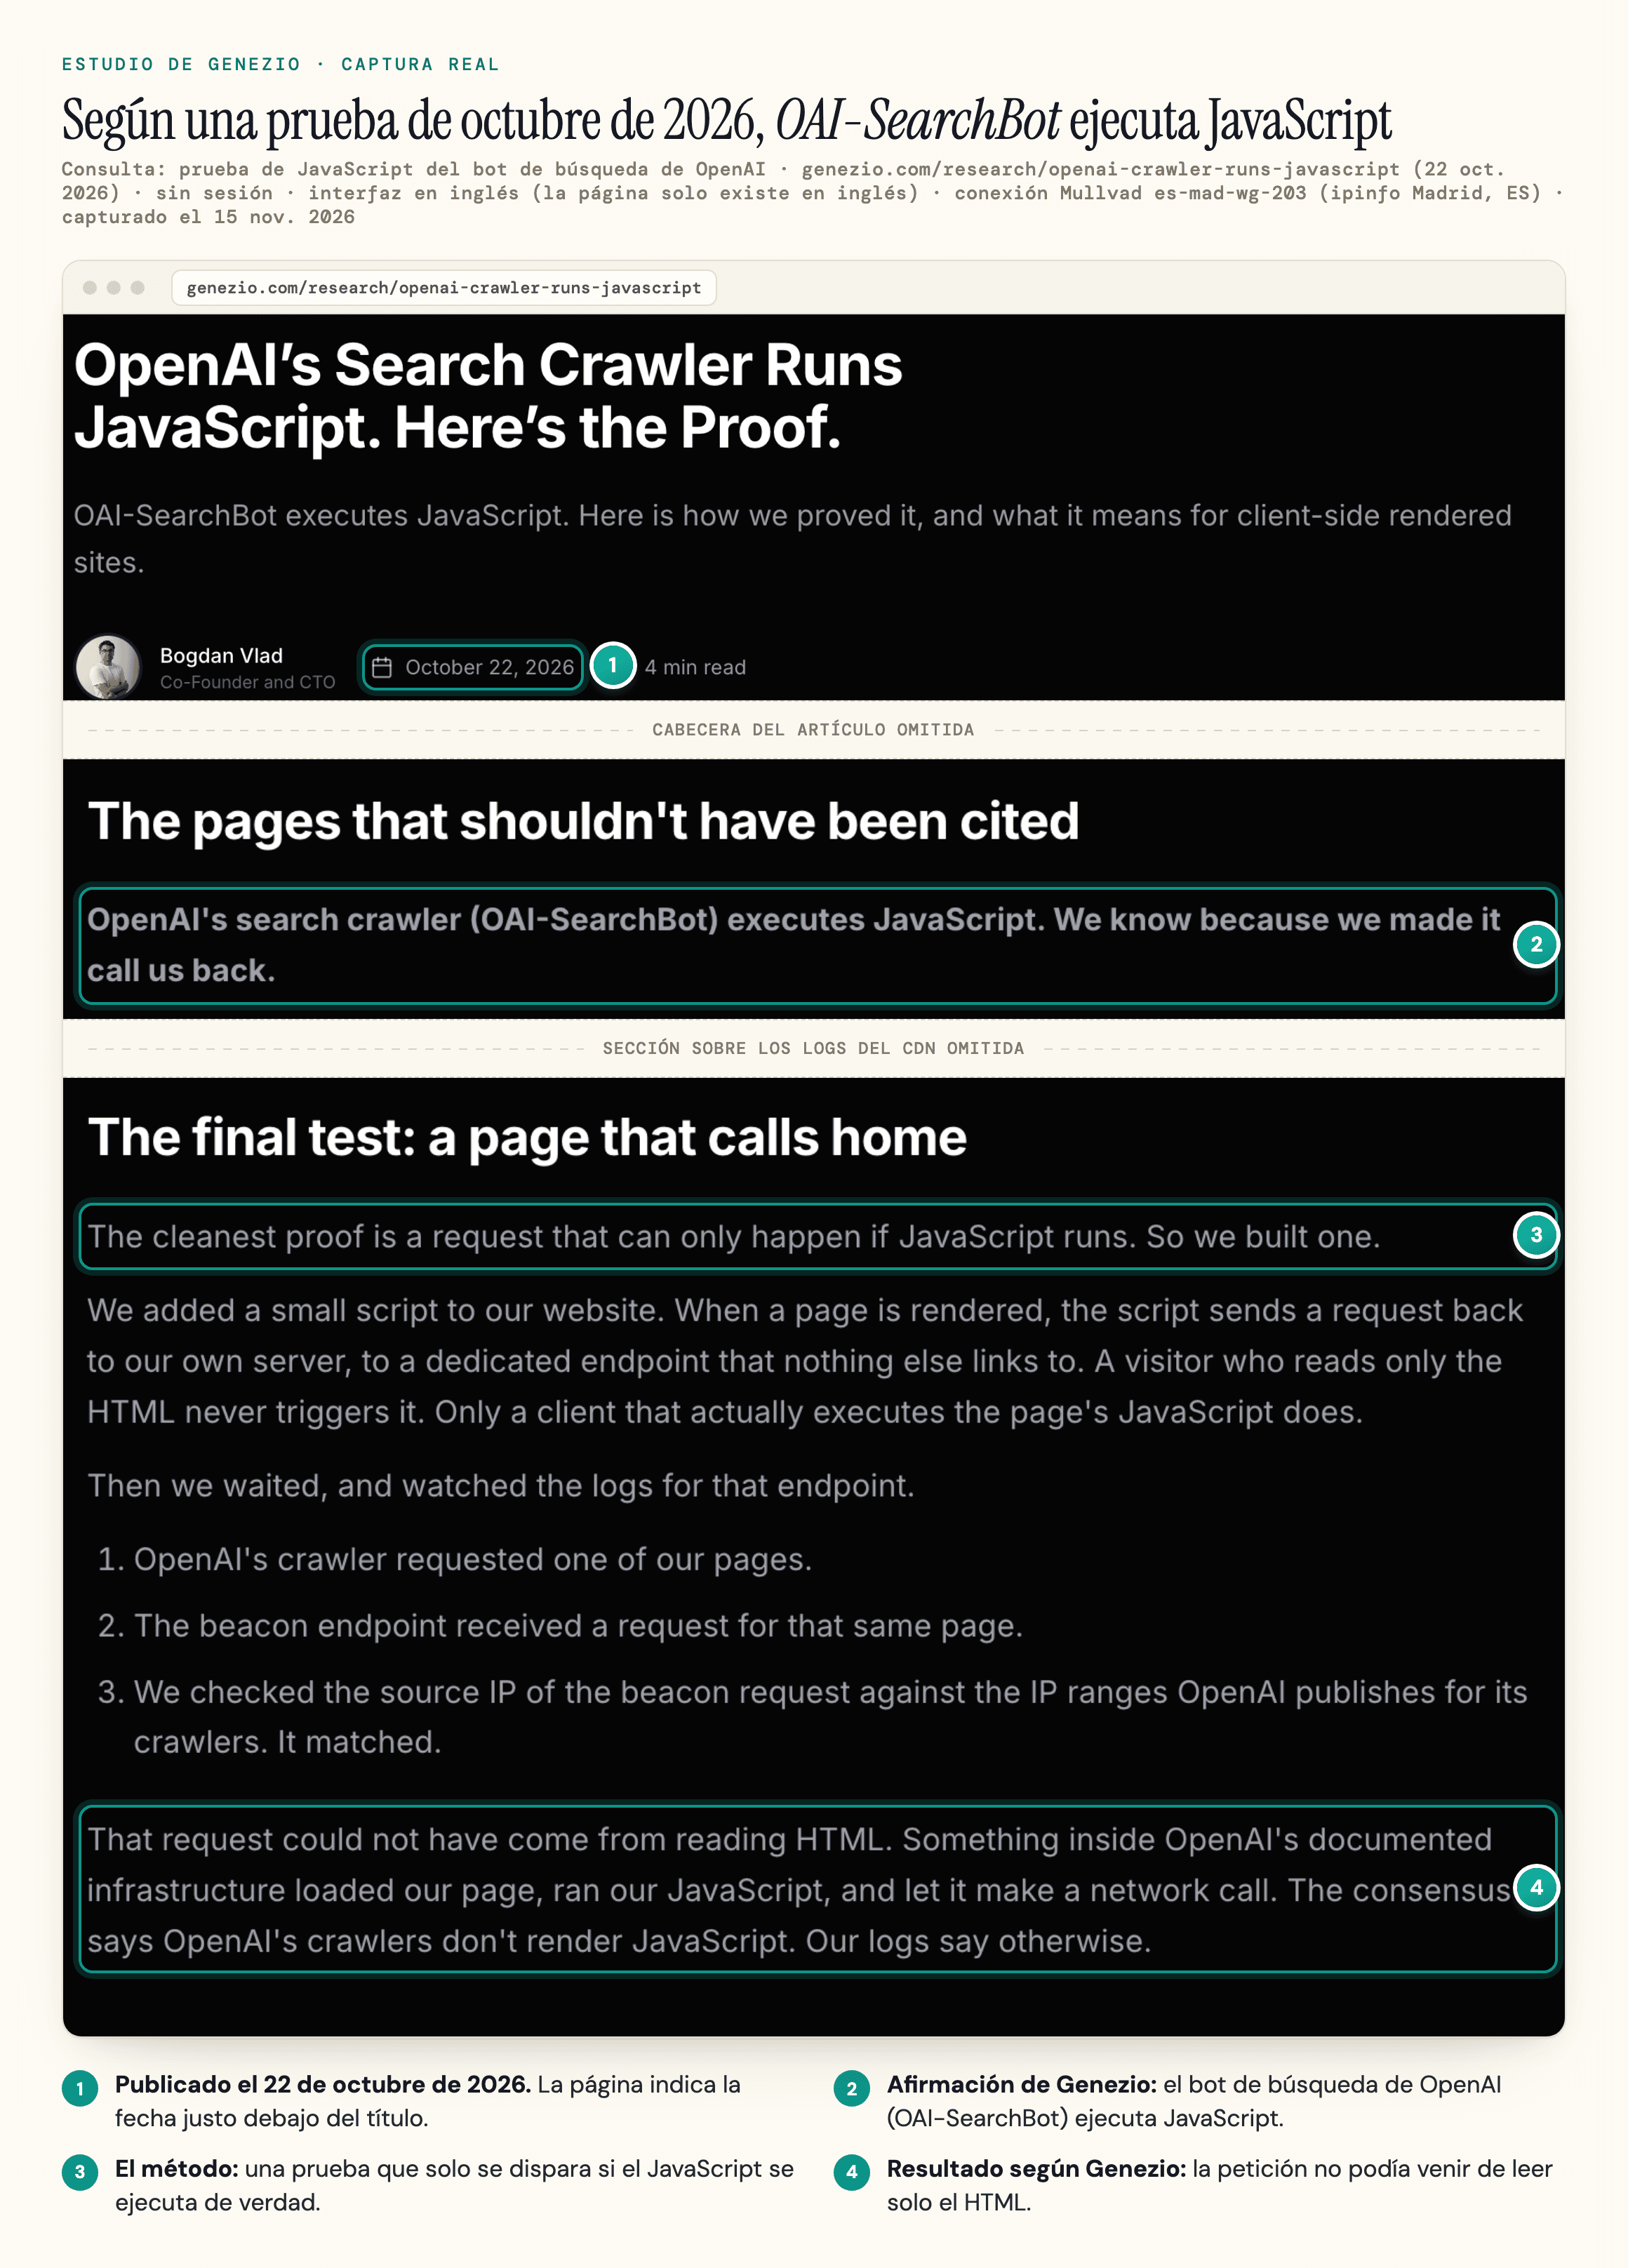
Una prueba de 2026 muestra una excepción para OAI-SearchBot en un sitio. El 22 de octubre de 2026, Genezio, que vende software de visibilidad en IA, publicó una prueba en su propio sitio en la que un rastreador procedente de los rangos de IP de OpenAI llamó a un endpoint al que solo se podía llegar ejecutando JavaScript.
El log de 30 días de un sitio de noticias publicado por Forge, hasta el 24 de septiembre de 2026, captó a OAI-SearchBot cargando una sola página como lo haría un navegador, una vez en 1738 peticiones con el nombre de ese bot (Forge no las comparó con la lista de IP de OpenAI). Forge señala además que un log no permite saber si los scripts se ejecutaron.
OpenAI no ha documentado nada de esto. En ese mismo log, ChatGPT-User, Claude-User y PerplexityBot no cargaron scripts.
Otras dos pruebas enturbian el panorama. Una prueba con beacon de JS SEO Lab registró a GPTBot ejecutando scripts insertados en el propio HTML, y una prueba de searchVIU hecha el 30 de octubre de 2025 sugiere que el contenido escrito por scripts puede llegar al índice de Perplexity.
La prueba del código fuente
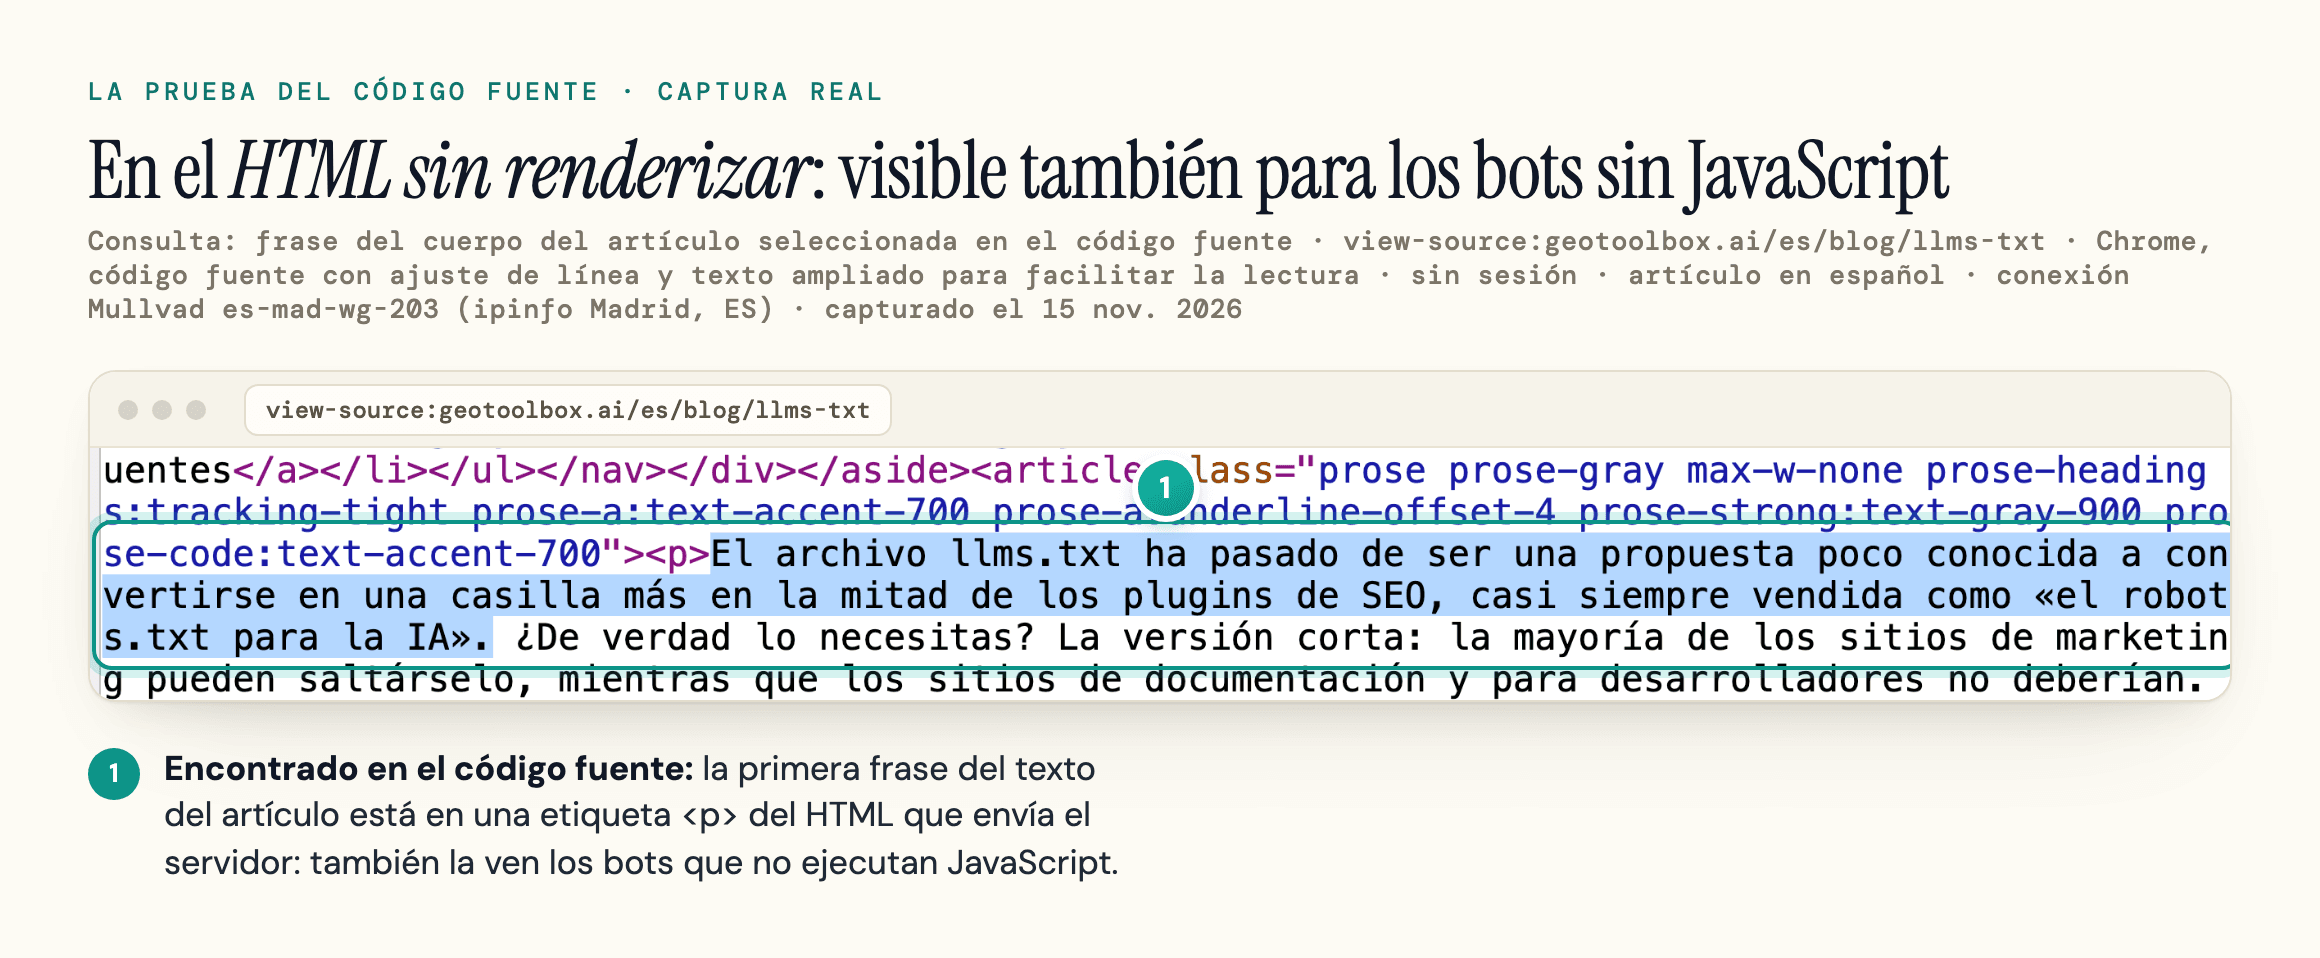
Abre el código fuente (Ctrl+U, o Cmd+Opción+U en Mac), busca una frase de tu contenido principal y comprueba si está. Si no aparece en el código fuente, los rastreadores que leen HTML sin renderizar no pueden citarla.
La solución es el renderizado en el servidor, la generación estática o el prerrenderizado para las páginas de contenido. Nuestra guía de SEO para JavaScript recoge los resultados de las pruebas bot por bot y las opciones de framework.
Indexación, canonicals y sitemaps
Indexar es una decisión de Google, y tú influyes en ella con señales coherentes: una URL canónica por cada contenido, ningún noindex accidental y un sitemap que incluya solo las páginas que quieres indexar.
En Search Console, el trabajo de SEO técnico empieza por el informe «Indexación de páginas», que agrupa las URL que Google dejó fuera según el motivo que indica.
Google trata la etiqueta canonical como una señal fuerte, no como una orden, y funciona mejor cuando los enlaces internos, los sitemaps y las redirecciones apuntan en la misma dirección. Nuestra guía sobre las etiquetas canonical explica cómo eligen una URL Google y los motores de IA.
Sitemaps e IndexNow
Google indica que un sitio de unas 500 páginas o menos enlazadas por completo entre sí puede no necesitar un sitemap. Bing añade IndexNow, un aviso que informa a Bing de que una URL se ha añadido, actualizado o eliminado, y sus pautas vinculan esa actualidad con las respuestas de Copilot.
Para enviar un sitemap a Google, añádelo en el informe «Sitemaps» de Search Console, que también muestra cuándo lo leyó Googlebot y los errores de procesamiento, o pon una línea Sitemap: en el robots.txt (también sirve la API de Search Console). Google considera que enviarlo es solo una indicación: no garantiza que Google descargue el archivo ni que lo use. Consulta nuestra guía del sitemap XML para configurarlo.
«Rastreada: actualmente sin indexar»
En Search Console, este estado significa que Google descargó la página y decidió no indexarla, por ahora. La ayuda de Search Console lo define así: «Google ha rastreado la página, pero no la ha indexado». No es un código de error, y Google no indexa todas las URL que rastrea.
Sigue este orden:
- Comprueba si la página duplica otra URL y si Google eligió una canonical distinta
- Comprueba cuántos enlaces internos apuntan a ella y desde dónde
- Comprueba si aporta algo que no aporten las páginas ya indexadas sobre el mismo tema
El botón «Solicitar indexación» solo pide a Google que vuelva a rastrear la URL, y rara vez cambia el resultado mientras la causa siga ahí.
Navegación por facetas
Los filtros y los criterios de orden pueden crear miles de URL casi idénticas. Para mantener a los rastreadores fuera de las combinaciones que nadie busca, la guía sobre navegación por facetas de Google prefiere bloquearlas en robots.txt o poner los filtros en fragmentos de URL, y advierte de que las etiquetas canonical suelen ser menos eficaces para esto. Si esas URL ya están indexadas, ponles primero noindex y bloquéalas solo cuando salgan del índice. Nuestra guía de SEO para ecommerce explica cómo decidirlo filtro a filtro.
Los catálogos B2B añaden otro problema de rastreo: fichas técnicas y certificados que solo se publican como PDF o tras formularios, un tema que trata nuestra guía de SEO B2B.
Paginación
Las listas largas, como las páginas de categoría y los archivos de un blog, se reparten en varias páginas. La guía de paginación de Google pide una URL única por página, como ?page=2, con su propia canonical: no apuntes la canonical de todas las páginas a la primera. Enlaza cada página con la siguiente mediante un <a href> normal, y no pongas los números de página en fragmentos #, que Google ignora. Google ya no usa rel="next" ni rel="prev".
Arquitectura del sitio y enlaces internos
Los buscadores y los rastreadores de IA encuentran la mayoría de las páginas siguiendo enlaces: tus enlaces internos deciden qué se descubre primero y qué parece importante.
Usa enlaces <a href> normales. Las pautas de Bing piden exactamente eso, con un texto ancla relevante, y los enlaces que solo existen después de que se ejecute un controlador de clic son invisibles para los rastreadores que no ejecutan JavaScript.
Mantén las páginas importantes cerca de la página de inicio mediante las páginas de categoría y las migas de pan. Toda página que quieras indexar necesita una ruta rastreable hasta ella. Procura que la estructura de las URL sea corta, legible y estable, porque cada cambio exige redirecciones.
Páginas huérfanas y enlaces rotos
Las páginas huérfanas, a las que no apunta ningún enlace interno, son las víctimas habituales de los rediseños y de las migraciones de CMS.
Los enlaces internos rotos hacen perder rastreo a todos los bots, incluidos los de IA. Una auditoría completa del sitio, como la de nuestra lista de comprobación de auditoría SEO, detecta las páginas huérfanas y los enlaces rotos.
Redirecciones: 301 frente a 302, o 404
Cuando muevas o retires una URL, redirígela a una página que la sustituya de verdad, con una redirección permanente en el servidor (301 o 308). Google usa una redirección permanente como señal de que el destino debe ser la URL canónica, y muestra el destino en los resultados. Una redirección temporal (302 o 307) sirve para un cambio que vas a deshacer: Google suele seguir mostrando la página de origen y no la usa como señal de canonical, aunque otras señales aún pueden hacer que se indexe el destino. Si nada sustituye a la página, devuelve un 404 o un 410, que Google recomienda para las páginas eliminadas de forma permanente, y actualiza los enlaces que apuntaban a ella.
Experiencia de página: Core Web Vitals, móvil y HTTPS
Las Core Web Vitals son los factores de SEO técnico que se miden con datos de visitantes reales: carga, capacidad de respuesta y estabilidad visual. Google señala que las buenas puntuaciones se corresponden con lo que sus sistemas de posicionamiento principales buscan recompensar, pero son una señal entre muchas, y la relevancia va primero.
| Métrica | Qué mide | Valor bueno |
|---|---|---|
| Largest Contentful Paint (LCP) | Carga: cuándo aparece el contenido principal | 2,5 segundos o menos |
| Interaction to Next Paint (INP) | Capacidad de respuesta a clics, toques y pulsaciones de teclas | 200 milisegundos o menos |
| Cumulative Layout Shift (CLS) | Estabilidad visual (cambios inesperados del diseño) | 0,1 o menos |
La guía de Core Web Vitals de web.dev fija estos objetivos en el percentil 75 de las cargas de página, medidos por separado para móvil y escritorio. El INP sustituyó al First Input Delay como métrica de capacidad de respuesta, y cualquier valor por encima de 500 milisegundos se considera deficiente.
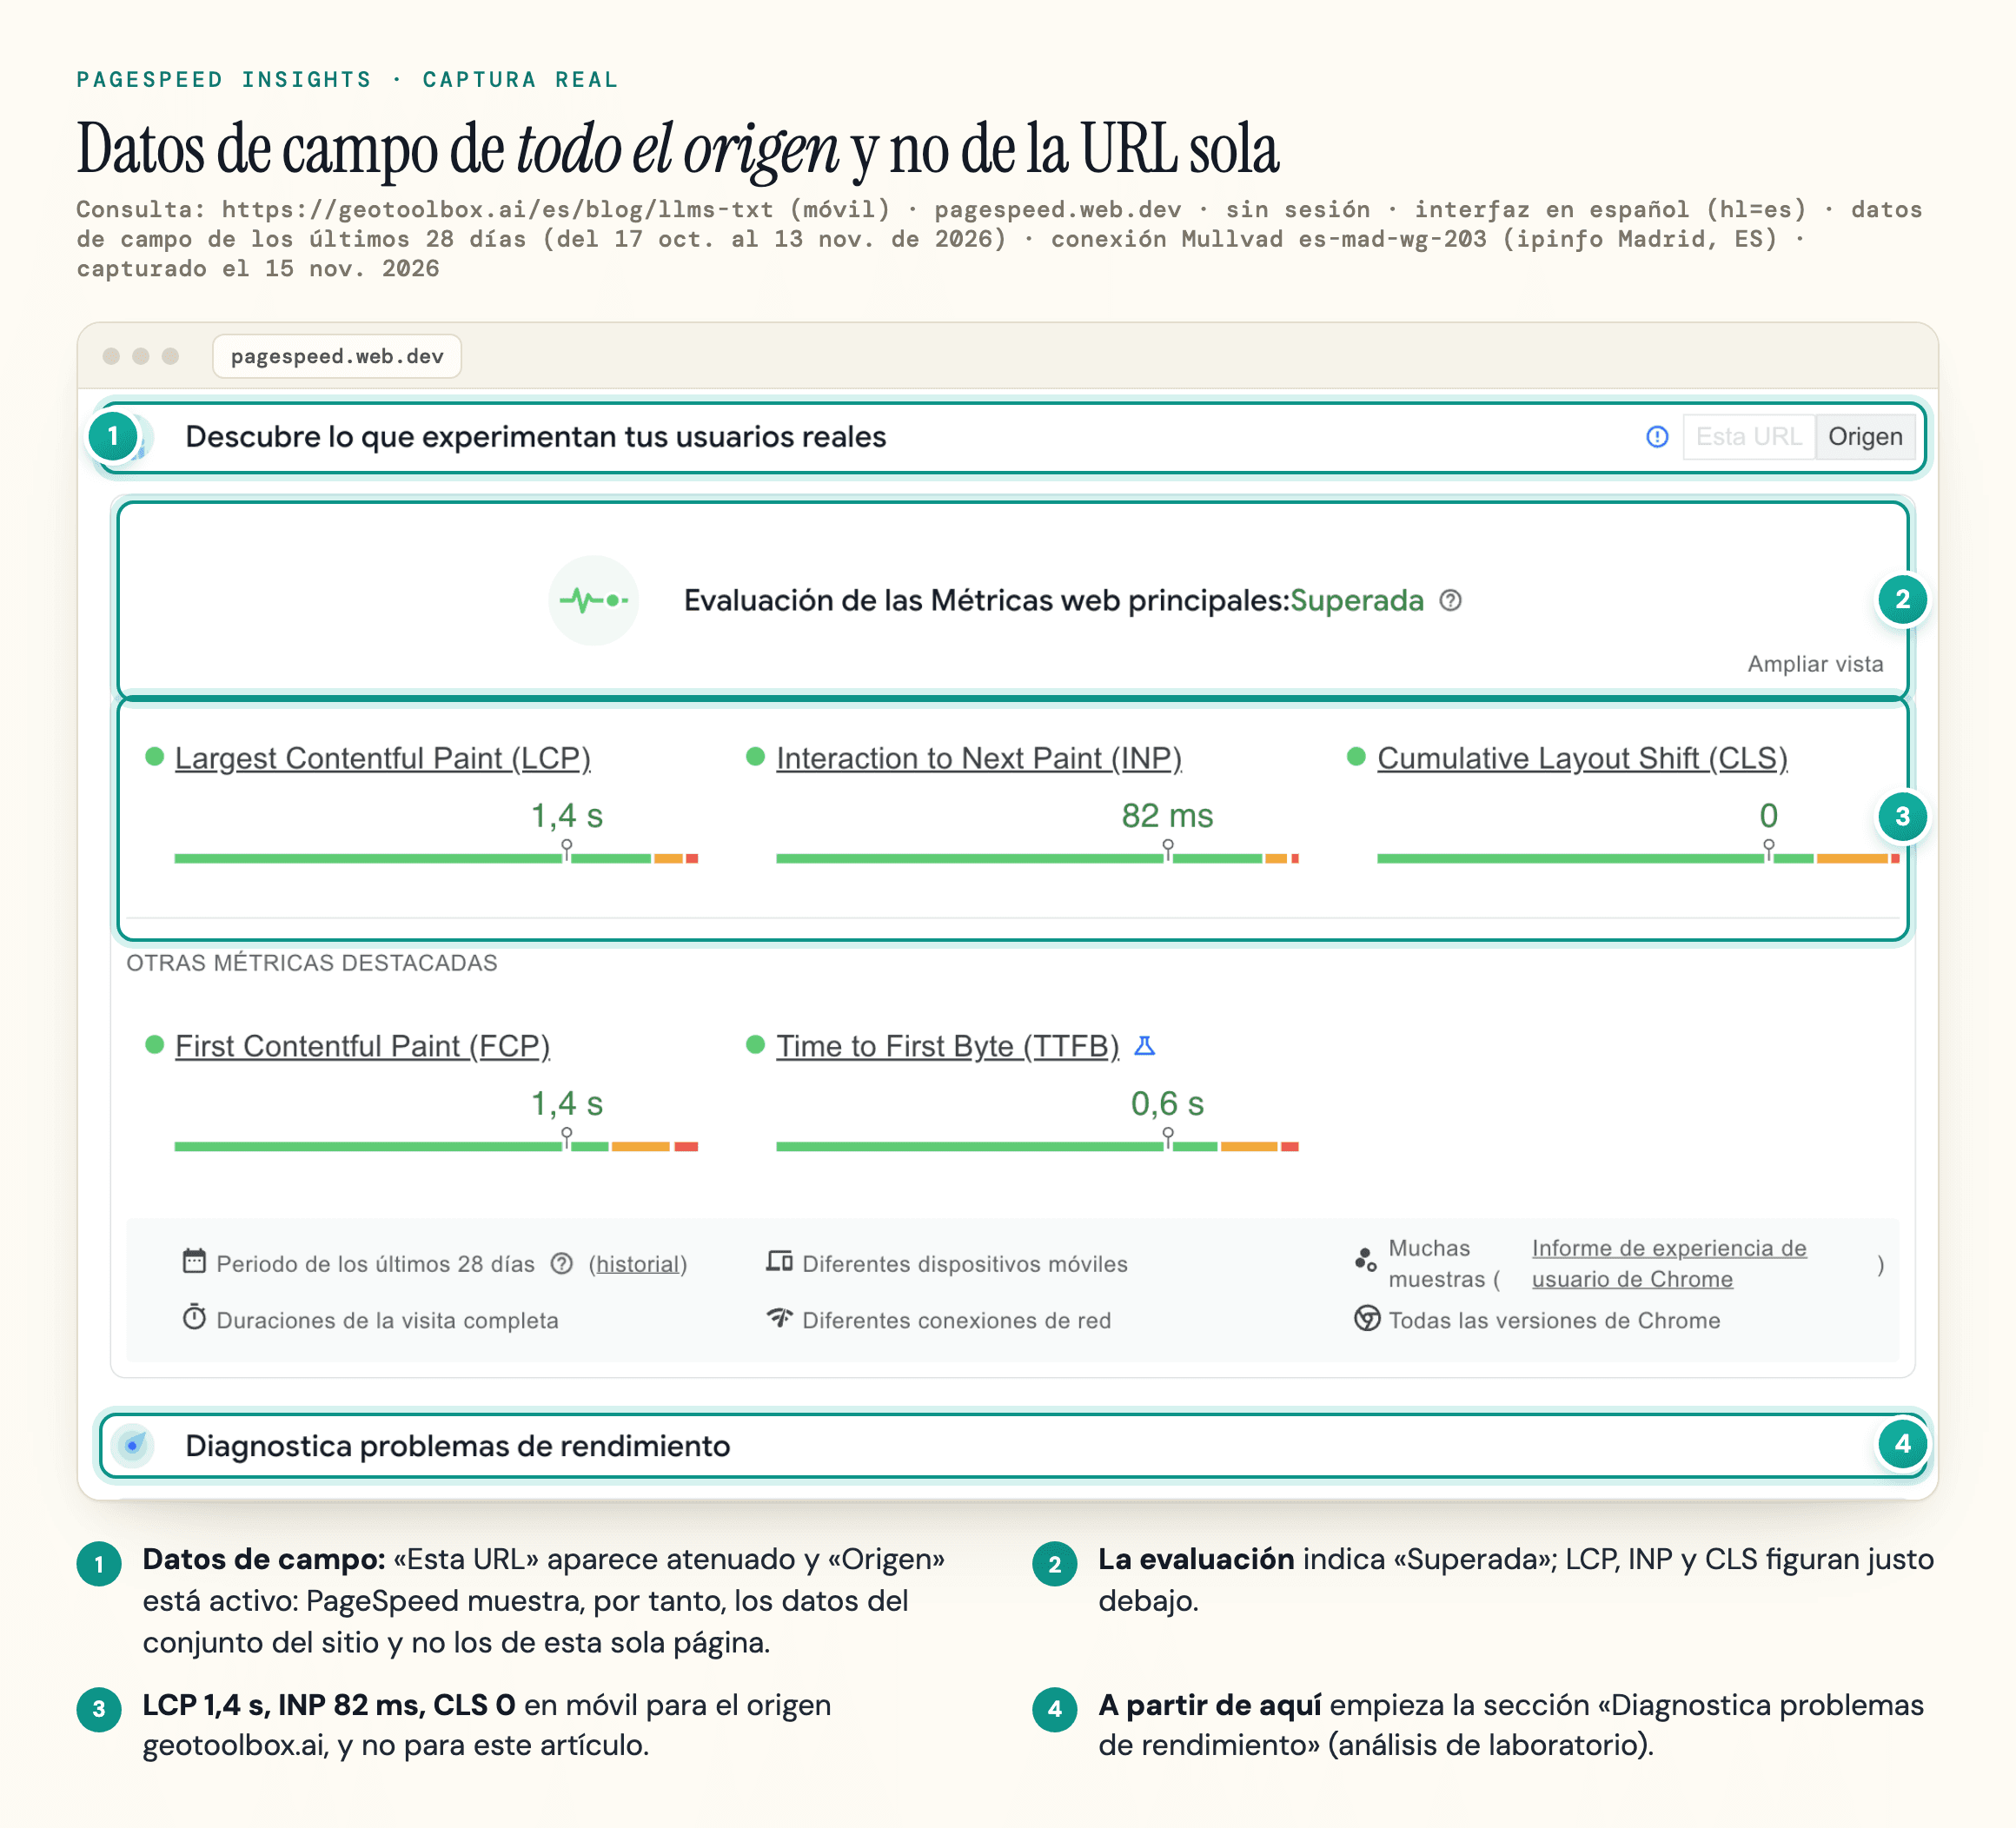
Fíjate en los datos de campo y no en la puntuación de laboratorio: esta cambia de una prueba a otra, mientras que los datos de campo proceden de usuarios reales de Chrome. Cuando una URL tiene muy poco tráfico, PageSpeed Insights muestra los datos de campo de todo el origen, si el origen tiene suficientes, como en la captura siguiente.
Cómo acelerar una página lenta
Para el LCP, la guía de optimización de web.dev recoge estas correcciones:
- Imágenes: no cargues nunca de forma diferida (lazy loading) la imagen del LCP, y comprime las imágenes en formatos modernos como AVIF o WebP
- Código que bloquea el renderizado: minifica y comprime el CSS crítico, y difiere o incrusta en el HTML el JavaScript que bloquea el renderizado
- Caché y distancia: una política de cache-control eficaz hace casi instantáneas las cargas repetidas, y un CDN entrega los archivos más cerca de los visitantes
- Respuesta del servidor: un tiempo hasta el primer byte lento, a menudo por cadenas de redirecciones o por respuestas que el CDN no puede guardar en caché, retrasa todo lo que viene después
Para el INP, la guía del INP de web.dev recomienda dividir las tareas largas de JavaScript en otras más pequeñas para que la página responda antes a la interacción.
Indexación mobile-first y HTTPS
Google indexa la versión móvil de tus páginas, que rastrea con el agente de smartphone; el contenido o los enlaces que faltan en la versión móvil faltan también para Google. Además, las páginas deben entregarse por HTTPS en un único host, y las URL HTTP y la otra versión del host (con www o sin www) deben redirigir a él.
¿La velocidad ayuda a que te citen las IA?
No hemos visto pruebas publicadas de que lo haga, y ninguna de las páginas de rastreadores de OpenAI, Anthropic o Perplexity que consultamos menciona la velocidad de la página.
Datos estructurados y hreflang
Los datos estructurados indican de qué trata una página en un formato que las máquinas leen sin tener que adivinar. Escríbelos en JSON-LD y mantenlos idénticos a lo que muestra la página.
La guía de optimización para IA de Google dice: «los datos estructurados no son obligatorios para la búsqueda con IA generativa y no es necesario añadir ningún etiquetado especial de schema.org». Aun así recomienda el marcado para poder optar a los resultados enriquecidos. Las pautas de Bing dicen que los datos estructurados pueden ayudar a que el grounding sea más claro, pero no garantizan visibilidad ni tráfico procedente del grounding.
En el único estudio de intervención que conocemos, Ahrefs siguió 1885 páginas que añadieron schema y comprobó que las citas en IA apenas variaron. Nuestro análisis de los datos estructurados para la búsqueda con IA recoge los estudios.
Validar los datos estructurados
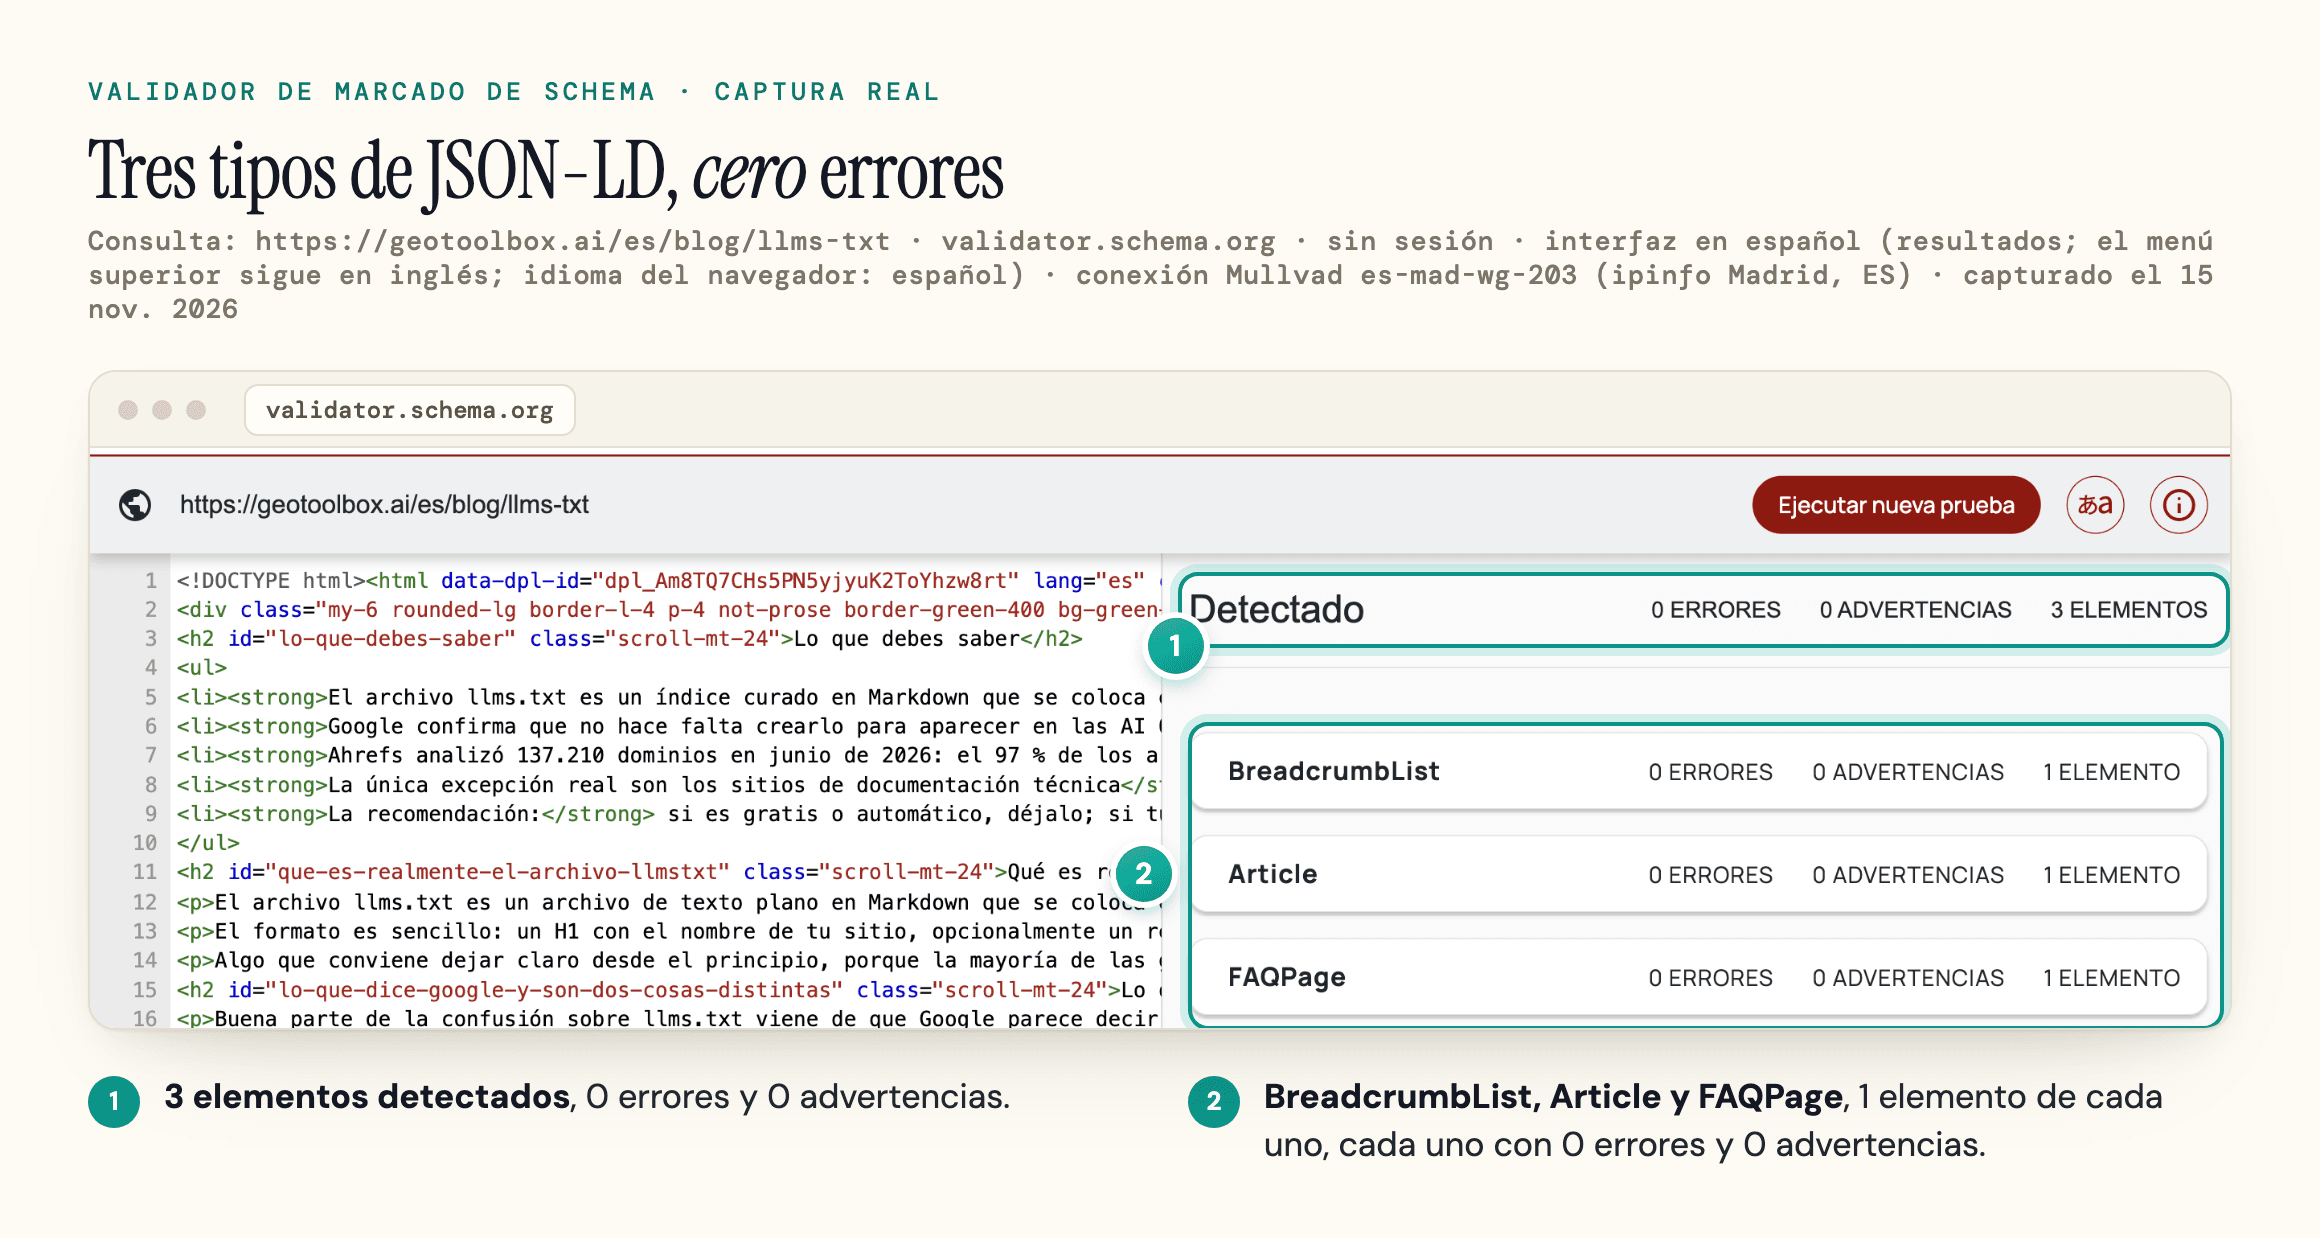
Un bloque JSON-LD con un error de sintaxis no se puede leer en absoluto, y Bing advierte de que el marcado engañoso puede ignorarse.
Usar hreflang en sitios multilingües
El atributo hreflang indica a Google qué versión de una página debe mostrar según el idioma o la región. Cada valor es un código de idioma en formato ISO 639-1, seguido opcionalmente de un código de región (es-ES, es-MX, en-US).
Los fallos más habituales son las anotaciones en un solo sentido (la página en español nombra a la inglesa, pero no al revés) y las anotaciones que apuntan a URL redirigidas o con noindex. Enlaza cada versión de idioma consigo misma y con todas las demás, apunta solo a URL canónicas y añade un valor x-default para la página por defecto.
Ninguna de las páginas de rastreadores de los proveedores de IA que consultamos menciona hreflang. Lo que sí pueden usar es una URL distinta y rastreable para cada idioma, que funcione en HTML sin renderizar.
Controles de la búsqueda con IA: qué cambia cada ajuste
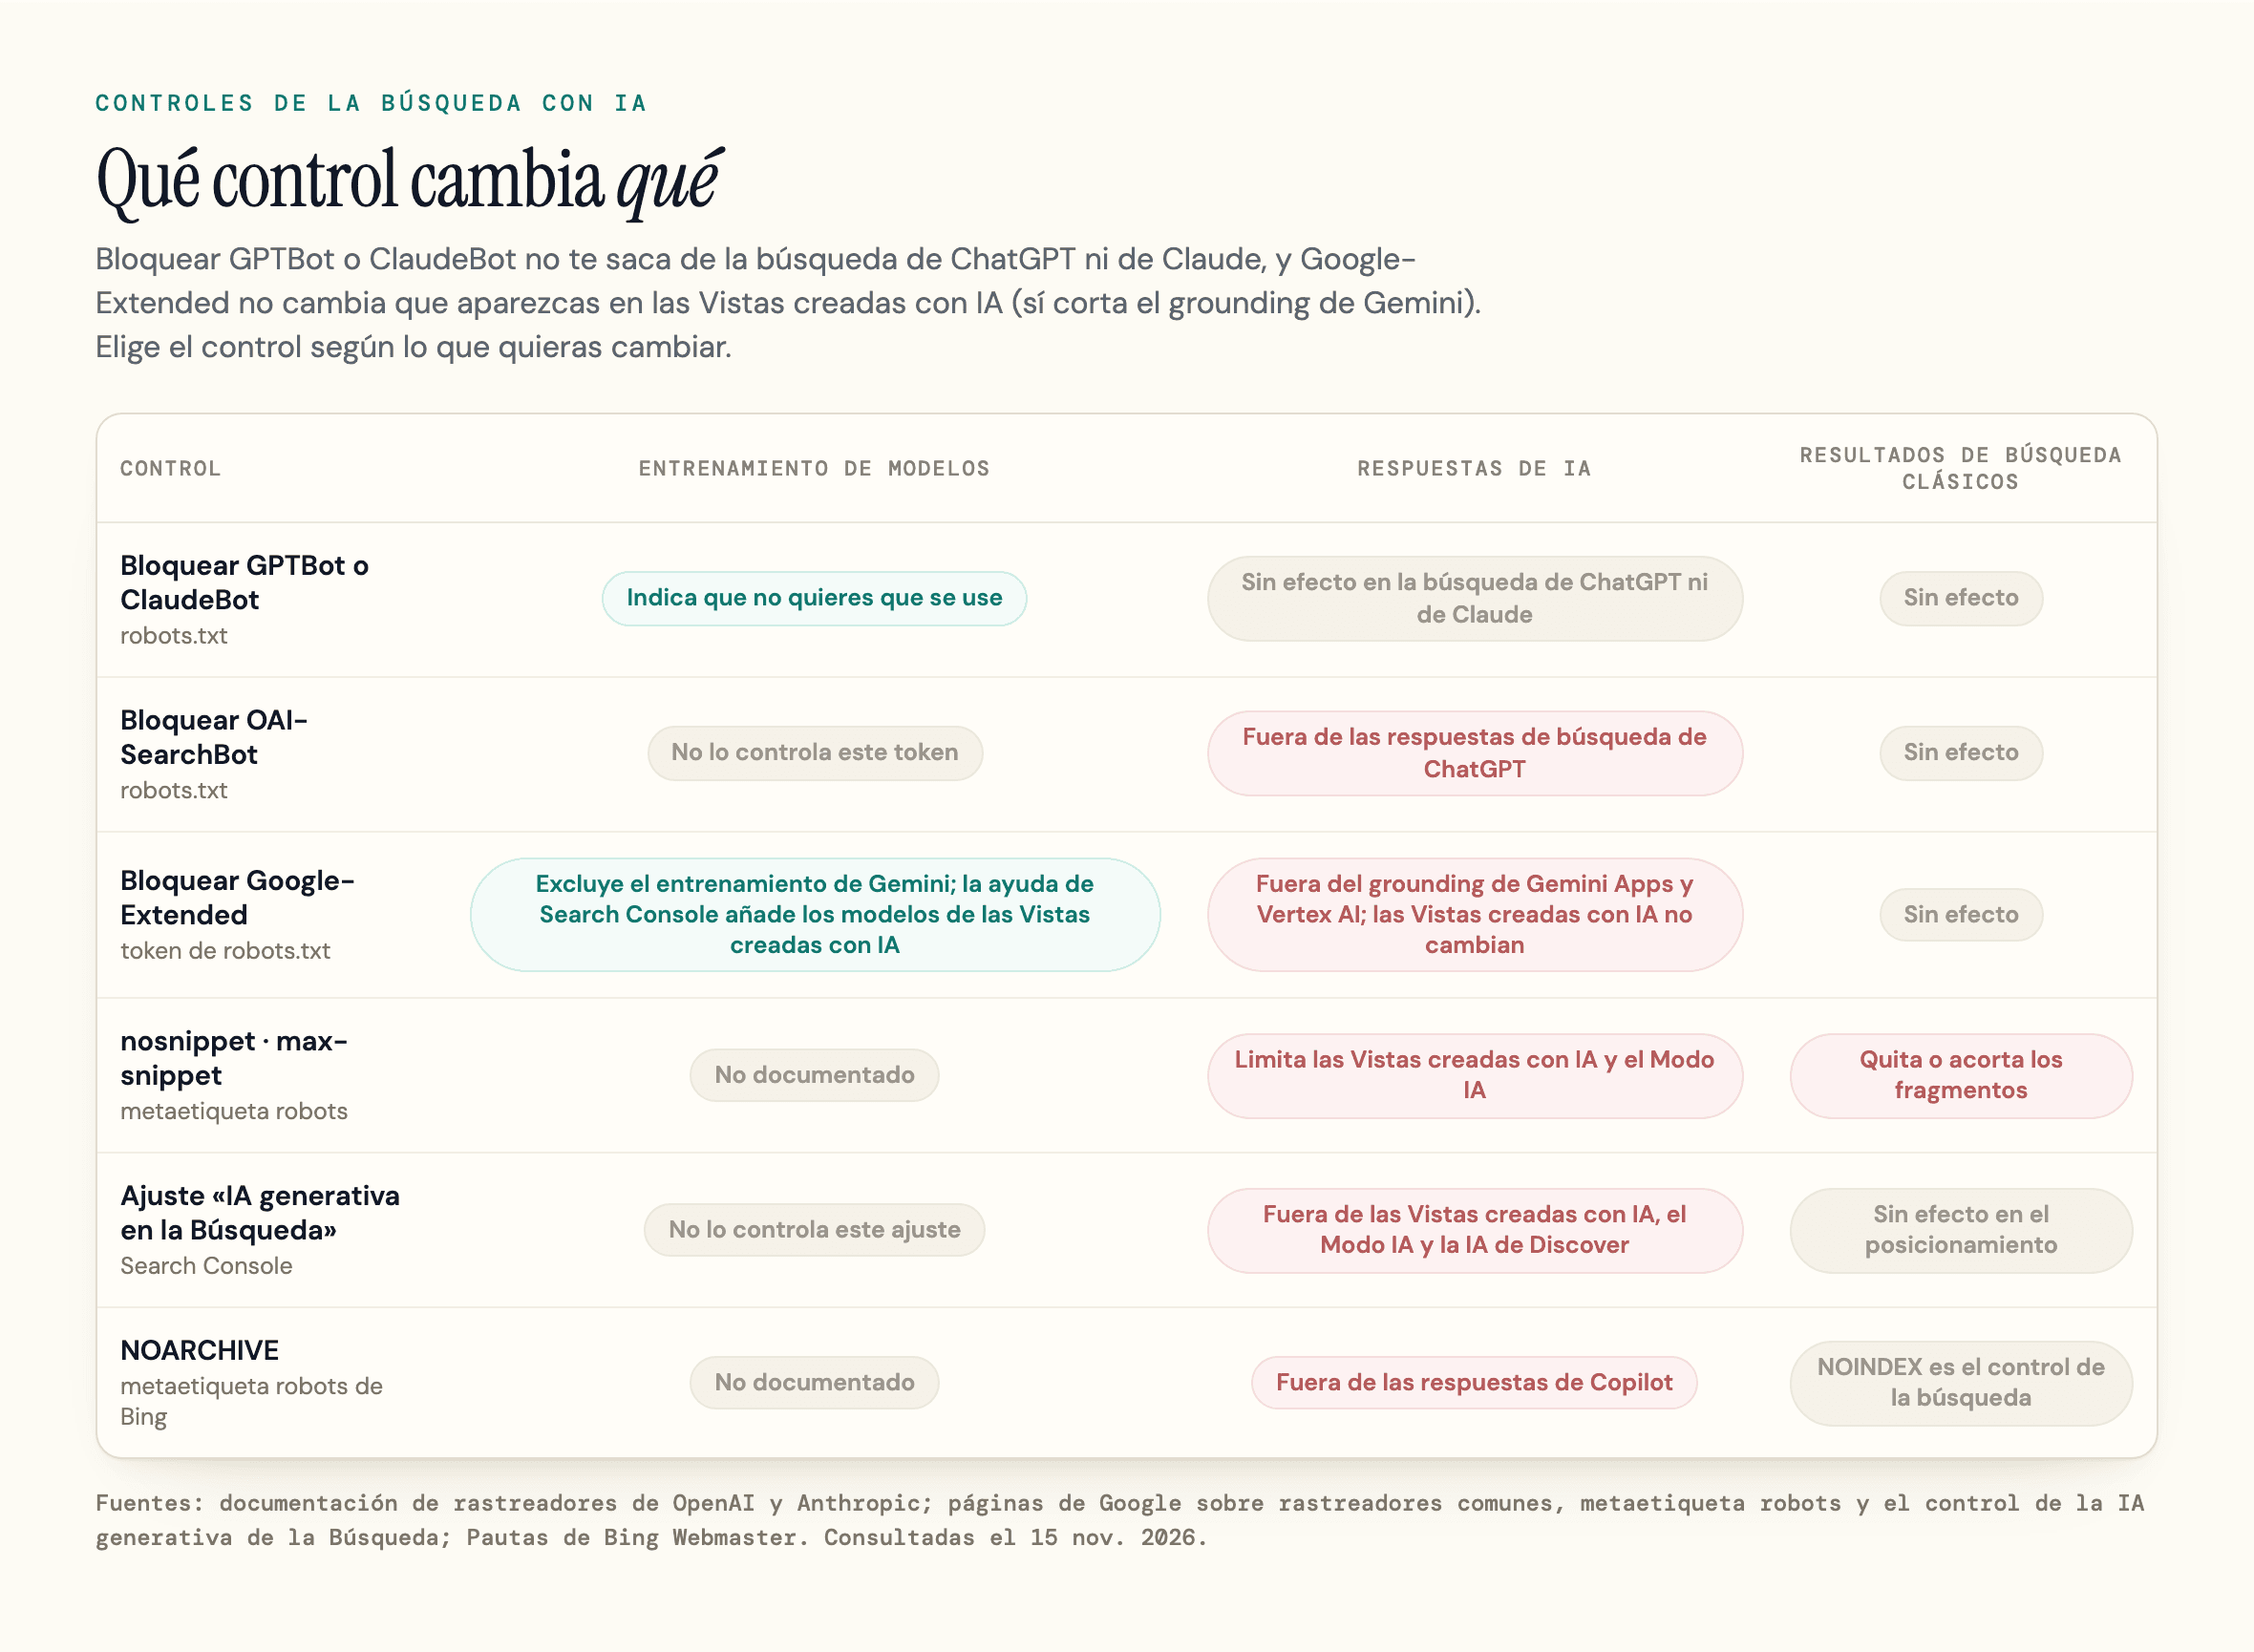
La mayoría de los errores al excluirse de la IA vienen de usar un control de entrenamiento para arreglar un problema de búsqueda, o al revés.
| Control | Qué hace | Qué no hace |
|---|---|---|
| Bloquear GPTBot o ClaudeBot | Indica que tu contenido no debe usarse para entrenar modelos | Sacarte de la búsqueda de ChatGPT o de Claude |
| Bloquear OAI-SearchBot | Mantiene tus páginas fuera de las respuestas de búsqueda de ChatGPT | Impedir los enlaces de navegación a tu sitio |
| Bloquear Google-Extended | Excluye tu contenido del entrenamiento de Gemini y del grounding en Gemini Apps y Vertex AI; la ayuda de Search Console añade el entrenamiento de los modelos que hay detrás de las Vistas creadas con IA y el Modo IA | Cambiar si apareces en la Búsqueda de Google, en las Vistas creadas con IA o en el Modo IA |
| Añadir nosnippet o max-snippet | Bloquea o limita el texto que Google puede usar como entrada directa de las Vistas creadas con IA y del Modo IA, y también puede reducir o quitar los fragmentos clásicos | Limitar el contenido que licencias a Google o que le facilitas como datos estructurados en la página (max-snippet) |
| Desactivar «IA generativa en la Búsqueda» en Search Console | Excluye la propiedad, y las propiedades secundarias que heredan su ajuste, de las Vistas creadas con IA, del Modo IA y de la IA generativa de Discover | Cambiar el posicionamiento en el resto de la Búsqueda |
| Añadir NOARCHIVE en Bing | Mantiene el contenido fuera de las respuestas y del grounding de Copilot | Quitar la URL de la búsqueda de Bing (eso lo hace NOINDEX) |
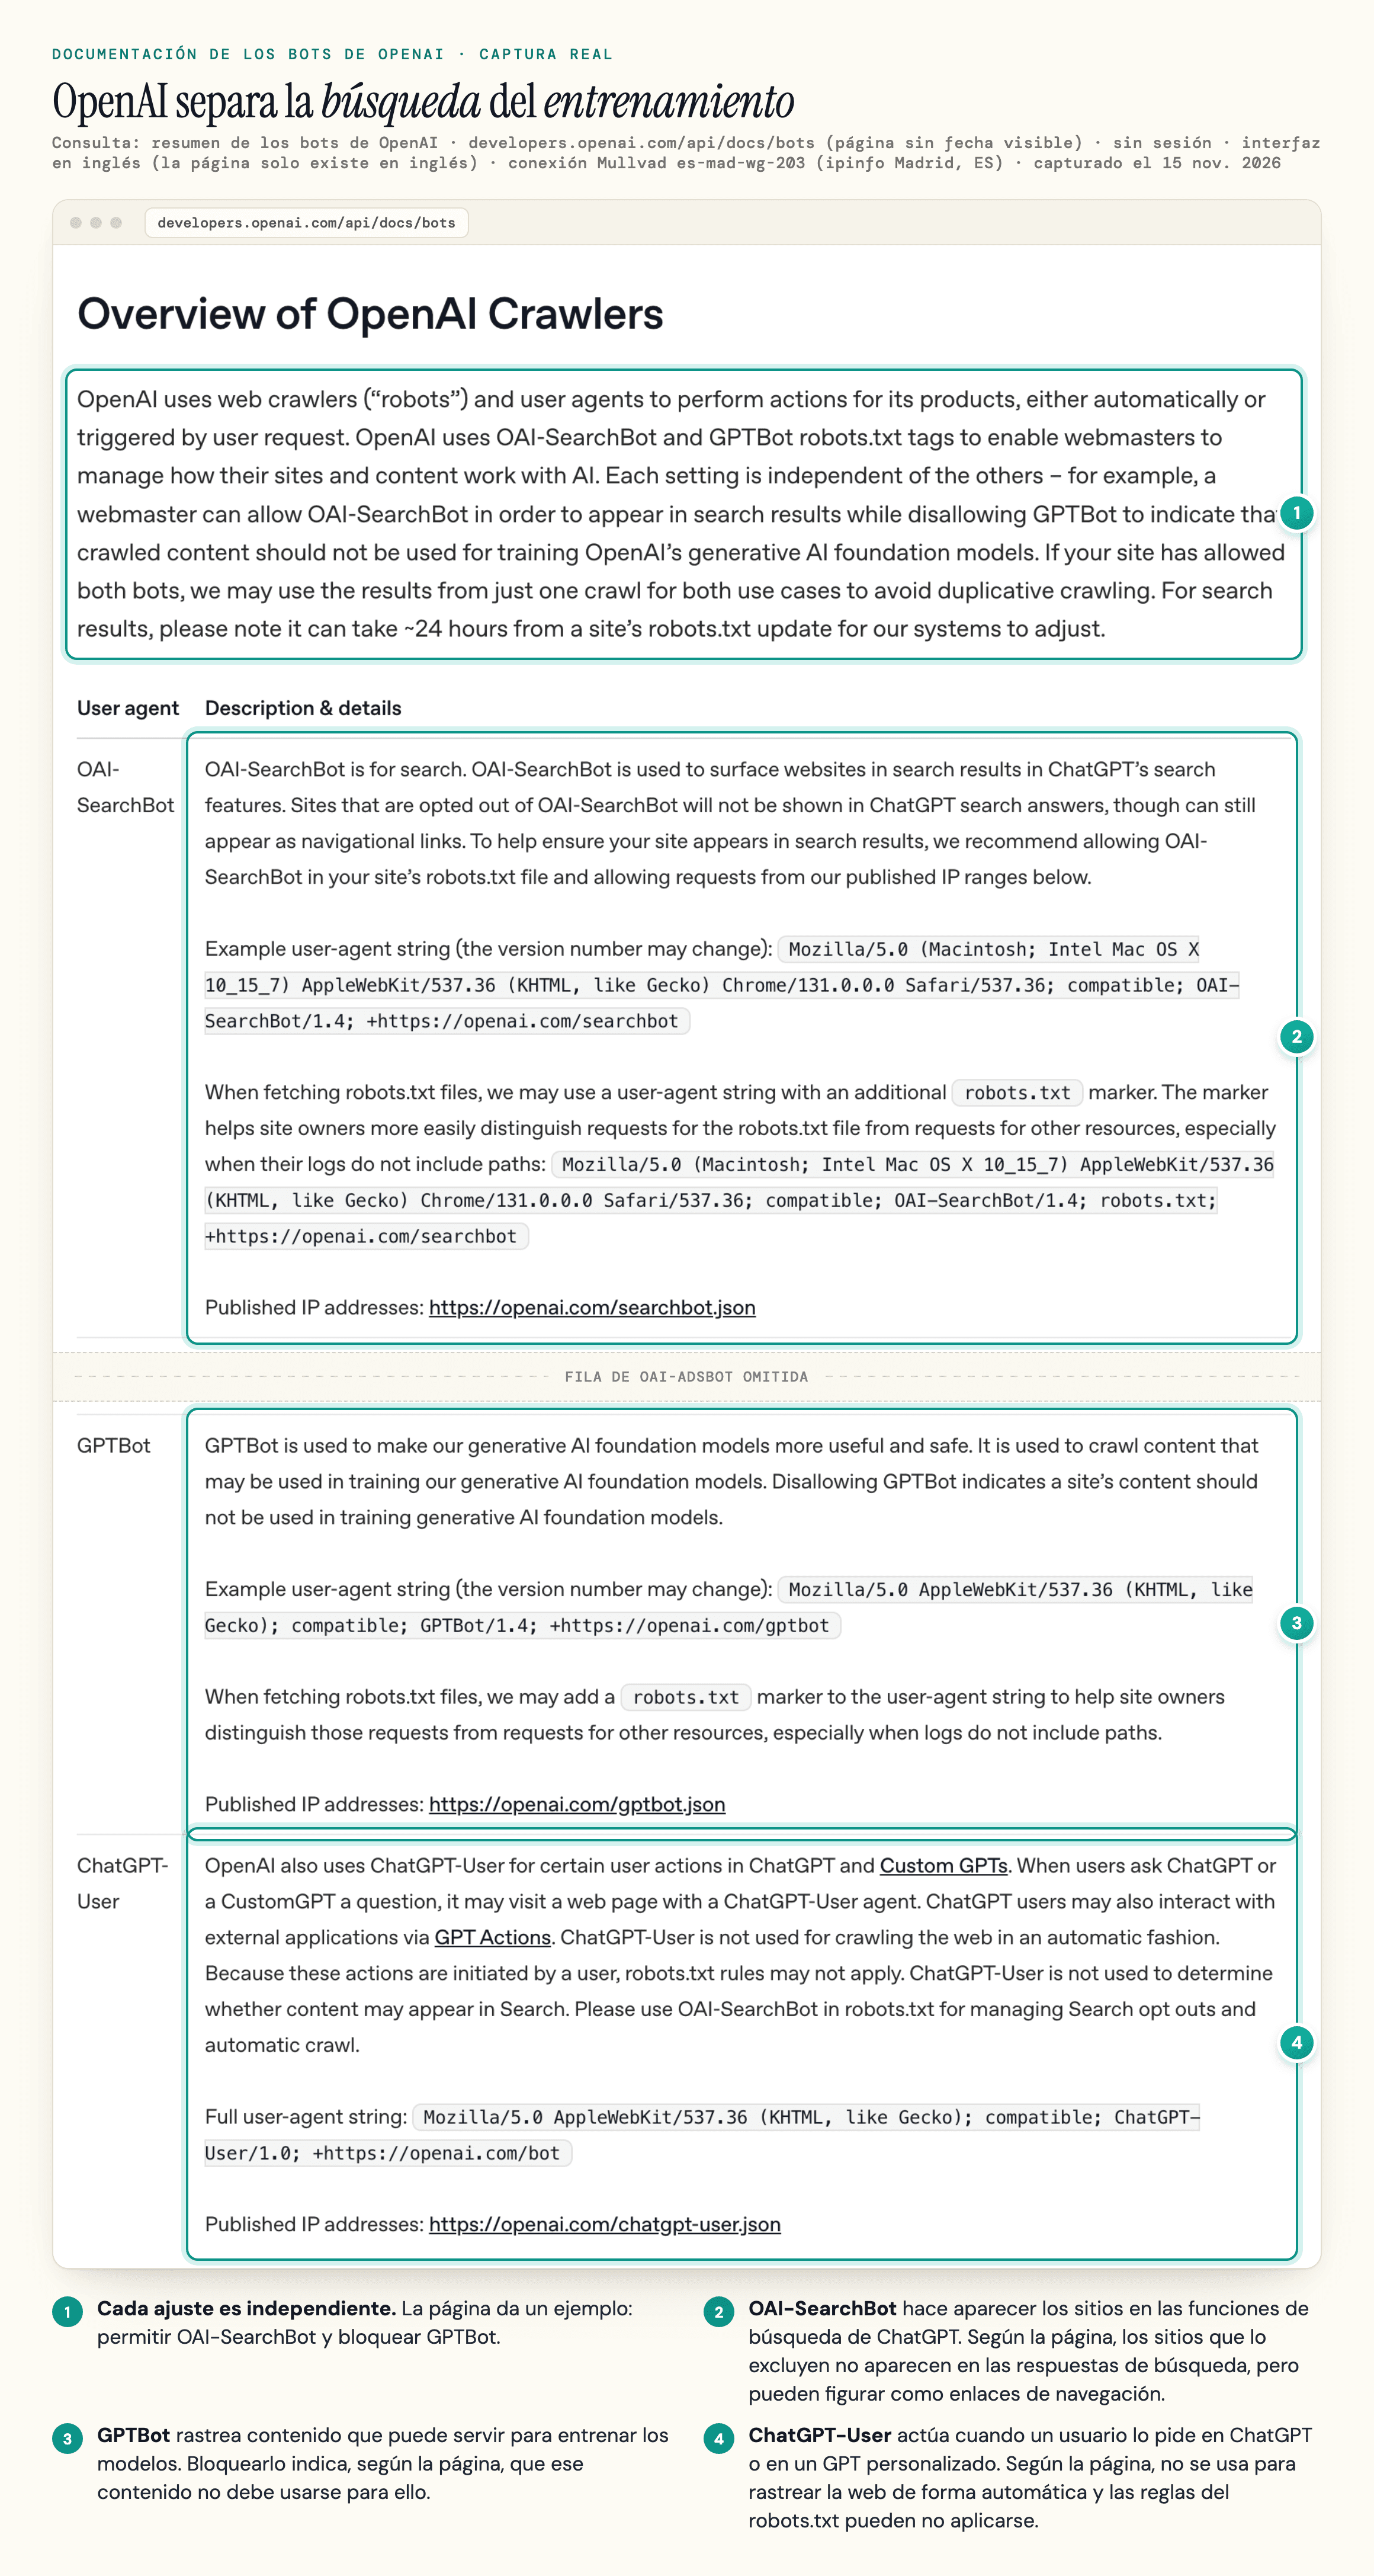
Según OpenAI, los sitios que excluyen OAI-SearchBot no se muestran en las respuestas de búsqueda de ChatGPT, aunque pueden seguir apareciendo como enlaces de navegación. En la página de rastreadores comunes de Google se lee que «Google-Extended no afecta a la inclusión de los sitios en la Búsqueda de Google».
Para las Vistas creadas con IA, las opciones son la familia nosnippet y el control de la IA generativa de la Búsqueda (en Search Console, Ajustes > IA generativa en la Búsqueda), que al 31 de agosto de 2026 Google ya había desplegado en todos los sitios web. Google indica que la exclusión suele tardar unos días: el contenido sale en 1 o 2 días después de aplicar el control, y parte puede tardar más por la caché.
Hay un archivo que puedes omitir para Google: su guía de optimización para IA dice que los archivos llms.txt ni ayudan ni perjudican a la visibilidad en la Búsqueda de Google. Consulta nuestro análisis de llms.txt para otros motores, y cómo desactivar las Vistas creadas con IA para los pasos de la exclusión.
Una señal compartida contra el entrenamiento
Según la página de Anthropic sobre sus bots, al 30 de octubre de 2026 la empresa ya había empezado a reconocer una señal legible por máquina con la que el propietario de un sitio indica si acepta que su contenido se use para entrenar modelos de IA. La señal sigue un borrador del grupo de trabajo aipref del IETF. La página de rastreadores comunes de Google indica que tiene previsto admitir la misma señal, que se define con user-agent: __usage_ai-training, a principios de 2027.
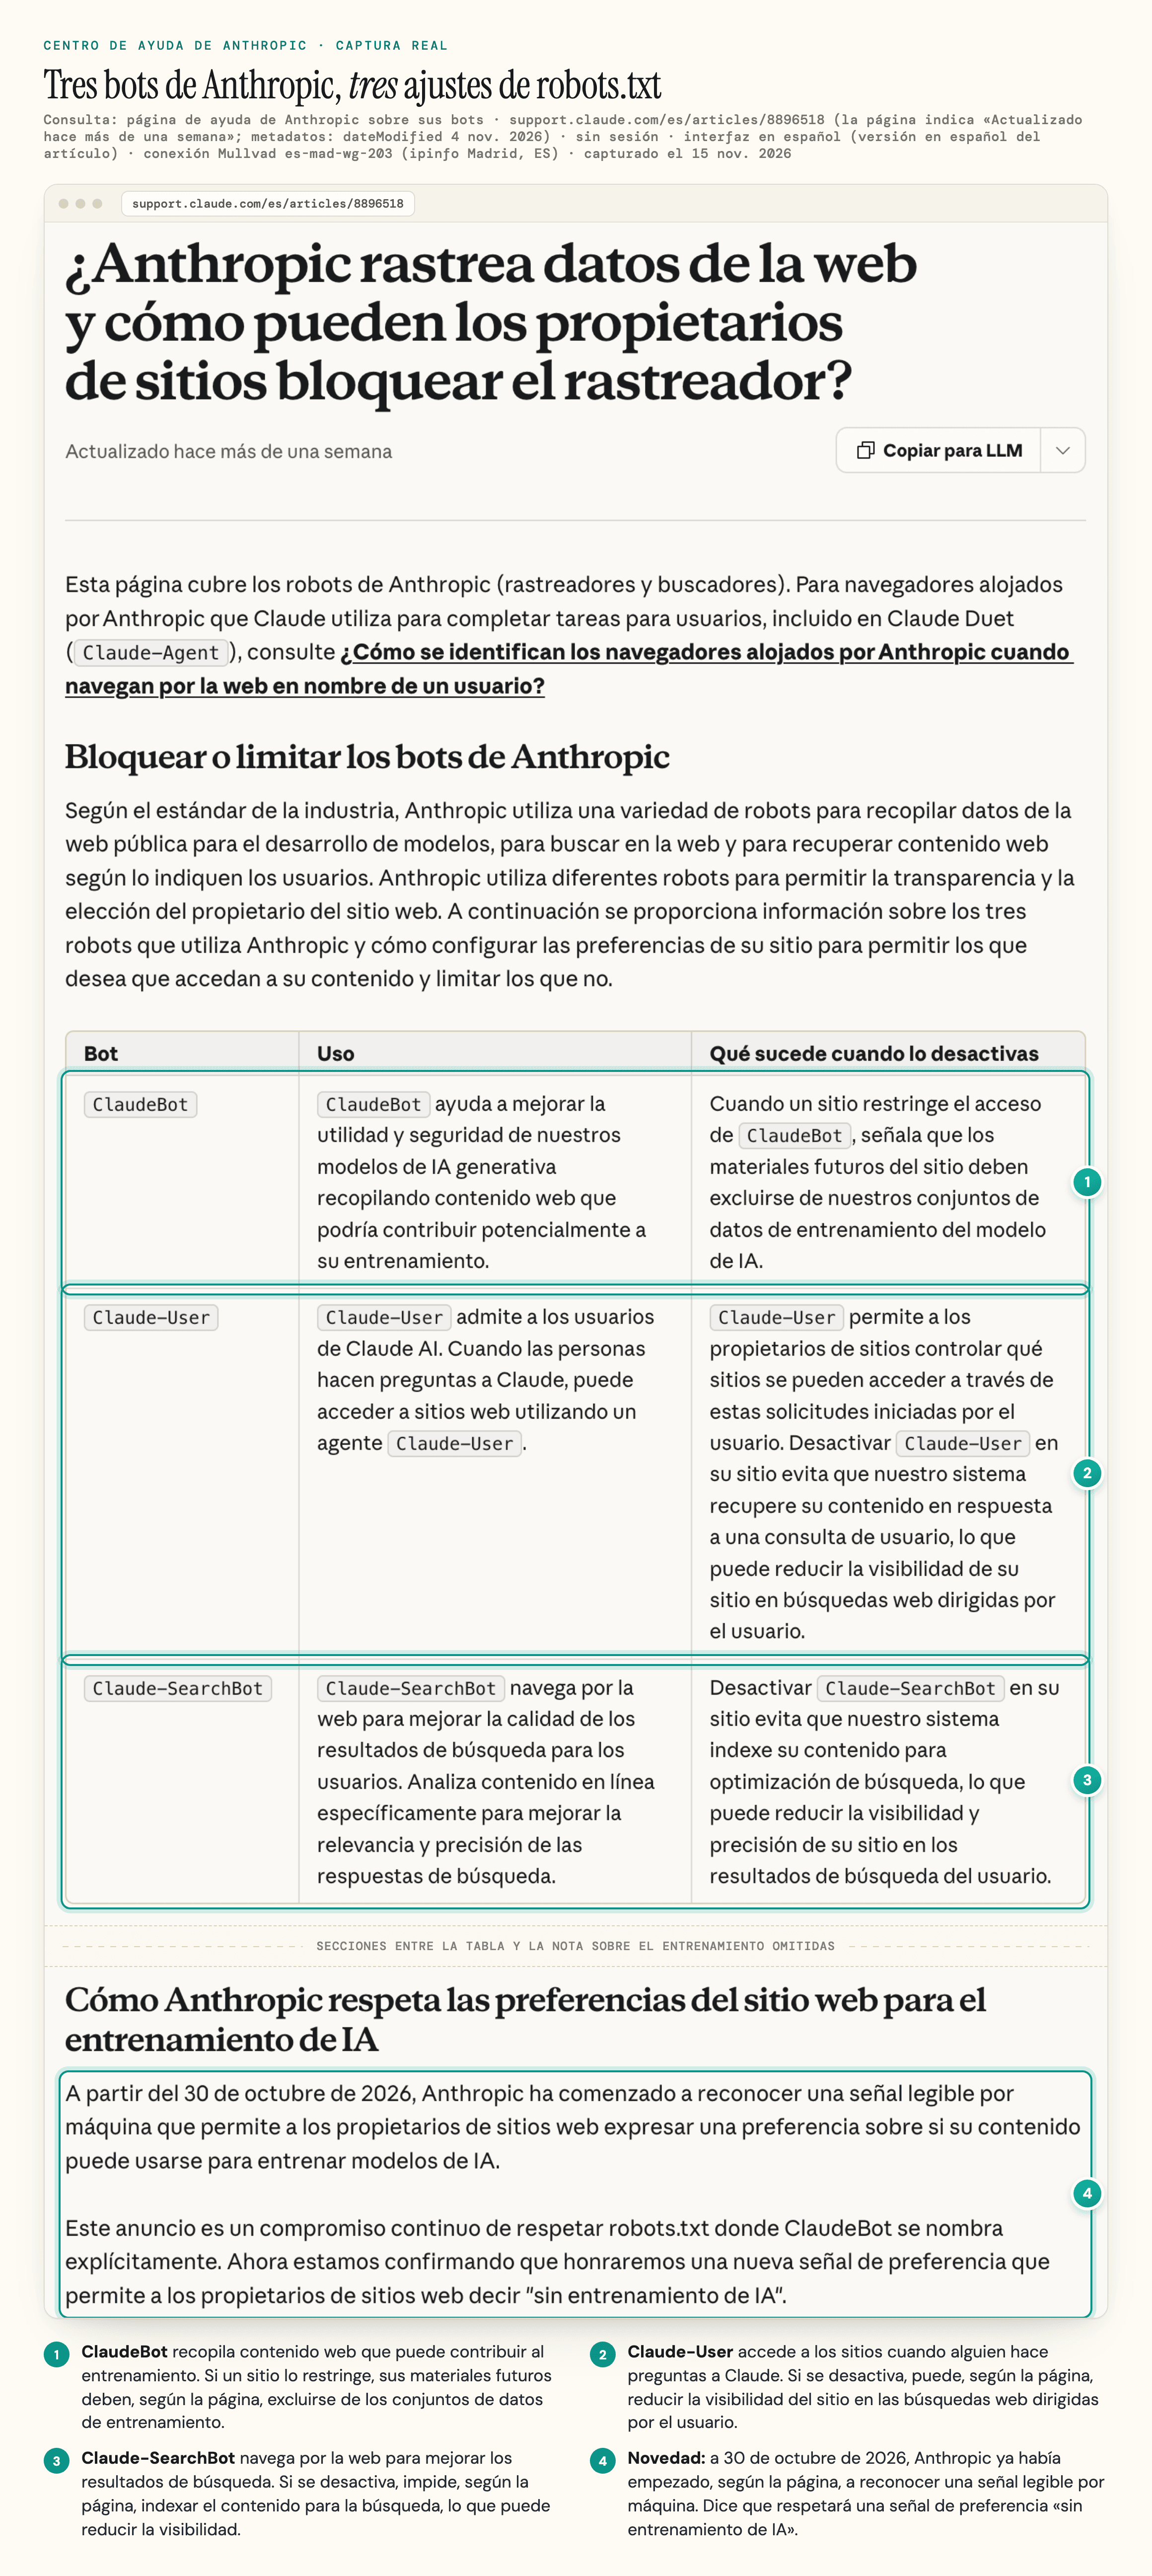
Qué dice la ley española sobre reservar el uso de tus contenidos
En España, el límite de minería de textos y datos está en el artículo 67 del Real Decreto-ley 24/2021, no en la Ley de Propiedad Intelectual. Permite reproducir obras de acceso legítimo con ese fin sin autorización, salvo que los titulares «hayan reservado expresamente el uso de las obras a medios de lectura mecánica u otros medios que resulten adecuados». El artículo no menciona el robots.txt ni las condiciones de uso. A escala europea, los firmantes del código de buenas prácticas para la IA de uso general (10 de julio de 2025) se comprometen a usar rastreadores que lean y respeten el robots.txt.
El texto no dice que el robots.txt baste por sí solo ni qué otros medios son «adecuados», y no sabemos cómo lo interpretarán los tribunales españoles: en la búsqueda del CENDOJ del 15 de noviembre de 2026 no encontramos resoluciones sobre este punto. En la práctica, el robots.txt es la señal que los rastreadores leen y que los firmantes del código se comprometen a respetar. Esto no es asesoramiento legal.
Lista de comprobación rápida de SEO técnico
Estas buenas prácticas de SEO técnico se apoyan unas en otras. Una página que no se puede descargar no gana nada con el schema: los primeros puntos son los más importantes.
- Acceso: las URL importantes devuelven 200, el robots.txt permite los bots que quieres y tu CDN no los bloquea
- Renderizado: el texto principal y los enlaces están en el HTML sin renderizar (la prueba del código fuente)
- Indexación: ningún noindex accidental, una canonical por página y un sitemap solo con URL canónicas, enviado en Search Console o indicado en el robots.txt
- Arquitectura: cada página importante tiene una ruta de enlaces internos rastreable; las URL movidas o retiradas redirigen de forma permanente (301) a una sustitución real, o devuelven 404 o 410 si no existe
- Experiencia de página: las Core Web Vitals se superan en datos de campo, en móvil y por HTTPS
- Datos estructurados: JSON-LD válido que coincide con la página visible; hreflang enlaza cada versión de idioma consigo misma y con todas las demás
- Controles de IA: cada grupo de robots.txt, cada ajuste de fragmentos y cada ajuste de Search Console elegidos a propósito
- Medición: el «Informe de rendimiento de IA generativa» de Google Search Console, el informe AI Performance de Bing y los logs del servidor filtrados por user-agent
Empieza por el punto 1. Pega tu dominio en el AI Crawler Checker gratuito de geotoolbox para ver qué bots de IA bloquea tu robots.txt en la ruta de la página de inicio, y después ejecuta el escaneo Agent Readiness para ver qué devuelve tu firewall a esos bots.
Medir los rastreadores de IA y las citas
Cualquiera puede falsificar un user-agent. Por eso, en los logs, coteja los bots de IA que dicen ser de OpenAI, Anthropic o Perplexity con las listas de IP que publican para sus rastreadores. Por el lado de Google, la guía de optimización para IA remite al «Informe de rendimiento de IA generativa» de Google Search Console.
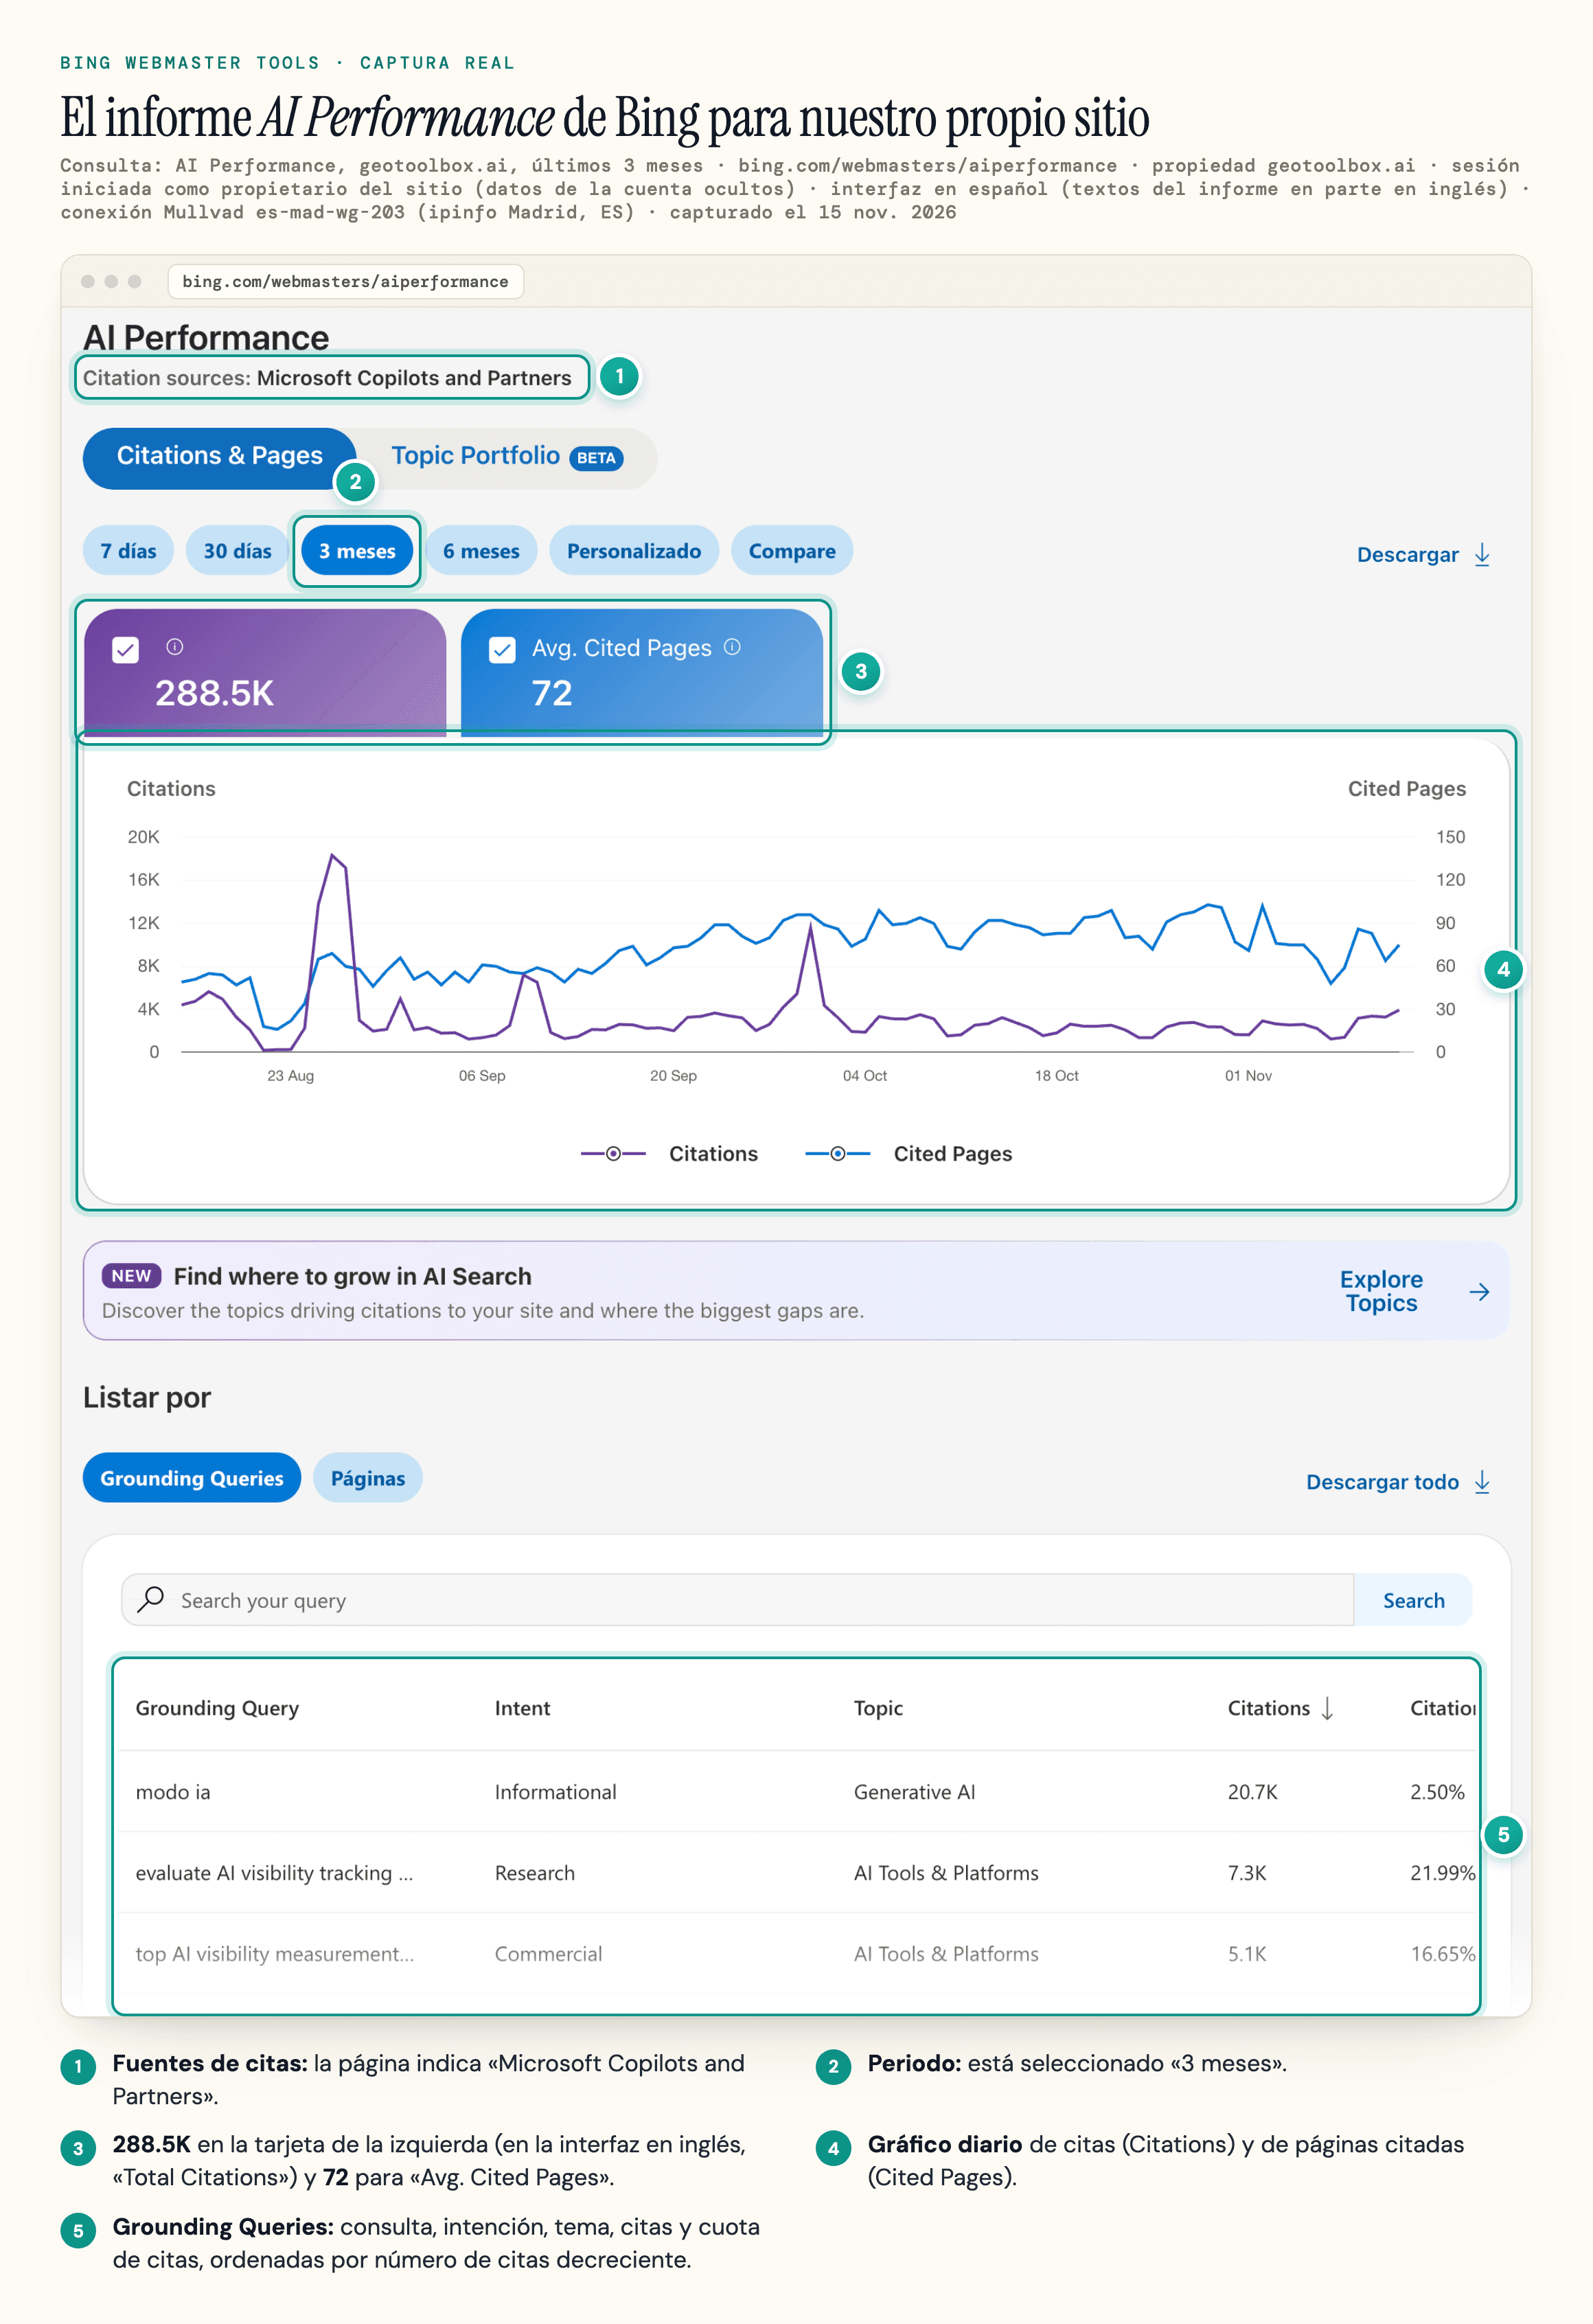
El informe AI Performance de Bing muestra qué páginas tuyas citan Copilot y los resúmenes con IA de Bing, y las consultas de grounding que hay detrás. Cuenta citas; no informa de clics.
Preguntas frecuentes
¿Hay que saber programar para hacer SEO técnico?
No, pero sí hay que saber leer código. Gran parte del trabajo es diagnóstico: leer el robots.txt, los códigos de estado, el código fuente de la página y los informes de Search Console. Las correcciones como el renderizado en el servidor o las reglas de redirección suelen quedar en manos de un desarrollador.
¿Sigue importando el SEO técnico con la búsqueda con IA?
Sí, y probablemente más. Copilot funciona con el índice de Bing, y los rastreadores de IA que leen HTML sin renderizar son menos indulgentes que Googlebot. Una página que no pueden descargar o leer no se puede citar.
¿Qué es la regla 80/20 en el SEO técnico?
La mayor parte del impacto viene de unas pocas comprobaciones: si las páginas importantes se pueden rastrear, renderizar e indexar. Corrige el acceso, el contenido en HTML sin renderizar y las señales de indexación antes de dedicar tiempo a puntuaciones como el rendimiento de Lighthouse o a avisos menores del validador.
¿Puede ChatGPT hacer SEO técnico?
Puede explicar un error, redactar reglas de robots.txt, redirecciones o JSON-LD y resumir una exportación de rastreo que le pegues. No puede ver los logs de tu servidor, tus datos de Search Console ni lo que recibió realmente cada bot, así que contrasta sus sugerencias con esos datos antes de publicar un cambio.
Fuentes
- Google Search Central - Requisitos técnicos de la Búsqueda de Google (actualizado el 18 de diciembre de 2025) -
developers.google.com/search/docs/essentials/technical?hl=es - Google Search Central - Funciones de IA y tu sitio web (actualizado el 31 de diciembre de 2025) -
developers.google.com/search/docs/appearance/ai-features?hl=es - Google Search Central - Guía de Google sobre la optimización para las funciones de IA generativa de la Búsqueda de Google (actualizado el 15 de julio de 2026) -
developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=es - Ayuda de Search Console - Control de la IA generativa de la Búsqueda (consultado el 15 de noviembre de 2026) -
support.google.com/webmasters/answer/16908024?hl=es - Google España - La Vista creada con IA en la Búsqueda llega a Europa (26 de marzo de 2025) -
blog.google/intl/es-es/productos/la-vista-creada-con-ia-en-la-busqueda-llega-a-europa - Google España - La Búsqueda de Google: el Modo IA llega a España (8 de octubre de 2025) -
blog.google/intl/es-es/productos/la-busqueda-de-google-el-modo-ia-llega-a-espana - Infraestructura de rastreo de Google - Rastreadores habituales de Google, Google-Extended (actualizado el 3 de noviembre de 2026) -
developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers?hl=es - Google Search Central - Especificaciones de las metaetiquetas «robots» (actualizado el 26 de marzo de 2026) -
developers.google.com/search/docs/crawling-indexing/robots-meta-tag?hl=es - Google Search Central - Comprender conceptos básicos del SEO en JavaScript (actualizado el 11 de noviembre de 2026) -
developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics?hl=es - Google Search Central - Introducción a los archivos robots.txt (actualizado el 18 de diciembre de 2025) -
developers.google.com/search/docs/crawling-indexing/robots/intro?hl=es - Infraestructura de rastreo de Google - Gestión del presupuesto de rastreo (actualizado el 16 de septiembre de 2026) -
developers.google.com/crawling/docs/crawl-budget?hl=es - Infraestructura de rastreo de Google - Gestionar el rastreo de URLs de navegación por facetas (actualizado el 6 de marzo de 2026) -
developers.google.com/crawling/docs/faceted-navigation?hl=es - Google Search Central - Qué es un sitemap (actualizado el 18 de diciembre de 2025) -
developers.google.com/search/docs/crawling-indexing/sitemaps/overview?hl=es - Google Search Central - Crear y enviar un sitemap (actualizado el 15 de julio de 2026) -
developers.google.com/search/docs/crawling-indexing/sitemaps/build-sitemap?hl=es - Google Search Central - Prácticas recomendadas para la paginación en Google (actualizado el 18 de diciembre de 2025) -
developers.google.com/search/docs/specialty/ecommerce/pagination-and-incremental-page-loading?hl=es - Google Search Central - Las redirecciones y la Búsqueda de Google (actualizado el 5 de mayo de 2026) -
developers.google.com/search/docs/crawling-indexing/301-redirects?hl=es - Google Search Central - Versiones localizadas de tus páginas (actualizado el 23 de septiembre de 2026) -
developers.google.com/search/docs/specialty/international/localized-versions?hl=es - Google Search Central - Prácticas recomendadas para la indexación centrada en los móviles (actualizado el 20 de febrero de 2026) -
developers.google.com/search/docs/crawling-indexing/mobile/mobile-sites-mobile-first-indexing?hl=es - Google Search Central - Conceptos básicos sobre las Métricas web principales y los resultados de búsqueda de Google (actualizado el 18 de diciembre de 2025) -
developers.google.com/search/docs/appearance/core-web-vitals?hl=es - Ayuda de Search Console - Informe «Indexación de páginas» (consultado el 15 de noviembre de 2026) -
support.google.com/webmasters/answer/7440203?hl=es - Ayuda de Search Console - Herramienta de inspección de URLs (consultado el 15 de noviembre de 2026) -
support.google.com/webmasters/answer/9012289?hl=es - web.dev - Web Vitals (actualizado el 31 de octubre de 2024) -
web.dev/articles/vitals - web.dev - Interaction to Next Paint (INP) (actualizado el 2 de septiembre de 2025) -
web.dev/articles/inp - web.dev - Optimize Largest Contentful Paint (actualizado el 31 de marzo de 2025) -
web.dev/articles/optimize-lcp - web.dev - Optimize Interaction to Next Paint (actualizado el 2 de septiembre de 2025) -
web.dev/articles/optimize-inp - IETF - RFC 9309, Robots Exclusion Protocol (septiembre de 2022) -
www.rfc-editor.org/rfc/rfc9309.html - OpenAI - Overview of OpenAI Crawlers (consultado el 15 de noviembre de 2026) -
developers.openai.com/api/docs/bots - Anthropic - ¿Anthropic rastrea datos de la web y cómo pueden los propietarios de sitios bloquear el rastreador? (actualizado el 4 de noviembre de 2026) -
support.claude.com/es/articles/8896518 - Perplexity - Perplexity Crawlers (actualizado el 12 de noviembre de 2026) -
docs.perplexity.ai/docs/resources/perplexity-crawlers - Microsoft Bing - Bing Webmaster Guidelines (consultado el 15 de noviembre de 2026) -
www.bing.com/webmasters/help/webmaster-guidelines-30fba23a - Microsoft Bing - AI Performance in Bing Webmaster Tools (consultado el 15 de noviembre de 2026) -
www.bing.com/webmasters/help/ai-performance-9f8e7d6c - Vercel - The rise of the AI crawler (17 de diciembre de 2024) -
vercel.com/blog/the-rise-of-the-ai-crawler - Genezio - OpenAI's Search Crawler Runs JavaScript (22 de octubre de 2026) -
genezio.com/research/openai-crawler-runs-javascript - JS SEO Lab - JavaScript execution has two depths, and bots split cleanly between them (actualizado el 25 de octubre de 2026) -
jsseo.dev/findings/javascript-execution-has-two-depths - searchVIU - Schema markup and AI put to the test (actualizado el 15 de octubre de 2026; prueba realizada el 30 de octubre de 2025) -
www.searchviu.com/en/guides/schema-markup-ai - Ahrefs - We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved. (11 de mayo de 2026) -
ahrefs.com/blog/schema-ai-citations - Forge - Can AI crawlers run JavaScript? What ChatGPT-User really sees on your page (24 de septiembre de 2026) -
www.forgeaibotlog.com/articles/can-ai-crawlers-execute-javascript - Infraestructura de rastreo de Google - Fetchers activados por el usuario de Google (actualizado el 18 de septiembre de 2026) -
developers.google.com/crawling/docs/crawlers-fetchers/google-user-triggered-fetchers?hl=es - Infraestructura de rastreo de Google - Cómo interpreta Google la especificación robots.txt (actualizado el 27 de octubre de 2026) -
developers.google.com/crawling/docs/robots-txt/robots-txt-spec?hl=es - Cloudflare - Cloudflare just changed how AI crawlers scrape the Internet-at-large (nota de prensa, 1 de julio de 2025) -
www.cloudflare.com/press/press-releases/2025/cloudflare-just-changed-how-ai-crawlers-scrape-the-internet-at-large - Cloudflare - Visibilidad sin entrenamiento de la IA, las dos cosas son posibles (anunciado el 15 de septiembre de 2026; versión en español del 21 de septiembre de 2026) -
blog.cloudflare.com/es-es/accountable-mixed-use-ai-crawlers - BOE - Real Decreto-ley 24/2021, de 2 de noviembre, artículo 67 (texto consolidado, última actualización publicada el 29 de junio de 2023) -
www.boe.es/buscar/act.php?id=BOE-A-2021-17910 - Comisión Europea - The General-Purpose AI Code of Practice (código publicado el 10 de julio de 2025; el compromiso sobre el robots.txt está en el capítulo de derechos de autor, que se descarga desde esta página; consultado el 15 de noviembre de 2026) -
digital-strategy.ec.europa.eu/en/policies/contents-code-gpai