
Le fichier llms.txt est passé de proposition confidentielle à case à cocher dans les principaux plugins SEO, le plus souvent vendu comme « le robots.txt de l’IA ». En faut-il vraiment un ? En bref : la plupart des sites marketing peuvent s’en passer, mais les sites de documentation et les sites pour développeurs auraient tort de s’en priver.
Ce qu’il faut retenir
- llms.txt est un fichier Markdown placé à la racine d’un site, proposé par Jeremy Howard le 3 septembre 2024 pour guider les modèles d’IA : une suggestion, pas un standard que les moteurs se seraient engagés à suivre.
- La recherche Google l’ignore : son guide d’optimisation pour l’IA, publié en mai 2026, précise qu’en publier un n’a aucune incidence sur la visibilité ni sur le classement dans Google, et l’audit Lighthouse de Chrome le juge facultatif.
- Les mesures vont toutes dans le même sens : 408 requêtes vers le fichier sur 515 millions d’événements de robots d’IA (Limy, mai 2026) et aucune sur 33 092 passages de robots d’IA en 60 jours (SeoMix, France, avril-mai 2026).
- La règle de décision : créez-le pour une documentation d’API ou un site de développeurs, gardez-le s’il est généré automatiquement, ignorez-le sur un site vitrine, un site e-commerce ou un petit blog.
- Ce qui compte davantage se joue ailleurs : l’accès des robots (robots.txt, pare-feu, JavaScript) et un contenu que les modèles peuvent citer.
Le robots.txt est le fichier qui contrôle vraiment l'accès des robots
Contrairement à llms.txt, le robots.txt décide si les robots d’IA peuvent ou non récupérer votre site. Le vérificateur de robots d’IA gratuit indique lesquels des 34 robots d’IA votre robots.txt autorise ou bloque.
Qu’est-ce que le fichier llms.txt ?
Le fichier llms.txt est un fichier texte au format Markdown, placé à la racine d’un site, à l’adresse /llms.txt. Le développeur Jeremy Howard l’a proposé le 3 septembre 2024 pour répondre à un problème précis : un modèle d’IA dispose d’une fenêtre de contexte limitée, et un site entier, avec sa navigation, ses publicités et son JavaScript, est trop volumineux et trop encombré pour lui être fourni tel quel. Le fichier se veut une carte sélective : une courte liste de vos pages les plus importantes, dans un format qu’un modèle lit sans avoir à décortiquer toute votre mise en page.
Le format tient en quelques lignes. Un titre H1 avec le nom du site (le seul élément obligatoire), un résumé facultatif d’une ligne en citation (blockquote), puis des sections H2 qui listent vos pages clés avec une courte description. Une section « Optional » peut regrouper les liens qu’un modèle est libre de laisser de côté quand il manque de place ; depuis la révision v2 d’août 2026, ce n’est plus qu’une convention. La v2 recommande aussi de proposer une version Markdown épurée des pages dont les agents ont besoin et de la signaler par des relations de lien standard ; le fichier lui-même garde ce format minimal.
Un point à clarifier d’emblée, car la plupart des guides entretiennent la confusion : selon la spécification, llms.txt existe pour « aider les agents à utiliser un site web » et sert surtout à l’inférence plutôt qu’à l’entraînement, c’est-à-dire quand un assistant ou un agent de code lit votre site pour aider un utilisateur. Depuis sa v2 d’août 2026, la proposition affirme que les agents de code utilisent ces fichiers de façon fiable. En revanche, elle ne prétend nulle part que les moteurs de recherche vous classent mieux grâce au fichier, ni que les moteurs de recherche IA le lisent pour choisir leurs sources. Il s’agit d’une suggestion sur la façon dont les sites pourraient exposer leur contenu aux modèles, pas d’un standard formel, et aucun fournisseur de recherche IA ne s’est engagé à le lire.
Ce que dit réellement Google (les deux voix)
Une bonne part de la confusion autour de llms.txt vient du fait que Google semble dire deux choses contraires. Du côté de la recherche Google, le message est net. Sa documentation sur les fonctionnalités d’IA indique : « Vous n’avez pas besoin de créer de fichiers lisibles par un ordinateur, de fichiers textuels d’IA ni de balisage pour apparaître dans ces fonctionnalités ». Aucune optimisation spéciale n’est requise pour les Aperçus IA (AI Overviews) ou le Mode IA (AI Mode) : il suffit d’être indexé et de pouvoir s’afficher avec un extrait. Autrement dit, llms.txt ne fait rien pour votre visibilité dans la recherche IA de Google. Le guide d’optimisation pour l’IA, publié en mai 2026 avec une note sur llms.txt ajoutée le 15 juin 2026, nomme d’ailleurs le fichier : en publier un pour d’autres services qui s’en servent n’a « aucune incidence sur la visibilité ou le classement de votre site dans la recherche Google, car la recherche Google les ignore ». John Mueller, de Google, a comparé le fichier à l’ancienne balise meta keywords : une déclaration qu’un site fait sur lui-même, qu’un robot peut tout simplement ignorer, puisqu’il lui suffit de lire la page elle-même pour vérifier.
Il y a ensuite l’autre Google. Lighthouse, l’outil d’audit de Chrome, intègre depuis mai 2026 un audit llms.txt, ce qui ressemble à une caution jusqu’à ce qu’on regarde la catégorie où il se trouve. Il relève de la catégorie expérimentale « Agentic browsing » (navigation agentique), pas du SEO. L’audit échoue si le fichier renvoie une erreur serveur, si la requête n’aboutit pas ou, quand le fichier est servi, s’il n’a pas de titre H1, s’il ne contient aucun lien Markdown ou s’il fait moins de 50 caractères. Un fichier absent est marqué « Non applicable », car, selon Google, sa fourniture est « facultative pour le moment ». L’enjeu est d’aider un agent d’IA à saisir plus vite votre structure ; le classement n’entre pas en ligne de compte.
Il n’y a donc pas de contradiction : deux équipes répondent à deux questions différentes. L’équipe Search vous dit que llms.txt ne vous vaudra aucune citation. L’équipe chargée de la navigation agentique estime qu’il pourrait, un jour, aider un agent d’IA à explorer votre site plus efficacement. Ni l’une ni l’autre n’en fait un signal de classement, et toutes deux le jugent facultatif.
Un épisode de l’hiver 2025-2026 montre le peu de poids du fichier, même chez Google. En décembre 2025, une mise à jour du CMS de la documentation développeurs de Google a ajouté des fichiers llms.txt sur de nombreux sites de Google ; l’équipe Search a retiré le sien de sa propre documentation en moins d’une journée, tandis que d’autres équipes laissaient le leur en ligne. En janvier 2026, interrogé sur Bluesky pour savoir si le fichier encore visible sur ai.google.dev valait approbation, John Mueller a répondu : « pour être direct, non ».
Ça marche vraiment ? Ce que montrent les données
Laissons la théorie de côté et regardons ce qui a été mesuré. Pour l’usage qui intéresse la plupart des propriétaires de sites, être repris par la recherche IA, les résultats sont sans appel.
| L’affirmation | Ce que montrent les mesures | Source |
|---|---|---|
| Les robots de recherche IA lisent votre llms.txt | Un fichier hébergé sur Search Engine Land n’a enregistré aucune visite de GPTBot, ClaudeBot, PerplexityBot ni Google-Extended sur environ dix semaines de logs serveur (de la mi-août à la fin octobre 2025). Des études de logs plus récentes constatent le même désintérêt quasi total : 84 requêtes sur 62 100 visites de robots d’IA lors d’un test de 90 jours (février 2026), et 408 requêtes sur 515 millions d’événements de robots d’IA chez les marques suivies par Limy (mai 2026). Dans les données d’Ahrefs de mai 2026, 97 % des quelque 38 000 domaines dotés d’un llms.txt valide n’ont reçu aucune requête vers ce fichier | Semrush / OtterlyAI / Limy / Ahrefs |
| Il améliore les citations ou le trafic IA | Selon Ahrefs, « il n’y a aucune preuve que llms.txt améliore la récupération par l’IA, augmente le trafic ou renforce la précision des modèles » ; l'étude de SE Ranking de novembre 2025, sur quelque 300 000 domaines, arrive au même constat : quand SE Ranking a retiré llms.txt de son modèle de prédiction des citations, les prédictions se sont améliorées au lieu de se dégrader | Ahrefs / SE Ranking |
| Les grands fournisseurs d’IA le prennent en charge | Aucun ne s’est engagé à l’analyser ; John Mueller, de Google : aucun des services d’IA n’a dit s’en servir. Le test de Search Engine Land de janvier 2026 ne dit pas autre chose : ni OpenAI, ni Anthropic, ni Google, ni Meta | Google / Ahrefs / Search Engine Land |
| L’adoption est déjà généralisée | Sur les quelque 300 000 domaines étudiés par SE Ranking (novembre 2025), 10,13 % en avaient un, répartis presque uniformément sur le web plutôt que concentrés chez les plus gros sites ; le compteur de NerdyData, qui repère la chaîne « llms.txt » dans le code des pages, est passé de 951 domaines en juillet 2025 à 16 670 en septembre 2026 | SE Ranking ; NerdyData, via Semrush |
Ryan Law, directeur du marketing de contenu chez Ahrefs, voit à titre personnel dans llms.txt « une solution en quête de problème », et Semrush, après un test en conditions réelles, n’y voit au mieux qu'« une expérience peu coûteuse » et conseille de ne pas s’attendre à ce qu’il fasse bouger les choses pour l’instant. Le test le plus direct à ce jour est celui de Search Engine Land, qui a suivi 10 sites pendant 90 jours avant et après l’ajout du fichier (janvier 2026) : sept n’ont montré aucun changement mesurable et l’un d’eux a reculé de 19,7 %. Les deux sites qui ont gagné du trafic IA le doivent à une campagne de relations presse et à de nouveaux contenus, pas au fichier. OtterlyAI, après son propre test de logs de 90 jours, est allé plus loin : il a retiré complètement la vérification de llms.txt de son audit GEO (février 2026). En France, le test de SeoMix aboutit à la même conclusion : sur les logs de six sites, en 60 jours (avril et mai 2026), aucun des 33 092 passages de robots d’IA (2 249 URL différentes explorées) n’a demandé le fichier. Côté visibilité dans la recherche IA, les données disponibles convergent : en l’état, rien n’indique que le fichier change quoi que ce soit.
Il reste une vraie exception, et c’est ce qui empêche le fichier d’être un simple effet de mode. Les assistants de code qui chargent de la documentation dans leur contexte récupèrent et utilisent bien llms.txt ; des plateformes de documentation comme Mintlify le génèrent automatiquement pour les sites qu’elles hébergent, ce qui en fait la seule voie d’adoption étayée par la documentation des plateformes elles-mêmes plutôt que par des mesures de logs. D’où le profil de ceux qui l’ont adopté les premiers (Anthropic, Stripe, Mintlify) : presque tous des sites de documentation pour développeurs. L’erreur consiste à généraliser à partir d’eux. On cite leur adoption comme la preuve que llms.txt marche pour tout le monde, alors qu’elle montre seulement qu’il marche pour une documentation technique que des machines consomment directement.
Faut-il s’en occuper ? La règle de décision
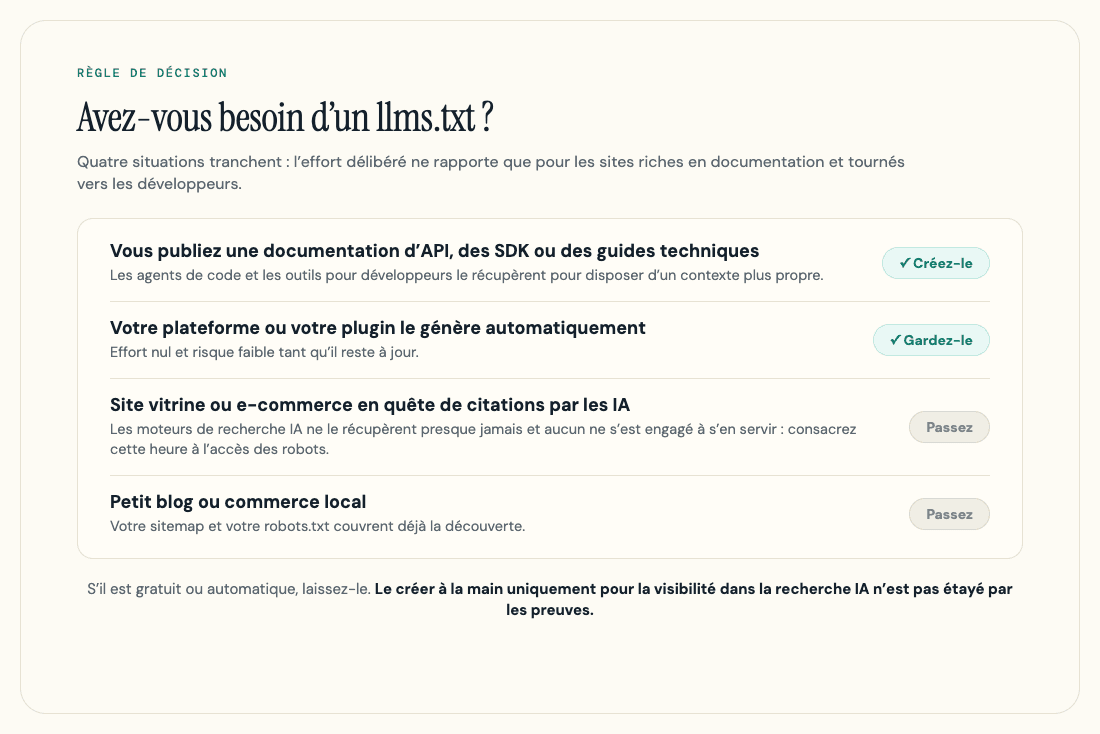
Inutile d’organiser une réunion stratégique pour cela : quatre situations suffisent à trancher.
| Votre situation | Verdict | Pourquoi |
|---|---|---|
| Vous publiez une documentation d’API, des SDK ou des guides techniques que l’on colle dans ChatGPT ou Claude | Créez-le | Les agents de code et les outils pour développeurs le récupèrent, d’après les plateformes qui le génèrent, et il leur donne un contexte plus propre sur votre produit |
| Votre plateforme ou votre plugin le génère automatiquement (GitBook, un plugin SEO ou une plateforme de documentation comme Mintlify) | Gardez-le | Effort nul et risque faible tant qu’il reste à jour, et vous êtes paré si l’adoption progresse |
| Vous gérez un site vitrine, e-commerce ou marketing et visez des citations par les IA | Passez | Aucun moteur de recherche IA n’a confirmé s’en servir et les logs ne montrent presque aucune requête vers le fichier ; mieux vaut consacrer ce temps à l’accès des robots et au contenu |
| Vous gérez un petit blog ou un site d’entreprise locale | Passez | Votre sitemap et votre robots.txt couvrent déjà la découverte pour les robots qui comptent |
Avant de trancher, ouvrez votresite.fr/llms.txt : votre plugin SEO a peut-être déjà publié le fichier. Yoast SEO (versions gratuite et Premium, depuis la 25.3) et Rank Math le génèrent dès que vous activez l’option correspondante ; chez Rank Math, le fichier reste vide tant qu’on ne l’a pas configuré, et les articles en noindex en sont exclus. SEOPress, l’extension française, le propose dans sa version PRO depuis la 9.5 (27 janvier 2026), sous forme de fichier virtuel. All in One SEO, d’après sa documentation, l’active par défaut. Un fichier généré à votre insu reste public : vérifiez ce qu’il liste.
La logique du tableau : si le fichier est gratuit ou généré automatiquement, il ne vous coûte rien, alors laissez-le. S’il fallait en construire et en maintenir un à la main dans le seul but de gagner en visibilité auprès des moteurs d’IA, les mesures plaident pour s’en abstenir. Aujourd’hui, un effort délibéré ne se justifie que pour les sites riches en documentation et tournés vers les développeurs, où des machines lisent bel et bien le fichier.
Comment créer un fichier llms.txt (dans les règles de l’art)
Si vous êtes du côté du « créez-le », la spécification est courte et le fichier se rédige en quelques minutes. Notre générateur de llms.txt gratuit s’occupe de la partie fastidieuse : collez un domaine et il construit un fichier conforme à la spécification à partir de votre propre sitemap, avec les vrais titres et les vraies descriptions, en écartant les pages qui n’ont rien à faire dans un index pour IA. Relisez ce qu’il vous donne avant de publier, car c’est la sélection qui compte.
- Commencez par un H1 avec le nom de votre site ou de votre produit. C’est le seul élément que la spécification exige.
- Ajoutez un résumé d’une ligne dans une citation (blockquote), juste en dessous, pour décrire le site.
- Regroupez vos pages clés sous des sections H2, chacune avec un lien Markdown et une courte description : par exemple une section « Documentation » qui pointe vers votre guide de démarrage, votre référence d’API et vos tutoriels.
- Ajoutez une section « Optional » à la fin, pour les liens secondaires qu’un modèle peut sauter s’il manque de place dans sa fenêtre de contexte.
- Enregistrez le fichier sous
/llms.txtà la racine de votre domaine et vérifiez qu’il s’affiche bien à l’adressevotresite.fr/llms.txt.
Gardez-le sélectif. L’objectif est de remettre à un modèle vos meilleures pages, les plus à jour : laissez de côté les pages pauvres en contenu, les doublons et les pages archivées. Un fichier à rallonge vous dessert.
Une mise au point, parce que la moitié des guides se trompent : llms-full.txt ne fait pas partie de la spécification officielle. Il s’agit d’une convention distincte, popularisée par des plateformes de documentation comme Mintlify (qui la génèrent pour les sites qu’elles hébergent) : elle regroupe toute votre documentation dans un seul gros fichier. Ce fichier peut servir à des outils spécialisés dans la documentation pour développeurs, mais il reste facultatif, il n’est pas « la suite du standard », et sur un grand site il devient trop volumineux pour être utile. Si vous en voulez un, notre générateur de llms.txt le construit en même temps que le fichier d’index, avec moins de pages, car il est beaucoup plus lourd.
Les erreurs que répètent la plupart des guides
Au-delà de la confusion autour de llms-full.txt, quelques angles morts reviennent dans la plupart des conseils sur llms.txt, et mieux vaut les connaître avant de publier.
La validation est sommaire. L’audit Lighthouse vérifie que le fichier répond sans erreur serveur et qu’il contient un H1, au moins un lien et 50 caractères, rien de plus : ni vos sections H2, ni le bon fonctionnement des liens. Notre vérificateur llms.txt gratuit comble ce manque : il contrôle la structure H1 et H2 au regard de la spécification et vérifie que chaque URL listée est accessible. Ce qu’aucun outil ne peut faire, c’est vous garantir qu’un modèle lira le fichier comme vous l’entendez, et il n’existe pas d’équivalent du rapport robots.txt de la Search Console pour llms.txt : vous publiez donc en partie à l’aveugle.
Les consignes peuvent se contredire. Si vous listez dans llms.txt une page qui est aussi en noindex ou bloquée dans le robots.txt, rien dans la spécification n’indique laquelle l’emporte, et il ne faut pas supposer qu’un agent tranche comme vous le feriez. Autre revers, moins visible : llms.txt est un fichier public. Y lister vos pages les plus précieuses revient à en offrir un plan tout prêt aux robots de scraping et à vos concurrents, autant qu’aux agents bien intentionnés.
Enfin, il vieillit. Un fichier qui n’est plus synchronisé avec votre contenu réel alimente les modèles en liens et en réponses périmés. Si vous ne pouvez pas le tenir à jour, un llms.txt obsolète est pire que pas de fichier du tout.
llms.txt, robots.txt et sitemap : trois fichiers, trois rôles
L’étiquette « le robots.txt de l’IA » revient partout, et elle induit en erreur : les trois fichiers n’ont pas du tout le même rôle.
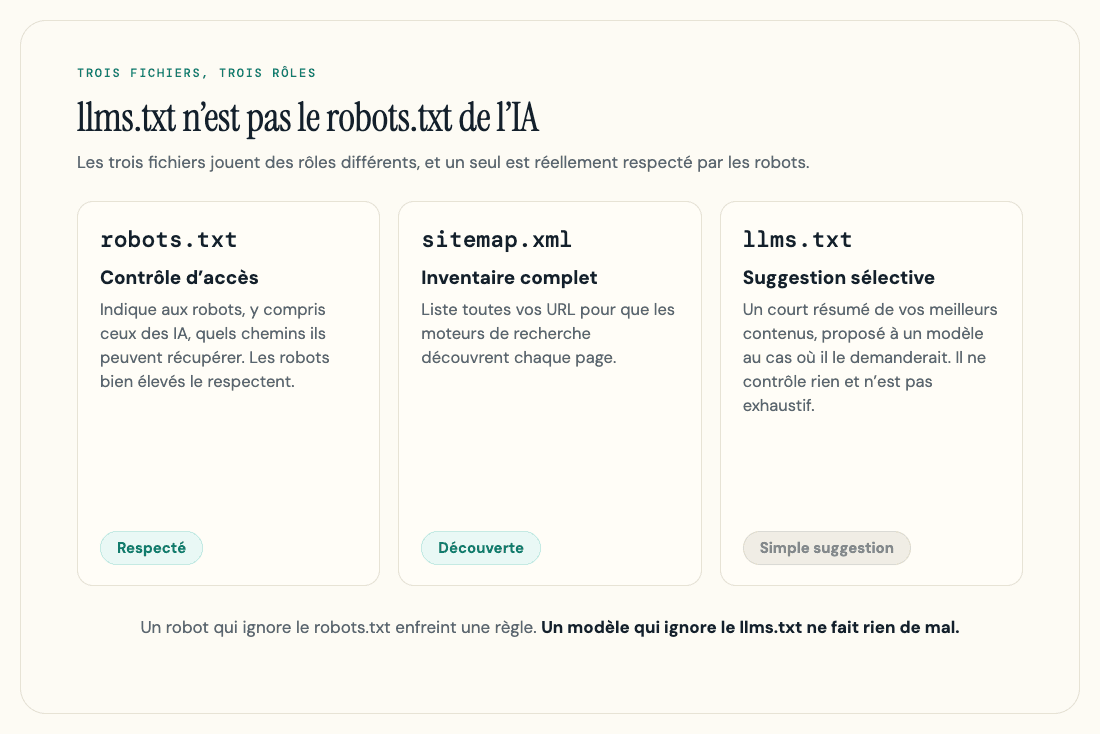
Le robots.txt est un contrôle d’accès. Il indique aux robots, y compris aux robots d’exploration d’IA, quels chemins ils peuvent récupérer, et les robots bien élevés s’y conforment : passer outre une de ses règles revient à mal se conduire. Un sitemap est un inventaire complet de vos URL, pour que les moteurs de recherche découvrent chaque page. Le llms.txt n’est ni l’un ni l’autre : il ne contrôle pas l’accès et n’est pas exhaustif ; il offre à un modèle un résumé sélectif de vos meilleurs contenus, au cas où celui-ci le demanderait.
La différence pratique qui compte : le robots.txt fait loi chez les robots respectueux, le llms.txt n’engage personne. Un robot qui ignore votre robots.txt enfreint une règle. Un modèle qui ignore votre llms.txt ne fait rien de mal, puisque le fichier n’a jamais été qu’une suggestion. C’est pourquoi il complète ces fichiers plus anciens sans remplacer ni l’un ni l’autre.
llms.txt détourne-t-il l’attention de la vraie visibilité dans les IA ?
Pour la plupart des sites, un peu. Non que le fichier soit nocif : il accapare simplement une attention qui serait mieux employée ailleurs. Les facteurs qui décident de vos citations par les moteurs d’IA n’ont rien d’exotique, et llms.txt n’en fait pas partie.
Il faut d’abord que les robots d’IA puissent atteindre vos pages et en faire le rendu. Une règle du robots.txt ou un pare-feu qui bloque GPTBot, ou un contenu qui n’apparaît qu’après un JavaScript que le robot n’exécute pas, vous écartera des réponses des IA, quelle que soit la qualité de votre llms.txt. Dans les audits de visibilité IA que nous menons, ce problème d’accès explique bien plus souvent un « on n’est pas cités » que l’absence d’un fichier. Vient ensuite le contenu : des pages claires, qui répondent d’emblée, qu’un modèle peut citer. Notre guide sur l'optimisation pour la recherche IA détaille les deux, et la question plus large de savoir si les agents peuvent utiliser votre site est traitée dans rendre son site prêt pour les agents.
Pour savoir où votre temps rapporte le plus, vérifiez d’abord l’accès, puis le contenu : ce sont les deux volets de la visibilité dans les IA qui reposent sur des preuves.
Le verdict
llms.txt n’a rien d’une lubie : la proposition répond à un vrai problème, mais pour un public restreint. Si vous publiez de la documentation pour développeurs, ou si votre plateforme génère le fichier gratuitement, en avoir un est raisonnable et ne vous coûte rien. Pour tous les autres, qui cherchent de la visibilité dans la recherche IA, les mesures en font l’élément le moins prioritaire de la liste.
Prenez-le donc pour ce qu’il est : un détail qui se règle en dix minutes, et non une stratégie. Pour gagner du terrain dans les réponses des IA, assurez-vous que les agents peuvent atteindre vos pages, en faire le rendu et les citer. Si vous ne faites qu’une chose cette semaine, testez votre domaine avec le score de préparation IA gratuit de geotoolbox et corrigez ce qu’il signale ; l'analyseur de contenu ajoute la note de citabilité page par page. Voilà où mènent les données ; llms.txt, lui, peut attendre que le standard rattrape le battage qui l’entoure.
Foire aux questions
ChatGPT, Claude ou Perplexity lisent-ils vraiment llms.txt ?
Vous pouvez y répondre pour votre propre site en cinq minutes de travail : publiez le fichier, patientez quelques semaines, puis cherchez dans vos logs serveur les requêtes vers /llms.txt par user-agent de robot. Toutes les études publiées à ce jour aboutissent au même résultat, nul ou presque, pour les robots des moteurs de recherche : l'analyse de Limy de mai 2026, sur 515 millions d’événements de robots d’IA chez les marques que la société surveille, n’a relevé que 408 requêtes vers le fichier, et Ahrefs a constaté que 97 % des quelque 38 000 domaines dotés d’un llms.txt valide n’avaient reçu aucune requête vers ce fichier en mai 2026. Ces mesures pèsent plus lourd que n’importe quelle déclaration d’un fournisseur.
Où se place exactement le fichier llms.txt ?
En général à la racine de votre domaine, comme le robots.txt : votresite.fr/llms.txt, servi en texte brut ou en Markdown avec un code 200. Il peut aussi se trouver dans un sous-répertoire, et la v2 de la proposition précise ce que cela signifie : /docs/llms.txt couvre alors tout ce qui se trouve sous /docs/. Sous WordPress, plusieurs plugins SEO l’écrivent pour vous ; sur les plateformes de documentation hébergées, il est le plus souvent généré automatiquement ; partout ailleurs, on le dépose comme fichier statique à la racine du site.
Quelle différence entre llms.txt et llms-full.txt ?
llms.txt est l’index court et sélectif défini par la spécification ; llms-full.txt verse toute la documentation dans un seul fichier. La règle de choix : un assistant de code à petite fenêtre de contexte a besoin de l’index, alors qu’un outil qui constitue une base de connaissances locale a besoin de l’export complet. Si vous n’en publiez qu’un, publiez l’index.
llms.txt a-t-il un effet sur l’indexation Google ou sur mes règles robots.txt ?
Aucune interaction, dans un sens comme dans l’autre. Googlebot indexe vos pages que le fichier existe ou non, et llms.txt ne peut pas lever un blocage du robots.txt : un robot que le robots.txt exclut ne devrait pas non plus récupérer votre llms.txt. Considérez les deux fichiers comme entièrement indépendants.
Sources
- The /llms.txt file, v2 - spécification llms.txt (Jeremy Howard, proposition de 2024, révisée en août 2026) -
llmstxt.org - llms.txt | Lighthouse - Google Chrome for Developers (l’audit de navigation agentique ; la page d’aide date de mai 2026 et retarde sur le code de l’audit) -
developer.chrome.com/docs/lighthouse/agentic-browsing/llms-txt - llms-txt.js, Lighthouse v13.5.0 (septembre 2026) - GoogleChrome sur GitHub (ce que l’audit vérifie réellement : erreurs de récupération, statut, H1, lien, longueur) -
github.com/GoogleChrome/lighthouse/blob/v13.5.0/core/audits/agentic/llms-txt.js - AI Features and your website - Google Search Central (aucun fichier spécial requis pour les fonctionnalités d’IA) -
developers.google.com/search/docs/appearance/ai-features - Google’s Guide to Optimizing for Generative AI Features on Google Search - Google Search Central (llms.txt ignoré par Google Search, mai-juin 2026) -
developers.google.com/search/docs/fundamentals/ai-optimization-guide - What Is llms.txt, and Should You Care About It? - Ahrefs (verdict et avis de John Mueller) -
ahrefs.com/blog/what-is-llms-txt - We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read - Ahrefs (étude de 137 210 domaines, données de mai 2026, publiée en juin 2026) -
ahrefs.com/blog/llmstxt-study - What is llms.txt & should you use it? - Semrush (test sur les logs serveur et données d’adoption, mis à jour en septembre 2026) -
semrush.com/blog/llms-txt - LLMs.txt: Why Brands Rely On It and Why It Doesn’t Work - SE Ranking (étude d’adoption et de corrélation avec les citations sur 300 000 domaines, novembre 2025) -
seranking.com/blog/llms-txt - Does llms.txt matter? We tracked 10 sites to find out - Search Engine Land (test avant/après sur 10 sites, janvier 2026) -
searchengineland.com/does-llms-txt-matter-467740 - llms.txt and AI Visibility: Results from OtterlyAI’s GEO Study - OtterlyAI (test de logs serveur sur 90 jours, février 2026) -
otterly.ai/blog/the-llms-txt-experiment - LLMs.txt in 2026: The Full Guide - Limy (analyse de 515 millions d’événements de robots, mai 2026) -
limy.ai/blog/llms-txt-in-2026-the-full-guide - Google Search Team Does Not Endorse LLMs.txt Files - Search Engine Roundtable (Mueller sur les propres fichiers llms.txt de Google, janvier 2026) -
seroundtable.com/google-does-not-endorse-llms-txt-40789.html - Llms.txt : le fichier inutile pour le GEO et les IA - SeoMix (test de logs sur 60 jours, avril-mai 2026, mis à jour le 16 juin 2026) -
seomix.fr/llms-txt-fichier-geo - llms.txt - Yoast SEO Features - Yoast (fonction gratuite, introduite dans Yoast SEO 25.3, juin 2025) -
yoast.com/features/llms-txt - llms.txt - Rank Math (module et réglages) -
rankmath.com/kb/llms-txt - SEOPress 9.5 - SEOPress (llms.txt en version PRO, janvier 2026) -
seopress.org/newsroom/product-news/seopress-9-5 - Edit your llms.txt file - SEOPress (fichier virtuel, réglages PRO) -
seopress.org/support/guides/edit-your-llms-txt-file - How to create an llms.txt using All in One SEO - All in One SEO (fonction activée par défaut) -
aioseo.com/docs/how-to-create-an-llms-txt-using-all-in-one-seo