
Les navigateurs agentiques sont arrivés. Comet, le mode agent de ChatGPT et, hors UE et EEE, Gemini dans Chrome ne se contentent plus de lire vos pages : ils les parcourent, remplissent des formulaires et finalisent des achats pour la personne qui le leur a demandé. Ils font partie d’une vague plus large d'agents IA nommés qui s’installent dans chaque fonction de l’entreprise. Cela transforme une question discrète en question urgente : votre site est-il agent-ready ? Pour la plupart des sites, la réponse est non, et les raisons sont précises et corrigibles.
Ce qu’il faut retenir
- Un site agent-ready, c’est un site qu’un agent IA (Comet, Gemini dans Chrome, le mode agent de ChatGPT) peut non seulement lire, mais aussi utiliser : remplir un formulaire, cliquer, payer, sans qu’un humain ne tienne la souris.
- Trois portes décident si l’agent termine sa tâche : accès (robots.txt, pare-feu, CDN), rendu (le contenu doit être présent dans le HTML, pas apparaître après coup via JavaScript) et compréhension (titres clairs, données structurées, texte exposé dans le DOM).
- Un benchmark français de mars 2026 (Converteo, 170 sites, 38 assistants notés) chiffre le fossé : aucun des assistants analysés ne permet aujourd’hui de finaliser un achat, avec un sous-score transactionnel de 25/100 contre 62/100 pour l’accessibilité.
- Les trois agents ne sont pas disponibles de la même manière en France : Comet fonctionne déjà, le mode agent de ChatGPT est disponible sur les formules payantes selon OpenAI (non vérifié directement), mais Gemini dans Chrome n’est proposé dans aucun pays de l’UE, de l’EEE ni en Suisse (vérifié le 18 septembre 2026).
- Le scan Agent Readiness gratuit de geotoolbox montre en quelques minutes ce qu’un agent voit réellement en arrivant sur votre site, et par où commencer.
Ce que « agent-ready » veut vraiment dire, et en quoi ça diffère du référencement
Pendant vingt ans, le travail consistait à faire lire une page. Un robot d’exploration récupérait le HTML, un index jugeait la page pertinente, puis un humain cliquait pour faire le reste. Un site agent-ready répond à une question plus récente : un logiciel peut-il terminer, sur votre site et sans personne pour tenir la souris, la tâche qu’un humain effectuait auparavant ? Ce basculement, du logiciel qui répond au logiciel qui agit, porte un nom : l'IA agentique.
C’est la ligne qui sépare ce sujet du référencement classique. Le référencement vous rend trouvable et citable. Un robot d’exploration IA qui récupère votre page pour construire une réponse ChatGPT se contente encore de lire. Un navigateur agentique fait l’étape suivante : il lit la page, décide quoi faire, puis clique, saisit, sélectionne et valide pour accomplir une tâche qu’un utilisateur lui a confiée. Lire est passif ; agir ne l’est pas.
Être agent-ready, c’est donc survivre à cette deuxième étape. L’agent doit atteindre vos pages, les afficher comme les verrait une machine, comprendre ce qu’elles contiennent, puis manipuler les commandes : le champ de recherche, les filtres, le formulaire de paiement. Le moindre maillon de cette chaîne qui ne fonctionne que pour un humain muni d’yeux et d’une souris est un maillon qu’un agent laisse tomber en route.
Vérifiez le premier maillon de la chaîne
Avant qu’un agent puisse agir sur votre site, un robot doit d’abord l’atteindre. L'AI Crawler Checker, gratuit, indique lesquels des 34 robots IA votre robots.txt autorise ou bloque, avec la ligne exacte à corriger.
Ce n’est donc pas une nouvelle couche de peinture posée sur l'optimisation pour les moteurs génératifs. Le GEO consiste à être la réponse. Être agent-ready consiste à rester utilisable une fois que cette réponse vous envoie un agent. Les deux se recoupent, les mêmes robots et le même chemin d’accès nourrissent les deux, mais les modes d’échec diffèrent, et le second n’est presque jamais testé.
Les navigateurs agentiques utilisent déjà votre site
Ce n’est pas une anticipation. Comet, de Perplexity, et le mode agent de ChatGPT sont des produits en service, et des internautes les pointent déjà vers de vrais sites pour rechercher, comparer et acheter.
Le trafic le confirme. Le trafic des navigateurs agentiques a augmenté de plus de 1 300 % entre janvier et août 2025, atteignant près de 4,5 millions de requêtes par mois, selon des données HUMAN Security relayées par Snowplow, avant de bondir de 131 % supplémentaires d’un mois sur l’autre entre août et septembre 2025. Et 87 % de ces visites d’agents concernent un produit, ce qui suggère une intention d’achat plutôt qu’une exploration au hasard. Cette poussée a d’abord été portée par Comet et ChatGPT Agent ; ChatGPT Atlas a brièvement rejoint Comet en tête après son lancement en octobre 2025, avant qu’OpenAI ne mette fin au navigateur autonome Atlas le 9 août 2026 et n’intègre la même capacité agentique directement dans l’application ChatGPT, touchant ainsi l’audience bien plus large de ChatGPT au lieu d’exiger un téléchargement séparé.
Autre signal, français cette fois : dans une étude publiée le 17 septembre 2026, KPMG et la Fevad, la fédération française du e-commerce, constatent, sur un marché qui a pesé 196,4 milliards d’euros et 3,2 milliards de transactions en 2025 (chiffre d’affaires en hausse de 7 %), que « le site marchand ne disparaît pas, mais il perd son monopole sur la découverte, la comparaison et une partie de la conversion ». 31 % des acheteurs en ligne français utilisent déjà l’IA générative dans leur parcours d’achat, une proportion qui grimpe à 73 % chez les utilisateurs intensifs d’IA, et l’étude projette que près d’un Français sur deux pourrait recourir au commerce agentique d’ici 2030.
Le piège, c’est que ces agents ne voient pas tous votre site de la même façon. Comet et Gemini dans Chrome reposent sur Chromium, donc ils exécutent votre JavaScript et vont jusqu’à raisonner sur une capture d’écran de la page rendue ; le mode agent de ChatGPT, désormais une extension ou un panneau latéral dans Chrome plutôt qu’un navigateur autonome, hérite du même rendu lorsqu’il tourne dans Chrome. Mais beaucoup des robots qui comptent le plus pour votre visibilité, les robots de réponse derrière les citations ChatGPT et Perplexity, n’exécutent aucun JavaScript et lisent votre HTML brut. Un bouton évident pour un agent qui lit une capture d’écran peut être invisible pour un agent qui ne lit que du texte, et un contenu qui n’apparaît qu’après l’exécution d’un script n’existe tout simplement pas pour les robots qui ignorent le JavaScript.
Une précision qui change tout pour un lecteur français : ces trois agents ne sont pas disponibles de la même façon ici. Comet, de Perplexity, se télécharge librement depuis la France. Selon la documentation d’OpenAI, le mode agent de ChatGPT est également disponible en France, sur les formules payantes, mais nous n’avons pas pu le vérifier directement sur un compte français. Gemini dans Chrome, en revanche, n’est proposé dans aucun pays de l’Union européenne : la liste officielle des régions compatibles publiée par Google ne mentionne ni la France, ni aucun autre État membre de l’UE ou de l’EEE, ni la Suisse, alors que le Royaume-Uni et les États-Unis y figurent (vérifié le 18 septembre 2026). Son mode agentique « auto browse » est par ailleurs triplement restreint : réservé aux États-Unis, à un appareil configuré en anglais et aux abonnés Google AI Pro ou Ultra.
Cela ne vous dispense en rien du travail décrit ici. Votre site reste accessible depuis les États-Unis et le Royaume-Uni, où Gemini dans Chrome est bel et bien actif, et Comet opère déjà depuis la France, tout comme le mode agent de ChatGPT selon OpenAI. Un tunnel de commande qui bloque un agent le bloque pour un client américain comme pour un client français : la seule différence aujourd’hui, c’est la provenance du trafic, et l’historique des déploiements de Google dans l’EEE suggère un décalage, pas une absence définitive.
Ce qui bloque vraiment un agent
La plupart des échecs d’agent n’ont rien d’exotique. Ce sont les mêmes schémas qui ont toujours fait trébucher l’automatisation et les outils d’accessibilité, exposés désormais à un public bien plus large. Voici ceux qui vous coûtent une tâche non terminée.
| Ce qui bloque | Pourquoi l’agent s’arrête | Le plus touché |
|---|---|---|
| Contenu généré uniquement en JavaScript (SPA) | Les robots de réponse et de nombreux agents n’exécutent pas le JavaScript, donc un prix, un bouton ou une page entière construits par un script se présentent vides ; même les agents qui exécutent le JS ratent le contenu qui charge trop tard | Sites React/Vue/Angular, flux à défilement infini |
| Menus au survol ou à révélation par clic | Un agent ne déplace pas de souris pour survoler ; une navigation qui ne s’ouvre qu’au survol ne s’ouvre jamais | Méga-menus, navigation déroulante |
| Connexion, 2FA et parcours OAuth | Un agent ne peut ni lire un code SMS ni passer une vérification biométrique, la tâche s’arrête à cette porte | Espaces comptes, portails B2B, panier sauvegardé |
| CAPTCHA et détection de robots | Les dispositifs conçus pour arrêter l’automatisation arrêtent aussi l’agent légitime, sans moyen de les distinguer | Paiement, inscription, formulaires de contact |
| Sélecteurs de magasin et fenêtres de variantes | Une sélection obligatoire en pop-up au milieu du parcours bloque le chemin que l’agent doit suivre | Fiches produit e-commerce, catalogues géolocalisés |
| Contenu caché dans des onglets ou accordéons | Les caractéristiques absentes du DOM initial passent facilement inaperçues ; l’agent répond avec ce qu’il peut voir | Fiches techniques, FAQ, grilles tarifaires |
| Cibles de clic minuscules ou masquées | Les agents basés sur la vision filtrent les éléments de moins de 8 pixels carrés environ, ou couverts par des superpositions transparentes | Contrôles en icône seule, boutons couverts par la bannière cookies |
D’après notre expérience à auditer des sites pour la visibilité IA, le blocage le plus courant n’est pas un cas particulier retors. C’est un prix, un bouton d’ajout au panier ou un paragraphe clé qui n’existe qu’après l’exécution du JavaScript. La page a l’air parfaite dans votre navigateur et arrive quasiment vide pour la plupart des robots d’IA et des robots de réponse derrière les citations IA. Le test gratuit le plus rapide : chargez la page avec le JavaScript désactivé et regardez ce qui survit. Pour une version notée, l'analyseur de contenu récupère la page comme le ferait un robot et compare les versions avec et sans JavaScript.
Un benchmark français publié en mars 2026 par Converteo chiffre précisément ce fossé. Sur 170 sites e-commerce français audités, 22 % seulement disposent d’un assistant IA, et parmi les 38 assistants notés, la moyenne de maturité plafonne à 46 sur 100, et aucun des assistants analysés ne permet aujourd’hui de finaliser un achat : le sous-score transactionnel atteint 25/100, contre 62/100 pour la simple accessibilité. Le constat porte sur les assistants que les marchands déploient eux-mêmes sur leur propre site, pas sur les navigateurs agentiques de leurs clients comme Comet ou ChatGPT ; il n’en dit pas moins quelque chose d’utile ici : même quand c’est le marchand qui construit l’assistant, l’étape transactionnelle reste celle que personne n’a encore vraiment conçue pour une machine.
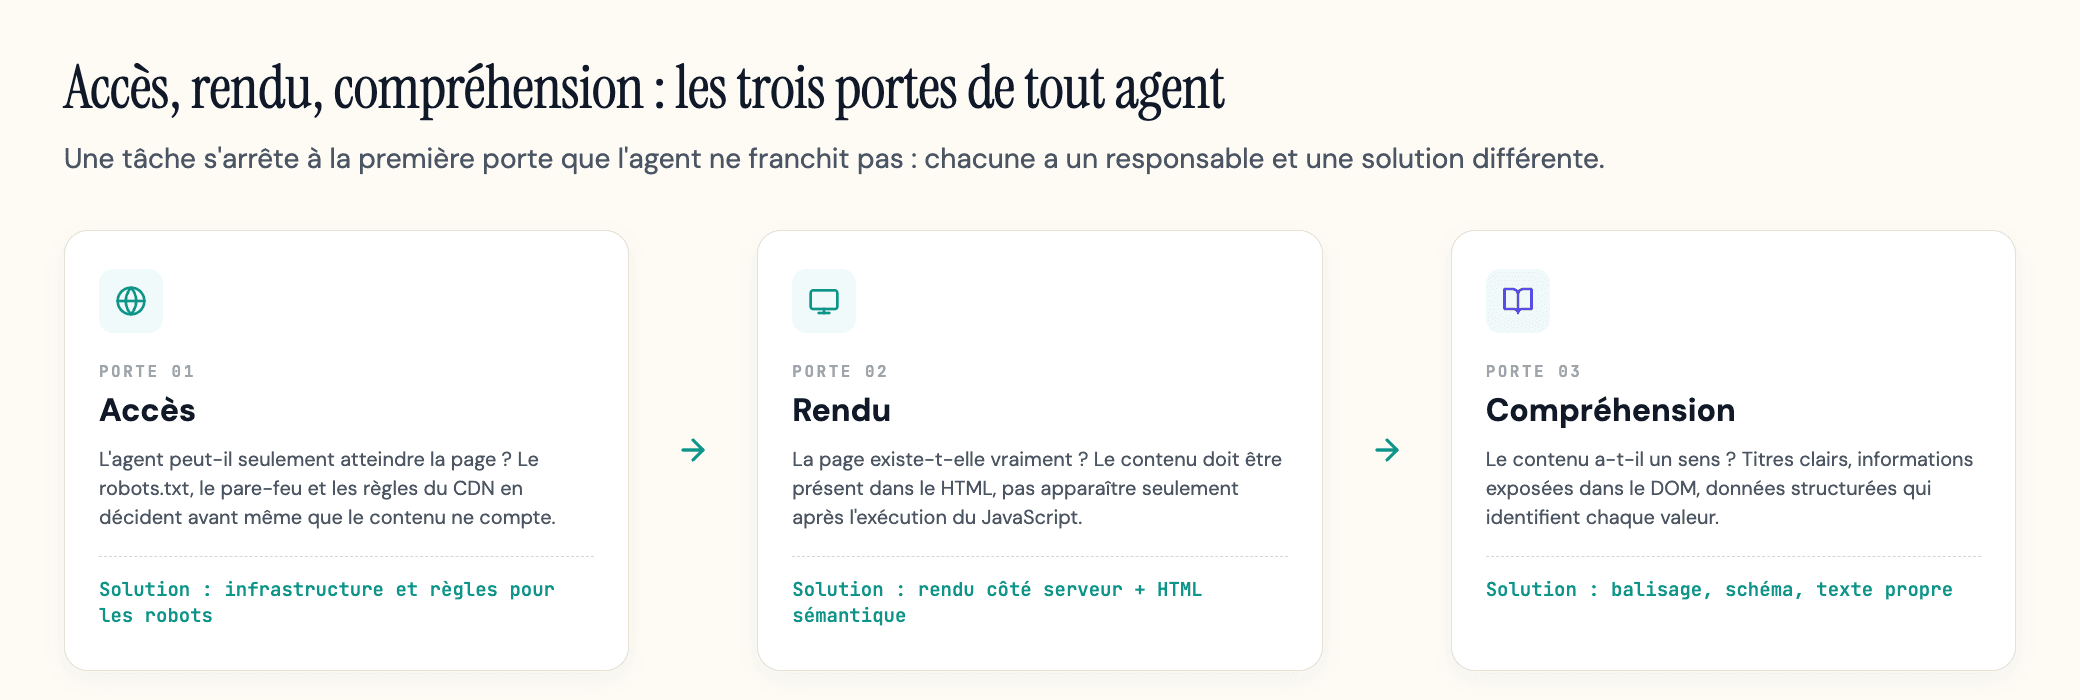
Chacun de ces blocages se loge dans l’une des trois portes, et il est utile d’y penser en ces termes, car chaque porte a un responsable et une solution différents.
Accès : l’agent peut-il seulement entrer ?
L’accès, c’est la question de savoir si l’agent peut atteindre la page. C’est votre robots.txt, votre pare-feu et vos règles de CDN. Bloquez le mauvais robot, ou laissez une règle de sécurité soumettre tout trafic non-navigateur à une vérification, et l’agent ne voit jamais rien. L’accès est une décision d’infrastructure, et c’est celle que les propriétaires de site ratent le plus souvent par accident.
Rendu : la page est-elle vraiment là ?
Le rendu, c’est la question de savoir si la page est réellement présente une fois que l’agent arrive. Un agent textuel a besoin du contenu dans le HTML, pas assemblé plus tard par un script. Un agent basé sur la vision a besoin d’une mise en page stable qu’il peut cartographier, ce qui renvoie aux recommandations de Google sur l'arbre d’accessibilité, la même carte lisible par machine qu’utilisent les lecteurs d’écran. Le HTML sémantique fait l’essentiel du travail ici : un vrai <button> ou <a> dit à un agent ce qu’un élément fait, tandis qu’un <div> cliquable ne lui dit rien.
Compréhension : peut-il donner un sens à la page ?
La compréhension, c’est la question de savoir si le contenu signifie quelque chose une fois rendu. Des titres clairs, des prix et des caractéristiques exposés dans le DOM plutôt qu’enfouis dans un onglet, et des données structurées qui identifient ce qu’est chaque élément. C’est aussi là qu’une version markdown de la page et un fichier llms.txt aident, en donnant à l’agent du texte propre au lieu de lui faire analyser une mise en page.
Accès et rendu relèvent surtout de l’Agent Readiness, des aspects que l’on vérifie au niveau du site. La compréhension, c’est là où citabilité et utilisabilité se rejoignent. Réunissez les trois et un agent peut vous trouver, vous voir et agir. Ratez-en une, et la tâche meurt à cette porte.
Faut-il bloquer ou autoriser les agents IA ?
La réponse honnête, c’est que « bloquer » et « autoriser » sont deux notions trop grossières. La vraie question, c’est quels agents, pour quelle tâche.
La distinction entre entraînement et citation est couverte dans notre guide des robots d’exploration IA : bloquer un robot d’entraînement comme GPTBot ne fait que vous retirer de l’entraînement, tandis que bloquer les robots de recherche et de citation vous rend impossible à citer. Les navigateurs agentiques ajoutent un troisième cas : un agent qui récupère votre page parce qu’une vraie personne lui a demandé d’acheter quelque chose. Le bloquer, c’est refouler un client qui s’est présenté carte en main. Reste la question plus large de savoir si ces agents recommanderont votre marque et achèteront chez vous, tout simplement.
La plupart des sites n’ont pas fait ces choix exprès. Un scan de 200 000 domaines par Cloudflare a constaté que 78 % ont un robots.txt, mais que la quasi-totalité sont écrits pour les moteurs de recherche, et que 4 % seulement déclarent une préférence spécifique pour l’IA. Les leviers existent ; presque personne ne les a réglés pour ce cas de figure.
Depuis le 15 septembre 2026, Cloudflare distingue trois usages du même robot : recherche, entraînement et agent. Bonne nouvelle pour la porte « accès » décrite plus haut : un robot « accountable » (une catégorie qui inclut les grands robots comme ceux de Google) peut désormais se voir interdire l’entraînement sans perdre le droit d’indexer pour la recherche, via un nouveau réglage « Disallow AI Training » qui remplace l’ancien blocage total, plus grossier, que les clients existants utilisaient jusqu’ici. Seul l’usage par un agent sur une page publicitaire reste, lui, un vrai blocage dans le préréglage proposé aux nouveaux domaines monétisés par la publicité. Comme Cloudflare équipe une bonne partie de l’hébergement e-commerce et PME français, le réglage n’a rien de théorique : mieux vaut savoir lequel de ces trois s’applique à votre domaine avant de bloquer l’entraînement à l’aveugle et de perdre, par la même occasion, du trafic d’agents d’achat que vous vouliez laisser passer.
Cela illustre le paradoxe plus large : votre dispositif de sécurité ne sait pas distinguer un robot frauduleux de l’agent légitime qui agit pour votre client. Vous ne réglez pas ça en désactivant la protection. La réponse qui émerge consiste à laisser les bons agents prouver leur identité : des standards comme Web Bot Auth font signer leurs requêtes aux agents, pour que vous puissiez les mettre en liste blanche tout en continuant à soumettre l’automatisation anonyme à un contrôle. C’est encore tôt, mais la direction est claire : l’identité plutôt que le blocage général.
Pour l’instant, le réglage par défaut reste le même qu’avant : bloquez l’entraînement si vous le souhaitez, gardez les robots de recherche et de citation accessibles, et ne laissez pas une règle de sécurité générale murer sans le vouloir les agents que vos propres clients vous envoient.
Comment rendre votre site agent-ready
Rien de tout cela n’exige de reconstruire votre site. C’est une séquence de corrections, à peu près dans l’ordre de leur impact.
-
Rendez votre contenu critique côté serveur. Si le prix, le bouton d’achat ou le texte essentiel n’apparaissent qu’après l’exécution du JavaScript, faites-les passer dans le HTML livré au premier chargement. Cette seule correction règle le blocage le plus courant. Testez-la en affichant la page avec JavaScript désactivé, ou avec un contrôle de rendu, et confirmez que l’essentiel est toujours là.
-
Utilisez du HTML sémantique et une mise en page stable. De vrais éléments
<button>et<a>, des labels liés aux champs, des titres dans l’ordre. Gardez la mise en page stable et évitez les superpositions transparentes qui couvrent des commandes actives. C’est le même travail qui aide les lecteurs d’écran, et il rend l’arbre d’accessibilité digne de confiance pour un agent. -
Exposez les faits dans le DOM. Sortez les prix, caractéristiques, disponibilités et détails clés des états au survol et des onglets pour les placer dans la page rendue. Ajoutez des données structurées pour que chaque valeur soit identifiée pour ce qu’elle est.
-
Réglez votre robots.txt exprès. Décidez quels robots font quel travail, et utilisez les Content Signals pour distinguer l’entraînement de l’inférence plutôt que de tout bloquer avec une seule règle générale.
-
Proposez une version texte propre. Un rendu markdown des pages importantes et une liste de lecture llms.txt donnent aux agents un accès direct aux mêmes faits, en texte brut. Cloudflare a mesuré jusqu’à 80 % de tokens en moins lorsque le serveur renvoie une version markdown de la page. Dans un test distinct, un agent dirigé vers la documentation de Cloudflare, conçue pour les agents, a consommé 31 % de tokens en moins et atteint la bonne réponse 66 % plus vite que sur un site moyen non optimisé. Considérez llms.txt comme de la plomberie utile pour les agents, pas comme un signal de classement, parce que ça n’en est pas un : Lighthouse 13.3 vient certes de l’intégrer à ses audits Agentic Browsing (mai 2026), et le fichier y est noté plutôt que simplement récupéré, mais cela reste une note de « bonne pratique agent », jamais un facteur de référencement.
-
Ne piégez pas les agents sur des parcours publics. Réservez CAPTCHA et connexion à ce qui a vraiment besoin d’être protégé. Si un produit ou un article public se retrouve derrière un défi, un agent s’arrête là.
-
Donnez un chemin de secours aux agents. Quand un parcours a vraiment besoin de JavaScript ou d’authentification, fournissez une voie statique ou API vers la même information, pour qu’un agent incapable de finir la version interactive puisse au moins lire le résultat.
L’injection de prompt : le risque que les propriétaires de site oublient
Il y a un angle sécurité que la plupart des check-lists agent-ready sautent, et il joue dans les deux sens.
Un navigateur agentique lit le contenu de la page pour décider quoi faire. Si un attaquant parvient à placer du texte sur une page que l’agent lit, il peut essayer d’y glisser des instructions : du texte caché qui dit à l’agent d’ignorer sa tâche, de divulguer des données, ou d’aller ailleurs. Ce n’est pas théorique : des chercheurs en sécurité de Guardio ont piégé Comet, le navigateur de Perplexity, dans une arnaque au phishing en moins de quatre minutes en lui soumettant du contenu conçu pour le tromper, et les équipes de sécurité d'OpenAI écrivent elles-mêmes que l’injection de prompt ne sera probablement jamais totalement « résolue ». Palo Alto Networks considère ces instructions indirectes comme un risque central du web agentique.
Pour un propriétaire de site, l’exposition réelle est étroite mais mérite d’être nommée. L’agent doit effectivement lire du texte contrôlé par l’attaquant, donc les surfaces à surveiller sont celles où le contenu d’autrui apparaît sur vos pages : avis clients, commentaires, messages de forum, et tout widget tiers que vous affichez. La correction, c’est la même hygiène que vous devez déjà à ces champs : assainissez et encadrez le contenu généré par les utilisateurs, et n’injectez jamais aveuglément du texte tiers dans des pages sur lesquelles un agent va agir.
C’est un risque émergent, pas une alerte rouge pour une simple boutique en ligne ou un site vitrine. Mais si vos pages portent du contenu que vous n’écrivez pas vous-même, il mérite sa place sur votre liste.
Le paiement mérite la même vigilance, pour une raison commerciale cette fois. 69 % des détaillants déclarent avoir subi une fraude facilitée par l’IA au cours de l’année écoulée, et 3 % seulement s’estiment bien préparés (Deloitte, décembre 2025). Visa a introduit en octobre 2025 le Trusted Agent Protocol, un cadre ouvert destiné précisément à distinguer un agent d’achat authentifié d’un robot frauduleux avant le paiement ; Akamai s’y est associé en décembre 2025 pour y apporter son expertise de la détection comportementale. Cette initiative répond au même dilemme que celui des CAPTCHA. Côté français, la même étude Converteo mesure que la confiance dans l’assistance IA à l’achat passe de 47 % avant l’achat à 30 % au moment de payer, et en Europe l’authentification forte imposée par la DSP2, mise en œuvre le plus souvent via 3-D Secure, ajoute une friction spécifique au paiement par agent, indépendante des CAPTCHA.
Pour la vue d’ensemble, avec cinq incidents réels déjà divulgués (pas des démonstrations en laboratoire) et la façon dont le même mécanisme se joue au-delà des seuls navigateurs agentiques, voir les risques de sécurité des agents IA.
Comment savoir si votre site est vraiment agent-ready
Voici la partie délicate. Vous ne pouvez rien sentir de tout cela depuis votre propre navigateur, parce que votre navigateur exécute le JavaScript, conserve votre connexion et affiche chaque mise en page parfaitement. L’expérience de l’agent est invisible depuis votre poste de travail, et vos statistiques ne combleront pas cet écart. Attention à ne pas confondre deux choses. GA4 sait désormais étiqueter le trafic envoyé par un assistant IA : le canal « Assistant IA » regroupe les visites arrivant depuis ChatGPT, Gemini, DeepSeek, Copilot ou Grok, les AI Overviews et le Mode IA de Google en étant exclus. Ce qu’il ne sait toujours pas faire, c’est distinguer une session pilotée par un agent d’une session humaine : un navigateur agentique se présente avec le user-agent Chrome standard et hérite de l’empreinte de son utilisateur. Le parcours d’achat qui échoue silencieusement pour un agent ne remontera donc dans aucun rapport.
Il faut donc regarder le site comme le fait un agent, délibérément. Deux contrôles couvrent les trois premières portes ; aucun scanner à ce jour, y compris le nôtre, ne simule un agent qui va au bout de votre parcours de paiement, testez donc ce flux vous-même, JavaScript désactivé.
Un scan au niveau du site répond aux questions d’accès et de rendu sur tout votre domaine. Le scan Agent Readiness de geotoolbox fait cela gratuitement à partir d’une URL racine : il teste l’accès réel pour les principaux robots d’IA et capture ce qu’un agent sans interface voit vraiment, pour que l’écart entre votre navigateur qui affiche tout parfaitement et la vue d’un agent cesse d’être invisible.
Un contrôle au niveau de la page répond aux mêmes questions pour une URL précise et indique aussi si la page est citable une fois qu’un agent y entre. L'analyseur de contenu note une page unique sur exactement cela, le chemin d’accès et le contenu ensemble.
Entre les deux, vous obtenez ce que la check-list seule ne peut pas donner : une preuve. Pas « nous avons ajouté llms.txt », mais « un agent peut désormais atteindre, rendre et lire cette page », avec un avant et un après à montrer à un développeur.
Google propose désormais aussi un contrôle maison. Lighthouse 13.3 (7 mai 2026) a ajouté une catégorie Agentic Browsing à ses audits par défaut, une catégorie que Google qualifie lui-même encore d'« en cours de développement et susceptible d’évoluer », et cela s’est concrétisé depuis : Chrome 150 (sorti le 30 juin 2026) l’inclut sous forme de case à cocher optionnelle dans le panneau Lighthouse des DevTools, et PageSpeed Insights la note désormais aussi. Elle applique des contrôles déterministes sur quatre signaux : l’arbre d’accessibilité, la stabilité de la mise en page, une récupération optionnelle du llms.txt, et WebMCP, une API de navigateur naissante qui emprunte au modèle d’exposition d’outils de MCP pour laisser une page déclarer des actions qu’un agent peut appeler directement. Le résultat est un ratio de réussite plutôt qu’une note sur 100, et c’est un plancher, pas une simulation d’agent, mais que Google évalue l’agent-readiness dans son outillage par défaut indique clairement où cela se dirige.
Agent-ready, le nouveau prérequis
Le travail qui rend votre site utilisable par un agent est le même travail qui le rend lisible par un robot de citation. La page qui s’affiche proprement pour Comet est celle que ChatGPT peut citer. Les règles de robots qui laissent passer un agent sont les mêmes qui vous maintiennent dans les réponses de Perplexity. Accès, rendu, compréhension : un seul chemin d’accès nourrit à la fois la façon dont la recherche IA vous cite et la capacité d’un agent à agir en votre nom.
Le trafic d’agent reste une petite part du total pour la plupart des sites, mais la courbe dit qu’il cessera d’être optionnel d’abord pour l’e-commerce. Le travail est bon marché, il sert en même temps l’hygiène de citation, et les sites qui le font gagneront discrètement les tâches que ceux qui ne le font pas laissent filer.
Le premier geste le moins cher, c’est d’arrêter de deviner. Passez votre page d’accueil et une page produit ou service clé dans le scan Agent Readiness de geotoolbox (gratuit avec un compte) et voyez ce qu’un agent obtient réellement en arrivant. La plupart des propriétaires de site trouvent une ou deux corrections qui comptent bien plus que le reste, et vous ne pouvez pas prioriser ce que vous n’avez jamais vu.
Foire aux questions
Les agents IA exécutent-ils le JavaScript, ou mon site React leur est-il invisible ?
Sachez quelle classe vous servez : les navigateurs agentiques basés sur Chromium (Comet, testable librement depuis la France, et Gemini dans Chrome, actif aux États-Unis et au Royaume-Uni mais pas dans l’UE ni l’EEE) exécutent le JavaScript et lisent même des captures d’écran ; le mode agent de ChatGPT, désormais une extension ou un panneau Chrome plutôt qu’un navigateur autonome, en fait autant, et serait lui aussi accessible en France sur les formules payantes selon OpenAI. À l’inverse, les robots de réponse derrière les citations (OAI-SearchBot, PerplexityBot et leurs équivalents) ne lisent que le HTML brut. Un site React convient au premier groupe et reste invisible pour le second, sauf s’il est généré côté serveur.
Cloudflare ou un CAPTCHA vont-ils bloquer les agents IA qui achètent sur mon site ?
Vérifiez vos propres journaux avant de deviner : filtrez sur les user-agents identifiables (les robots de citation, pas les navigateurs agentiques en session, qui se présentent comme un Chrome ordinaire) et repérez les 403 et pages de vérification sur les parcours produit et paiement. Si vous en trouvez, ciblez la règle par chemin plutôt que de la supprimer entièrement ; une vérification sur /compte ou /admin ne vous coûte rien, une vérification sur une fiche produit publique vous coûte des achats délégués.
Faut-il bloquer les agents IA, ou est-ce que je deviendrai invisible ?
La décision se prend par classe de robot, et le vrai cas nouveau, c’est le trafic agentique : contrairement aux robots d’entraînement, une session de navigateur agentique se termine souvent par une transaction, donc la bloquer a un coût direct sur le chiffre d’affaires plutôt qu’un simple coût de visibilité. Auditez quelles classes vos règles actuelles bloquent avant de décider quoi que ce soit.
Google Analytics suit-il le trafic des agents IA ?
GA4 sait étiqueter le trafic envoyé par un assistant IA via son canal Assistant IA, mais il ne peut toujours pas distinguer une session pilotée par un agent d’une session humaine, parce qu’un agent dans le navigateur hérite de l’empreinte de son utilisateur. Les solutions de contournement qui existent aujourd’hui : l’analyse des journaux serveur par chaîne user-agent, une dimension personnalisée calée sur les user-agents connus des agents, et la surveillance des sessions à la vitesse d’interaction impossible pour un humain. Aucune n’est complète, ce qui explique pourquoi les contrôles au niveau des journaux battent les tableaux de bord analytics sur ce terrain.
llms.txt vaut-il le coup si Google dit que ça n’affecte pas le classement ?
Oui, mais pour la bonne raison. llms.txt n’est ni un signal de classement ni un signal de citation IA, et il ne faut pas le vendre comme tel. Il vient malgré tout d’entrer dans l’outillage de Google : les audits Agentic Browsing de Lighthouse 13.3 comprennent un contrôle llms.txt (mai 2026), et celui-ci note le fichier au lieu de se contenter de le récupérer. Les sites dépourvus de llms.txt sont marqués « non applicable », mais un fichier servi et mal formé échoue franchement : l’audit attend un fichier Markdown comportant au moins un titre H1, au moins un lien, et plus de cinquante caractères. Cela résume bien son poids actuel : facultatif, mais noté dès lors que vous le mettez en place. Notre analyse de l’intérêt de llms.txt couvre le groupe restreint à qui ça sert vraiment et la règle de décision pour tous les autres.
Le paiement agentique est-il réel aujourd’hui, ou juste un effet de mode ?
Réel, et la couche protocole est désormais en place : l’Agentic Commerce Protocol, un standard ouvert d’OpenAI et Stripe, sert déjà de liaison entre marchands et utilisateurs de ChatGPT, et l’Universal Commerce Protocol, codéveloppé par Google, Shopify, Amazon, Walmart et Stripe entre autres, couvre la recherche catalogue, la construction du panier, la liaison d’identité, le paiement et la gestion des commandes. Un rail distinct natif crypto, x402, règle les paiements d’agents en stablecoins par HTTP. Mais ces rails ne fonctionnent que là où un marchand les a intégrés ; partout ailleurs, un agent achète via votre parcours de paiement humain habituel. C’est exactement pour ça que les corrections décrites ici comptent encore.
Sources
- Introducing the Agent Readiness score - Cloudflare (adoption du robots.txt et des préférences IA, gains de tokens et de vitesse mesurés) -
blog.cloudflare.com/agent-readiness - Build agent-friendly websites - Google web.dev (arbre d’accessibilité, HTML sémantique, taille des éléments interactifs) -
web.dev/articles/ai-agent-site-ux - Lighthouse agentic browsing scoring - Chrome for Developers (quatre contrôles déterministes d’agent-readiness, notation en ratio) -
developer.chrome.com/docs/lighthouse/agentic-browsing/scoring - Lighthouse v13.3.0 release notes - GoogleChrome sur GitHub (Agentic Browsing ajoutée à la config par défaut, 7 mai 2026) -
github.com/GoogleChrome/lighthouse/releases/tag/v13.3.0 - What’s new in DevTools (Chrome 150) - Chrome for Developers (case à cocher Agentic Browsing, désactivée par défaut, 30 juin 2026) -
developer.chrome.com/blog/new-in-devtools-150 - What Is an Agentic Browser? - Snowplow (croissance du trafic d’agents, intention produit, données HUMAN Security) -
snowplow.io/blog/what-is-an-agentic-browser - Agentic Browsing Is Here - Snowplow (angle mort analytics, GA4 ne distingue pas les agents) -
snowplow.io/blog/agentic-browsing-is-here - What Are Agentic Browsers? - Palo Alto Networks (injection de prompt, automatisation sur-privilégiée) -
paloaltonetworks.com/cyberpedia/what-are-agentic-browsers - Researchers Trick Perplexity’s Comet AI Browser Into a Phishing Scam - The Hacker News (exemple réel d’injection de prompt) -
thehackernews.com/2026/03/researchers-trick-perplexitys-comet-ai.html - Evolving Atlas into ChatGPT for browser-based agentic work - OpenAI Help Center (arrêt d’Atlas le 9 août 2026, capacité agentique intégrée à l’app ChatGPT et à une extension Chrome) -
help.openai.com/en/articles/20001371-evolving-atlas-into-chatgpt-for-browser-based-agentic-work - E-commerce : les agents IA rebattent les cartes du partage de la valeur - KPMG et la Fevad (étude française, 17 septembre 2026) -
fevad.com/e-commerce-les-agents-ia-rebattent-les-cartes-du-partage-de-la-valeur - Benchmark des agents IA e-commerce - Converteo (170 sites français audités, mars 2026) -
comarketing-news.fr/e-commerce-les-sites-francais-ne-sont-pas-prets-pour-le-tout-ia - Agentic Commerce Protocol - OpenAI et Stripe (standard ouvert pour le paiement agent-marchand) -
agenticcommerce.dev - Universal Commerce Protocol - codéveloppeurs UCP dont Google, Shopify, Amazon, Walmart, Stripe -
ucp.dev - Accountable, mixed-use AI crawlers - Cloudflare (le mécanisme « Disallow AI Training » du 15 septembre 2026) -
blog.cloudflare.com/accountable-mixed-use-ai-crawlers - Content independence day: AI options for every site - Cloudflare (annonce de juillet 2026, catégories Search/Training/Agent) -
blog.cloudflare.com/content-independence-day-ai-options - Only 3% of retailers feel well prepared to address AI-enabled fraud risks - Deloitte Canada (décembre 2025) -
deloitte.com/ca/en/Industries/consumer/perspectives/agentic-ai-fraud-retail