
Quelle est la meilleure IA ? Tout dépend de l’usage, et les classements ne désignent plus un seul gagnant. Au 8 novembre 2026, Claude Opus 5.5 domine les classements de code, Gemini 4 Argon est en tête d’Arena et du classement d’agents de Mercor parmi les modèles accessibles, et GPT-6.1 Sol offre le meilleur rapport qualité-prix via l’API. Gemini 4 Carbon arrivait en tête de 3 classements au 8 novembre, mais Google le réserve à un groupe restreint de spécialistes de la cyberdéfense. Le 9 novembre 2026, Artificial Analysis a placé Claude Fable 5.2 en tête de son indice d’intelligence : les scores de l’indice d’intelligence des tableaux ci-dessous datent du 8 novembre.
Ces classements vieillissent en quelques semaines : chaque tableau ci-dessous indique sa date de relevé.
Ce qu’il faut retenir
- Au 8 novembre 2026, il n’existe pas une meilleure IA mais une par usage : Claude Opus 5.5 pour le code et le travail intellectuel, Gemini 4 Argon pour les scores sur Arena et dans les classements d’agents parmi les modèles accessibles, GPT-6.1 Sol pour le coût par tâche.
- Gemini 4 Carbon était premier, au 8 novembre, sur Arena, sur Artificial Analysis et dans le classement d’agents de Mercor, mais Google le réserve à un groupe restreint de spécialistes de la cyberdéfense, sans date d’ouverture au public.
- Le coût par tâche importe davantage que le prix du token : GPT-6.1 Sol et Claude Sonnet 5.5 ont le même prix catalogue et le même score de 55 sur Artificial Analysis, mais Sol coûte 1,27 $ par tâche contre 10,02 $ pour Sonnet.
- En France, les premiers abonnements payants tournent autour de 20 € par mois : ChatGPT Plus à 23 €, Google AI Pro à 21,99 €, Claude Pro à 18 € HT et Vibe Pro de Mistral à 17,99 € TTC (relevé du 8 novembre 2026).
- Si vous traitez des données de clients, la CNIL recommande de réserver les offres grand public aux usages non confidentiels : vérifiez les conditions de données avant de choisir un modèle.
La réponse courte : la meilleure IA selon l’usage
Choisissez selon la tâche plutôt que selon la marque. Ces choix s’appuient sur les classements en direct et les pages de benchmark détaillés plus bas.
| Usage | Premier choix | Deuxième choix | Pourquoi |
|---|---|---|---|
| Code agentique | Claude Opus 5.5 | Claude Sonnet 5.5 | Premier du classement officiel Terminal-Bench (65,8 % après la réévaluation du 9 novembre) et d’APEX-SWE chez Mercor (67,6 %) ; Sonnet 5.5 est deuxième dans les deux cas (63,9 % et 66,4 %) |
| Travail intellectuel et agents | Claude Opus 5.5 | Gemini 4 Argon | Devance Argon sur Artificial Analysis (59 contre 50) et arrive en tête de GDPval-AA (1866, à égalité avec Kimi K3.1 Pro, 1858, à la marge d’erreur près) ; Argon devance Opus 5.5 sur APEX-Agents chez Mercor (82,4 % contre 73,5 %) et sur Arena (1523 contre 1505, classement du 6 novembre 2026) |
| Meilleur rapport qualité-prix via l’API | GPT-6.1 Sol | GPT-6 Astra (effort high) | 55 sur Artificial Analysis pour 1,27 $ par tâche, contre 10,04 $ pour Opus 5.5 à 59 ; sur Terminal-Bench, après la réévaluation du 9 novembre, 60,9 % contre 60,3 % pour Astra (effort max), dans les intervalles de confiance des deux, pour une fraction du coût d’exécution |
| API à bas coût et gros volumes | GPT-6.1 Sol (effort medium) | GPT-6.1 Terra (effort xhigh) | 46 pour 0,36 $ par tâche, le score que Kimi K3.1 Pro atteint pour 3,68 $ ; Terra en effort xhigh obtient 45 pour 0,40 $ |
| Meilleur score, mais inaccessible | Gemini 4 Carbon | aucun | Premier sur Arena, sur Artificial Analysis (au 8 novembre) et dans le classement d’agents de Mercor, mais pas ouvert au public |
| Héberger le modèle soi-même | Kimi K3.1 Pro | DeepSeek V4.1 Flash | Meilleur modèle à poids ouverts sur Artificial Analysis avec 46, environ 14 points derrière les leaders au 8 novembre |
Si vous ne voulez retenir qu’un nom pour le code et le travail intellectuel, prenez Opus 5.5 : il est inclus dès Claude Pro. Pour les meilleurs scores sur Arena et dans les classements d’agents parmi les modèles que l’on peut acheter aujourd’hui, tournez-vous vers Gemini 4 Argon, disponible dans l’application Gemini avec Google AI Pro. Les versions gratuites et les prix en euros figurent dans le tableau des abonnements plus bas.
Les modèles qui comptent au 8 novembre 2026
Aujourd’hui, 9 modèles fermés et 1 modèle à poids ouverts se détachent. Ils viennent de quatre grandes familles (GPT d’OpenAI, Claude d’Anthropic, Gemini de Google et Grok de xAI), auxquelles s’ajoutent Muse Wonder de Meta et les modèles à poids ouverts comme Kimi K3.1 Pro. Les prix API sont en dollars par million de tokens (entrée / sortie), au tarif standard ; la grille complète se trouve dans notre guide du coût des tokens.
| Modèle | Éditeur | Prix API (entrée / sortie) | Fenêtre de contexte (tokens) | Où l’utiliser |
|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 4 $ / 20 $ | 1 million | Claude Pro (18 € HT) et au-delà, API |
| Claude Fable 5.2 | Anthropic | 8 $ / 40 $ | 1 million | Claude Max (90 € HT) et Ultra (180 € HT) ; avec Pro, via des crédits d’utilisation (pendant l’offre de lancement, du 9 au 16 novembre 2026, Pro inclut en plus les modèles Fable jusqu’à la moitié de la limite hebdomadaire) ; API |
| Claude Sonnet 5.5 | Anthropic | 2 $ / 10 $ | 1 million | Abonnements Claude, API |
| GPT-6 Astra | OpenAI | 10 $ / 50 $ | 1,05 million | ChatGPT Pro, sous le nom GPT-6 Pro ; avec Plus, seulement dans Work et Codex ; API |
| GPT-6.1 Sol | OpenAI | 2 $ / 10 $ | 1,05 million (500 000 par défaut dans Work et Codex) | API ; ChatGPT Work et Codex |
| Gemini 4 Argon | 2 $ / 10 $ jusqu’au 30 novembre, puis 4 $ / 20 $ | 1 million | Application Gemini avec Google AI Pro (21,99 €) et Ultra ; API | |
| Gemini 4 Carbon | Pas en vente (prix annoncé : 2 $ / 10 $ au lancement, puis 4 $ / 20 $) | 1 million (selon Artificial Analysis) | Un groupe restreint de spécialistes de la cyberdéfense, via le programme Fairwind de Google | |
| Muse Wonder | Meta | 4 $ / 20 $ selon la fiche Arena | 1 million (selon la fiche Arena) | Meta Model API et Muse Code |
| Grok 4.7 | xAI | 2 $ / 6 $ | 500 000 | API, Cursor et Grok Build |
| Kimi K3.1 Pro | Moonshot AI | Poids ouverts | 1 million | Téléchargement sur Hugging Face sous sa propre licence ; API hébergées |
Relevé sur les pages des éditeurs le 6 novembre 2026, revérifié le 8 novembre 2026. Les abonnements sont indiqués au prix affiché en France ; le détail des taxes figure dans le tableau des abonnements.
Trois points méritent qu’on s’y arrête. Opus 5.5 coûte 4 $ / 20 $, en baisse par rapport aux 5 $ / 25 $ d’Opus 5. Le tarif d’Argon est un prix de lancement, détaillé dans la partie Ce qui va changer. Et les longs prompts coûtent plus cher que ne l’indique le tableau : au-delà de 272 000 tokens en entrée, OpenAI facture toute la requête 2 fois plus cher en entrée et 1,5 fois plus cher en sortie, pour GPT-6 Astra comme pour GPT-6.1 Sol via l’API. xAI applique lui aussi un tarif majoré aux requêtes Grok 4.7 qui dépassent 200 000 tokens.
Attention aux noms proches : GPT-6 Sol et GPT-6.1 Sol sont deux modèles distincts. D’après l’aide d’OpenAI, le chat standard de ChatGPT passe sur GPT-6 Sol (déploiement en cours), tandis que GPT-6.1 Sol est une option à part dans ChatGPT Work et Codex.
Gemini 4 Carbon : le meilleur score que vous ne pouvez pas acheter
Carbon a beau avoir mené 3 classements au 8 novembre, l’Aperçu IA de google.fr ne le mentionnait pas le 8 novembre 2026 : pour « meilleure ia », il répondait par usage en nommant des outils comme Claude, ChatGPT, Gemini ou Perplexity, sans citer la moindre version de modèle. Dans son billet de lancement, Google réserve Carbon à « un sous-ensemble de défenseurs en cybersécurité », puis à d’autres partenaires de confiance, ajoutés progressivement via le programme Fairwind. Google dit vouloir l’ouvrir aux développeurs, aux entreprises et au grand public « dès que possible », sans donner de date. À ce jour, il n’existe ni abonnement public ni API générale.
Pour un acheteur, Carbon n’est donc pas encore une option. Voyez dans ses scores un avant-goût de la direction que prend Gemini, et choisissez parmi les modèles auxquels vous pouvez vous abonner.
Pourquoi les classements ne donnent pas le même gagnant
Chaque classement de LLM mesure une chose différente, et l’ordre change d’un tableau à l’autre. Les 4 classements ci-dessous, relevés avant le 9 novembre, désignent 2 gagnants différents : Carbon est en tête d’Arena, d’Artificial Analysis et du classement d’agents de Mercor, Opus 5.5 de Terminal-Bench. Parmi les modèles accessibles, Argon arrive premier sur 2 classements et Opus 5.5 sur les 2 autres.
| Classement | Ce qu’il mesure | 1er | 2e | 3e | Date |
|---|---|---|---|---|---|
| Arena, texte (général) | Votes humains à l’aveugle, 420 modèles | Gemini 4 Carbon (High) 1526, provisoire | Gemini 4 Argon (High) 1523 | Muse Wonder (Max) 1513 | Classement daté du 6 novembre 2026 |
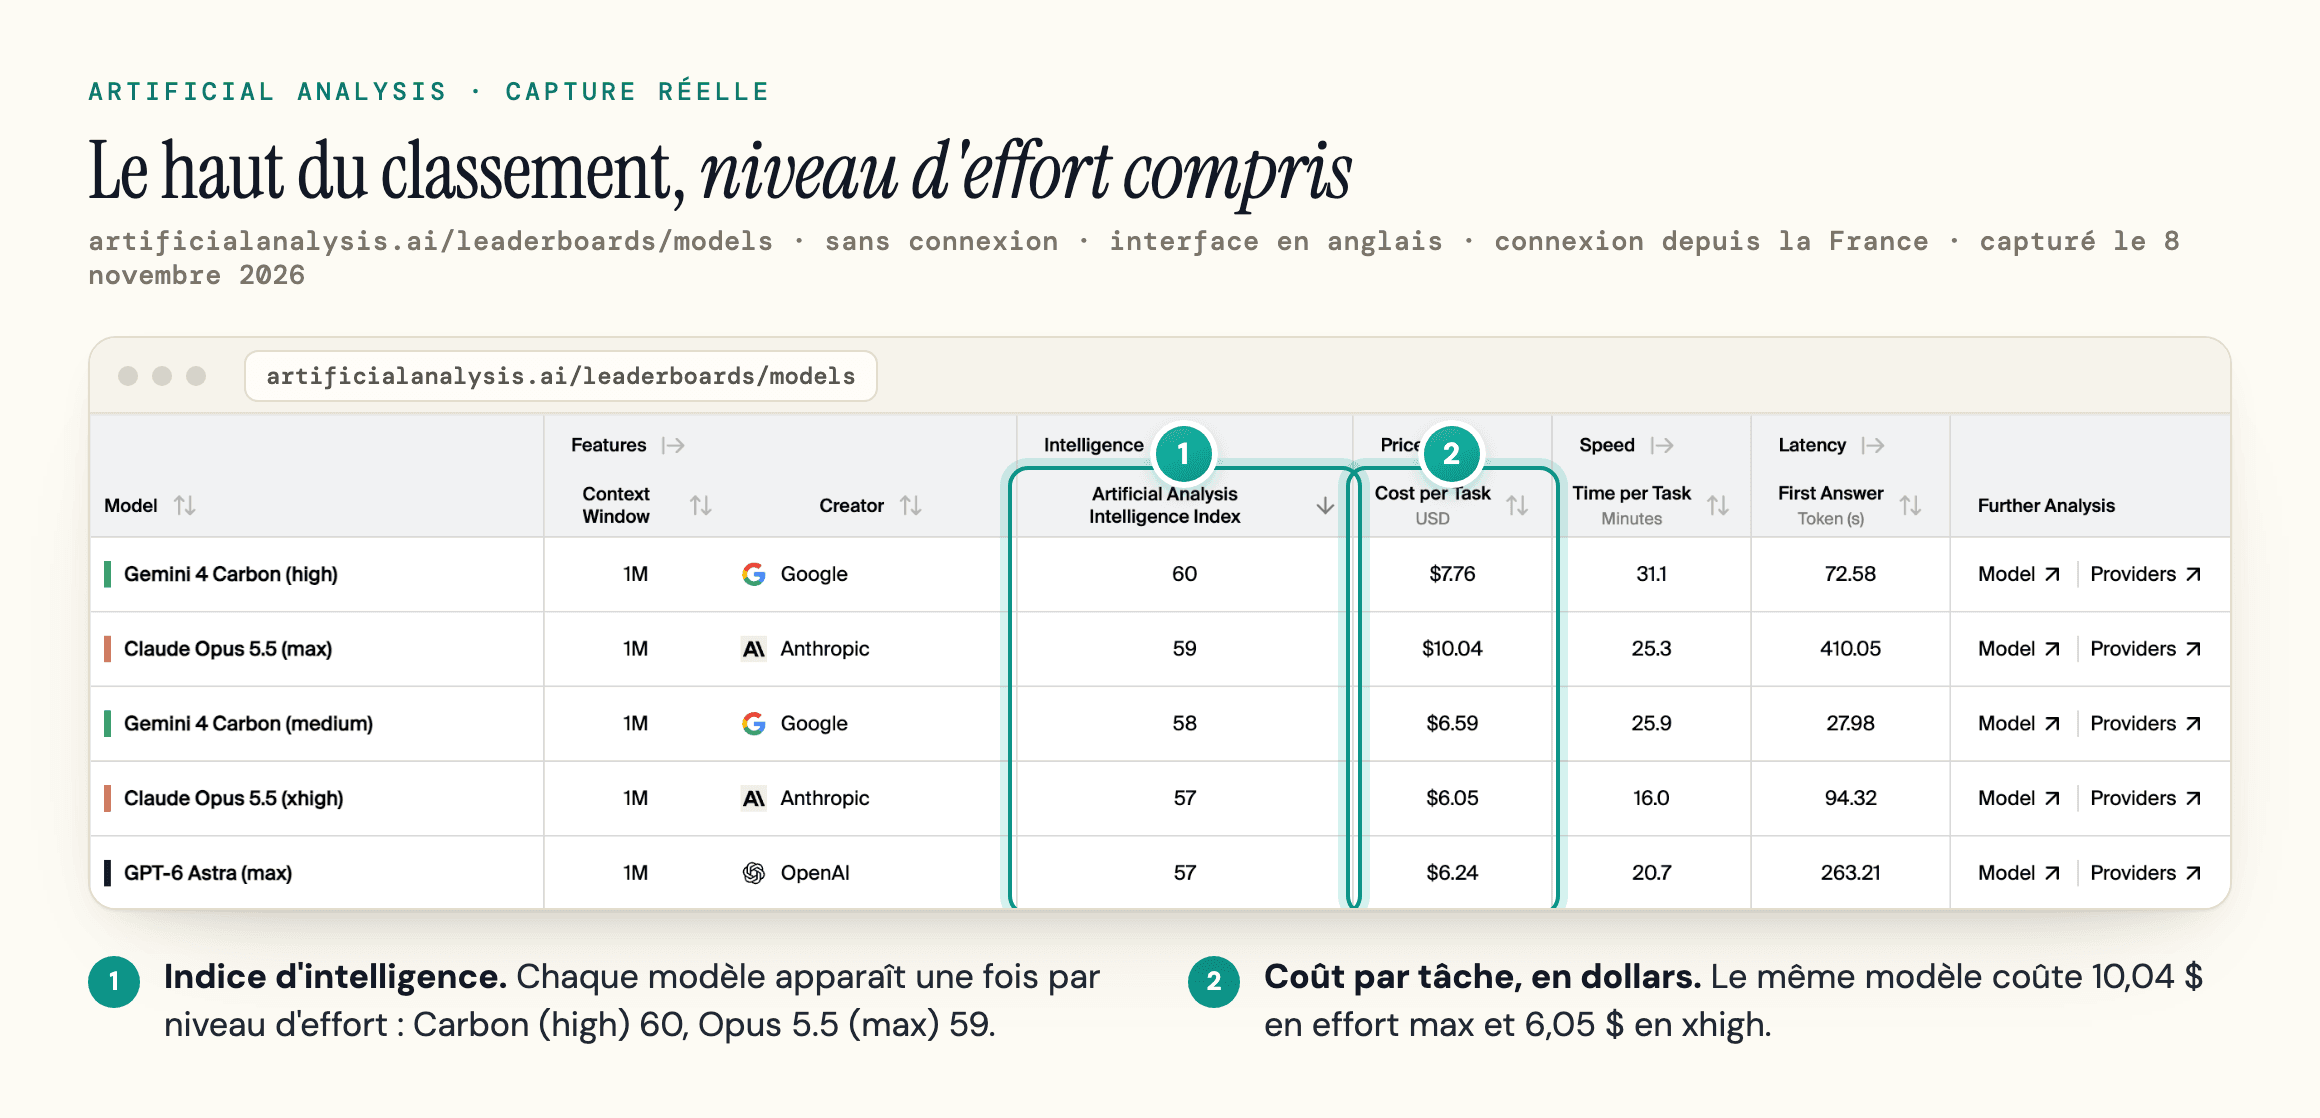
| Indice Artificial Analysis | Ses propres évaluations, menées en toute indépendance | Gemini 4 Carbon (high) 60 | Claude Opus 5.5 (max) 59 | GPT-6 Astra (max) 57 | Relevé le 8 novembre 2026 |
| Mercor APEX-Agents | Tâches professionnelles rédigées par des experts | 84,2 % (Gemini 4 Carbon) | 82,4 % (Gemini 4 Argon) | 77,6 % (Tencent Hy4) | Relevé le 8 novembre 2026 |
| Terminal-Bench 4.1, officiel | Tâches d’agent en ligne de commande | 65,8 % (Claude Opus 5.5) | 63,9 % (Claude Sonnet 5.5) | 60,9 % (GPT-6.1 Sol) | Exécutions 4.0 réévaluées le 9 novembre 2026 |
Les scores ne sont pas comparables d’un classement à l’autre. Artificial Analysis affiche plusieurs niveaux d’effort par modèle ; le tableau retient le meilleur de chacun.
Chez Mercor, côté agents, Opus 5.5 n’est que cinquième avec 73,5 %, derrière Carbon (84,2 %), Argon (82,4 %), Tencent Hy4 (77,6 %) et Sonnet 5.5 (75,5 %). Sur le classement Arena du 6 novembre, Muse Wonder (Max) de Meta était troisième avec 1513, devant Opus 5.5 (1505).
Préférence, indice indépendant, classements d’agents
Chaque classement répond à une question différente, d’où ces écarts.
Arena classe les modèles selon la préférence humaine, à l’aveugle. Il récompense les réponses que les gens aiment, pas celles qui sont justes. Sur le classement du 6 novembre, le score de 1526 de Carbon était signalé comme provisoire et reposait sur 4 483 votes, contre 18 399 pour Argon et 14 849 pour Opus 5.5.
Artificial Analysis fait tourner chaque modèle lui-même, et le niveau d’effort pèse lourd sur le résultat : Opus 5.5 obtient 59 en effort max et 52 en effort high. Au lancement de Carbon, Google citait un score de 59 sur cet indice ; la page affichait 60 le 8 novembre. Le 9 novembre 2026, Artificial Analysis a listé Claude Fable 5.2 à 65 en effort max (26,54 $ par tâche) et 62 en high (9,08 $), devant Carbon (60) et Opus 5.5 (59, à 10,04 $). Même au sein d’un seul classement, les scores bougent.
Mercor et Terminal-Bench testent des agents : chaque score mesure le modèle et son outillage. Terminal-Bench indique l’agent utilisé à côté de chaque résultat, Claude Code pour les modèles Claude et Codex pour ceux d’OpenAI. Méfiez-vous aussi de la page « meilleurs modèles » de Mercor, datée du 23 septembre 2026 : antérieure aux lancements d’Argon et de Carbon, elle place toujours Opus 5.5 en tête, alors que le classement en direct dit autre chose.
Les tableaux des éditeurs, eux, reposent sur leurs propres tests. Dans son billet sur Opus 5.5, Anthropic prévient que « les écarts de benchmark sont devenus un indicateur moins fiable des différences en conditions réelles ». Sa ligne Terminal-Bench 4.0 compare Opus 5.5 en effort xhigh à GPT-6 Astra en effort high, d’après le chiffre publié par OpenAI. Anthropic précise que chaque chiffre est le meilleur score du modèle, mais les réglages diffèrent.
Les benchmarks vieillissent aussi. OpenAI a cessé d’évaluer ses modèles sur SWE-bench Verified en raison de tests défaillants et de contamination, et recommande désormais SWE-bench Pro. Un score de code tiré d’un classement plus ancien peut ainsi reposer sur un test qu’au moins un laboratoire a abandonné.
compar:IA, le comparateur public français
La France a son propre comparateur. compar:IA, porté par le ministère de la Culture et financé avec la DINUM et ALT-EDIC, fait voter les internautes à l’aveugle entre deux réponses, sur des questions posées en français. Son classement, mis à jour le 8 novembre 2026, couvre 121 modèles et environ 269 000 votes (méthode Bradley-Terry). Claude Opus 5.5 y arrive en tête avec 1190, devant Muse Spark 1.2 (1179) et Muse Spark 1.3 (1171), mais le site range ces 3 modèles dans la même classe, que les votes ne permettent pas de départager.
Deux limites : il ne liste ni Gemini 4 Argon, ni Carbon, ni GPT-6 Astra, ni Grok, et la page précise qu’il reflète des préférences subjectives, pas la factualité des réponses. Son vrai intérêt est ailleurs : tester gratuitement deux modèles sur vos propres questions, sans savoir lequel répond.
Ce que nous avons testé, et ce que nous citons seulement
Chaque score de benchmark de cette page est repris de sa source, et daté. Nous n’en avons refait aucun. Le seul jeu de données que nous avons produit chez geotoolbox est un panel : le 6 novembre 2026, depuis les États-Unis, nous avons interrogé 5 moteurs d’IA avec 8 questions en anglais sur le choix d’un modèle, puis relevé chaque source citée. Ces 5 moteurs : ChatGPT (en mode déconnecté, plus un appel API), Gemini, le Mode IA (AI Mode) de Google, l’API Sonar de Perplexity et un agent Claude avec recherche web.
Les moteurs ont cité 183 domaines distincts. Parmi eux, 152 n’apparaissaient que chez un seul moteur, et 15 seulement chez 3 moteurs ou plus, presque tous des sites de documentation d’éditeurs ou de classements : anthropic.com, openai.com, x.ai, Artificial Analysis, Arena, BenchLM et LLM Stats. En dehors de ce socle commun, les moteurs ne s’accordent guère sur ce qu’ils citent.
Meilleure IA pour coder
Pour le code agentique, Claude Opus 5.5 est le meilleur LLM d’après les données qui ne viennent pas du billet de lancement d’un éditeur. Claude Sonnet 5.5 suit, et GPT-6.1 Sol s’impose dès que le budget entre en ligne de compte.
Le classement officiel Terminal-Bench a réévalué le 9 novembre 2026 ses exécutions de la version 4.0 avec les vérificateurs de la version 4.1, et chaque score est resté dans son intervalle de confiance à 95 % d’origine. Opus 5.5 y obtient 65,8 % avec Claude Code, et Sonnet 5.5, 63,9 %. Suivent, avec Codex, GPT-6.1 Sol (60,9 %) et GPT-6 Astra (60,3 %), dans les intervalles de confiance l’un de l’autre, puis la meilleure exécution de Fable 5.1, à 57,6 %. Fable 5.2 n’y a pas encore d’exécution. Le classement précise également le coût de chaque exécution : celle de GPT-6.1 Sol a coûté une fraction de celles d’Opus 5.5 et de Sonnet 5.5. Pour le détail des quatre gammes Claude, consultez notre comparatif des modèles Claude.
Le classement APEX-SWE de Mercor confirme le duo de tête : Opus 5.5 à 67,6 % et Sonnet 5.5 à 66,4 %, puis Opus 5 à 63,7 % et Fable 5.1 à 63,6 % parmi les modèles affichés sur son graphique. Mercor retient pour chaque modèle l’environnement d’exécution qui lui donne son meilleur score, ici Terminus-2.
Sur Terminal-Bench 4.0, les modèles à poids ouverts sont au coude à coude avec les leaders, du moins selon leur éditeur. La fiche du modèle publiée par Moonshot annonce 65,7 % pour Kimi K3.1 Pro sur Terminal-Bench 4.0 avec l’environnement Claude Code. Son tableau reprend les scores des autres modèles à partir de leurs billets de blog ou du classement officiel : c’est un chiffre d’éditeur comme un autre.
Le score dépend en partie de l’outil de code qui pilote le modèle. Pour aller plus loin, lisez notre comparaison Kimi K3 et Claude, notre analyse de GPT-6 Astra et notre test de Claude Fable 5.1.
Meilleure IA pour rédiger, chercher et lire de longs documents
Pour le travail intellectuel, les classements sont partagés. Opus 5.5 arrive en tête de GDPval-AA d’Artificial Analysis avec 1866, à égalité, à la marge d’erreur près, avec Kimi K3.1 Pro (1858) et Muse Wonder Full (1857) ; Claude Fable 5.2, ajouté au classement le 9 novembre 2026, obtient 1831 en effort max et 1718 en effort high, donc moins qu’Opus 5.5 en max, mais avec les réglages par défaut de l’API, Fable 5.2 (high, 1718) devance Opus 5.5 (medium, 1593). Gemini 4 Argon y est loin derrière, à 1631. Argon devance en revanche nettement Opus 5.5 dans le classement des tâches professionnelles de Mercor (82,4 % contre 73,5 %), comme sur Arena. Testez les deux sur vos propres documents.
La taille du contexte est ici la seule donnée objective, et les meilleurs modèles se tiennent de près. Claude Opus 5.5, Fable 5.2 et Sonnet 5.5 acceptent tous 1 million de tokens. GPT-6 Astra dispose d’une fenêtre de 1 050 000 tokens, dont jusqu’à 922 000 en entrée et 128 000 en sortie. Gemini 4 Argon offre une limite unifiée de 1 million de tokens (entrée et sortie) via l’API, et Grok 4.7 s’arrête à 500 000.
Pour la qualité de rédaction, il n’existe pas de note neutre en dehors des votes de préférence, et sur Arena ce sont des modèles Gemini, Meta et Claude qui occupent la tête. Côté recherche, les grandes applications ont chacune un mode de recherche approfondie (la page des offres de ChatGPT l’inclut dans toutes les formules, en version limitée dans l’offre gratuite). Faute de test indépendant qui les compare directement, nous ne les classons pas. Pour comparer les applications elles-mêmes, consultez nos comparatifs Claude ou ChatGPT, Claude ou Gemini et Gemini ou ChatGPT.
Meilleur rapport qualité-prix : le coût par tâche, pas le prix du token
Les prix catalogue sont trompeurs, car les modèles ne dépensent pas la même quantité de raisonnement pour une même tâche. Artificial Analysis publie une colonne de coût par tâche à côté de chaque score, et c’est elle qui révèle l’écart réel.
| Modèle (effort) | Score de l’indice | Coût par tâche | Prix catalogue (entrée / sortie) |
|---|---|---|---|
| Claude Opus 5.5 (max) | 59 | 10,04 $ | 4 $ / 20 $ |
| Claude Opus 5.5 (xhigh) | 57 | 6,05 $ | 4 $ / 20 $ |
| GPT-6 Astra (max) | 57 | 6,24 $ | 10 $ / 50 $ |
| GPT-6 Astra (high) | 55 | 3,24 $ | 10 $ / 50 $ |
| Claude Sonnet 5.5 (max) | 55 | 10,02 $ | 2 $ / 10 $ |
| GPT-6.1 Sol (max) | 55 | 1,27 $ | 2 $ / 10 $ |
| GPT-6.1 Sol (xhigh) | 52 | 0,76 $ | 2 $ / 10 $ |
| GPT-6.1 Sol (medium) | 46 | 0,36 $ | 2 $ / 10 $ |
| Kimi K3.1 Pro | 46 | 3,68 $ | Poids ouverts |
| Grok 4.7 (xhigh) | 35 | 7,77 $ | 2 $ / 6 $ |
Artificial Analysis, relevé le 6 novembre 2026 et inchangé le 8 novembre 2026. Le coût par tâche est celui que le site mesure sur son propre jeu de tâches, pas sur votre charge de travail.
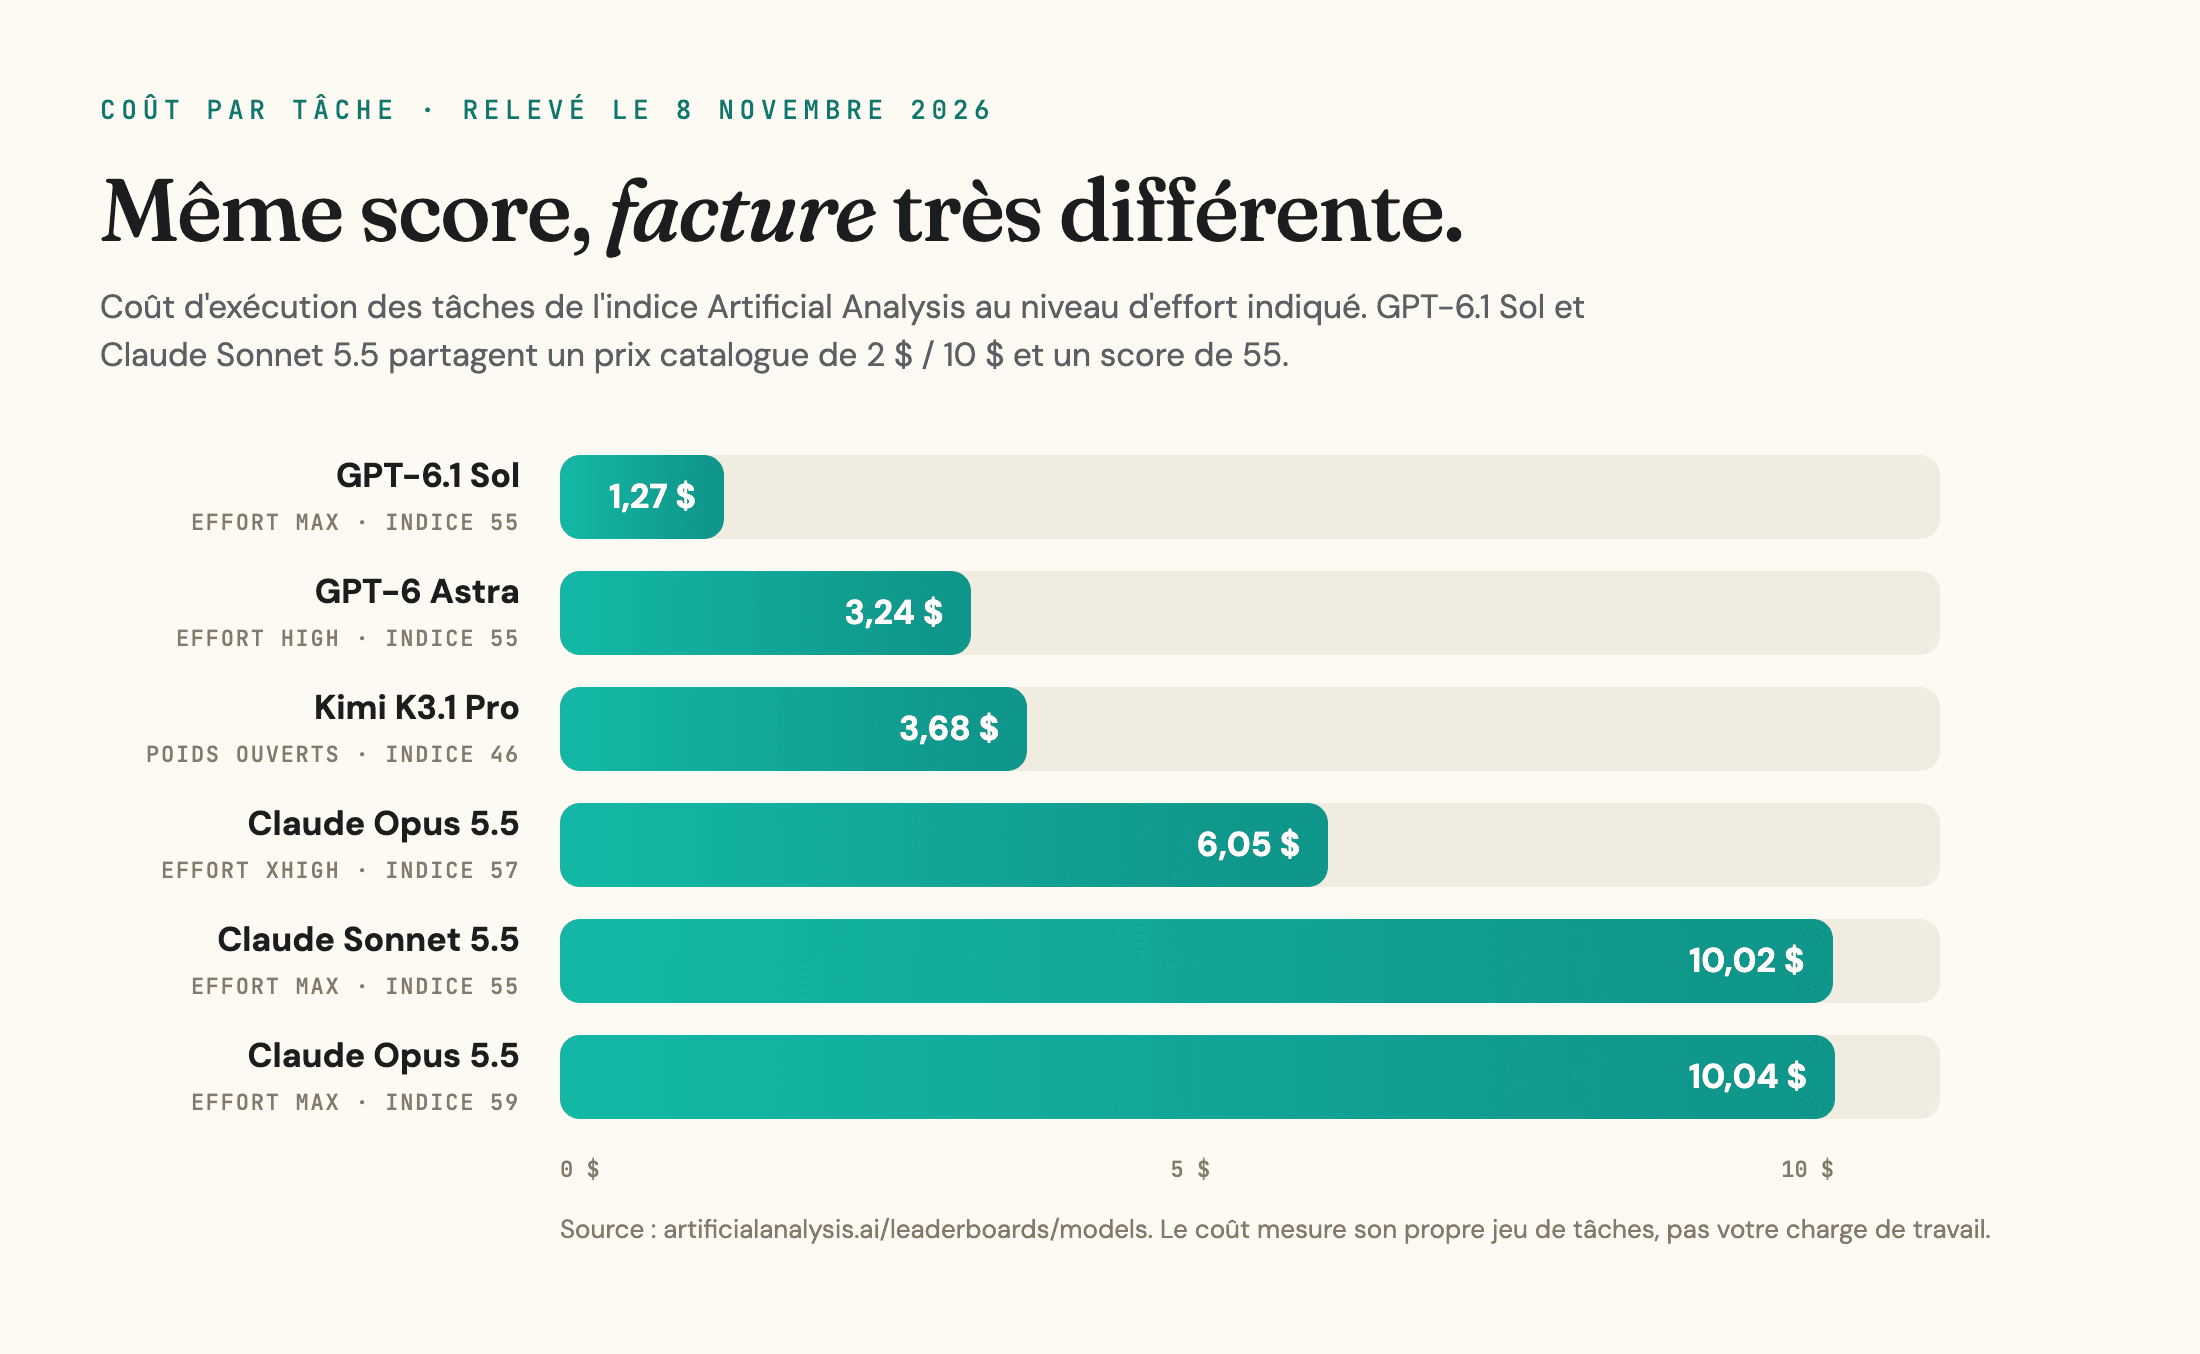
On peut en tirer 4 enseignements. GPT-6.1 Sol et Claude Sonnet 5.5 affichent le même prix catalogue (2 $ / 10 $) et le même score de 55 en effort max, mais GPT-6.1 Sol coûte 1,27 $ par tâche et Sonnet 10,02 $. Atteindre 55 avec GPT-6 Astra coûte 3,24 $ en effort high. Les 2 derniers points d’Opus 5.5 (de 57 à 59) coûtent environ 4 $ de plus par tâche. Et en bas de l’échelle, GPT-6.1 Sol en effort medium obtient 46 pour 0,36 $ par tâche, le score que Kimi K3.1 Pro atteint pour 3,68 $.
Le niveau d’effort est le levier décisif. Sur la même page, Opus 5.5 va de 35 en effort low à 59 en effort max : un score de classement sans niveau d’effort ne dit pas grand-chose. Le reste de la grille (entrées en cache, remises sur le traitement par lots) se trouve dans le guide cité plus haut. Quant à la vitesse : GPT-6.1 Sol en effort max prend environ 20 minutes par tâche, contre environ 9 pour Astra en effort high et environ 25 pour Opus 5.5 en effort max (relevé du 8 novembre 2026).
Meilleurs modèles à poids ouverts
Le leader des modèles à poids ouverts est Kimi K3.1 Pro. Avec 46, Artificial Analysis le place en tête des 40 modèles à poids ouverts que compte son classement de 99 modèles. C’est environ 14 points de moins que Carbon (60) et 13 de moins qu’Opus 5.5 (59). Sa fiche annonce 2 800 milliards de paramètres au total, dont 104 milliards actifs, sous une licence spécifique (Kimi K3.1 Pro License).
Derrière, Artificial Analysis affiche DeepSeek V4.1 Flash 1017 (max) à 33 et GLM-5.3 (max) à 32, un net décrochage par rapport à Kimi. Côté européen, le modèle phare de Mistral, Mistral Large 4, est lui aussi à poids ouverts, mais il obtient 26 sur le même indice. « Poids ouverts » ne veut pas dire « open source » : lisez chaque licence avant de bâtir un produit sur un modèle. Nos guides des meilleurs LLM open source et des modèles d’IA chinois détaillent les licences et l’hébergement, et notre guide pour faire tourner un LLM en local couvre le matériel.
Ce que comprend vraiment votre abonnement, en euros
Le modèle d’un classement et celui de votre application ne sont pas forcément les mêmes. Un même éditeur peut servir un modèle via l’API, un autre dans le chat et un troisième dans son outil de code.
| Formule | Prix mensuel en France | Ce qui tourne |
|---|---|---|
| ChatGPT Free | 0 € | Chats textuels illimités avec GPT-6 selon la page des offres ; la page d’aide d’OpenAI sur GPT-6 (mise à jour fin octobre) cite encore GPT-5.6 Luna comme modèle de Free |
| ChatGPT Go | 8 € | Plus de messages, de fichiers importés et d’images que l’offre gratuite |
| ChatGPT Plus | 23 € | GPT-6 Sol dans le chat standard (déploiement en cours) ; GPT-6 Astra seulement dans Work et Codex |
| ChatGPT Pro | À partir de 103 €, en 3 paliers (Pro 100, Pro 200 et Pro 500) | GPT-6 Pro, basé sur GPT-6 Astra, dans le chat sur Pro 100 et Pro 200 ; l’aide d’OpenAI ne cite pas Pro 500 |
| Claude Free | 0 € | Sonnet et Haiku, sans Opus |
| Claude Pro | 18 € HT (15 € HT par mois en annuel) | Opus, Sonnet et Haiku ; Fable via des crédits d’utilisation (du 9 au 16 novembre 2026, Pro inclut en plus tous les modèles Fable jusqu’à la moitié de la limite hebdomadaire) |
| Claude Max et Ultra | 90 € et 180 € HT | Fable inclus, jusqu’à la moitié de votre limite hebdomadaire, en plus de tout ce que contient Pro |
| Gemini gratuit | 0 € | Le modèle Flash-Lite |
| Google AI Plus | 4,99 € | Le modèle Flash ; Gemini 4 Argon n’arrive qu’avec AI Pro |
| Google AI Pro | 21,99 € | Gemini 4 Argon, Pro et Flash dans l’application Gemini ; Argon n’est pas proposé dans le Mode IA en France |
| Vibe (ex-Le Chat) de Mistral | Free 0 €, Pro 17,99 € TTC | Accès limité à Vibe en gratuit, accès complet avec Pro |
| X Subscription Premium | 31 € HT (16 € HT le premier mois) | Grok, Cursor Pro et les avantages X Premium+, avec un quota 4 fois supérieur à celui de l’offre X Subscription Plus |
Prix mensuels relevés le 8 novembre 2026 depuis la France, en mode déconnecté. ChatGPT et Google n’affichent aucune mention de taxe ; Mistral affiche ses prix TTC ; Claude et X affichent des prix hors taxes, auxquels s’ajoute la TVA à 20 % (soit 21,60 € TTC pour Claude Pro). Le détail par éditeur : prix de ChatGPT, prix de Claude, prix de Gemini et prix de Grok.
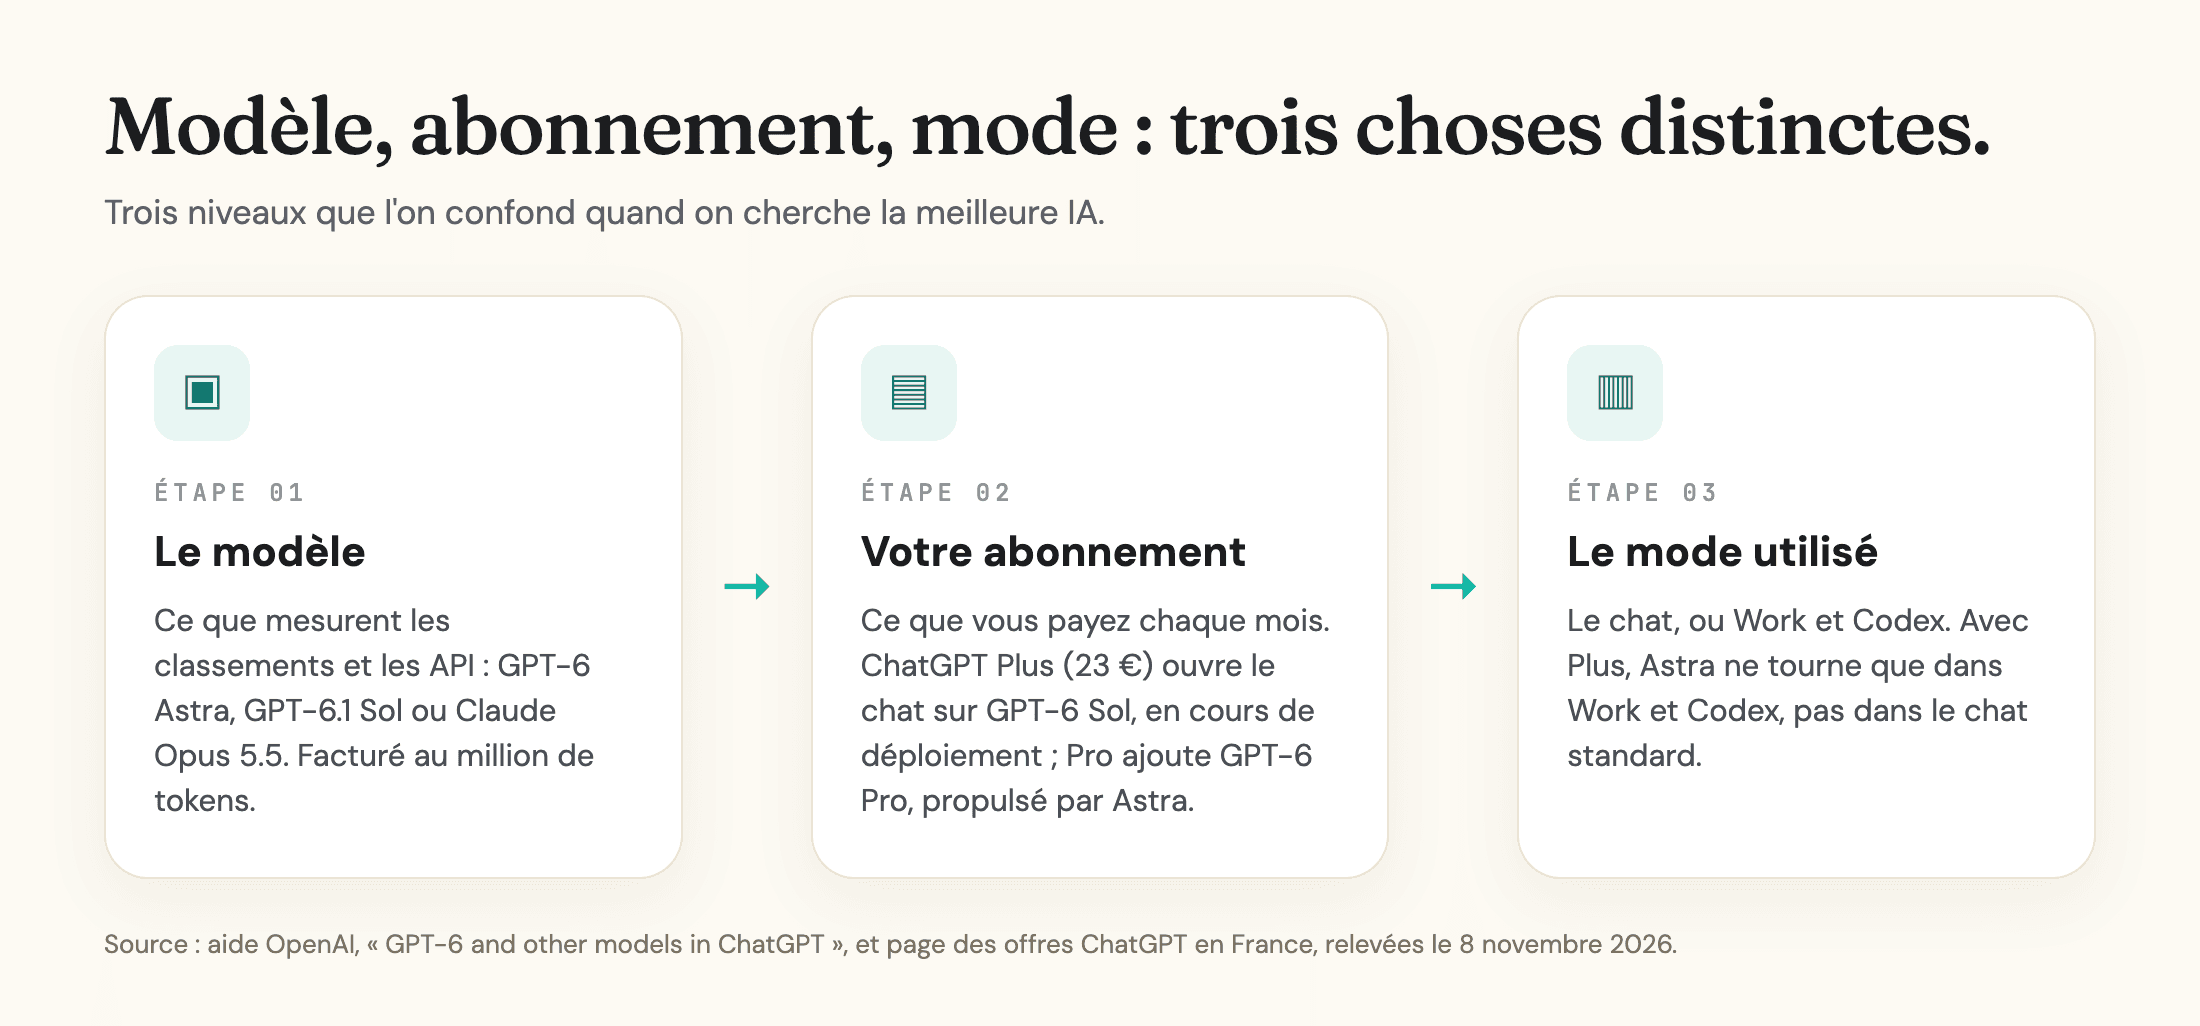
L'aide d’OpenAI sur GPT-6 dans ChatGPT précise que GPT-6 Pro est disponible sur Pro 100 et Pro 200, et que Plus donne accès à Astra dans Work et Codex. Avec la formule à une vingtaine d’euros, vous n’obtenez donc pas le même niveau de modèle d’un éditeur à l’autre : Opus avec Claude Pro (18 € HT), Argon dans l’application Gemini avec Google AI Pro (21,99 €), GPT-6 Sol (en cours de déploiement) avec ChatGPT Plus (23 €) ; GPT-6 Pro, dans le chat, reste réservé à Pro. Si vous ne faites que discuter, commencez par les versions gratuites.
Vibe, l’assistant de Mistral, reste une option européenne crédible : facturé en euros TTC, avec des données hébergées dans l’UE par défaut selon l’aide de Mistral (page du 12 août 2026). Son modèle phare n’est pas au niveau des leaders sur les classements, mais son hébergement européen peut peser dans votre choix si vous traitez des données de clients (voir l’étape 1 ci-dessous).
Vous cherchez une alternative à ChatGPT pour un usage précis ? Consultez notre guide des meilleures alternatives à ChatGPT.
Comment choisir l’IA adaptée à votre travail
Un classement sert à faire une présélection. Ce sont vos propres tâches qui tranchent.
- Vérifiez d’abord les conditions de traitement des données si vous manipulez des données de clients ou de salariés : c’est une question de RGPD avant d’être une question de modèle. Dans ses questions-réponses du 18 juillet 2024, la CNIL n’envisage un service grand public que pour des usages non confidentiels, avec des adresses professionnelles et la réutilisation des données désactivée. Pour des données personnelles, elle privilégie un système installé sur site, ou à défaut un service hébergé dans le cloud et encadré par un contrat de sous-traitance. De leur côté, ChatGPT, Claude et Vibe peuvent utiliser vos conversations sur les offres grand public pour entraîner leurs modèles tant que vous ne l’avez pas refusé dans les paramètres ; chez Gemini, cela dépend du réglage « Activité dans les applications Gemini ».
- Retenez 3 modèles qui figurent dans le top 5 d’au moins 2 classements pour votre type de travail.
- Alignez les réglages : comparez les scores au même niveau d’effort et avec le même outil, car les deux font bouger les résultats.
- Faites passer 20 à 50 de vos propres tâches dans l’outil que vous utiliserez vraiment : l’API, Claude Code, Codex ou l’application de chat.
- Notez si la réponse est juste, ce que l’exécution a coûté et combien de temps elle a pris.
- Refaites le test à chaque nouvelle sortie. Google a lancé Carbon environ 2 semaines après Argon : une présélection peut être dépassée en moins d’un mois.
Pour comprendre pourquoi deux modèles répondent différemment au même prompt, notre article sur la façon dont les modèles d’IA réfléchissent fait le point.
Ce qui va changer
Trois points à surveiller sur cette page.
- Le prix d’Argon : dans son billet de lancement, Google présente 2 $ / 10 $ comme un prix de lancement valable jusqu’au 30 novembre 2026 ; ensuite, ce sera 4 $ / 20 $.
- Le déploiement de Carbon : Google prévoit de l’ouvrir au-delà des spécialistes de la cyberdéfense « dès que possible ». Ce jour-là, la réponse à « quelle est la meilleure IA » changera probablement.
- Les classements : Arena a publié un nouveau classement le 8 novembre, après celui du 6 novembre présenté plus haut, et Artificial Analysis, Mercor et Terminal-Bench se mettent à jour à mesure que des modèles et des niveaux d’effort sont ajoutés.
Nous revérifions cette page d’ici le 20 novembre 2026.
Vérifiez ce que chaque moteur d’IA dit de votre marque
Vos clients posent ces mêmes questions aux modèles pour obtenir des recommandations. Sur nos questions de choix de modèle, les 5 moteurs citaient rarement les mêmes sources : une marque présente dans la réponse d’un moteur peut donc être absente de celle d’un autre.
Le suivi de visibilité IA de geotoolbox fait passer vos propres prompts dans les moteurs couverts par votre formule, sur votre marché et dans votre langue, puis liste les sources citées par chacun et indique si votre marque est mentionnée. Pour savoir ce que votre robots.txt autorise aux robots d’exploration des IA, commencez par le score de préparation IA, gratuit.
Foire aux questions
Quelle est la meilleure IA en ce moment ?
Tout dépend de l’usage. Claude Opus 5.5 s’impose pour le code, Gemini 4 Argon pour les scores sur Arena et dans les classements d’agents parmi les modèles accessibles, et GPT-6.1 Sol pour le coût par tâche. Gemini 4 Carbon obtenait de meilleurs scores sur 3 classements au 8 novembre, mais il n’est pas encore accessible. Claude Fable 5.2 est en tête de l’indice d’intelligence d’Artificial Analysis depuis le 9 novembre 2026, mais n’a pas encore d’exécution indépendante sur un classement de code et se place derrière Opus 5.5 sur GDPval-AA en effort max.
Gemini 4 Carbon est-il accessible au public ?
Non. Google réserve Carbon à un groupe restreint de spécialistes de la cyberdéfense et prévoit d’ajouter progressivement d’autres partenaires de confiance via son programme Fairwind. Aucune date n’a été annoncée pour un accès plus large, même si Arena et Artificial Analysis le classent déjà.
Quelle est la meilleure IA gratuite ?
Pour du texte, ChatGPT Free est l’offre la plus généreuse sur le papier : sa page des offres annonce des chats textuels illimités avec GPT-6. Claude Free propose Sonnet et Haiku, sans Opus ; Gemini en version gratuite tourne sur Flash-Lite ; Vibe Free offre un accès limité à l’assistant de Mistral. Aucune version gratuite ne donne accès à Opus 5.5 ou à Argon.
Quelle IA est meilleure que ChatGPT ?
Sur Arena, Gemini 4 Argon et Claude Opus 5.5 devancent tous les modèles d’OpenAI, et Opus 5.5 les devance aussi sur la capture d’Artificial Analysis du 8 novembre (59 contre 57 pour GPT-6 Astra). En coût par tâche, GPT-6.1 Sol reste le modèle le moins cher parmi ceux qui obtiennent 55 dans le tableau du rapport qualité-prix.
Sources
- Introducing Claude Opus 5.5 (4 $ / 20 $ par million de tokens, tableau de benchmarks du lancement) - Anthropic, 22 septembre 2026 -
anthropic.com/news/claude-opus-5-5 - Gemini 4 Carbon: our next frontier model (accès Fairwind, prix annoncé) - Google, 28 octobre 2026 -
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon - Billet de lancement de Gemini 4 Argon (prix de lancement jusqu’au 30 novembre 2026) - Google, 13 octobre 2026 -
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon - Mode IA : pays et langues disponibles, et liste des pays où Gemini 4 Argon est proposé dans le Mode IA (la France n’y figure pas) - Aide Google Search, consulté le 8 novembre 2026 -
support.google.com/websearch/answer/16011537 - LLM Leaderboard, Intelligence Index et coût par tâche - Artificial Analysis, relevé les 8 et 9 novembre 2026 -
artificialanalysis.ai/leaderboards/models - GDPval-AA - Artificial Analysis, relevé le 9 novembre 2026 -
artificialanalysis.ai/evaluations/gdpval-aa - Classement des modèles open source - Artificial Analysis, relevé le 8 novembre 2026 -
artificialanalysis.ai/models/open-source - Text Arena, classement général - Arena, classement daté du 6 novembre 2026 -
arena.ai/leaderboard/text - APEX-Agents leaderboard - Mercor, relevé le 8 novembre 2026 -
mercor.com/apex/apex-agents-leaderboard - APEX-SWE leaderboard - Mercor, relevé le 8 novembre 2026 -
mercor.com/apex/apex-swe-leaderboard - Best AI models right now (ancien classement, 23 septembre 2026) - Mercor -
mercor.com/resources/apex/best-ai-models-llms - Terminal-Bench 4.1 leaderboard (exécutions 4.0 réévaluées) - Terminal-Bench, relevé le 9 novembre 2026 -
tbench.ai/leaderboard - Terminal-Bench 4.1: updating task verifiers - Terminal-Bench, 9 novembre 2026 -
tbench.ai/news/terminal-bench-4-1 - Classement compar:IA (mis à jour le 8 novembre 2026) et FAQ - compar:IA, ministère de la Culture -
arene.comparia.beta.gouv.fr/ranking - Les questions-réponses de la CNIL sur l’utilisation d’un système d’IA générative (18 juillet 2024) - CNIL -
cnil.fr/fr/les-questions-reponses-de-la-cnil-sur-lutilisation-dun-systeme-dia-generative - GPT-6 Astra et GPT-6.1 Sol, fiches modèles (contexte, prix, surcoût au-delà de 272 000 tokens) - OpenAI developer docs, relevé le 8 novembre 2026 -
developers.openai.com/api/docs/models/gpt-6-astra - GPT-6 and other models in ChatGPT - Aide OpenAI, relevé le 8 novembre 2026 -
help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt - Forfaits et tarifs ChatGPT (France) - OpenAI, relevé le 8 novembre 2026 -
chatgpt.com/fr-FR/pricing - Why we no longer evaluate SWE-bench Verified - OpenAI, 23 février 2026 -
openai.com/index/why-we-no-longer-evaluate-swe-bench-verified - Plans et tarifs Claude (France) - Anthropic, relevé le 8 novembre 2026 -
claude.com/fr/pricing - Abonnements Google AI (France) - Google, relevé le 8 novembre 2026 -
gemini.google/fr/subscriptions - Tarification Mistral (France, EUR) et aide sur le stockage des données - Mistral AI, relevé le 8 novembre 2026 -
mistral.ai/fr/pricing - Offres X Subscription (France) - xAI, relevé le 8 novembre 2026 -
grok.com/plans - Grok 4.7 (prix, disponibilité) - xAI, 21 septembre 2026 -
x.ai/news/grok-4-7 - Introducing Muse Wonder and Muse Wonder Full - Meta, 12 octobre 2026 -
about.fb.com/news/2026/10/introducing-muse-wonder-models - Kimi K3.1 Pro, fiche du modèle - Moonshot AI, Hugging Face, relevé le 8 novembre 2026 -
huggingface.co/moonshotai/Kimi-K3.1-Pro