
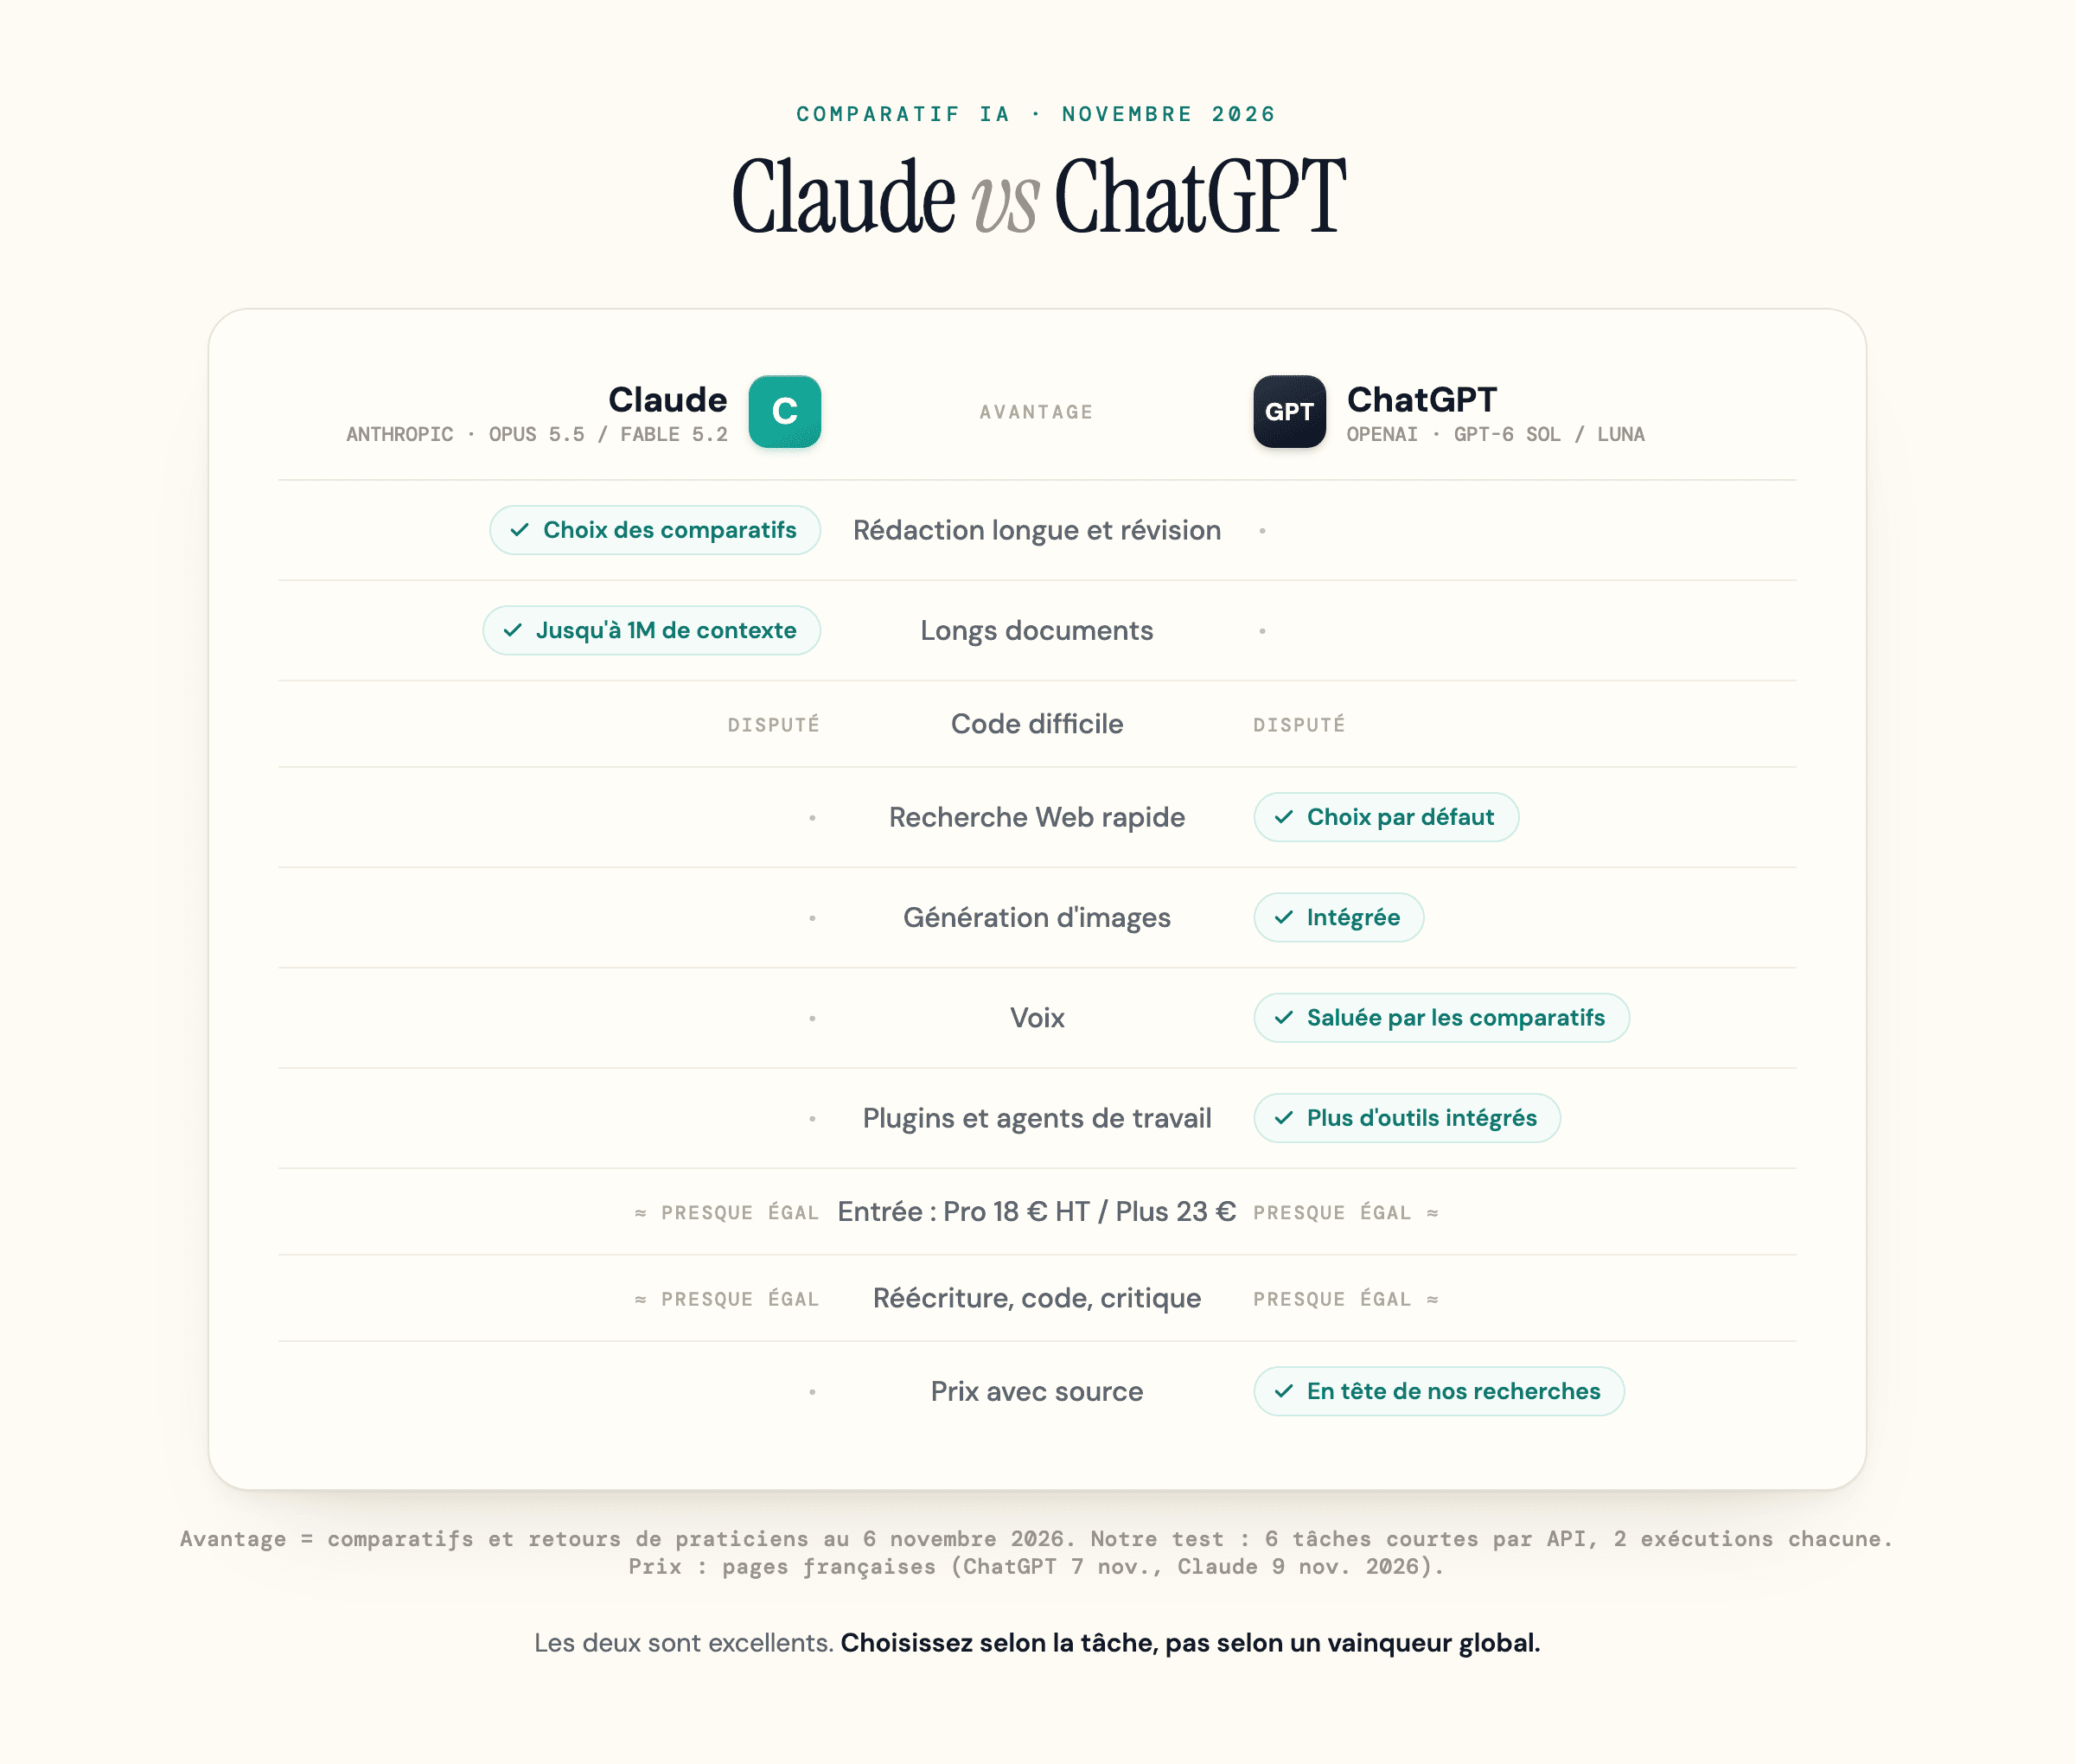
Claude ou ChatGPT : aucun des deux ne l’emporte nettement. Au 6 novembre 2026, des comparatifs comme celui de Zapier préfèrent Claude pour l’écriture créative, et sa fenêtre de 1 million de tokens convient aux longs documents. Sur le code, les praticiens sont partagés, et la plupart des comparatifs placent ChatGPT devant pour les images, la voix, la recherche Web rapide et les outils intégrés. Dans notre court test par API, les deux ont fait jeu égal sur la réécriture, le code et le retour critique, mais GPT-6 Sol a trouvé les pages des éditeurs de façon plus fiable.
Beaucoup de gens utilisent les deux : d’après l’enquête Menlo de 2026, l’utilisateur moyen d’IA aux États-Unis se sert de 3,0 assistants.
Le débat « Claude ou ChatGPT » est généralement présenté comme un match avec un vainqueur, et c’est pour cela que la plupart des comparatifs vieillissent si mal. Celui-ci s’adresse aux personnes qui publient ou commercialisent du contenu, pas à celles qui conçoivent des modèles, et il traite donc aussi une question que presque tous les comparatifs ignorent : lequel devrait citer votre marque ? Vous découvrez Claude ? Commencez par découvrir ce qu’est Claude.
Ce qu’il faut retenir
- Pas de vainqueur unique : Claude a généralement l’avantage sur la rédaction longue et les longs documents, ChatGPT sur les images, la voix, la recherche rapide et les outils intégrés, et le code reste disputé (au 6 novembre 2026).
- L’entrée de gamme coûte presque pareil : ChatGPT Plus affiche 23 € par mois sur la page tarifaire française, Claude Pro 18 € HT par mois, soit 21,60 € TTC avec la TVA de 20 % (calcul de notre part).
- En haut de gamme, les échelles divergent : ChatGPT Pro démarre à 103 € et compte trois niveaux d’usage (Pro 100, 200 et 500), Claude s’arrête à Max (90 € HT) et Ultra (180 € HT).
- Les limites d’usage comptent plus que le modèle : Claude décompte tout, chat compris, sur une fenêtre de 5 heures plus un plafond hebdomadaire ; ChatGPT laisse le chat courant « illimité » sous garde-fous anti-abus et décompte Codex sur des fenêtres de 5 heures et hebdomadaires.
- Pour une marque, la question décisive est de savoir quel moteur la cite : vos clients utilisent des assistants différents, et apparaître dans l’un ne garantit rien dans les autres.
Claude ou ChatGPT : aperçu rapide (novembre 2026)
Les deux sont excellents, et les vraies différences se jouent à la marge. Les gammes de modèles et les limites des forfaits évoluent chaque mois : chaque ligne ci-dessous porte donc la date de relevé du 6 novembre 2026 et provient des pages des éditeurs eux-mêmes ; les prix en euros ont été relevés le 7 novembre 2026 sur la page tarifaire française.
| Claude | ChatGPT | |
|---|---|---|
| Éditeur | Anthropic | OpenAI |
| Modèles dans l’application | Opus 5.5, Sonnet 5.5 et Haiku 5.5, plus le modèle haut de gamme Fable 5.2 sur les forfaits payants (tableau des modèles d’Anthropic) | Dans le Chat, GPT-6 Sol sur Plus, Pro et Business depuis le 7 octobre 2026, et GPT-6 Luna sur Free et Go depuis le 8 octobre selon les notes de version (une page d’aide d’OpenAI cite encore GPT-5.6 Luna) ; Pro ajoute le raisonnement de GPT-6 Astra. Work et Codex tournent notamment sur GPT-6.1 Sol et Terra |
| Forfaits (par mois) | Free, Pro 18 €, Max 90 €, Ultra 180 € (hors taxes, tels qu’affichés en France) | Free, Go 8 €, Plus 23 €, Pro à partir de 103 € en trois niveaux (page tarifaire française) |
| Limites d’usage | Une fenêtre de 5 heures plus un plafond hebdomadaire sur tout, chat compris ; les comptes Ultra vérifiés n’ont pas de limite de 5 heures, seulement des limites hebdomadaires | Chat courant illimité sur tous les forfaits, sous garde-fous anti-abus ; Codex a des fenêtres de 5 heures et hebdomadaires, et GPT-6 Pro sa propre limite hebdomadaire de messages |
| Contexte dans l’application | Jusqu’à 1 million de tokens selon le modèle, sur tous les forfaits | Chats Instant de 27K (Free), 54K (Go, Plus) et 128K (Pro) ; chats de raisonnement de 256K (Go, Plus) et 400K (Pro) |
| Mémoire | Mémoire entre les conversations sur tous les forfaits, Free compris | Limitée sur Free, plus longue sur Go, étendue sur Plus, maximale sur Pro |
| Recherche Web | Intégrée sur tous les forfaits ; un mode Recherche à partir de Pro | Intégrée ; recherche approfondie sur tous les forfaits, limitée sur Free et Go |
| Outil de code | Claude Code à partir de Pro | Codex sur tous les forfaits, limité sur Free et Go |
| Agents | Claude Code, Claude in Chrome, tâches planifiées | ChatGPT Work sur ordinateur, Web et mobile à partir de Plus ; Pro ajoute Dot, un agent toujours actif |
| Images et voix | Aucun générateur d’images sur sa page des forfaits ; Claude Design crée des prototypes et des diapositives ; mode vocal sur tous les forfaits | Génération d’images sur tous les forfaits (Images 2.6 depuis le 4 novembre) ; voix sur tous les forfaits |
| Assistants personnalisés | Projets et Skills | Plugins ; les GPT personnalisés sont retirés le 11 décembre 2026 |
| Offre gratuite | Sonnet et Haiku, recherche Web, mémoire et Artifacts, avec des plafonds sur 5 heures et à la semaine | Chats textuels illimités sous garde-fous anti-abus (sur GPT-6 Luna selon les notes de version) ; imports, images et voix limités |
Sources du tableau : tarifs de Claude et le centre d’aide de Claude, tarifs de ChatGPT et les notes de version de ChatGPT. Les deux sont des grands modèles de langage construits sur le même principe, et une liste de fonctionnalités ne mène donc pas très loin. Ce qui permet de prévoir lequel vous préférerez, c’est la manière dont chacun a été entraîné, son rapport au Web ouvert et la quantité d’usage que chaque forfait vous laisse réellement.
Claude est-il meilleur que ChatGPT ?
Non, et l’inverse n’est pas vrai non plus. « Meilleur » change selon la tâche. Des comparatifs comme celui de Zapier voient en Claude le meilleur partenaire pour le travail créatif, et sur Reddit les praticiens citent souvent les modèles Opus de Claude pour les problèmes de code difficiles, avec des avis qui varient selon le forfait.
Comparatifs et praticiens reconnaissent à ChatGPT la génération d’images intégrée, un mode vocal plus abouti et davantage d’outils intégrés, comme les plugins et les agents de travail. Le code est réellement disputé, et sur des tâches courtes et bien délimitées, nous n’avons pas pu les départager (voir notre test plus bas).
Si vos journées se passent à rédiger, réviser et raisonner sur de longs documents, Claude est généralement décrit comme plus précis et moins verbeux. Si elles passent par les images, la voix ou l’outil que chaque tâche exige, l’écosystème de ChatGPT est difficile à battre. Les deux éditeurs ajustent leurs modèles en permanence : considérez chaque avantage comme une tendance du mois.
Beaucoup de gens utilisent plusieurs assistants. Dans le 2026 State of Consumer AI de Menlo Ventures, une enquête menée auprès de 5 067 adultes américains et publiée le 16 septembre 2026, ChatGPT touche 60 % des utilisateurs d’IA, Gemini 58 % et Claude 20 % (contre 7 % un an plus tôt), et l’utilisateur moyen se sert désormais de 3,0 assistants généralistes, contre 2,2.
Menlo observe aussi que les utilisateurs de Claude paient plus souvent pour l’IA (82 %) et utilisent plus souvent des agents (48 %). Menlo est investisseur d’Anthropic : lisez les chiffres de Claude comme un signal, pas comme un recensement neutre.
La question utile est donc : meilleur pour quoi, sur quel forfait, pour qui et mesuré comment.
Claude ou ChatGPT : les prix et le forfait qu’il vous faut vraiment
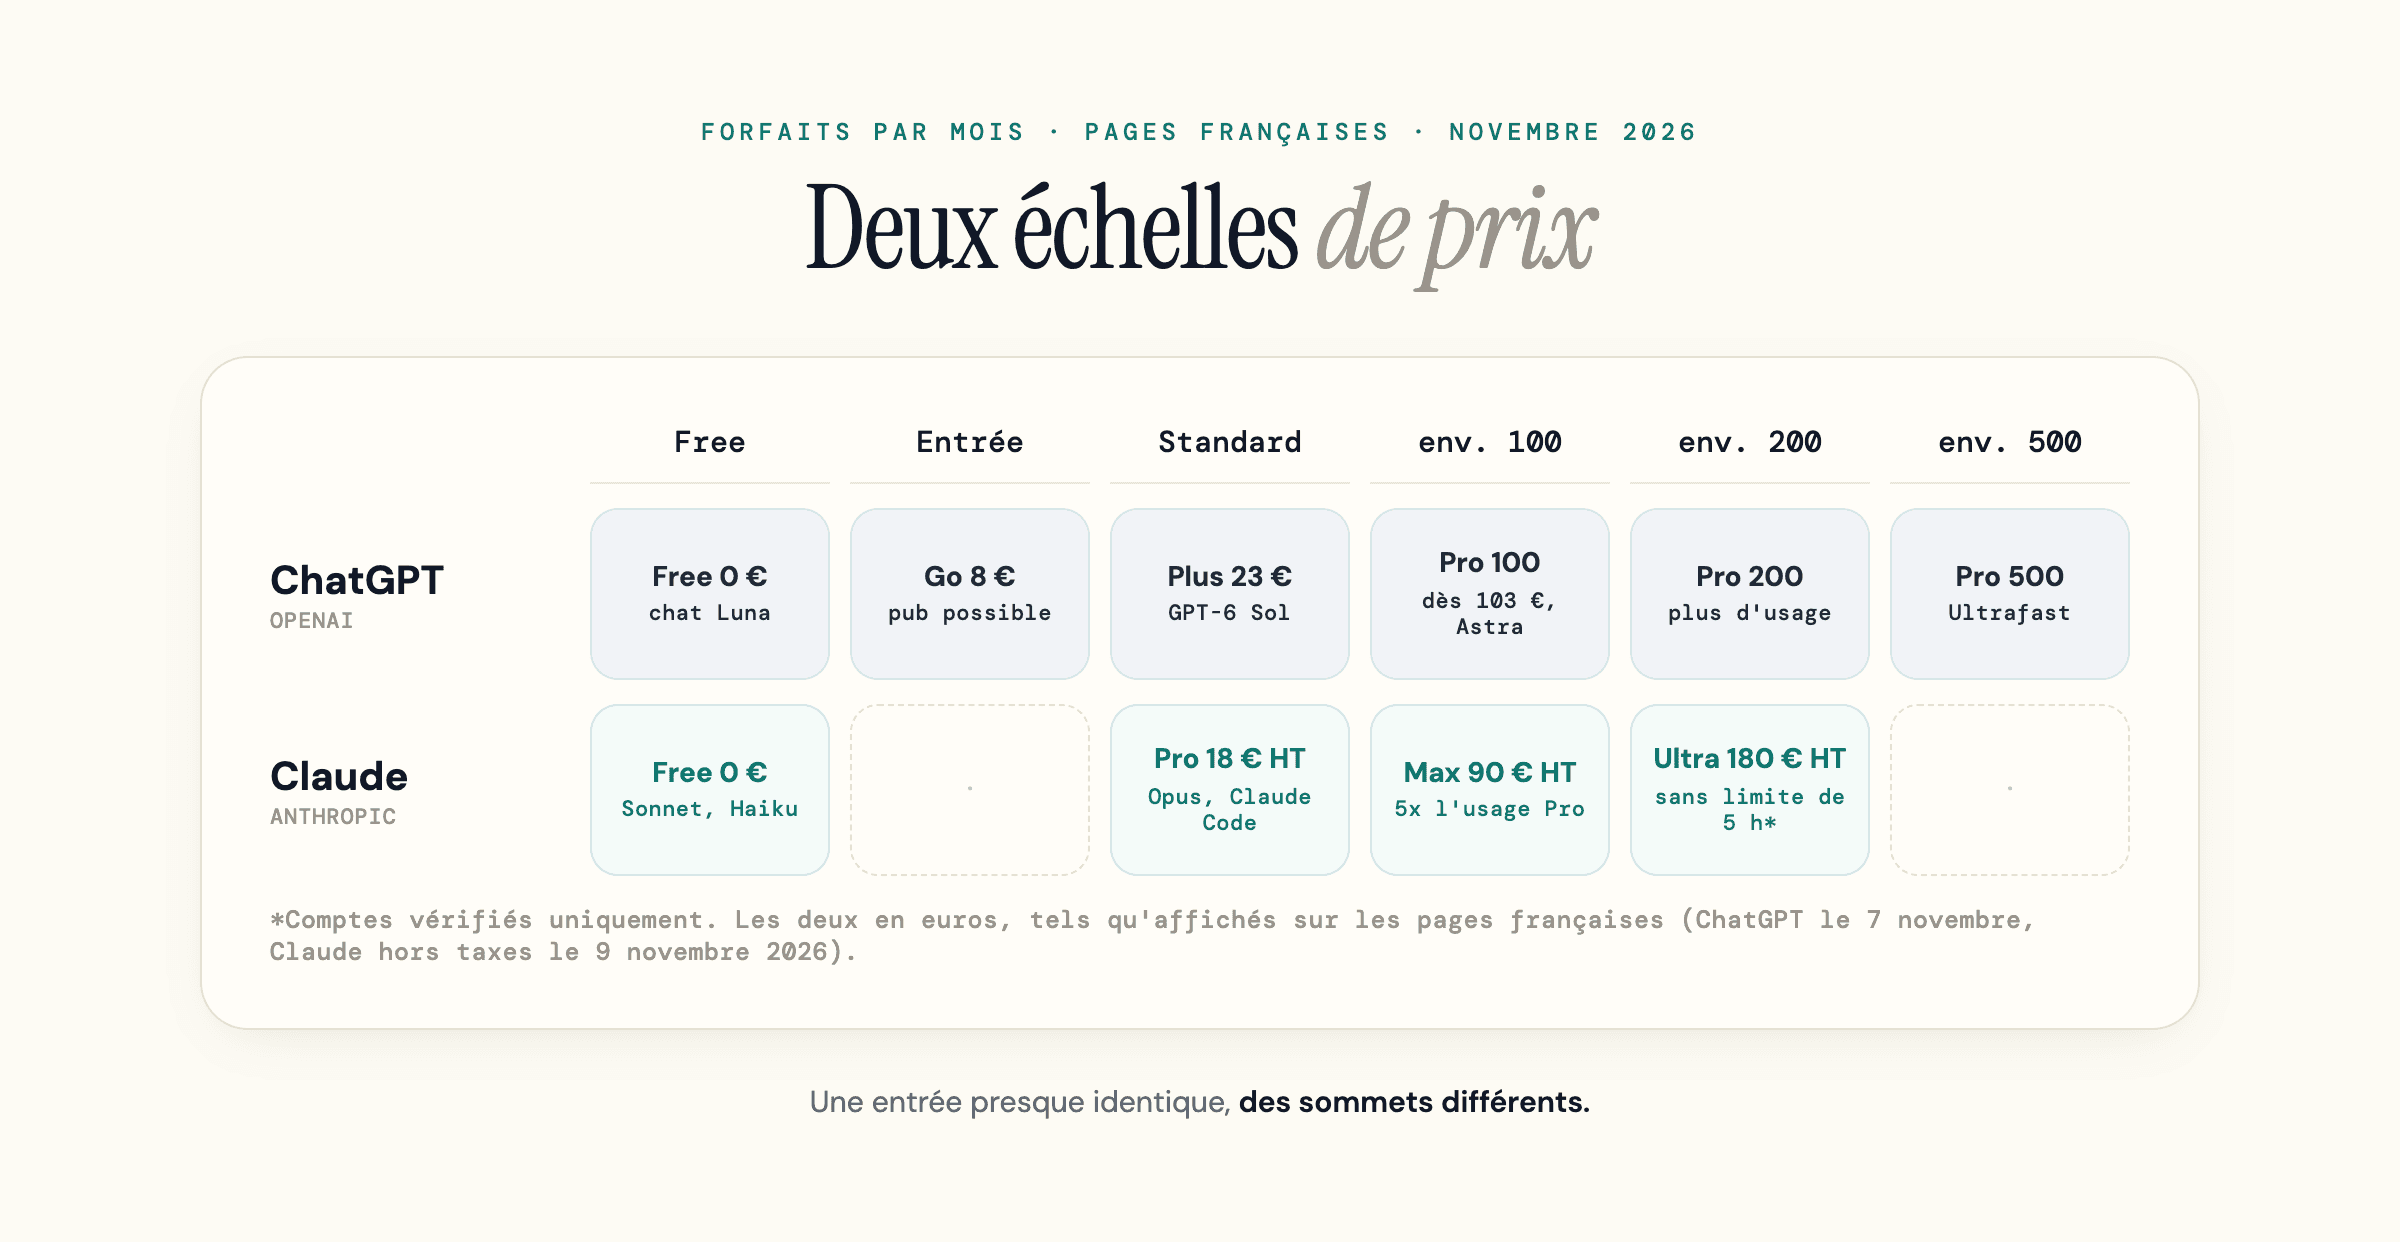
À l’entrée de gamme, les deux sont quasiment au même prix ; la différence tient à ce que chaque forfait vous laisse faire avant de vous arrêter. L’échelle ci-dessous reprend ce qu’affichaient les pages tarifaires françaises, consultées sans connexion depuis une adresse IP française (le 7 novembre 2026 pour ChatGPT, le 9 novembre pour Claude). Le contenu des forfaits provient des pages d’aide des éditeurs au 6 novembre 2026. Pour le détail de chaque côté, voyez nos guides sur les prix de ChatGPT et les prix de Claude.
| Niveau | Claude | ChatGPT |
|---|---|---|
| Free | Sonnet et Haiku, recherche Web, mémoire, Artifacts ; usage limité toutes les 5 heures et chaque semaine | Chats textuels illimités sous garde-fous anti-abus ; imports, images, voix, recherche approfondie et Codex limités |
| Entrée | Rien en dessous de Pro | Go, 8 € : plus de messages, d’imports, d’images et de voix, mémoire plus longue ; peut inclure des publicités |
| Standard | Pro, 18 € HT : ajoute Opus, Claude Code, le mode Recherche et davantage de Projets ; Fable via des crédits d’usage (du 9 au 16 novembre 2026, l’offre de lancement de Fable 5.2 l’inclut jusqu’à la moitié de la limite hebdomadaire) | Plus, 23 € : raisonnement avancé avec GPT-6, Codex et recherche approfondie étendus, ChatGPT Work sur ordinateur, Web et mobile |
| Autour de 100 | Max, 90 € HT : 5 fois l’usage de Pro ; Fable jusqu’à la moitié de votre limite hebdomadaire ; 100 $ de crédits API par mois | Pro 100, à partir de 103 € : tout Plus, plus le raisonnement Pro sur GPT-6 Astra et des sessions Work et Codex plus longues ; 103 € de crédits API par mois |
| Autour de 200 | Ultra, 180 € HT : pas de limite de 5 heures pour les comptes vérifiés, 10 fois l’usage hebdomadaire de Pro ; 200 $ de crédits API par mois | Pro 200 : plus d’usage que Pro 100 ; de nouveau ouvert aux nouveaux abonnés depuis le 29 septembre ; 229 € de crédits API par mois |
| Autour de 500 | Pas de niveau équivalent | Pro 500 : l’usage inclus le plus élevé et le seul forfait Pro avec le mode Ultrafast ; 510 € de crédits API par mois |
Sources : pages d’aide d’Anthropic sur Pro, Max et Ultra (modifiées le 30 octobre 2026), page d’OpenAI sur les niveaux Pro et page de Plus. La page tarifaire française d’OpenAI n’indique que « à partir de 103 € » pour Pro et donne les crédits API mensuels de chaque niveau (103 €, 229 € et 510 €), sans prix propre en euros pour Pro 200 et Pro 500. Anthropic a renommé Max 20x en Ultra sans changer le prix et précise que ses prix valent pour les abonnements Web : sur mobile, le prix peut différer.
Ce que vous payez vraiment en France. Consultée depuis la France, la page tarifaire d’Anthropic affiche des euros et précise que les prix « n’incluent pas les taxes applicables » : Pro à 18 € HT par mois, Max à 90 € HT et Ultra à 180 € HT (relevé du 9 novembre 2026). Avec la TVA de 20 %, Pro revient à 21,60 € TTC par mois (calcul de notre part). OpenAI affiche ChatGPT Plus à 23 € par mois sur sa page française, sans préciser si la TVA est incluse. Le montant qui compte reste celui de votre propre écran de paiement.
ChatGPT Plus vs Claude Pro
À l’entrée de gamme, vous choisissez une structure d’usage autant qu’un modèle. Les deux éditeurs décomptent le travail intensif sur des fenêtres de 5 heures et hebdomadaires (chez OpenAI, cela concerne Codex). Anthropic publie pour Claude Pro une limite de 5 heures plus une limite hebdomadaire sur tous les modèles, chat compris.
OpenAI laisse le chat courant « illimité » sous garde-fous anti-abus, mais indique que Plus « peut inclure des limites d’usage comme des plafonds de messages, surtout en période de forte demande » et décompte Codex sur des fenêtres de 5 heures et hebdomadaires, visibles dans Paramètres > Utilisation.
Ce que vous achetez diffère aussi. Pro ajoute Opus, Claude Code, le mode Recherche et davantage de Projets, et facture Fable, le modèle haut de gamme d’Anthropic, aux crédits d’usage ; du 9 au 16 novembre 2026, l’offre de lancement de Fable 5.2 l’inclut jusqu’à la moitié de la limite hebdomadaire. Plus ajoute le raisonnement GPT-6, une recherche approfondie et un Codex étendus, et ChatGPT Work sur ordinateur, Web et mobile, tandis que la génération d’images et la voix sont incluses dans tous les forfaits ChatGPT.
Si vous travaillez surtout le texte et le code, Pro suffit ; s’il vous faut aussi des images ou la voix, ChatGPT couvre une plus grande partie de votre journée.
Les niveaux autour de 100 et 200
C’est en haut de chaque échelle que les forfaits divergent. Le forfait Max de Claude coûte 90 € HT et vous laisse consacrer jusqu’à la moitié de votre limite hebdomadaire à Fable. Ultra coûte 180 € HT et, pour les comptes vérifiés, supprime complètement la limite de 5 heures. ChatGPT répartit la même tranche entre Pro 100 et Pro 200, avec au-dessus un niveau Pro 500, le seul à proposer le mode Ultrafast.
OpenAI a aussi changé de cap deux fois : il a rouvert Pro 200 aux nouveaux abonnés le 29 septembre 2026, puis, le 29 octobre, a annulé une réduction prévue de l’allocation Work et Codex de Pro 200 et doublé celle de Pro 100 et de Pro 500, d’après ses notes de version et sa page sur les niveaux Pro.
Max et Ultra de Claude incluent 100 $ et 200 $ de crédits API par mois, et chaque niveau Pro de ChatGPT inclut des crédits API mensuels égaux à son prix en dollars, selon le guide des crédits API d’OpenAI.
Les allocations changent assez souvent des deux côtés pour qu’un passage sur la page de l’éditeur avant de vous abonner vaille mieux que n’importe quel tableau, le nôtre compris.
Les postes Team et Business
Pour les équipes, les deux échelles ont la même structure et des montants très proches ; en facturation annuelle, le poste Claude est affiché moins cher en France (hors taxes chez Anthropic ; OpenAI ne précise pas la TVA). Un poste standard coûte 21,04 € HT par utilisateur et par mois en facturation mensuelle, ou 18 € HT en facturation annuelle, sur Claude Team, et 21 € sur ChatGPT Business d’après la page tarifaire française (20 $ en annuel, 25 $ en mensuel ; aucun montant en euros pour le mensuel). Un poste premium, avec davantage d’usage, coûte 105,23 € HT ou 90 € HT chez Claude et 105 € chez ChatGPT (100 $ ou 125 $).
Si vous butez sans cesse sur la limite
Les retours sont contrastés. Sur Reddit, des abonnés à Claude Pro décrivent des journées de chat intensif qui épuisent la fenêtre de 5 heures, l’un d’eux disant l’avoir atteinte « étonnamment vite ». Pour le travail agentique, certains trouvent que Claude tient plus longtemps que Codex, d’autres l’inverse, selon le forfait.
Les parades relevées dans les 20 fils des 90 derniers jours que nous avons lus se recoupent. Envoyez le chat informel vers ChatGPT et gardez Claude pour le travail qui le justifie. Ouvrez une nouvelle session avec un court résumé écrit plutôt que de reprendre un long chat qui relit tout son historique. Et utilisez un modèle plus petit pour les tâches légères. Ce sont des retours de la communauté, pas des résultats mesurés, et ces fils se trouvent dans des subreddits proches de chaque marque.
Comment Claude et ChatGPT sont construits (et pourquoi cela se ressent)
Sous le capot, les deux reposent sur le même type de moteur, puis prennent un virage net qui explique l’essentiel de leur comportement. Chacun est un transformer qui prédit le token suivant, entraîné sur une large part d’Internet. Le caractère avec lequel vous échangez vient d’une seconde étape, l’alignement, et du produit qui entoure le modèle.
Le comportement d’assistant de ChatGPT a surtout été façonné par l’apprentissage par renforcement à partir de retours humains : des personnes notent les réponses et le modèle apprend à produire davantage de ce qui est récompensé. Claude l’utilise aussi, mais y ajoute l'IA constitutionnelle. Le modèle critique et révise d’abord ses propres réponses au regard d’un ensemble de principes écrits, puis l’étape d’apprentissage par renforcement est guidée par des préférences qu’une autre IA génère selon ces mêmes principes.
Selon Anthropic, « the only human oversight is provided through a list of rules or principles » (la seule supervision humaine passe par une liste de règles ou de principes). Ces recettes d’entraînement différentes expliquent peut-être une partie de ce que décrivent les utilisateurs : Claude pose davantage de questions de clarification ou objecte dans les cas limites, ChatGPT est plus généraliste et plus prompt à produire quelque chose tout de suite.
Ce sont des tendances, et nous ne pouvons inspecter de l’extérieur le fonctionnement interne d’aucun des deux modèles : toute explication de leur comportement reste une lecture éclairée. Le mécanisme est détaillé dans nos articles sur le fonctionnement de ChatGPT et le fonctionnement interne de Claude.
| Le modèle | Le produit | |
|---|---|---|
| Ce que c’est | Un réseau entraîné qui transforme du texte en davantage de texte | L’application autour : outils, mémoire, recherche Web, génération d’images, filtres de sécurité, interface |
| Claude | Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.2, façonnés par l’IA constitutionnelle | claude.ai, Claude Code et Claude in Chrome : recherche Web, gestion de fichiers, Artifacts, code agentique |
| ChatGPT | GPT-6 Sol et Luna dans le Chat, Astra pour le raisonnement Pro, façonnés par RLHF | L’application ChatGPT : génération d’images, voix, plugins, Work et Codex, nombreux outils |
Quand on dit « ChatGPT génère des images » ou « Claude écrit du code », on décrit généralement le produit, pas le modèle brut. Les distinguer fait toute la différence entre un comparatif qui tient et un comparatif qui vieillit dès que l’un des deux éditeurs lance une fonctionnalité. Un écart de capacité aujourd’hui relève souvent d’un choix produit, pas d’une limite permanente du modèle.
Comment chacun cherche sur le Web et cite ses sources
Les deux modèles arrêtent d’apprendre des mois avant votre question ; ce qui change, c’est la façon dont chacun accède au Web en direct. Un modèle ne connaît le monde que jusqu’à sa date limite d’entraînement. Le tableau des modèles d’Anthropic attribue à tous les modèles Claude actuels, Opus 5.5 et Fable 5.2 compris, une date limite de connaissances fiable de juin 2026.
Les pages modèles d’OpenAI indiquent le 20 avril 2026 pour GPT-6 Sol, le 18 mai 2026 pour GPT-6 Luna et le 30 avril 2026 pour GPT-6 Astra.
Tout ce qui est plus récent, y compris la plupart des informations actuelles sur votre entreprise, n’atteint l’un ou l’autre qu’au moment de la requête : par la recherche Web, le contexte que vous collez, les fichiers que vous importez ou les sources connectées.
Le comportement Web de ChatGPT est réparti entre plusieurs robots, et OpenAI documente précisément le rôle de chacun. GPTBot collecte des données d’entraînement. OAI-SearchBot fait apparaître des pages dans les résultats de recherche de ChatGPT. ChatGPT-User récupère une page en direct quand votre question l’exige.
Ce sont des interrupteurs indépendants : bloquer l’un ne bloque pas les autres. La mécanique, et les cas où ChatGPT se trompe d’attribution, sont décrits dans nos articles sur la façon dont ChatGPT cite ses sources et le fonctionnement de la recherche ChatGPT.
La recherche Web de Claude est intégrée à tous les forfaits, et Pro et au-delà ajoutent un mode Recherche pour les investigations en plusieurs étapes. Les praticiens trouvent la recherche par défaut de Claude plus superficielle que celle de ChatGPT. Le conseil le plus plébiscité du plus grand fil consacré à la recherche que nous ayons lu : activer le mode Recherche, indiquer à Claude combien de sources consulter (15 à 20) et lui demander de lister leurs désaccords, puis augmenter le niveau d’effort. À défaut, rassembler les sources dans ChatGPT et les analyser dans Claude.
Avec sa fenêtre de 1 million de tokens, Claude convient aussi très bien quand vous collez un long document dans sa fenêtre de contexte et lui demandez de raisonner dessus plutôt que sur le Web ouvert.
Nous avons vérifié nous-mêmes un point précis : avec la recherche Web activée, chaque modèle trouve-t-il la page de l’éditeur pour une information modifiée la semaine précédente ? Chaque modèle a reçu deux fois une question sur un forfait OpenAI et une sur un forfait Anthropic. GPT-6 Sol a cité à chaque fois la page d’aide de l’éditeur et donné tous les chiffres justes.
Claude Opus 5.5 a donné les bons chiffres dans 3 exécutions sur 4, mais n’a cité une page d’éditeur que dans 1 sur 4. Dans les 3 autres, il s’est appuyé sur des pages tierces, faute de page d’éditeur dans ses résultats, et dans une exécution il n’a pas pu confirmer un prix.
C’est un petit échantillon, sur des moteurs de recherche différents : voyez-y une raison d’ouvrir la page citée, pas un classement ; le test complet figure plus bas.
Quand la recherche Web est désactivée, chaque modèle répond à partir de sa mémoire d’entraînement figée, et l’un comme l’autre peut produire une citation assurée, d’apparence authentique, qui n’existe pas. Ce n’est pas un mensonge : c’est une défaillance connue, où le modèle reconnaît la forme d’une source et complète avec des détails plausibles, ce qui explique que les deux outils inventent des articles scientifiques et des URL qui n’ont jamais existé.
Nous détaillons le mécanisme dans hallucinations de l’IA. Activer la recherche Web réduit fortement le phénomène sans l’éliminer : la citation qu’un modèle vous donne est une piste à vérifier, jamais une garantie.
Claude ou ChatGPT pour coder
En programmation, les produits comptent plus que les modèles. L’agent de code de Claude est Claude Code, inclus dès le forfait Pro ; celui de ChatGPT est Codex, disponible sur tous les forfaits avec une allocation limitée sur Free et Go. Comme les deux laboratoires proposent un agent complet à côté de la fenêtre de chat, la plupart des développeurs choisissent un flux de travail.
L’argent dit la même chose. Dans le 2026 State of Enterprise AI de Menlo Ventures, publié le 3 novembre 2026, Claude Code et Codex représentent ensemble 24,0 milliards de dollars, soit 70 % d’un marché du code assisté par IA en entreprise de 34,0 milliards de dollars, contre environ 1 milliard de dollars un an plus tôt. Menlo ne répartit pas cette estimation entre les deux laboratoires, et son enquête auprès d’environ 400 décideurs d’entreprises américaines a été menée en septembre 2026.
Menlo est aussi investisseur d’Anthropic : lisez ce chiffre comme une mesure d’adoption. Dans son enquête grand public, parmi les personnes qui utilisent des agents, Codex atteint 35 % et Claude Code ou Cowork 32 %.
Sur l’API, par million de tokens en entrée et en sortie, Claude Opus 5.5 coûte 4 $ et 20 $ et GPT-6 Sol 2 $ et 10 $, tandis que Claude Fable 5.2 coûte 8 $ et 40 $ et GPT-6 Astra 10 $ et 50 $. L’API est facturée en dollars.
Sur les benchmarks, le tableau dépend de l’environnement de test, comme le montre le tableau plus bas. Ce que disent les développeurs est plus concret. Sur Reddit, les modèles Opus de Claude sont souvent cités pour les problèmes difficiles et la planification, en particulier sur les forfaits autour de 100 € et au-delà. D’autres jugent Codex et les petits modèles GPT moins chers par tâche sur les forfaits autour de 20 €, et plusieurs estiment l’écart faible et conseillent d’essayer les deux pendant un mois. Ce sont des retours de la communauté.
Nous avons mené un petit test de code. Les deux modèles ont reçu la même fonction Python de calcul de médiane, boguée, avec la consigne de corriger une moyenne manquante, de ne plus modifier l’entrée et de lever une erreur sur une liste vide. Nous avons passé chaque réponse dans 6 tests unitaires. Claude Opus 5.5 et GPT-6 Sol les ont tous réussis, deux fois chacun.
Une fonction de médiane est une tâche facile : cela montre seulement que les deux franchissent un seuil de base. Pour une comparaison avec l’autre grand assistant de code, voyez Claude vs Copilot et Microsoft Copilot vs ChatGPT.
Claude ou ChatGPT pour la rédaction, les longs documents et le quotidien
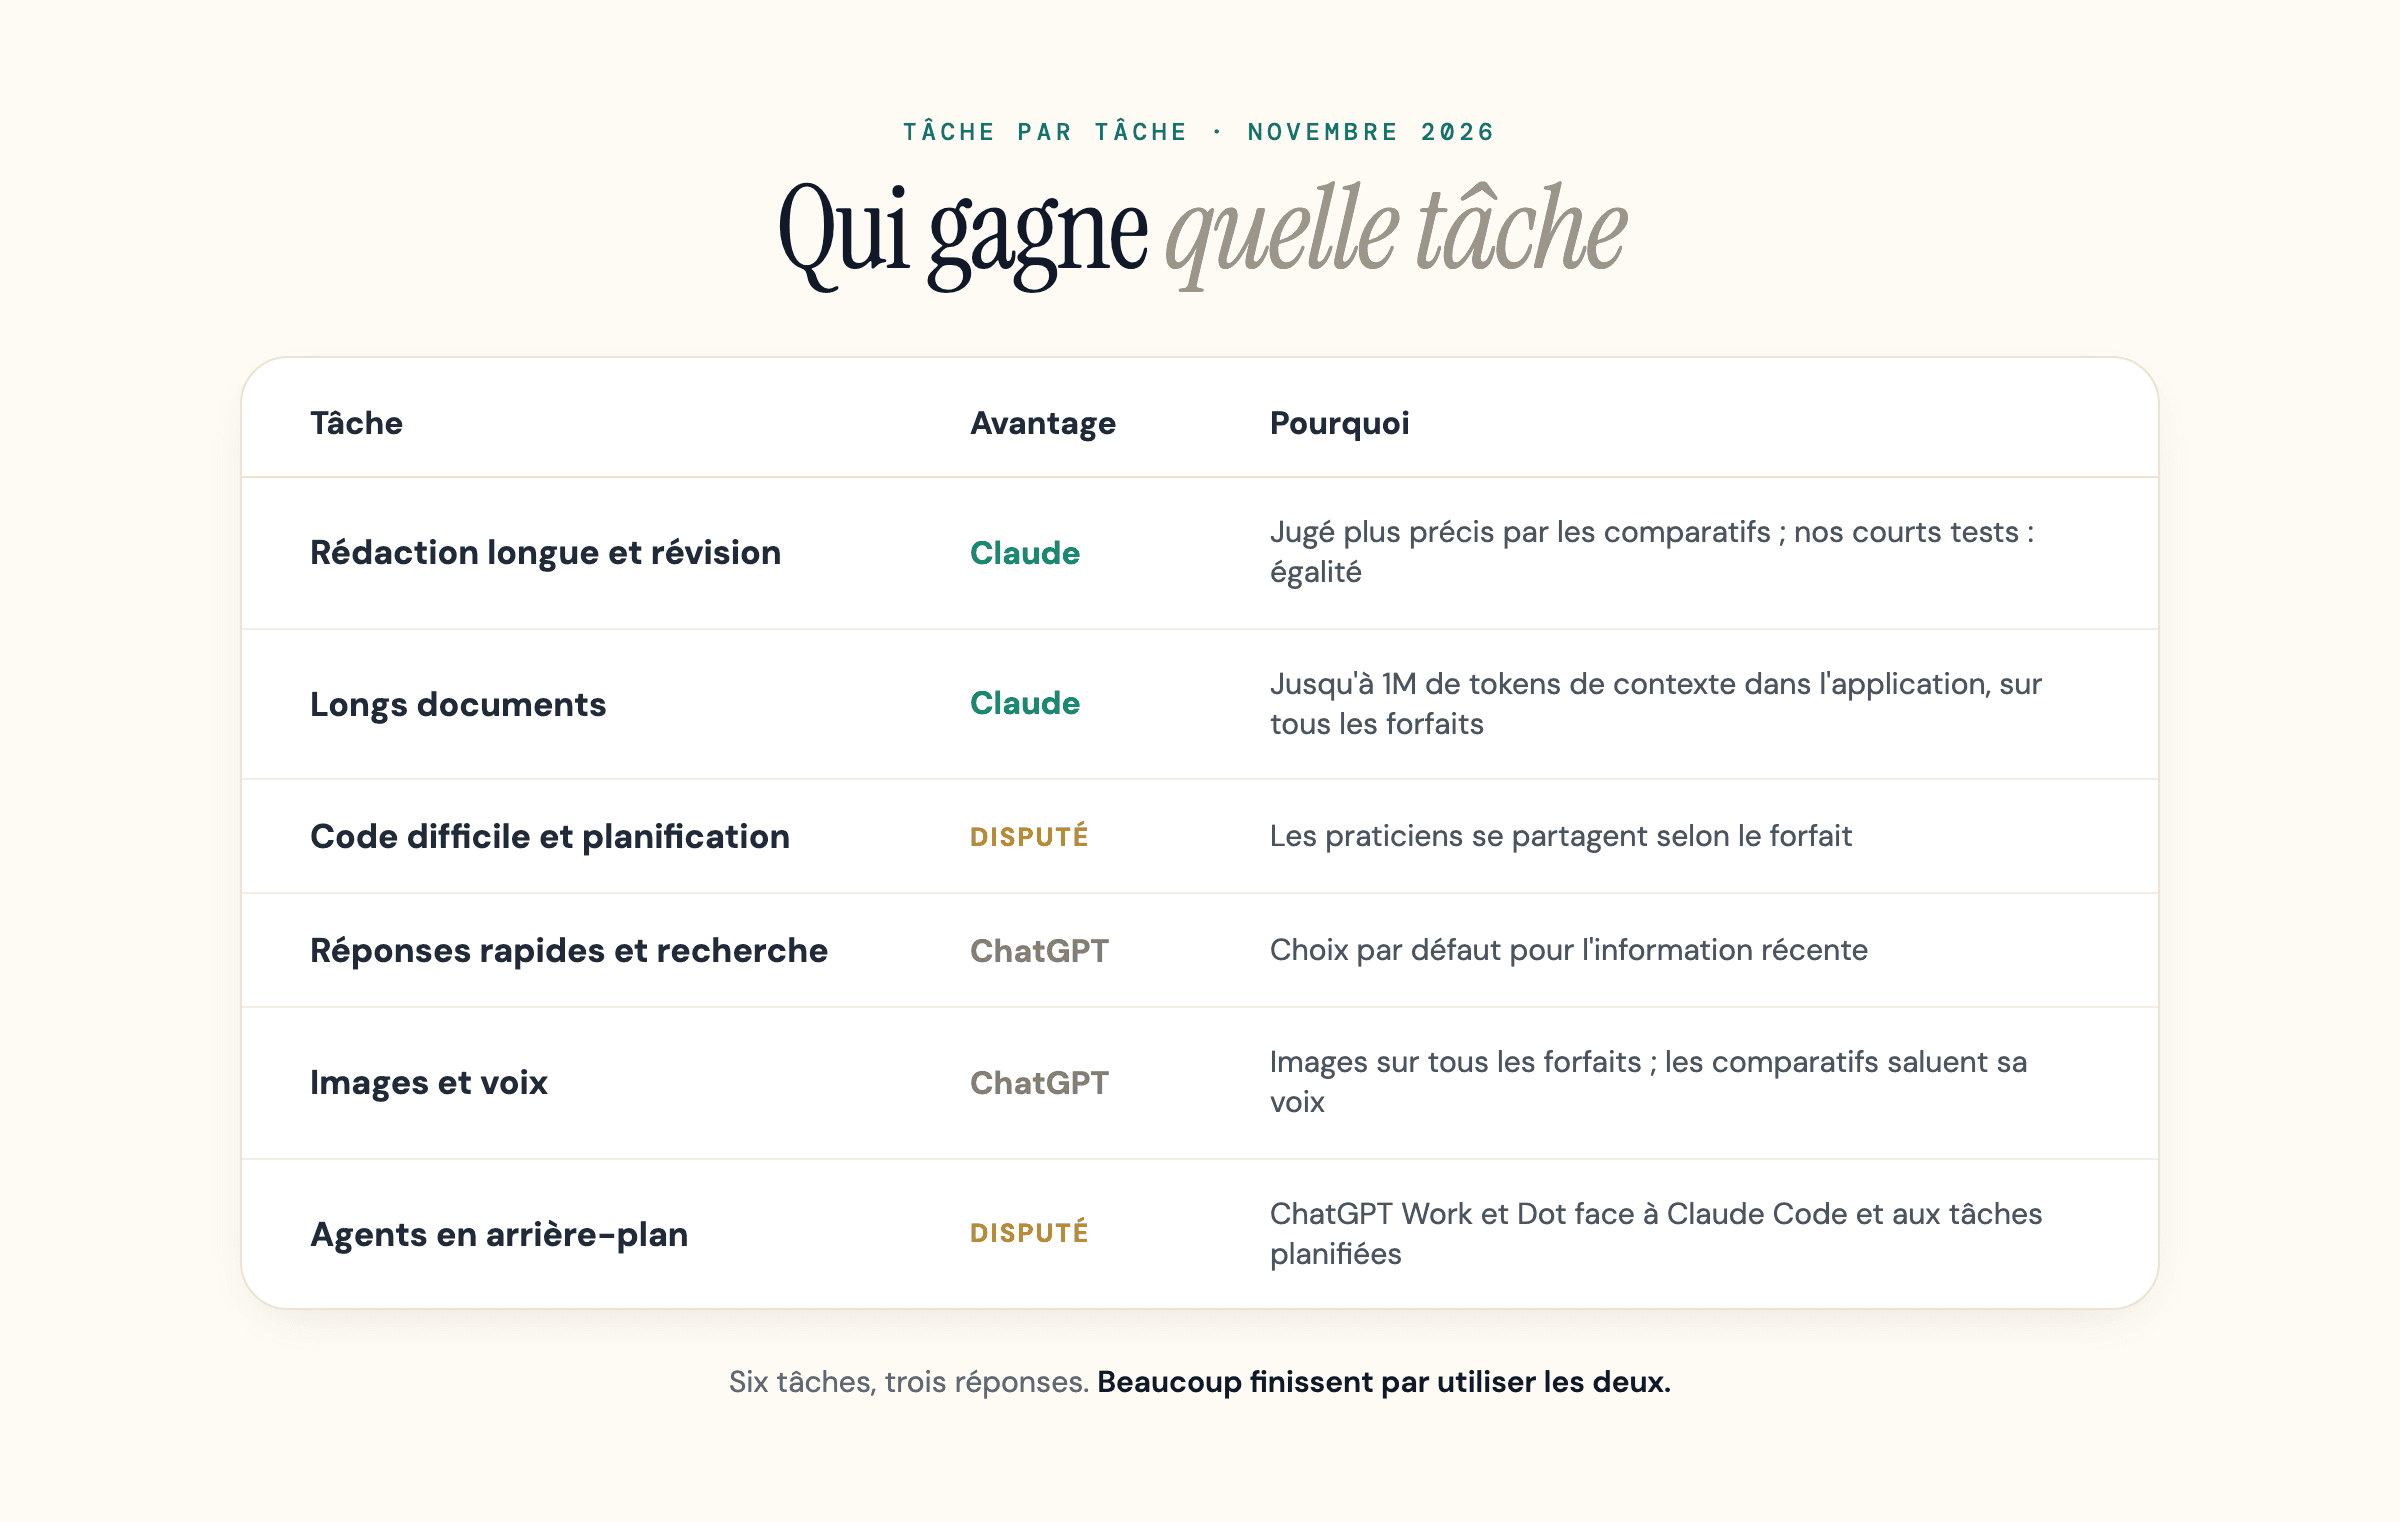
Classé par tâche, le tableau est plus clair que n’importe quel vainqueur global. Voici où chacun se situe le plus souvent, avec la réserve qui compte à chaque fois.
| Tâche | Avantage le plus souvent | Pourquoi | La réserve |
|---|---|---|---|
| Rédaction longue et révision | Claude | Comparatifs et praticiens décrivent une prose plus naturelle et moins de remplissage | Dans nos courts tests de réécriture et de contraintes, les deux ont fait jeu égal |
| Raisonner sur vos propres longs documents | Claude | Jusqu’à 1 million de tokens de contexte dans l’application sur tous les forfaits, contre 27K à 400K chez ChatGPT selon le forfait et le mode | Un contexte annoncé ne garantit pas une mémoire fiable de tout son contenu |
| Code difficile et planification | Disputé | Les praticiens se partagent selon le forfait : Opus est le choix sur les forfaits autour de 100 € et au-delà, et certains jugent Codex moins cher par tâche autour de 20 € | Une avance sur un benchmark n’est pas une avance en implémentation |
| Réponses rapides et recherche | ChatGPT | Les praticiens le considèrent comme le choix par défaut pour l’information récente | Le mode Recherche de Claude réduit l’écart à partir de Pro |
| Images, voix, multimodal | ChatGPT | Génération d’images intégrée ; des comparatifs comme celui de Zapier saluent son mode vocal avancé | Claude a aussi un mode vocal et crée des schémas et des prototypes via les Artifacts et Claude Design |
| Agents qui travaillent en arrière-plan | Disputé | ChatGPT Work et Dot face à Claude Code et aux tâches planifiées | Les deux évoluent chaque mois et décomptent l’usage différemment |
En rédaction, le conseil habituel veut que Claude soit le correcteur le plus incisif et qu’il ait tendance à vous donner raison, si bien qu’il faut lui demander explicitement une critique sévère. Nous avons testé la seconde moitié sur un cas. Les deux modèles ont reçu un tweet de lancement vantant une application « 100 % sans bug » et « garantie », avec la consigne de le noter et de dire s’il fallait le publier.
Les deux l’ont noté 2 ou 3 sur 10 dans les 4 exécutions, ont relevé les exagérations et déconseillé de le publier en l’état. Un cas facile ne prouve ni ne réfute une tendance, mais c’est une raison de ne pas supposer que l’un ou l’autre flattera un brouillon manifestement mauvais.
Sur les longs documents, la différence est structurelle. La page tarifaire de ChatGPT indique une fenêtre de contexte partagée par forfait, 54K pour les chats Instant sur Plus et 256K pour les chats de raisonnement, dont une partie seulement reste disponible pour votre saisie. Claude offre jusqu’à 1 million de tokens sur tous ses forfaits. C’est un vrai écart dans la quantité que vous pouvez coller en une fois, même s’il ne dit rien de la façon dont chaque modèle l’exploite.
Agents, images, voix et plugins
La fenêtre de chat n’est plus que la moitié de chaque produit. Les deux éditeurs proposent des agents qui travaillent plus longtemps qu’une simple réponse, et c’est là que les deux listes de fonctionnalités ont le plus grossi.
Côté ChatGPT, ChatGPT Work fonctionne sur ordinateur, Web et mobile à partir de Plus (Free et Go ont une version limitée sur ordinateur). La page tarifaire de ChatGPT range aussi les Projets et les tâches planifiées parmi les fonctionnalités de Plus, Codex prend en charge les tâches de code et Pro ajoute Dot, un agent toujours actif.
Work et Codex tournent sur leurs propres modèles, dont GPT-6.1 Sol et GPT-6.1 Terra, distincts de ceux du Chat, d’après les notes de version d’OpenAI.
Côté Claude, Claude Code couvre le code, Claude in Chrome et les connecteurs Microsoft 365 couvrent le navigateur et la bureautique, et à partir de Pro on peut déléguer et planifier des tâches. Anthropic indique sur sa page du forfait Ultra que vous pouvez confier à Claude des travaux plus longs, comme des rapports, des tableurs et des présentations, et qu’il continue en arrière-plan.
Les plugins remplacent les GPT personnalisés. La note de version d’OpenAI du 11 septembre annonce le retrait des GPT personnalisés sur tous les forfaits et leur migration vers les plugins, qui combinent des instructions réutilisables et des applications connectées, et sa FAQ sur le retrait fixe la date au 11 décembre 2026 (au 11 février 2027 pour FedRAMP et certains espaces Enterprise approuvés).
Les GPT existants continuent de fonctionner jusque-là. Les équivalents les plus proches chez Claude sont les Projets, qui regroupent fichiers et instructions partagés, et les Skills. Si vous avez bâti un processus métier sur un GPT personnalisé, prévoyez la migration dès maintenant.
Pour les images et la voix, ChatGPT garde l’avantage. Images 2.6, sorti le 4 novembre, ajoute la création de GIF (en cours de déploiement au 6 novembre) et des images de référence enregistrées, et la génération d’images est proposée sur tous les forfaits. Un nouveau modèle vocal, GPT-Live-1.1, est arrivé le 15 octobre avec des accents plus naturels et de nouvelles voix en français, allemand, hindi, japonais, coréen et espagnol du Mexique. Claude a lui aussi un mode vocal sur tous les forfaits, mais sa page des forfaits ne mentionne aucun générateur d’images.
Il a en revanche Claude Design, lancé le 17 avril 2026 pour les prototypes, présentations et documents d’une page, ce qui est un autre travail que générer une photo ou une illustration. Les praticiens le disent plus directement : Claude ne génère pas d’images et sa voix est plus faible, ChatGPT est le plus polyvalent.
Nous avons testé les deux : 6 tâches courtes, mêmes prompts
Nous avons mené notre propre test en 6 tâches. Le 6 novembre 2026, nous avons envoyé les mêmes 6 prompts, deux fois chacun, à Claude Opus 5.5, le modèle par lequel Anthropic conseille de commencer pour la plupart des usages, et à GPT-6 Sol, le modèle du Chat de ChatGPT sur Plus. Les requêtes passaient par l’API de DataForSEO, qui intègre la recherche Web propre à chaque éditeur.
Nous avons rédigé les prompts et les règles de notation avant la première exécution. Des scripts ont noté 3 tâches (nombre de mots, éléments obligatoires, tests unitaires), et les 3 tâches ouvertes ont été notées à l’aveugle par 2 évaluateurs IA indépendants, réponses anonymisées et mélangées (un modèle Opus et un modèle Sonnet, donc tous deux d’Anthropic). Ils ne savaient pas quel modèle avait écrit quoi, mais certains liens cités portaient des paramètres de suivi d’OpenAI que nous n’avions pas retirés : l’anonymisation n’était donc pas parfaite. Ils se sont accordés sur toutes les notes maximales.
| Tâche | Ce qu’elle vérifie | Claude Opus 5.5 (note maximale) | GPT-6 Sol (note maximale) |
|---|---|---|---|
| 1. Raccourcir un paragraphe | 45 mots au plus, 6 noms et chiffres conservés | 2 sur 2 | 2 sur 2 |
| 2. Respecter des contraintes strictes | Trois phrases de 12 mots, sans virgule, sans point-virgule et sans la lettre q | 2 sur 2 | 2 sur 2 |
| 3. Corriger une fonction Python | 6 tests unitaires sur une fonction de médiane | 2 sur 2 | 2 sur 2 |
| 4a. Trouver les prix de ChatGPT Pro | Bons chiffres, le changement du 29 octobre, une URL source d’OpenAI | 0 sur 2 | 2 sur 2 |
| 4b. Trouver Claude Ultra | Bons chiffres, le changement de nom de Max 20x, une URL source d’Anthropic | 0 sur 2 | 2 sur 2 |
| 5. Juger un mauvais tweet | Note basse, signale les exagérations, déconseille la publication | 2 sur 2 | 2 sur 2 |
| Total | 8 sur 12 | 12 sur 12 |
Les deux tâches de recherche expliquent tout l’écart, et cet écart tient surtout à la recherche elle-même. Pour la note maximale, il fallait citer la page de l’éditeur. GPT-6 Sol a mené des recherches limitées aux sites d’aide des éditeurs et a trouvé la page de l’éditeur à chaque fois.
Claude Opus 5.5 a fait une recherche large par question, n’a trouvé une page d’éditeur que dans 1 exécution sur 4 et l’a dit plutôt que de citer une page qu’il n’avait pas vue. Ses chiffres étaient justes 3 fois sur 4, mais la seule exécution qui citait une page d’éditeur laissait un prix non confirmé : aucune de ses 4 recherches n’a donc obtenu la note maximale.
Sur les quatre autres tâches, les deux étaient indiscernables, et ces tâches étaient assez faciles pour que les deux réussissent chaque exécution : elles montrent un plancher.
Ce que le test ne montre pas compte autant. Le point d’accès DataForSEO que nous avons utilisé limite les prompts à 500 caractères : il n’y a donc aucune tâche sur un long document, et nous ne tirons aucune conclusion sur la rédaction longue ou le raisonnement sur de gros fichiers.
2 exécutions par case, c’est peu, les modèles ont utilisé via cette API des outils de recherche différents propres à chaque éditeur, qui peuvent se comporter autrement que dans leur application, et ils ont été appelés sans les instructions système ni les outils que chaque application ajoute. Lisez ce tableau comme une vérification ponctuelle reproductible.
Ce que disent les benchmarks (à lire avec recul)
Les benchmarks montrent quels modèles appartiennent au peloton de tête, pas lequel utiliser au quotidien. Ils servent à la première chose et presque pas à la seconde. Voici l’état des principaux en novembre 2026.
| Benchmark | Ce qu’il mesure | Leader annoncé | À lire avec |
|---|---|---|---|
| SWE-bench Verified | Résolution de vrais tickets GitHub (code) | Claude est en tête, mais le classement public n’a ajouté aucun résultat depuis le 26 février 2026 et sa dernière entrée Claude est Opus 4.6. Meilleur score toutes configurations : 79,2 % (Claude 4.5 Opus). Dans la vue par défaut, avec un environnement de test standard, Claude 4.5 Opus mène à 76,8 %, Gemini 3 Flash et MiniMax M2.5 étant à égalité environ un point derrière | Les scores dépendent fortement de l’environnement de test. La fiche système d’Opus 5 d’Anthropic annonce 96,0 % sur Verified avec sa propre configuration, pour un modèle que le classement n’a jamais évalué. Celle d'Opus 5.5 remplace Verified par SWE-bench Pro (89,9 %) et Multilingual (93,9 %), et la page de GPT-6 Astra d’OpenAI ne donne aucun score SWE-bench |
| GPQA Diamond | Questions scientifiques de niveau doctorat (raisonnement) | GPT-6 Astra mène avec 96,0 %, devant Gemini 3.8 Flash à 95,3 % et Claude Fable 5.1 (modèle haut de gamme d’Anthropic jusqu’au 9 novembre 2026, puis remplacé par Fable 5.2) à 93,7 %, mais ces chiffres viennent du tableau comparatif d’OpenAI lui-même ; dans son annonce de Fable 5.2, Anthropic ne publie aucun score GPQA | Les scores sont proches du plafond : de petits écarts paraissent plus grands qu’ils ne le sont |
| Arena | Votes de préférence humaine en face à face | Gemini 4 Carbon (préliminaire) et Argon, de Google, occupent les 2 premières places en texte (instantané du 27 octobre 2026), Claude Opus 5.5 est troisième et Fable 5.1 cinquième ; la meilleure entrée d’OpenAI, GPT-5.6 Sol, figure au 22e rang | Cela mesure ce que les gens préfèrent, pas ce qui est juste |
| OSWorld | Utilisation de l’ordinateur et tâches agentiques | Claude Opus 5 mène le classement officiel OSWorld 2.0 sur le jeu hors ligne v2026.08.08 : 70,2 % en notation partielle contre 64,1 % pour GPT-5.6 Sol. Le tableau d’Astra d’OpenAI, qui reprend les 70,2 % d’Opus 5, place GPT-6 Astra devant à 72,6 % sur ce même jeu. Anthropic annonce 81,8 % pour Opus 5.5 sur des fichiers de tâches mis à jour avec son propre environnement et précise que ce score n’est pas directement comparable aux autres versions | Un benchmark jeune et bruité, qui bouge beaucoup d’une version à l’autre |
Plusieurs choses empêchent ces chiffres de dire ce qu’ils semblent dire. D’abord, la plupart des scores de code mis en avant sont déclarés par les laboratoires eux-mêmes, et un même modèle peut varier de 5 à 10 points selon l’environnement qui l’entoure. Ensuite, les anciens tests de culture générale comme MMLU sont pratiquement saturés et ne figurent plus dans les derniers tableaux de lancement des laboratoires : ils ne départagent plus les meilleurs modèles.
Troisièmement, la tête du classement change presque chaque mois au fil des lancements : tout chiffre isolé est un instantané. Quatrièmement, Arena récompense les réponses que les gens préfèrent, ce qui suit la qualité mais récompense aussi les réponses assurées, conciliantes et bien mises en forme, qui ne sont pas toujours justes.
La conclusion pratique est banale mais vraie : en novembre 2026, les modèles de pointe des deux laboratoires sont assez proches pour que les écarts de benchmark décident rarement d’un vrai flux de travail. Le benchmark qui compte, c’est votre propre flux de travail, mesuré sur les deux.
Confidentialité, dérive et les autres pièges
Deux aspects absents des tableaux de fonctionnalités comptent davantage que la plupart des caractéristiques.
Confidentialité et RGPD. En novembre 2026, les deux éditeurs vous permettent de refuser l’entraînement sur vos conversations grand public : la page tarifaire de ChatGPT affiche « Refus possible » sur chaque forfait individuel, et celle de Claude indique « Opt-out » pour l’entraînement des modèles sur Free, Pro, Max et Ultra. Anthropic a modifié sa politique d’entraînement grand public à l’automne 2025, annoncée le 28 août 2025 : ce dont vous vous souvenez sur le fait que Claude n’entraînait pas sur vos données est peut-être dépassé.
En France, le RGPD ajoute une seconde voie : comme OpenAI fonde l’entraînement sur l’intérêt légitime, vous pouvez vous y opposer au titre de l’article 21, en plus du réglage du produit, et saisir la CNIL d’une réclamation ; l’autorité irlandaise mène toutefois la procédure en chef de file, car les deux services sont exploités en Europe par une société irlandaise.
L’usage professionnel est traité à part : OpenAI indique qu’il n’entraîne pas ses modèles sur les données d’un espace ChatGPT Business, et le changement d’Anthropic ne s’appliquait pas aux services relevant de ses Commercial Terms, API comprise. Pour des données clients ou des secteurs réglementés (santé, juridique, finance), aucune des deux versions grand public ne suffit : il faut une offre professionnelle avec un accord de traitement des données. Vibe (ex-Le Chat) de Mistral est une option française : Mistral indique que les données sont hébergées par défaut dans l’UE, mais que certaines fonctionnalités peuvent entraîner des transferts temporaires hors de l’UE. Pour des données réglementées, vérifiez les garanties du forfait et des fonctionnalités utilisés.
Dérive. Les deux modèles évoluent sans prévenir. De nouvelles versions sortent en permanence, d’anciennes sont retirées, et les utilisateurs signalent régulièrement qu’un modèle semble moins bon après une mise à jour, parfois à raison, parfois par simple effet de perception. On reproche à ChatGPT de sembler aussi sûr de lui qu’il ait raison ou non, et à Claude de vous donner raison, même si notre unique test ci-dessus ne l’a pas montré. Retestez votre propre flux de travail après chaque mise à jour importante plutôt que de vous fier au verdict du trimestre précédent.
Dans quel moteur votre marque doit-elle apparaître ?
Si vous publiez ou commercialisez quoi que ce soit, la question qui rapporte n’est pas l’outil que vous utilisez. C’est celui qui nomme votre marque quand votre client pose la question. ChatGPT et Claude sont désormais tous deux des moteurs de réponse. Les gens leur demandent quel produit acheter, quelle agence engager, quel outil est le meilleur, et la réponse du modèle vous inclut ou non.
Ce n’est pas un comportement marginal, et le cas mesuré le plus net à ce jour concerne la recherche de Google elle-même. Une étude du Pew Research Center de 2025 a montré que, lorsqu’un résumé IA apparaissait dans les résultats de Google, les internautes américains ne cliquaient sur un lien classique que dans 8 % des visites, contre 15 % sans résumé, soit environ moitié moins.
Cette étude porte sur les AI Overviews de Google, pas sur ChatGPT ni Claude. Voyez le même glissement chez les assistants IA comme une hypothèse à mesurer : si davantage de réponses sont consommées sans clic, être dans la réponse compte plus que se positionner en dessous.
Le piège, c’est qu’apparaître dans un moteur ne garantit rien dans un autre, et Gemini et Grok ajoutent d’autres viviers de sources, que nous traitons dans Claude vs Gemini, Gemini vs ChatGPT, Grok vs Claude et Grok vs ChatGPT. Sur la requête elle-même, les AI Overviews de Google s’appuient sur la vidéo et les retours de praticiens : dans les données LLM Mentions de DataForSEO pour les requêtes américaines contenant « claude vs chatgpt », consultées le 6 novembre 2026, YouTube était cité dans 175 mentions, Reddit dans 91, Towards AI dans 74 et Zapier dans 66. Un comparatif clair, daté et doté d’un verdict net se mesure à ces sources, pas d’abord aux pages des éditeurs.
Les deux moteurs reposent sur la même mécanique, celle du fonctionnement de la recherche IA, mais ils la pondèrent différemment : chacun demande sa propre approche.
Pour être cité par l’un ou l’autre, rendez votre page facile à trouver et facile à reprendre : un HTML statique propre qu’un robot d’exploration peut parcourir, des titres formulés en questions, un tableau daté et chaque fait énoncé clairement avec sa source à côté. Notre test de recherche en donne l’exemple concret : GPT-6 Sol a trouvé la page d’aide de l’éditeur à chaque fois, parce qu’une recherche limitée au site pouvait l’atteindre.
Les méthodes complètes figurent dans apparaître dans ChatGPT et être cité par Claude. Une page optimisée uniquement pour le référencement Google classique peut être invisible dans les deux.
Vous ne choisissez pas le modèle qu’ouvre votre client, et le terrain s’élargit au-delà de ces deux-là, avec des challengers à poids ouverts comme Kimi et DeepSeek. Vous ne maîtrisez pas non plus le hasard de chaque réponse : la même question peut vous citer une fois et vous ignorer la suivante.
Ce que vous pouvez faire, c’est faire de votre page la source la plus claire et la plus fiable sur la question, puis mesurer combien de fois chaque moteur vous cite réellement et combler les manques.
Suivre votre part de voix dans l’IA moteur par moteur vaut mieux que deviner.
Comment nous les utilisons, et pourquoi la méthode compte plus que le modèle
Un mot sur l’origine de ce comparatif. Nous dirigeons une agence SEO, développons un outil GEO appelé geotoolbox et faisons de la recherche en sécurité, et l’essentiel de ce travail se fait dans Claude via Claude Code, avec les modèles d’OpenAI pour une seconde passe via Codex. Ce n’est donc pas une comparaison de fiches techniques, mais la façon dont nous les utilisons dans notre propre travail.
Ce que nous avons appris à nos dépens, c’est que le modèle compte moins que la boucle qui l’entoure. Un modèle qui relit son propre travail a tendance à relire son erreur et à la valider, parce que l’angle mort qui a produit l’erreur est le même qui vérifie. La solution est une seconde passe critique, idéalement par une autre famille de modèles, car un modèle différent se trompe à d’autres endroits.
Concrètement, Claude Code construit et les modèles d’OpenAI, via Codex, relisent en lecture seule. Nous traitons chaque remarque de Codex comme une piste à vérifier dans le fichier et dans une source primaire, jamais comme un verdict, car un second modèle se trompe avec aplomb assez souvent pour introduire ses propres erreurs.
C’est pourquoi nous ne publions jamais un premier jet. Qu’il s’agisse d’un article, d’une ligne de code en production ou d’une faille de sécurité, tout passe par plusieurs relectures sévères et indépendantes avant de compter. Cette version a suivi la même boucle : un premier jet, puis des relecteurs indépendants et une passe distincte avec un autre modèle avant publication. Nous opposons volontairement Claude et les modèles d’OpenAI.
Choisissez le modèle adapté à la tâche, puis cessez de faire confiance à une réponse unique. C’est pour la même raison que nous mesurons la visibilité dans l’IA en échantillonnant de nombreuses fois plutôt qu’en nous fiant à une seule vérification.
Claude ou ChatGPT : comment trancher
Choisissez selon la tâche et le forfait, pas selon le classement. Les deux ont une offre gratuite : le moyen le plus économique de trancher pour votre propre travail est de soumettre la même tâche réelle aux deux et de garder celui qui vous bloque le moins.
| Si c’est votre cas | Commencez par | Pourquoi |
|---|---|---|
| Vous rédigez, révisez ou raisonnez sur de longs documents | Claude Pro, 18 € HT | Jusqu’à 1 million de tokens de contexte dans l’application, sur tous les forfaits |
| Vous codez et pouvez dépenser 100 € ou plus par mois | Claude Max ou Ultra avec Claude Code | Souvent cité par les praticiens pour les problèmes difficiles |
| Vous codez avec le budget de l’entrée de gamme | ChatGPT Plus avec Codex, 23 € | Certains praticiens le trouvent plus endurant par tâche ; essayez Claude Pro un mois avant de décider |
| Vous avez besoin d’images ou de la voix | ChatGPT Plus, ou Go à 8 € pour un usage léger | Génération d’images et voix sur tous les forfaits ChatGPT, et la page des forfaits de Claude ne mentionne aucun générateur d’images |
| Vous voulez le niveau le plus élevé | ChatGPT Pro 500 | L’échelle de Claude s’arrête à Ultra, 180 € HT |
| Vous faites tout cela | Les deux forfaits d’entrée | Les praticiens de Reddit conseillent souvent de répartir le travail par tâche |
Pour une entreprise, le calcul est différent et n’a rien à voir avec le modèle le plus intelligent. Vos clients utilisent des assistants différents : la question qui fait bouger le chiffre d’affaires est de savoir lequel vous cite quand quelqu’un s’intéresse à votre catégorie, et comment vous vous situez face à vos concurrents.
C’est le manque que comble geotoolbox. Nous suivons ce que ChatGPT, Claude et les autres moteurs disent et citent réellement à propos de votre marque, moteur par moteur et dans le temps, pour que vous voyiez où vous apparaissez, où un concurrent occupe la réponse et quoi corriger.
Commencez par un score de préparation IA gratuit pour vérifier que ces moteurs peuvent seulement lire votre site, puis suivez votre présence sur l’ensemble des moteurs dans le domain overview. Les modèles continueront de s’échanger la première place. Qu’ils vous mentionnent, c’est la partie sur laquelle vous pouvez agir.
Foire aux questions
Claude est-il meilleur que ChatGPT ?
Cela dépend de la tâche. En novembre 2026, des comparatifs comme celui de Zapier préfèrent Claude pour l’écriture créative, et sa fenêtre de 1 million de tokens convient aux longs documents. La plupart des comparatifs placent ChatGPT devant pour les images, la voix, la recherche rapide et les outils intégrés, et sur le code les praticiens se partagent selon le forfait.
Dans notre court test par API, les modèles ont fait jeu égal sur la réécriture, les contraintes, le code et le retour critique, tandis que GPT-6 Sol trouvait plus sûrement la page de l’éditeur dans les recherches de prix. Beaucoup utilisent les deux et passent de l’un à l’autre selon la tâche.
Claude ou ChatGPT est-il moins cher ?
À l’entrée de gamme, ils coûtent presque pareil : Claude Pro affiche 18 € HT par mois en France, soit 21,60 € TTC, et ChatGPT Plus 23 € (relevés des 7 et 9 novembre 2026). ChatGPT propose aussi une offre gratuite avec chats textuels illimités et un forfait Go à 8 €, qui peut afficher des publicités. En haut de gamme, Claude s’arrête à Max (90 € HT) et Ultra (180 € HT), tandis que ChatGPT Pro démarre à 103 € et compte trois niveaux (Pro 100, Pro 200 et Pro 500).
La différence pratique la plus importante tient aux limites d’usage. Claude décompte tout sur des fenêtres de 5 heures et hebdomadaires (les comptes Ultra vérifiés n’ont pas de fenêtre de 5 heures, seulement des limites hebdomadaires), OpenAI décompte Codex de la même manière, ChatGPT laisse le chat courant illimité sous garde-fous anti-abus, et les gros utilisateurs de l’un comme de l’autre peuvent buter sur la limite. Sur l’API, les prix au token varient selon le modèle et changent souvent : vérifiez ceux de chaque fournisseur avant de budgéter.
Devrais-je passer de ChatGPT à Claude ?
Le plus souvent, mieux vaut ajouter que remplacer. Ils excellent dans des domaines différents et ont tous deux une offre gratuite : vous ne perdez rien à garder ChatGPT pour les images, la voix et la polyvalence tout en essayant Claude pour la rédaction et les longs documents. Ne basculez complètement que si votre travail relève presque entièrement des points forts d’un modèle et que les limites d’usage ou les manques de l’autre vous gênent vraiment.
Le moteur dans lequel ma marque apparaît a-t-il de l’importance ?
Oui, car vos clients utilisent des assistants différents, et être mentionné dans l’un ne garantit pas de l’être dans les autres. À mesure que les gens obtiennent plus de réponses sans cliquer, la présence dans la réponse devient la visibilité qu’apportait autrefois le classement. La démarche concrète consiste à mesurer combien de fois chaque moteur vous cite, moteur par moteur et dans le temps, et à combler les manques plutôt que de deviner.
Sources
- Anthropic, IA constitutionnelle : la sécurité à partir des retours d’IA -
anthropic.com/research/constitutional-ai-harmlessness-from-ai-feedback - OpenAI, Aperçu des robots OpenAI (GPTBot, OAI-SearchBot, ChatGPT-User) -
developers.openai.com/api/docs/bots - Anthropic, Modèles Claude : versions actuelles, fenêtres de contexte, dates limites de connaissances -
platform.claude.com/docs/en/about-claude/models/overview - Anthropic, Tarifs, page française, consultée le 9 novembre 2026 depuis la France, sans connexion (euros hors taxes) -
claude.com/fr/pricing - Anthropic Help Center, What is the Ultra plan?, What is the Max plan?, What is the Pro plan?, What is the Team plan? (modifiées le 30 octobre 2026), modèles Claude Fable sur votre forfait (modifiée le 9 novembre 2026), offres de lancement de Claude Fable 5.2 (consultées le 9 novembre 2026) -
support.claude.com/en/articles/17728952-what-is-the-ultra-plan - Anthropic, Mise à jour des conditions d’utilisation grand public, 28 août 2025 -
anthropic.com/news/updates-to-our-consumer-terms - OpenAI, Forfaits et tarifs ChatGPT, page française, consultée le 7 novembre 2026 depuis une adresse IP française -
chatgpt.com/fr-FR/pricing - OpenAI Help Center, Notes de version de ChatGPT (entrées des 11, 22 et 29 septembre, des 7, 15, 26 et 29 octobre et du 4 novembre 2026) -
help.openai.com/en/articles/6825453-chatgpt-release-notes - OpenAI Help Center, About ChatGPT Pro tiers ; What is ChatGPT Plus? ; ChatGPT Business overview -
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - OpenAI Help Center, Ads in ChatGPT -
help.openai.com/en/articles/20001047-ads-in-chatgpt - OpenAI Help Center, Using Codex with your ChatGPT plan ; Custom GPT retirement and migration FAQ -
help.openai.com/en/articles/11369540-using-codex-with-your-chatgpt-plan - OpenAI, API credits for ChatGPT subscribers -
developers.openai.com/api/docs/guides/chatgpt-api-credits - OpenAI, Pages modèles de GPT-6 Astra, GPT-6 Sol et GPT-6 Luna -
developers.openai.com/api/docs/models/gpt-6-astra.md - Menlo Ventures, 2026: The State of Enterprise AI, 3 novembre 2026 -
menlovc.com/perspective/2026-the-state-of-enterprise-ai - Menlo Ventures, 2026: The State of Consumer AI, 16 septembre 2026 -
menlovc.com/perspective/2026-the-state-of-consumer-ai - Zapier, Claude vs. ChatGPT: Which is best? -
zapier.com/blog/claude-vs-chatgpt - DataForSEO, API LLM Mentions (sources des AI Overviews de Google pour les requêtes contenant « claude vs chatgpt », États-Unis), consultée le 6 novembre 2026 -
dataforseo.com/apis/ai-optimization-api - MacRumors, Anthropic Debuts Claude Design, 17 avril 2026 -
macrumors.com/2026/04/17/anthropic-claude-design - Reddit, r/ChatGPT, I switched back to ChatGPT from Claude, septembre 2026 -
reddit.com/r/ChatGPT/comments/1w79n3c - Mistral AI Help Center, Where do you store my data? -
help.mistral.ai/en/articles/347629-where-do-you-store-my-data-or-my-organization-s-data - leto.legal, Claude, Anthropic et RGPD : conformité 2026 -
leto.legal/guides/claude-anthropic-rgpd-conformite-2026 - SWE-bench, benchmark de génie logiciel -
swebench.com - Arena, classement LLM par préférence humaine, instantané du 27 octobre 2026 -
arena.ai/leaderboard/text - Pew Research Center, Les internautes cliquent moins sur les liens quand un résumé IA apparaît -
pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results - Anthropic, Claude Opus 5.5, 22 septembre 2026 -
anthropic.com/news/claude-opus-5-5 - Anthropic, Fiches système de Claude Opus 5.5 (22 septembre 2026) et Claude Opus 5 (24 juillet 2026) -
anthropic.com/claude-opus-5-5-system-card,anthropic.com/claude-opus-5-system-card - OpenAI, GPT-6 Astra, 3 septembre 2026 -
openai.com/index/gpt-6-astra - Équipe OSWorld, classement OSWorld 2.0 -
osworld-v2.xlang.ai - OpenAI, Introducing GPT-6 Sol and Luna, 22 septembre 2026 -
openai.com/index/introducing-gpt-6-sol-and-luna