
Claude Fable 5.2 est arrivé le 9 novembre 2026 avec un prix en baisse et des performances de pointe supérieures à celles du modèle qu’il remplace. Il coûte 20 % de moins par token que Fable 5.1 et prend la tête de 2 des 4 premiers classements indépendants.
Ce qu’il vous coûtera dépend pourtant d’un réglage, l’effort, qui fixe le temps que le modèle passe à réfléchir avant de répondre. Sur FrontierCode, le benchmark de Cognition repris dans la System Card d’Anthropic, le niveau d’effort le plus élevé coûte plus de 20 fois le prix du plus bas pour une même tâche.
En effort low, le nouveau modèle bat le meilleur score de son prédécesseur pour moins d’un tiers du coût. Aux réglages les plus élevés, la facture monte, alors que chaque token coûte moins cher.
Ce qu’il faut retenir
- Claude Fable 5.2, sorti le 9 novembre 2026, est le modèle le plus puissant qu’Anthropic propose au grand public : il coûte 8 $ par million de tokens en entrée et 40 $ en sortie sur l’API, soit 20 % de moins que Fable 5.1.
- Le niveau d’effort pèse plus sur la facture que la baisse de prix : sur FrontierCode 2.0, selon la System Card d’Anthropic, le coût moyen par tâche de Fable 5.2 va de 2,10 $ en effort low à 44,70 $ en max, et le meilleur score est obtenu en xhigh (49,1 %).
- Dans les relevés des 9 et 10 novembre 2026, Fable 5.2 est premier sur l’Intelligence Index d’Artificial Analysis (65) et sur le Vals Index (71,31 %), ex aequo avec Opus 5.5 sur le Terminal-Bench 4.0 de Vals et 6e sur GDPval-AA ; Anthropic recommande de commencer par Opus 5.5 pour la plupart des tâches.
- En France, Fable est inclus en permanence à partir de la formule Max (90 € HT par mois, 108 € TTC) ; sur Pro (18 € HT, 21,60 € TTC), il est inclus du 9 novembre au 17 novembre 2026 à 8 h 59, heure de Paris, puis facturé en crédits d’usage.
- Les garde-fous de Fable 5.2 renvoient les demandes signalées vers Opus 4.8 ou Opus 5, et le modèle exige une conservation des données de 30 jours, sans zone d’inférence européenne sur l’API Claude au 10 novembre 2026.
Qu’est-ce que Claude Fable 5.2 ?
Claude Fable 5.2 est le modèle le plus puissant qu’Anthropic propose au grand public. Il est sorti le 9 novembre 2026, en même temps qu’un jumeau à accès restreint, Claude Mythos 5.2. Il remplace Fable 5.1 et vise le travail technique long et difficile : sessions d’agents de plusieurs heures, migrations de grandes bases de code, recherche et analyse approfondies.
Fable et Mythos sont un seul et même modèle. D’après l’annonce de lancement d’Anthropic, Fable est la version dotée de garde-fous renforcés en cybersécurité et en biologie, ce qui permet à Anthropic de la proposer à tout le monde.
Mythos 5.2 offre les mêmes capacités sans une partie de ces garde-fous. Il est réservé aux organisations admises dans les programmes de vérification d’Anthropic.
Anthropic ne conseille pas Fable à la plupart des utilisateurs. Sa recommandation : commencer par Claude Opus 5.5 pour l’essentiel du code et du travail de bureau, et ne passer à Fable que pour une tâche ambitieuse et ouverte. Fable se situe au-dessus d'Opus dans la gamme Claude.
| Caractéristique | Claude Fable 5.2 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Identifiant API | claude-fable-5-2 | claude-opus-5-5 | claude-sonnet-5-5 |
| Fenêtre de contexte | 1 million de tokens | 1 million de tokens | 1 million de tokens |
| Sortie maximale | 128 000 tokens | 128 000 tokens | 128 000 tokens |
| Date de coupure des connaissances | Juin 2026 | Juin 2026 | Juin 2026 |
| Prix (entrée / sortie, par million de tokens) | 8 $ / 40 $ | 4 $ / 20 $ | 2 $ / 10 $ |
| Réflexion | Adaptative, toujours active | Adaptative, toujours active | Adaptative |
| Effort par défaut sur l’API | high | medium | high |
| Latence (appréciation d’Anthropic) | Modérée | Modérée | Rapide |
Ces caractéristiques viennent de la présentation des modèles d’Anthropic. Le modèle est disponible sur l’API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry, ainsi que dans les applications Claude et dans Claude Code avec une formule payante.
Les modèles Fable et Mythos suivent leur propre numérotation (5, 5.1, 5.2), distincte de la génération 5.5 d’Opus, Sonnet et Haiku ; l’annonce de lancement n’en donne pas la raison. Notre suivi de Fable 5.5 revient sur les rumeurs qui annonçaient un autre nom.
Ce qui change par rapport à Fable 5.1
Fable 5.2 coûte moins cher par token, génère ses réponses plus vite, bloque moins de demandes et se dote d’un mode rapide. Les caractéristiques de base n’ont pas bougé : 1 million de tokens de contexte, 128 000 tokens en sortie, la même date de coupure des connaissances.
| Élément | Fable 5.1 (1er septembre 2026) | Fable 5.2 (9 novembre 2026) |
|---|---|---|
| Prix en entrée / en sortie | 10 $ / 50 $ par million de tokens | 8 $ / 40 $ par million de tokens |
| Lecture du cache | 0,25 $ par million de tokens | 0,20 $ par million de tokens |
| Mode rapide | Aucun tarif indiqué | 16 $ / 80 $, sortie jusqu’à 2,5 fois plus rapide |
| Vitesse de génération | Référence | Jusqu’à 30 % plus rapide (selon Anthropic) |
| Blocages par les garde-fous | Référence | Environ 55 % de moins lors des premiers tests (Anthropic) |
| Pas de retrait avant le | 1er septembre 2027 | 9 novembre 2027 |
Les chiffres de vitesse et de blocages viennent de l’annonce d’Anthropic : ce sont des données du fournisseur. « Jusqu’à 30 % plus rapide » est un plafond qui porte sur la vitesse de génération, et ne dit rien de la durée d’une tâche entière.
La baisse d’environ 55 % des blocages a été mesurée lors des premiers tests d’Anthropic sur claude.ai, Claude Code et Cowork : environ 60 % de blocages en moins en cybersécurité et 40 % en biologie.
Les anciens modèles restent en service. La page des retraits de modèles d’Anthropic indique que Fable 5.1 est actif et ne sera pas retiré avant le 1er septembre 2027, et que le Fable 5 d’origine l’est aussi, sans retrait avant le 9 juin 2027.
Les 3 modèles restent accessibles avec une formule payante, sous réserve des réglages des administrateurs sur Team et Enterprise. Notre analyse de Fable 5.1 reste en ligne comme archive de ce lancement.
Le 12 juin 2026, une directive américaine de contrôle des exportations a conduit Anthropic à désactiver le Fable 5 d’origine pour tous ses clients. Le modèle est revenu le 1er juillet 2026, une fois ces contrôles levés. Notre article sur l’interdiction de Fable 5 retrace cet épisode.
Prix de Claude Fable 5.2 : tarifs de l’API, mode rapide, cache et Batch
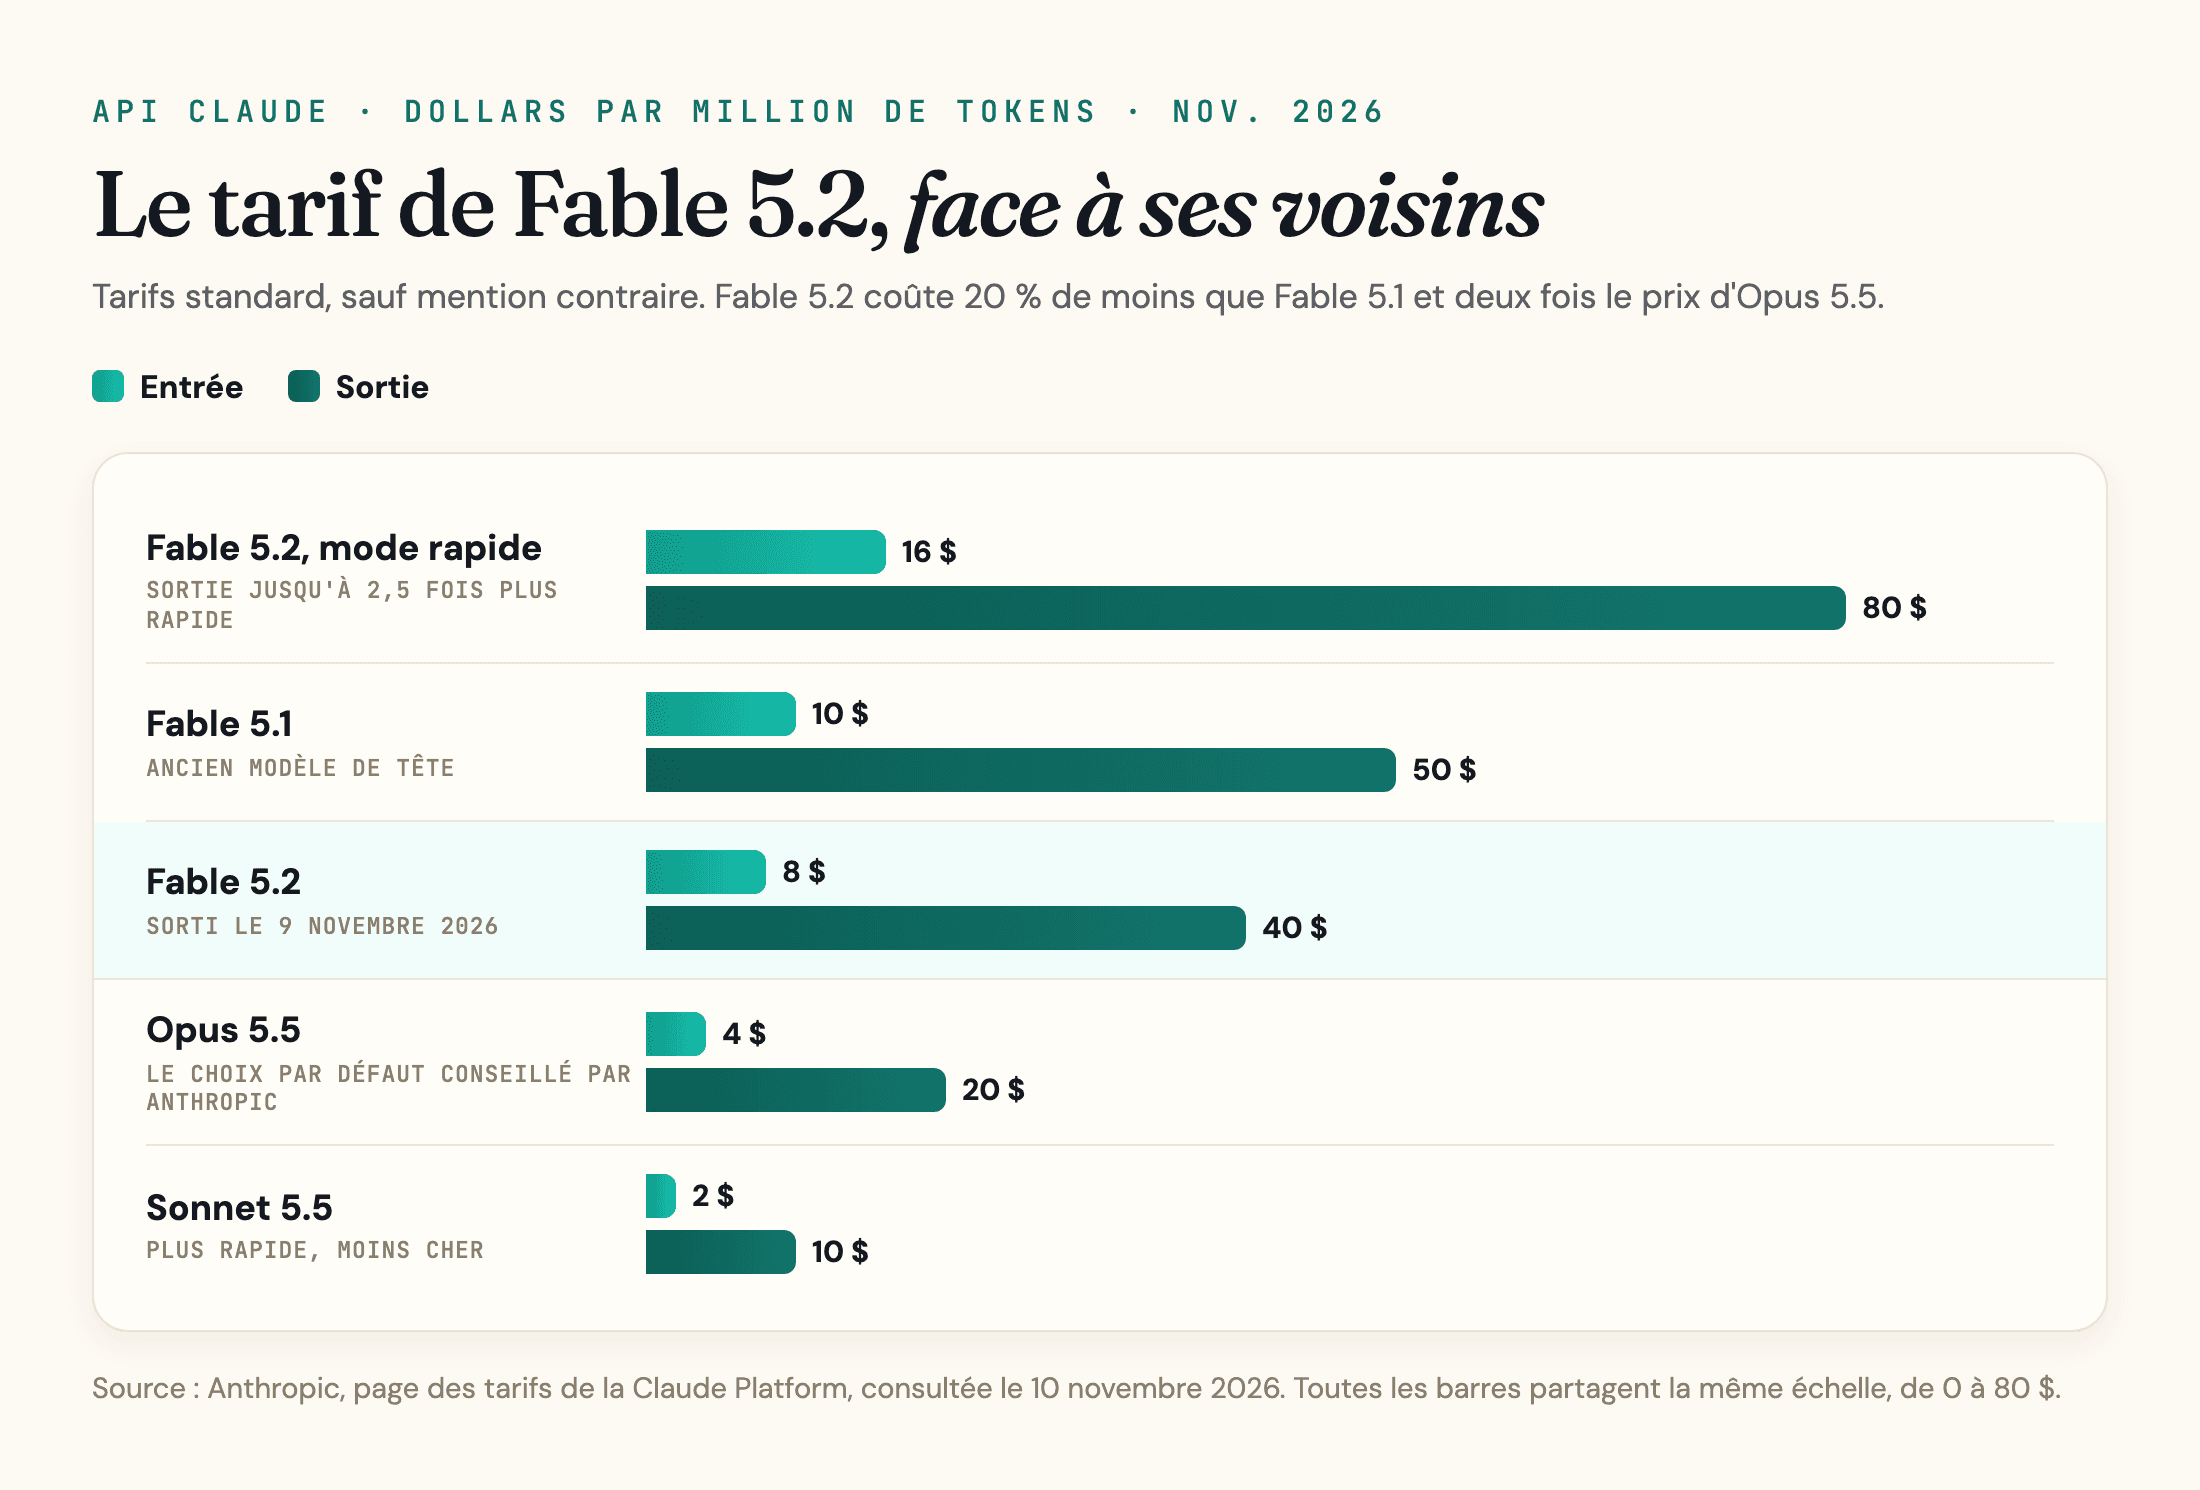
Fable 5.2 coûte 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie, soit 20 % de moins que les 10 $ et 50 $ de Fable 5.1. Tous les tarifs associés ont baissé dans la même proportion, comme le montre la page des tarifs d’Anthropic. Ces tarifs sont publiés en dollars.
| Tarif (par million de tokens) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Entrée | 8 $ | 10 $ | 4 $ |
| Sortie | 40 $ | 50 $ | 20 $ |
| Écriture en cache, 5 minutes | 10 $ | 12,50 $ | 5 $ |
| Écriture en cache, 1 heure | 16 $ | 20 $ | 8 $ |
| Lecture du cache | 0,20 $ | 0,25 $ | 0,20 $ |
| Mode rapide, entrée / sortie | 16 $ / 80 $ | Aucun tarif indiqué | 8 $ / 40 $ |
La surprise de ce tableau, c’est la lecture du cache. Fable 5.2 et Opus 5.5 y sont au même tarif : 0,20 $ par million de tokens lus en cache. Pour un agent qui renvoie un long prompt stable à chaque tour, l’écart entre Fable et Opus se révèle plus faible que ne le laissent penser les prix catalogue.
L’API Batch accorde 50 % de remise sur l’entrée et la sortie. Fable 5.2 en lot revient ainsi à 4 $ et 20 $, le prix d’Opus 5.5 en temps réel. Opus 5.5 en lot coûte encore moitié moins.
La fenêtre de contexte complète d’un million de tokens se facture au tarif standard, sans supplément pour les longs prompts. Sur l’API Claude, l’option d’inférence limitée aux États-Unis multiplie les tarifs par 1,1.
Un travail de 10 millions de tokens en entrée et 1 million en sortie coûte 120 $ sur Fable 5.2, 150 $ sur Fable 5.1 et 60 $ sur Opus 5.5, ou 240 $ sur Fable 5.2 en mode rapide. Ce calcul suppose que chaque modèle consomme le même nombre de tokens. Le niveau d’effort fait tomber cette hypothèse : c’est l’objet de la section suivante.
Le mode rapide (fast mode) a ses conditions. Il ne se combine pas avec l’API Batch. Il est proposé sur l’API Claude, dans Claude Code, sur Google Cloud et sur les déploiements Microsoft Foundry hébergés par Anthropic ; Amazon Bedrock ne figure pas dans cette liste.
Dans Claude Code avec un abonnement, la documentation du mode rapide précise qu’il se paie uniquement en crédits d’usage, et que l’activer en cours de conversation refacture tout le contexte déjà échangé au tarif du mode rapide, sans bénéficier du cache.
Pour comparer les prix par modèle chez tous les fournisseurs, consultez notre référence du coût des tokens et notre guide complet des prix de Claude.
Le piège du coût par tâche : c’est l’effort qui fait la facture
Une baisse de 20 % par token ne donne pas une facture 20 % plus légère. Fable 5.2 propose 5 niveaux d’effort (low, medium, high, xhigh et max). Plus l’effort est élevé, plus le modèle réfléchit, plus il appelle d’outils et plus il consomme de tokens : le niveau choisi pèse bien plus sur le coût d’une tâche que la baisse de prix.
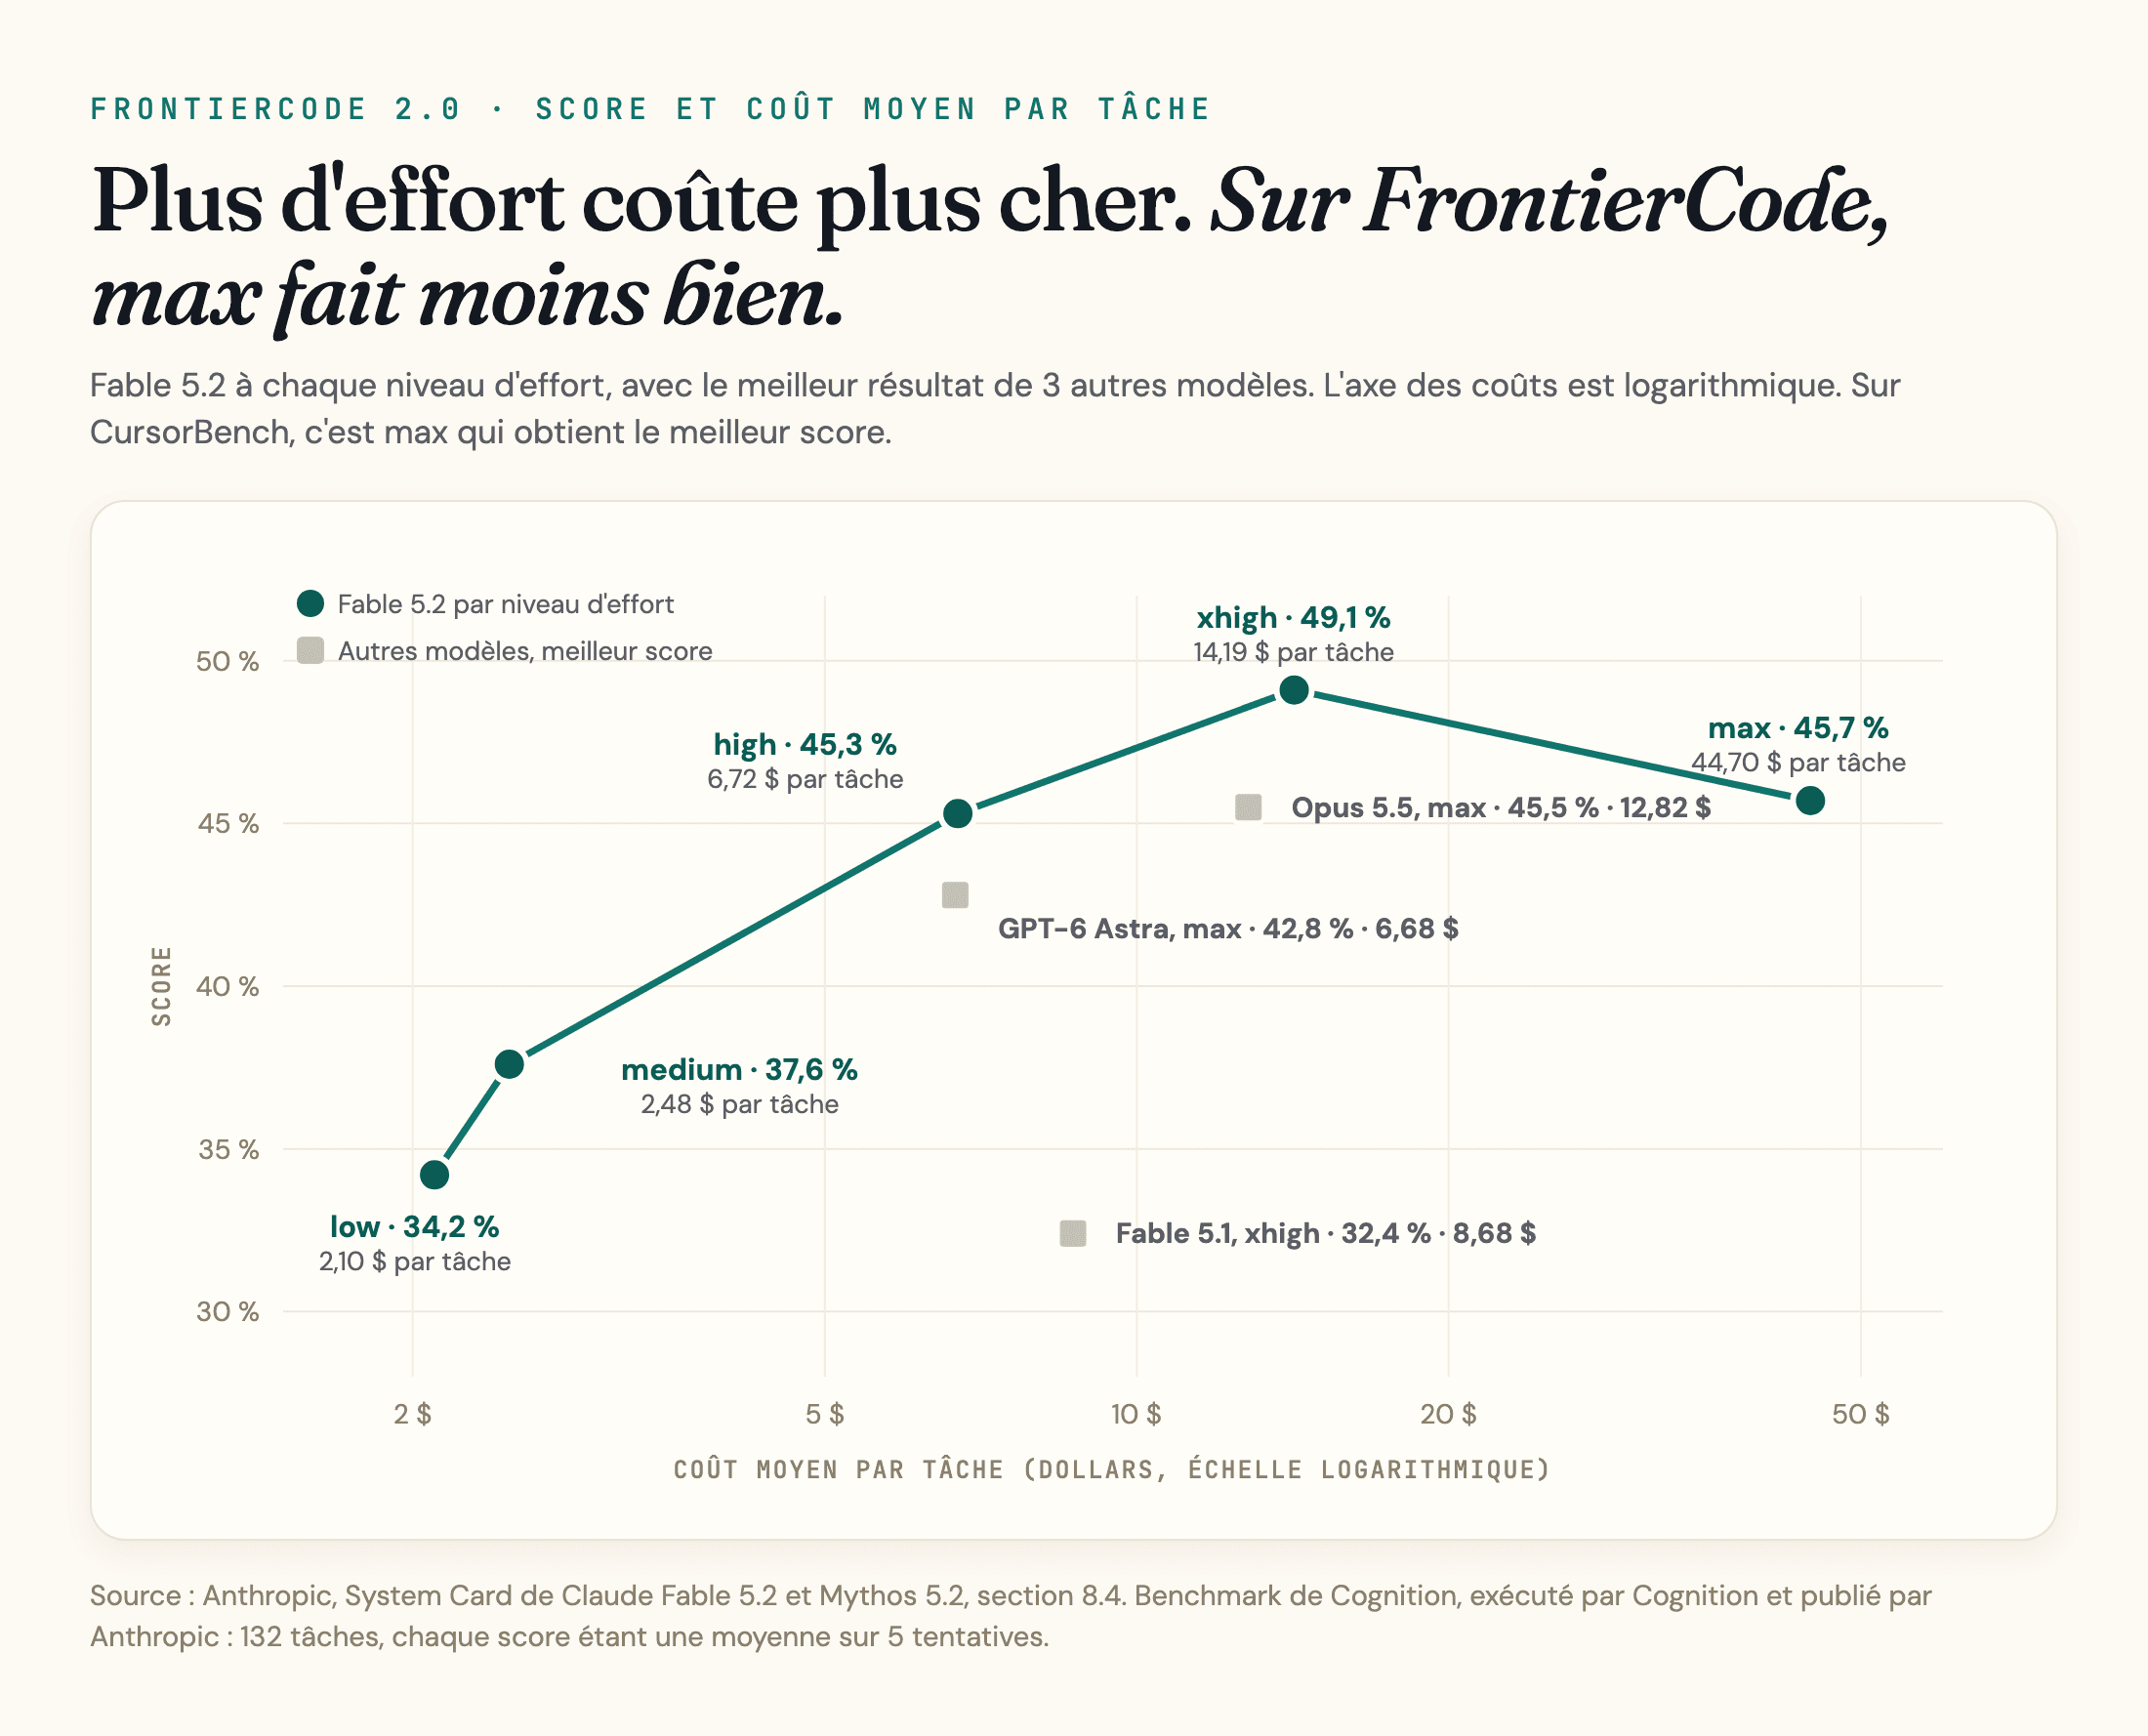
La démonstration la plus nette se trouve dans la System Card d’Anthropic, la fiche technique du modèle. Sur FrontierCode 2.0, le coût moyen par tâche de Fable 5.2 grimpe de 2,10 $ en effort low à 44,70 $ en max, et le score culmine un cran plus tôt, en xhigh.
| Modèle et effort | Score FrontierCode 2.0 | Coût moyen par tâche |
|---|---|---|
| Fable 5.2, low | 34,2 % | 2,10 $ |
| Fable 5.2, medium | 37,6 % | 2,48 $ |
| Fable 5.2, high | 45,3 % | 6,72 $ |
| Fable 5.2, xhigh | 49,1 % | 14,19 $ |
| Fable 5.2, max | 45,7 % | 44,70 $ |
| Opus 5.5, max (son meilleur score) | 45,5 % | 12,82 $ |
| GPT-6 Astra, max (son meilleur score) | 42,8 % | 6,68 $ |
| Fable 5.1, xhigh (son meilleur score) | 32,4 % | 8,68 $ |
Source : System Card d’Anthropic, section 8.4. FrontierCode est le benchmark de Cognition : 132 tâches, chaque score étant une moyenne sur 5 tentatives par tâche. Cognition l’a exécuté et Anthropic l’a publié, sans intervalle d’incertitude.
Cognition publie aussi son propre classement FrontierCode. Relevé le 10 novembre 2026, il donne à Fable 5.2 les mêmes scores en high et en xhigh, mais un coût plus élevé à chaque niveau d’effort : 2,62 $ en low, 3,10 $ en medium, 8,40 $ en high, 17,73 $ en xhigh et 55,87 $ en max.
Les coûts d’Opus 5.5, de GPT-6 Astra et de Fable 5.1 y sont les mêmes que dans la System Card. Les comparaisons de coût qui suivent reprennent les chiffres de la System Card.
Face à Fable 5.1 et à Opus 5.5, Fable 5.2 égale leurs meilleurs résultats pour moins cher. En effort low, il dépasse déjà le meilleur score de Fable 5.1 (34,2 % contre 32,4 %) pour 2,10 $ la tâche au lieu de 8,68 $.
En effort high, il arrive à 0,2 point du meilleur score d’Opus 5.5 pour environ la moitié du coût, et dépasse de 2,5 points le meilleur résultat de GPT-6 Astra pour un coût presque identique.
Avec les chiffres de Cognition, l’avantage se réduit : Fable en high coûte environ les deux tiers de ce que coûte Opus 5.5 à son meilleur score (12,82 $), et environ un quart de plus que GPT-6 Astra à son meilleur score (6,68 $).
À réglage égal, la facture peut monter. En xhigh, Fable 5.2 obtient 16,7 points de plus que Fable 5.1 et coûte 14,19 $ par tâche là où son prédécesseur en coûtait 8,68 $. Si vous gardez le même niveau d’effort et changez seulement de modèle, attendez-vous à payer plus pour un meilleur résultat.
Sur ce benchmark, max vaut rarement son prix. Il coûte plus de 3 fois le prix de xhigh pour un score inférieur.
Ce dernier constat ne se généralise pas. Sur CursorBench 4.0, dans la même System Card, max fait mieux que xhigh (60,0 % contre 56,3 %), et sur l’Intelligence Index d’Artificial Analysis, cité plus bas, max (65) devance xhigh (62) de 3 points. Ce qui se vérifie d’un benchmark à l’autre : le dernier cran est le plus cher.
Artificial Analysis publie le coût moyen par tâche de son Intelligence Index, ce qui permet de refaire la démonstration avec des données indépendantes. Voici son classement, relevé le 10 novembre 2026 :
| Modèle et effort | Intelligence Index | Coût par tâche de l’indice |
|---|---|---|
| Fable 5.2, max | 65 | 26,54 $ |
| Fable 5.2, xhigh | 62 | 14,83 $ |
| Fable 5.2, high | 62 | 9,08 $ |
| Fable 5.2, medium | 56 | 3,80 $ |
| Gemini 4 Carbon, high | 60 | 7,76 $ |
| Opus 5.5, max | 59 | 10,04 $ |
| Opus 5.5, medium | 48 | 2,45 $ |
| GPT-6 Astra, max | 57 | 6,24 $ |
Fable 5.2 en high devance Opus 5.5 en max pour un coût par tâche un peu inférieur. Passer de high à max rapporte 3 points de plus et triple presque le coût, et xhigh n’apporte rien de plus que high sur cet indice. Au réglage medium de chaque modèle, Fable coûte environ 1,5 fois le prix d’Opus par tâche, et non le double.
Artificial Analysis a testé Fable avec le repli par défaut d’Anthropic activé, et l’a trouvé lent en max : 44,6 minutes par tâche de l’indice, contre une médiane de 12,7 minutes pour des modèles comparables.
Quel niveau choisir ? Le réglage par défaut est medium dans les applications Claude et dans Claude Code, et high sur l’API.
Dans ses notes de version de Fable 5.2, Anthropic conseille de commencer en high, de ne monter en xhigh que là où vous avez mesuré un gain, et de réserver max aux tests qui sondent les limites du modèle et aux rares tâches où ni le temps ni les tokens ne comptent. Notre guide pour réduire le coût en tokens de Claude Code détaille les autres leviers.
Benchmarks de Fable 5.2 : chiffres d’Anthropic et classements indépendants
Fable 5.2 est en tête de la plupart des benchmarks publiés par Anthropic. Les premiers classements indépendants vont globalement dans le même sens, avec des écarts plus faibles, et deux classements d’Artificial Analysis (GDPval-AA et AA-Briefcase) le placent derrière Opus 5.5.
Les lignes ci-dessous sont extraites du tableau de l’annonce de lancement d’Anthropic. Ce sont des chiffres du fournisseur :
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (code agentique) | 49,1 % | 32,4 % | 45,5 % | 42,8 % | 41,1 % |
| FrontierSWE v2 (code agentique) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench (processus d’entreprise) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| Terminal-Bench-Science 0.1 | 74,6 % | 52,6 % | 58,7 % | 68,1 % | 64,8 % |
| Remote Labor Index (travail de bureau) | 41,3 % | 17,9 % | 21,3 % | 20,8 % | n. d. |
| WANDR (recherche agentique, notation souple) | 82,1 % | 68,7 % | 72,3 % | n. d. | n. d. |
| OSWorld 2.1 (tâches hors ligne, score partiel) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| Humanity’s Last Exam (avec outils) | 74,2 % | 65,6 % | 67,7 % | 57,2 % | n. d. |
| Chartography (lecture de graphiques, sans outils) | 73,4 % | 44,8 % | 64,4 % | 71,0 % | 72,5 % |
| RoboDojo Sim (robotique) | 64,9 % | 27,6 % | 39,4 % | 29,8 % | n. d. |
| AA-Briefcase v1.1 (grille / Elo) | 66,1 % / 1785 | 61,5 % / 1669 | 61,2 % / 1800 | 52,0 % / 1569 | 61,8 % / 1611 |
Ce tableau se lit avec 5 réserves :
- L’effort et l’outillage varient d’un modèle à l’autre. Anthropic présente chaque modèle à son niveau d’effort le plus élevé, sauf mention contraire. Sur FrontierCode, Fable a tourné en xhigh et Gemini 4 Carbon en medium, et le modèle de chaque laboratoire a été exécuté dans l’outil de code de ce laboratoire.
- Le chiffre d’OSWorld est un score partiel. La System Card indique, pour le même test, un taux de réussite strict de 54,6 % pour Fable 5.2, contre 53,2 % pour Opus 5.5.
- Fable n’est pas en tête sur toutes les lignes. Gemini 4 Carbon est devant sur AutomationBench, 53,9 % contre 51,4 %. Dans ce tableau, Opus 5.5 est devant sur le score Elo d’AA-Briefcase, 1800 contre 1785, alors que Fable obtient la meilleure note sur la grille d’évaluation de ce test. Sur le classement en direct d’Artificial Analysis, Sonnet 5.5 (1816) et Opus 5.5 (1801) sont tous deux devant Fable (1785) au 10 novembre 2026.
- Le contexte long ne lui donne pas l’avantage. Sur ProgramBench, un test de code exécuté dans une seule fenêtre d’un million de tokens, la System Card place Fable 5.2 à 85,6 %, sous Fable 5.1 (87,6 %) et Opus 5.5 (91,2 %). Fable 5.2 a épuisé son contexte sur 68 % des tâches. Quand on lui indiquait le contexte restant, il atteignait 91,6 %.
- RoboDojo est une simulation, exécutée par Anthropic.
L’annonce met aussi en avant des prouesses qu’aucun tableau ne résume, sans en chiffrer le coût :
- Une équipe de 1 000 agents a formalisé la démonstration du dernier théorème de Fermat en 30 heures. La System Card précise que l’exercice a tourné sur une version antérieure du modèle et s’est appuyé sur les définitions d’une formalisation précédente.
- Le modèle a résolu 2 problèmes ouverts de la physique des trous noirs.
- Il a conçu 3 appareils électroniques fonctionnels avec Diode, une société spécialisée dans les circuits imprimés.
Passons aux classements indépendants, tous relevés les 9 et 10 novembre 2026 :
| Classement indépendant | Fable 5.2 | Autres modèles du classement | Relevé le |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 65 (effort max), 1er | 60 pour Gemini 4 Carbon (high), 59 pour Opus 5.5 (max), 57 pour GPT-6 Astra (max) | 10 novembre 2026 |
| Vals Index | 71,31 %, 1er | 70,85 % pour Sonnet 5.5, 70,45 % pour Gemini 4 Carbon, 70,14 % pour Opus 5.5, 65,02 % pour GPT-6 Astra | 9 novembre 2026 |
| Terminal-Bench 4.0 (Vals) | 65,15 %, 1er ex aequo | 65,15 % pour Opus 5.5, 64,14 % pour Sonnet 5.5 | 9 novembre 2026 |
| GDPval-AA v2.1 d’Artificial Analysis (Elo) | 1831 (effort max), 6e | 1866 pour Opus 5.5 (max), 1861 pour Kimi K3.1 Pro, 1857 pour Muse Wonder Full (max), 1838 pour Sonnet 5.5 (max), 1835 pour Opus 5.5 (xhigh) | 10 novembre 2026 |
Fable 5.2 est premier sur 2 de ces 4 classements, ex aequo sur un troisième et 6e sur le quatrième. Les écarts restent faibles. Sur le Vals Index, qui pondère des tâches de finance, de code, de droit et de fiscalité, son avance sur Sonnet 5.5 est inférieure à un demi-point. Sur le Terminal-Bench 4.0 de Vals, il fait exactement jeu égal avec Opus 5.5.
Artificial Analysis fait tourner sa propre version de Terminal-Bench 4.0 : au 10 novembre 2026, Fable 5.2 (max) y obtient 59,6 %, à égalité avec Opus 5.5 à la 4e place, derrière Kimi K3.1 Pro (67,2 %), Gemini 4 Carbon (65,2 %) et Sonnet 5.5 (63,6 %).
Sur GDPval-AA v2.1, le classement d’Artificial Analysis consacré à des tâches professionnelles réelles, Opus 5.5 est devant, même si les intervalles de confiance des 2 scores se recoupent.
Côté classements indépendants, l’avance la plus nette se lit sur l’indice d’Artificial Analysis : 5 points devant le deuxième, Gemini 4 Carbon, et 8 devant GPT-6 Astra. Notre classement des meilleurs modèles d’IA suit l’évolution de ces tableaux.
Fable 5.2 ou Opus 5.5 : lequel choisir
Pour la plupart des usages, restez sur Opus 5.5. C’est la recommandation d’Anthropic : sa documentation conseille de commencer par Opus 5.5 et de ne passer à Fable 5.2 que si vos évaluations sur Opus, à un effort plus élevé, restent insuffisantes.
Les données ci-dessus montrent pourquoi le choix se fait au cas par cas. Sur certains tests, Fable à un réglage bas égale le meilleur résultat d’Opus pour moins cher : d’après Anthropic, Fable en medium atteint le meilleur score d’Opus 5.5 sur WANDR pour environ 40 % du coût par tâche.
Sur le Terminal-Bench 4.0 de Vals, c’est Opus qui l’emporte sur le coût : les 2 modèles sont à égalité à 65,15 %, et Fable a coûté 14,56 $ par test contre 12,04 $ pour Opus. Le Vals Index dit l’inverse : Fable y devance Opus d’un peu plus de 1 point (71,31 % contre 70,14 %) pour 17,94 $ par test contre 24,77 $.
| Votre travail | Commencez par | Pourquoi |
|---|---|---|
| Code au quotidien, revues de code, travail de bureau | Opus 5.5 | Le choix par défaut indiqué par Anthropic, à la moitié du prix catalogue de Fable 5.2 |
| Longues sessions d’agents sans supervision, grandes migrations | Opus 5.5 à un effort plus élevé, puis Fable 5.2 en high | Fable en high arrive à 0,2 point du meilleur résultat d’Opus 5.5 sur FrontierCode pour environ la moitié du coût par tâche (chiffres de la System Card) |
| Problèmes difficiles où Opus échoue encore en xhigh ou en max | Fable 5.2 en xhigh | Le score FrontierCode 2.0 le plus élevé qu’Anthropic rapporte pour un modèle commercialisé |
| Gros volumes, tâches sensibles à la latence | Sonnet 5.5 ou Haiku 5.5 | Anthropic juge la latence de Fable « modérée », et son prix se justifie surtout par la profondeur de raisonnement |
| Recherche en sécurité, travail sur des exploits, recherche en biologie | Mythos 5.2, si votre organisation est vérifiée | Les garde-fous de Fable bloquent l’essentiel de ce travail (voir plus bas) |
Anthropic décrit aussi une voie intermédiaire : Fable 5.2 en conseiller, que Haiku, Sonnet ou Opus consultent sur les problèmes les plus difficiles, ou en orchestrateur, qui confie les tâches simples à des modèles plus petits. Les notes de version préviennent que Fable 5.2 délègue volontiers dès que l’outillage qui le pilote l’y invite, et que les sous-agents peuvent représenter une grande part du coût d’une session.
Fable 5.2 vaut-il son prix, alors ? Pour un travail agentique long et difficile, souvent oui, mais seul un essai sur vos propres tâches le dira : lancez d’abord Opus 5.5 à un effort plus élevé puis, s’il ne suffit pas, Fable 5.2 en high, et comparez à la fois le résultat et la facture.
Accès par formule, limites d’usage et offres de lancement
Fable 5.2 est disponible dans toutes les formules payantes de Claude, et absent de la formule Free. Il n’est le modèle par défaut d’aucune formule : vous le choisissez dans le sélecteur de modèle, même si un réglage par défaut déjà placé sur un modèle Fable peut basculer vers lui automatiquement. La façon de le payer dépend de la formule.
En dehors des offres de lancement, la page d’aide d’Anthropic sur les modèles Fable répartit les abonnés en 2 groupes :
- Max, Ultra et sièges premium des formules Team et Enterprise facturées au siège : les modèles Fable sont inclus, jusqu’à 50 % de vos limites d’usage hebdomadaires. Ils consomment ces limites plus vite que les autres modèles Claude.
- Pro et sièges standard des formules Team et Enterprise facturées au siège : les modèles Fable ne sont pas inclus. Ils se paient à la consommation, en crédits d’usage (« crédits d’utilisation » dans le centre d’aide en français), que vous ou votre organisation devez activer.
Ces 50 % plafonnent la part de Fable et ne s’ajoutent pas à votre limite : votre usage des autres modèles puise dans la même enveloppe hebdomadaire.
Avec des sous-agents, les limites peuvent partir très vite, y compris celle de cinq heures. Sur le forum HardWare.fr, Feitan21 raconte le 10 novembre 2026, en plein échange sur Fable 5.2, lui avoir fait auditer son application principale : « 11 sous-agents, j’explose ma limite de 5h en 20min. »
En France, Anthropic affiche ses formules en euros hors taxes et ajoute 20 % de TVA. D’après son interface de facturation, relevée le 10 novembre 2026, Pro coûte 18 € HT par mois (21,60 € TTC), ou 180 € HT par an en facturation annuelle, soit 15 € HT par mois. Max coûte 90 € HT (108 € TTC) et Ultra 180 € HT (216 € TTC).
Sur Team, le siège standard est à 21,04 € HT et le siège premium à 105,23 € HT par mois. La première formule individuelle qui inclut Fable en permanence est donc Max ; notre guide des prix de Claude détaille le reste.
Sur les formules Enterprise, Fable 5.2 est désactivé pendant les 7 jours qui suivent son lancement, sauf si un administrateur l’active.
Passé ce délai, il est ajouté à tous les rôles qui ont déjà un modèle Fable activé, et tout réglage par défaut placé sur un modèle Fable passe à la version 5.2, sauf refus d’un administrateur. Sur l’API et les formules Enterprise facturées à l’usage, il se paie aux tarifs standard indiqués plus haut.
Les offres de lancement : une semaine pour Pro, des réinitialisations jusqu’au 8 mars 2027
Pour accompagner la sortie, Anthropic a prévu deux offres de lancement. Elles couvrent tous les modèles Fable, pas seulement la version 5.2.
Toutes deux reposent sur une « réinitialisation Fable » : un bouton à usage unique qui vous rend l’usage hebdomadaire dépensé sur les modèles Fable et, si votre compte a une limite de cinq heures, remet cette fenêtre à zéro.
Sur la formule Pro et les sièges Team standard, tous les modèles Fable sont inclus du 9 novembre au 16 novembre 2026 à 23 h 59, heure du Pacifique, soit le 17 novembre 2026 à 8 h 59, heure de Paris, jusqu’à 50 % des limites d’usage hebdomadaires.
Au-delà de ces 50 %, l’usage supplémentaire de Fable est facturé en crédits d’usage si vous les avez activés, même pendant la semaine de l’offre.
L’offre comprend aussi 1 réinitialisation Fable pour ces abonnés, à utiliser avant la même échéance.
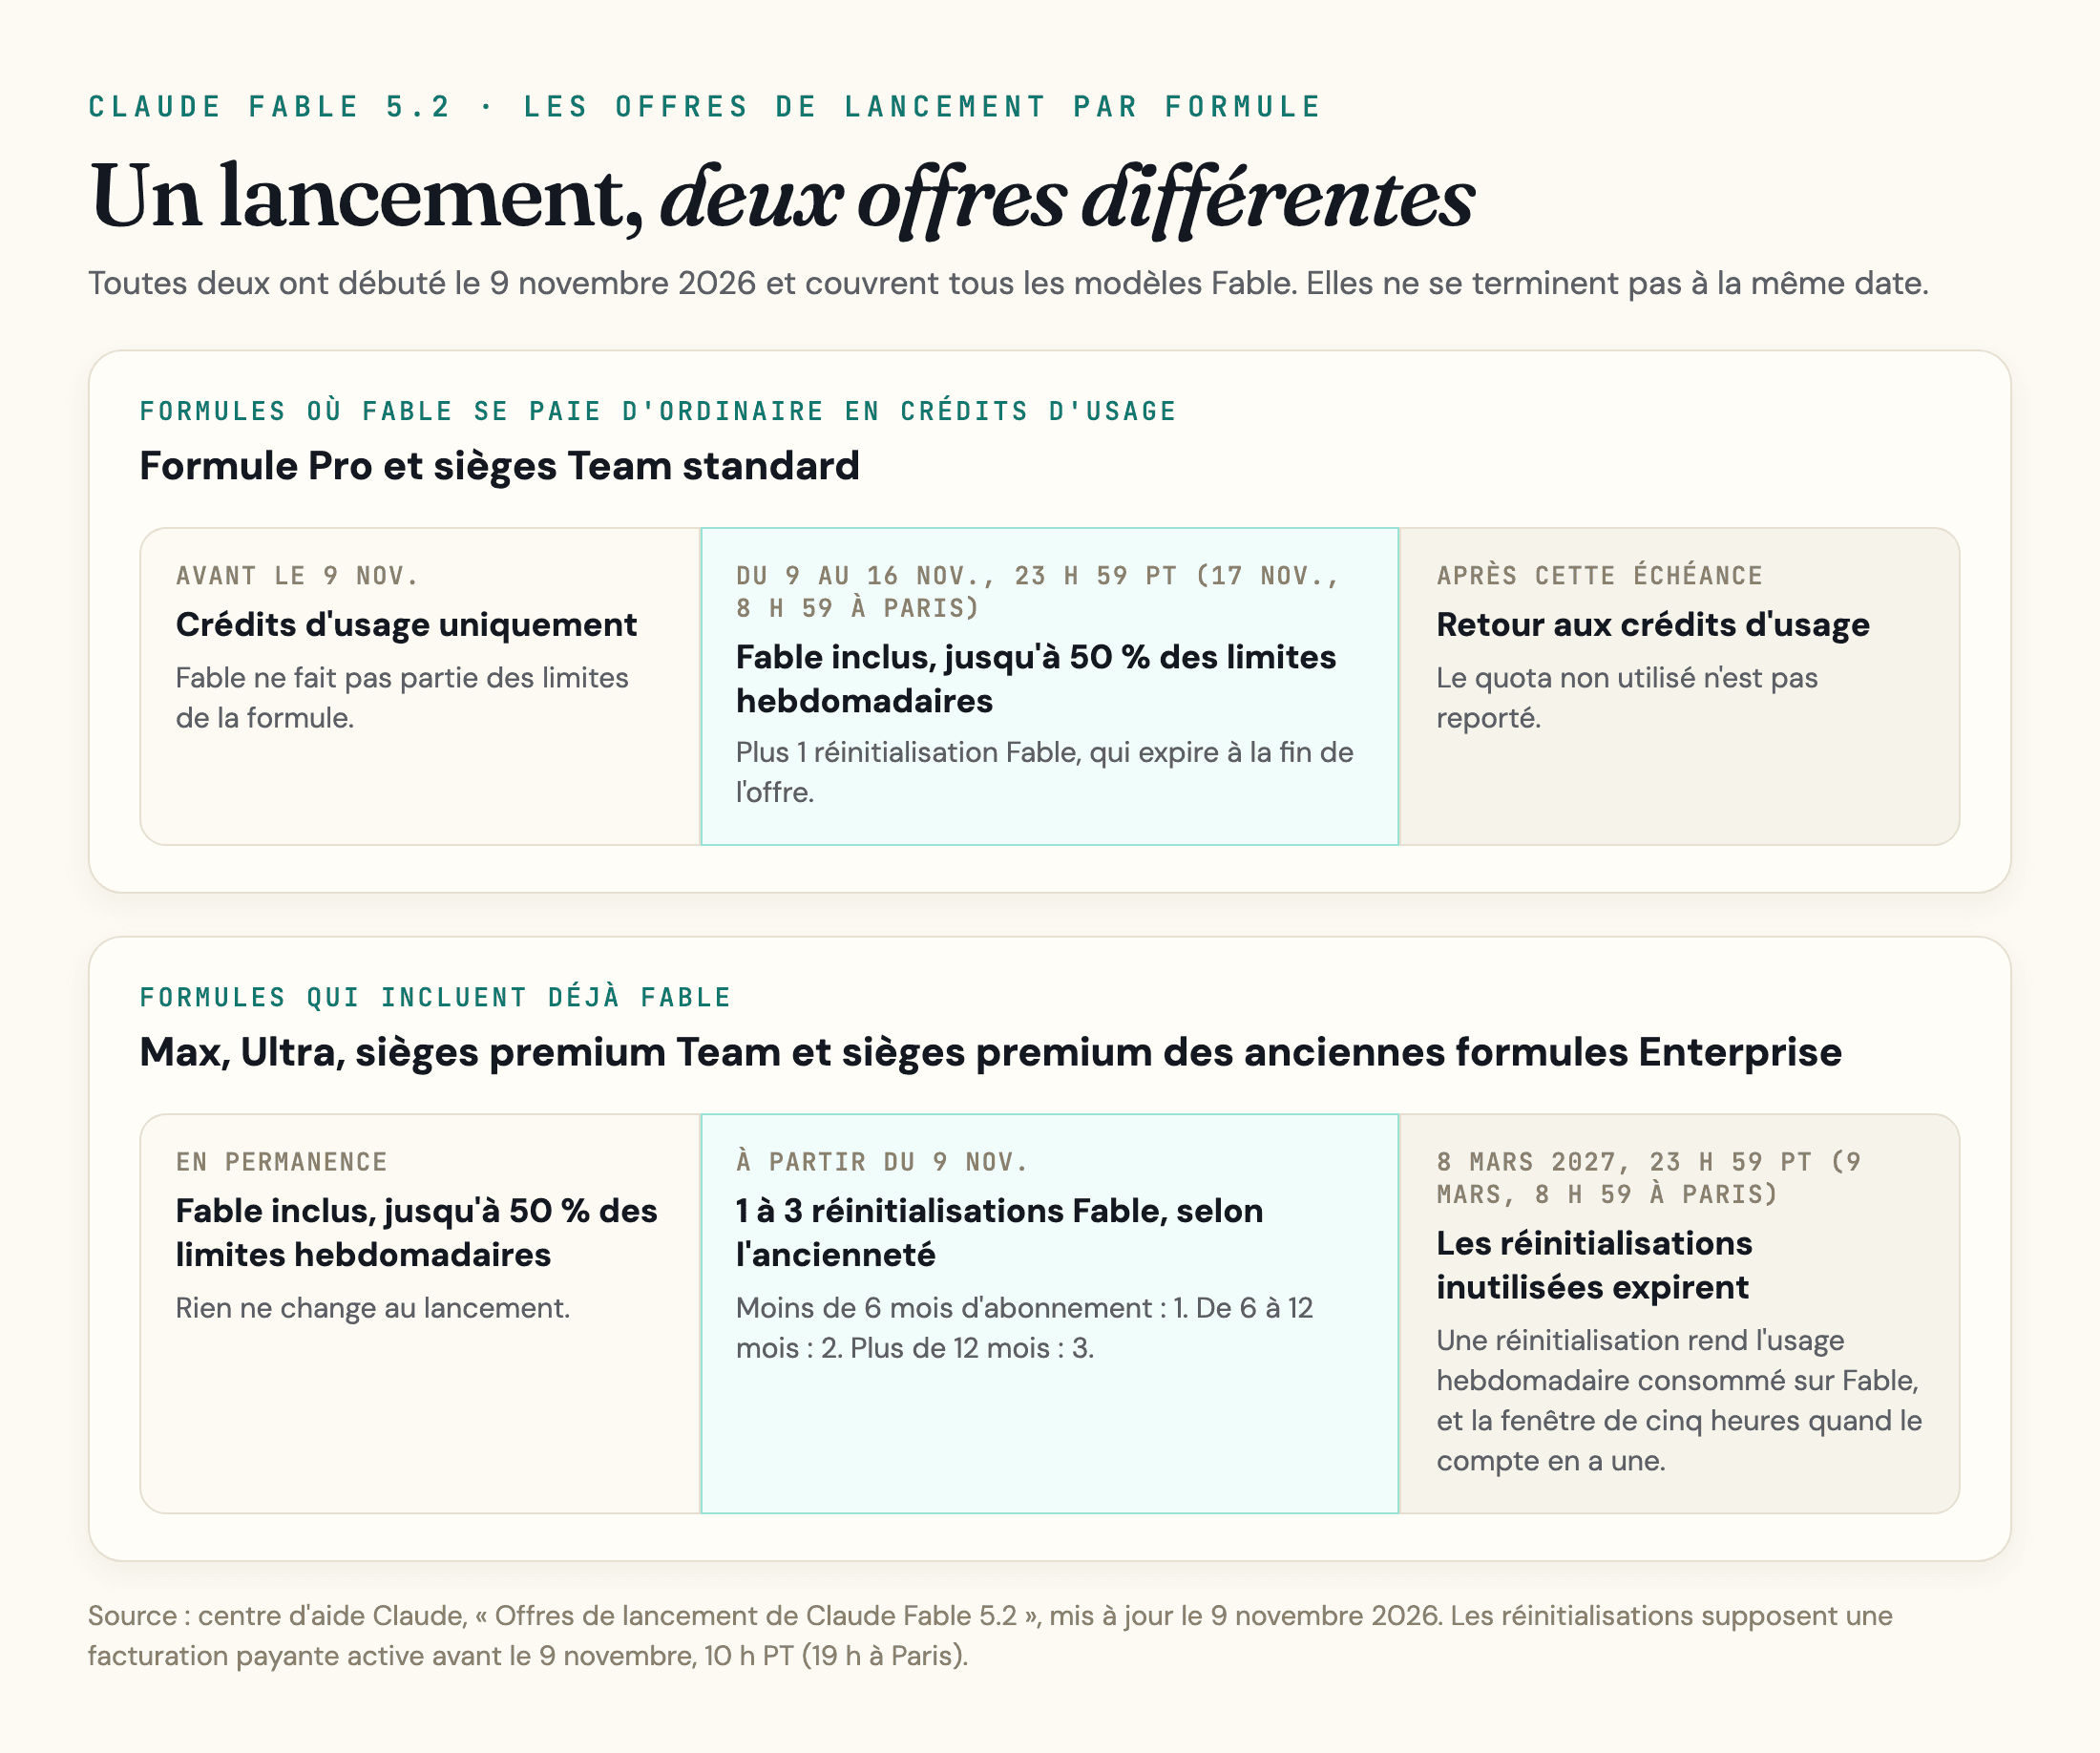
Après le 16 novembre 2026 à 23 h 59, heure du Pacifique, Fable repasse aux crédits d’usage sur la formule Pro et les sièges Team standard, et le quota non utilisé n’est pas reporté.
Les abonnés Max et Ultra, ainsi que les titulaires d’un siège premium, reçoivent à la place des réinitialisations : 1 s’ils paient depuis moins de 6 mois, 2 entre 6 et 12 mois, 3 au-delà de 12 mois. Elles expirent le 8 mars 2027 à 23 h 59, heure du Pacifique, soit le 9 mars 2027 à 8 h 59, heure de Paris.
Attention aux petites lignes :
- Une réinitialisation Fable n’est pas une réinitialisation hebdomadaire. L’usage hebdomadaire dépensé sur les autres modèles n’est pas rendu. Seule la fenêtre de cinq heures, quand le compte en a une, est entièrement remise à zéro.
- Il y a une date butoir de facturation. Les réinitialisations ne vont qu’aux comptes dont la facturation payante était en place avant le 9 novembre 2026 à 10 h, heure du Pacifique (19 h, heure de Paris). Les titulaires d’un siège Team ou Enterprise doivent aussi avoir rejoint leur organisation avant ce moment.
- Certaines formules sont exclues. Les offres ne s’appliquent ni à la formule Free, ni aux sièges standard des anciennes formules Enterprise facturées au siège, ni aux formules Enterprise en libre-service ou facturées à l’usage, et les réinitialisations ne sont pas proposées sur les formules Enterprise compatibles HIPAA.
Dans Claude Code, Fable 5.2 fonctionne par défaut avec la fenêtre d’un million de tokens, d’après la documentation des modèles de Claude Code.
Un piège attend les abonnés Pro une fois l’offre terminée : dans les exécutions non interactives lancées avec -p, Claude Code impute les requêtes Fable sur vos crédits d’usage sans demander confirmation. Notre guide de la fenêtre de contexte de Claude Code explique comment ce réglage pèse sur le coût.
Usage professionnel : RGPD et lieu de traitement
Pour des données de clients, retenez deux choses. L’avenant de traitement des données (DPA) d’Anthropic, le contrat de sous-traitance prévu par l’article 28 du RGPD, fait partie des conditions commerciales, qui couvrent l’API, Team et Enterprise, mais pas les offres pour particuliers (Free, Pro, Max, Ultra). Fable 5.2 exige par ailleurs une conservation des données de 30 jours, sauf autorisation expresse d’Anthropic.
Au 10 novembre 2026, aucune voie d’accès ne maintient par défaut le traitement dans l’Union européenne : l’API Claude, Amazon Bedrock et Microsoft Foundry ne donnent accès à Fable 5.2 que par une inférence mondiale ou américaine. Seul Google Cloud, dans son offre gérée par Google, affiche une multirégion Europe, à condition d’accepter le partage des requêtes et des réponses avec Anthropic et leur conservation jusqu’à 30 jours pour la surveillance des abus.
Garde-fous : ce qui est bloqué, et ce qui se passe ensuite
Fable 5.2 soumet chaque demande à des classifieurs de sécurité, des filtres automatiques volontairement larges. D’après l’annonce d’Anthropic, ils bloquent les activités cyber à haut risque, tests d’intrusion et génération d’exploits compris, ainsi que la plupart des tâches de recherche en biologie.
Quand une demande est bloquée, Anthropic indique que l’utilisateur reçoit à la place une réponse d’Opus 4.8 pour la cybersécurité et d’Opus 5 pour la biologie. Sa page d’aide étend ce renvoi vers Opus 5 à la chimie, aux sciences du vivant et à quelques sujets pointus de développement d’IA avancée. Les tentatives d’extraire le raisonnement du modèle sont refusées net, sans modèle de repli.
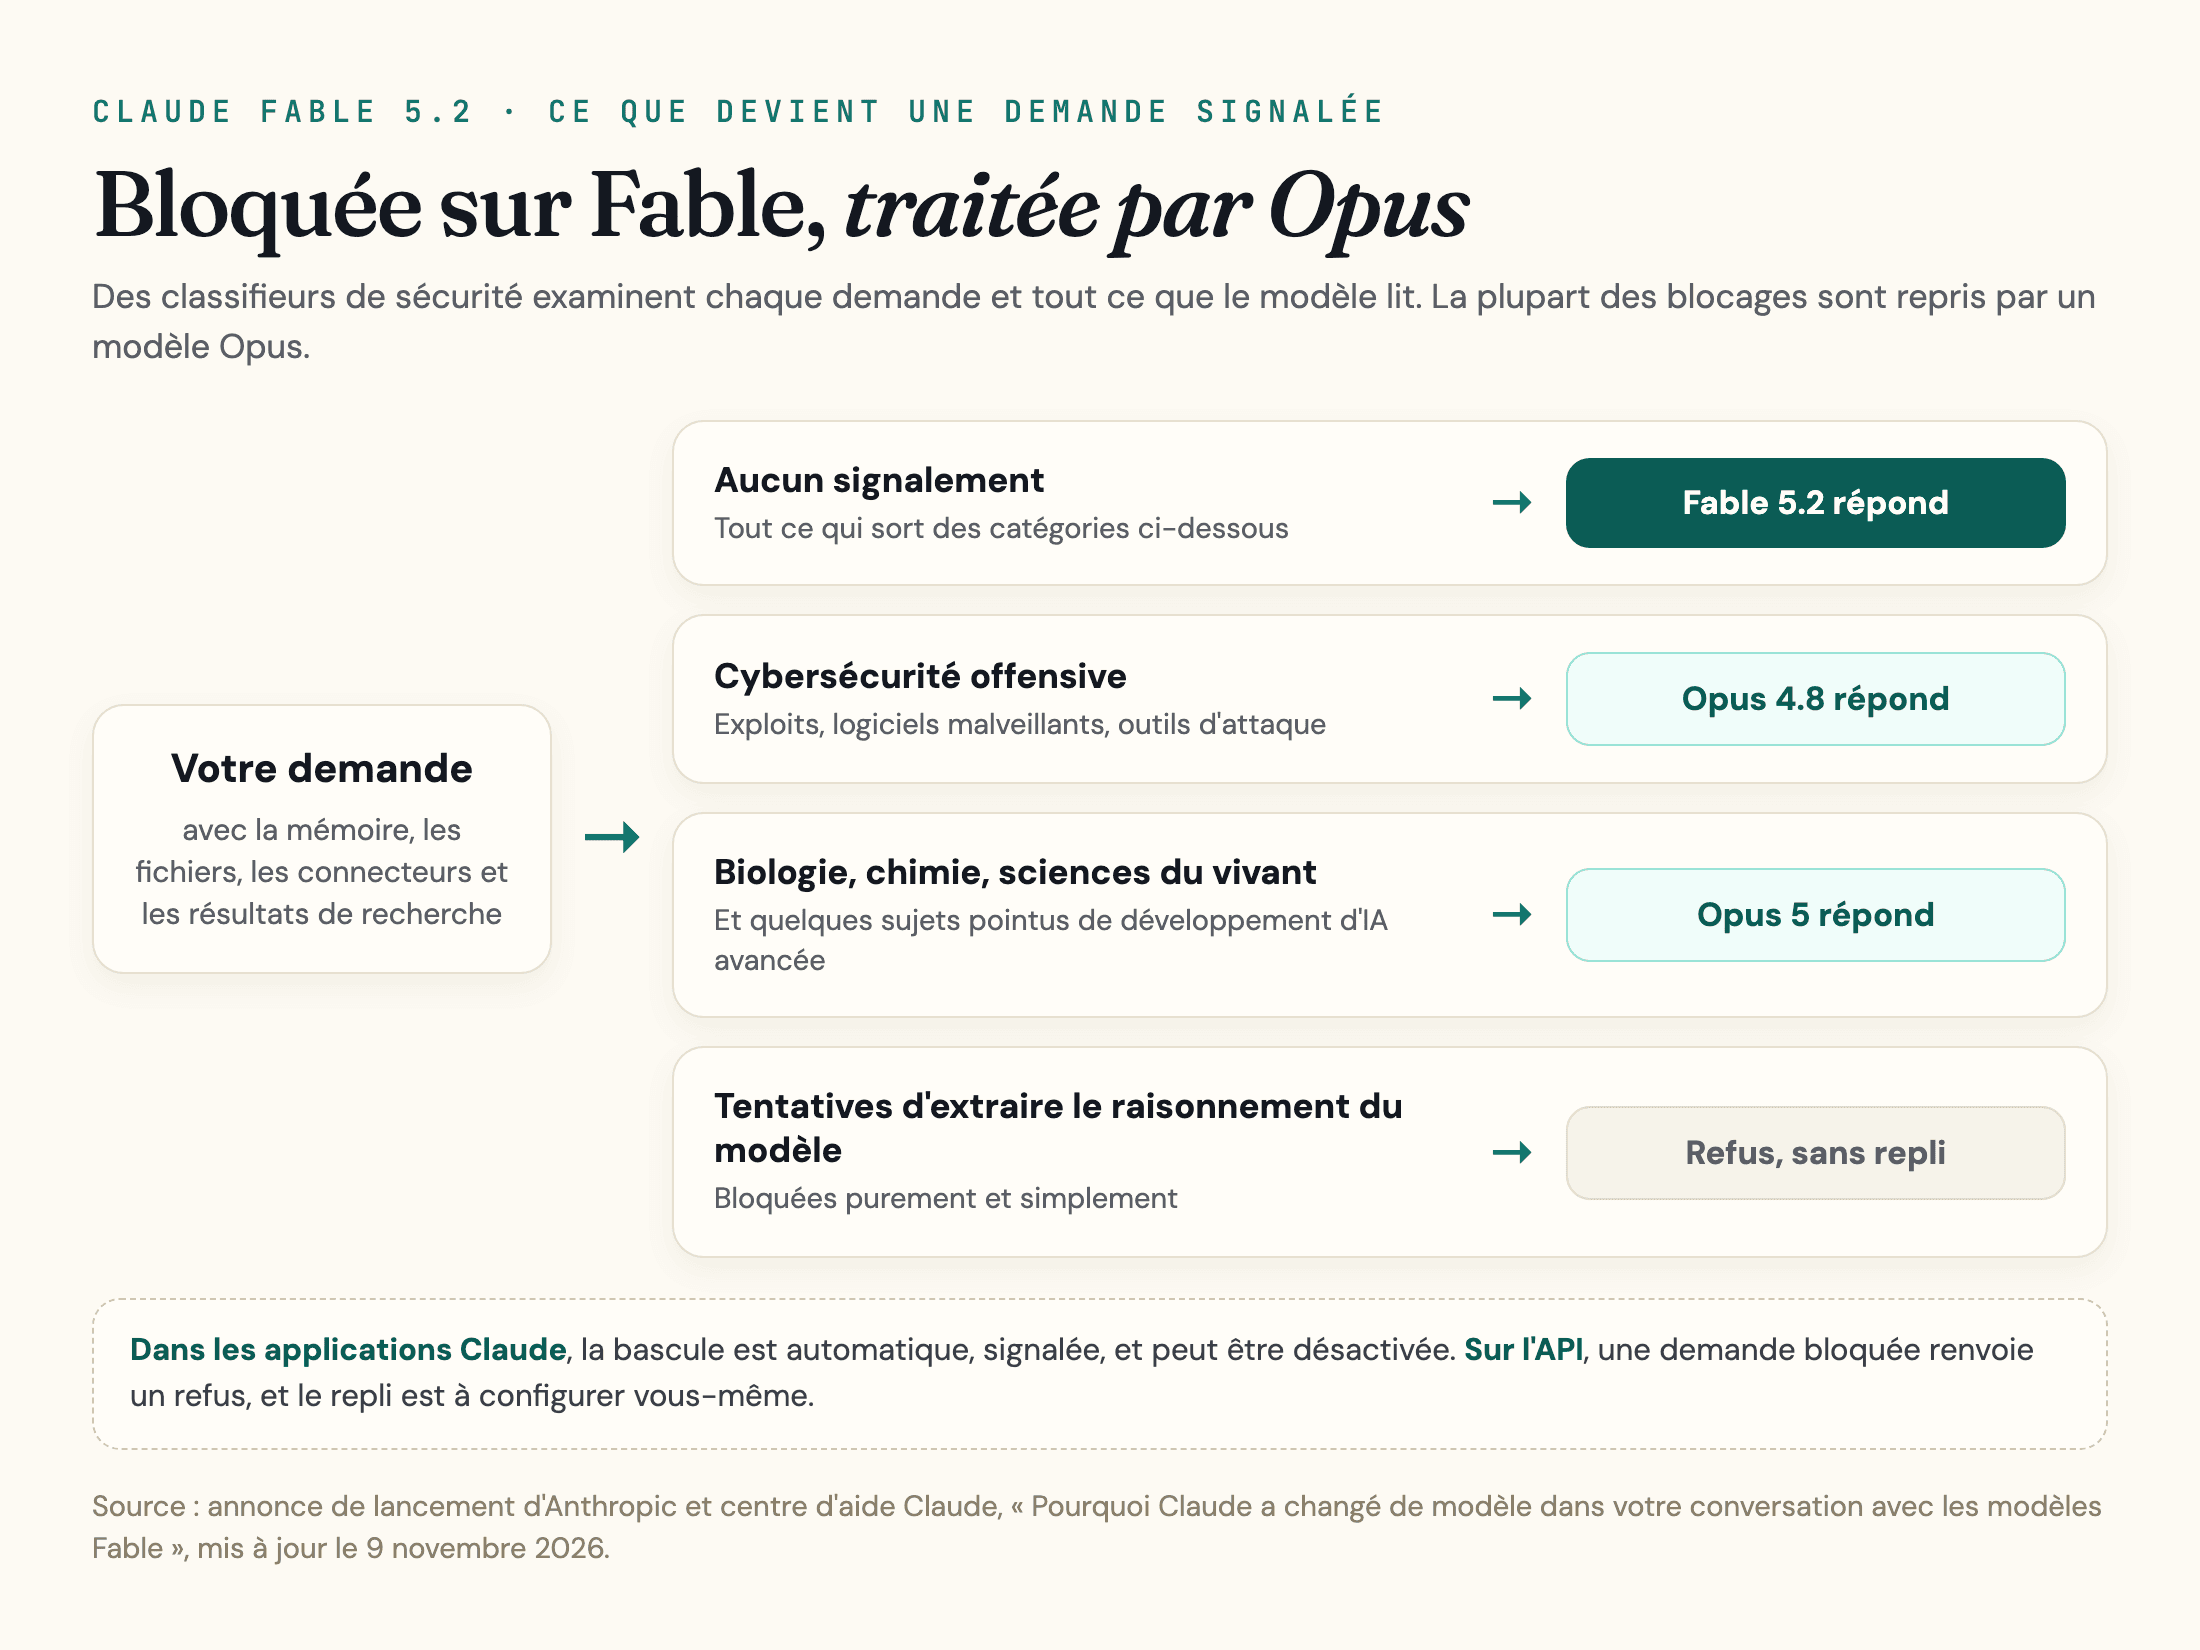
Dans les applications Claude, cette bascule est automatique et visible. D’après la page d’aide d’Anthropic sur le changement de modèle, la réponse porte le nom du modèle qui l’a produite, et le sélecteur reste sur Opus tant que vous ne revenez pas vous-même à Fable. Vous pouvez désactiver la bascule automatique.
Quelques détails passent facilement inaperçus :
- Un blocage peut venir d’un contenu que vous n’avez pas saisi. Les contrôles portent sur tout ce que le modèle lit : la mémoire, le contenu des connecteurs, les résultats de recherche web et les fichiers.
- Sur l’API, le repli se configure. Une requête refusée renvoie un code HTTP 200 avec le motif d’arrêt « refusal ». C’est à vous de décider de la relancer sur un autre modèle, et la réponse de repli est facturée comme une requête à part.
- Certains refus sont facturés. D’après la documentation d’Anthropic sur les refus, un refus qui arrive avant toute sortie est facturé quand sa catégorie est bio, frontier_llm ou reasoning_extraction, et ne l’est pas dans les autres catégories, comme cyber. Un refus qui survient en cours de génération entraîne la facturation de l’entrée et de la sortie déjà produite, quelle que soit la catégorie. Tous comptent dans les limites de débit.
Les équipes de sécurité se heurteront elles aussi à des blocages : la page d’aide précise que Fable peut aider sur les tâches courantes de cybersécurité, mais qu’il faut s’attendre à des bascules fréquentes. Pour ce travail, Anthropic oriente vers Claude Mythos 5.2, le même modèle au même prix, avec des garde-fous assouplis. L’accès passe par deux programmes d’Anthropic, le Cyber Verification Program et le Life Sciences Verification Program.
Passer de Fable 5.1 à Fable 5.2 : 4 changements d’API qui cassent du code
Si votre propre code appelle l’API Messages, les notes de version d’Anthropic recensent 4 changements susceptibles de le casser :
- Le contrôle du préfixe s’applique à tous les comptes. L’API vérifie que rien n’a été modifié avant un bloc de réflexion. Si votre code change des tours antérieurs (le prompt système, les outils ou un message précédent) puis renvoie un bloc de réflexion, la requête échoue avec une erreur 400. Sur Fable 5.1, cela ne concernait que les comptes créés à partir du 31 août 2026 : un compte plus ancien peut donc passer sur 5.1 et échouer sur 5.2. Si vos requêtes sont construites par Claude Code, claude.ai ou le Claude Agent SDK, ce changement ne vous touche pas.
- Les blocs de réflexion de Fable 5.2 ne sont lisibles que par Fable 5.2 et Mythos 5.2. Si vous changez de modèle en cours de conversation, le nouveau modèle ne peut pas lire la réflexion antérieure de Fable 5.2. L’API écarte ces blocs et la requête aboutit quand même.
- L’ancien outil de pilotage de l’ordinateur a disparu. Une requête qui déclare
computer_20251124renvoie une erreur 400 sur toutes les plateformes, sauf Amazon Bedrock. Utilisez la boîte à outilscomputer_toolset_20260801. - Un exécutant Fable 5.2 exige un conseiller Fable 5.2 ou Mythos 5.2. Avec l’outil advisor, où un modèle exécute la tâche et un autre le conseille, une requête avec tout autre modèle conseiller renvoie une erreur 400.
Vous venez plutôt d’Opus 5.5 ? Le guide de migration d’Anthropic signale d’autres changements, dont certains ne déclenchent aucune erreur. Fable 5.2 se règle par défaut sur l’effort high, là où Opus 5.5 se règle sur medium : une requête qui ne précise pas l’effort coûtera plus cher.
Fable 5.2 a ses propres limites de débit, avec des plafonds de tokens plus bas à chaque palier. Dans une organisation sans conservation des données (zero data retention), les requêtes renvoient une erreur 400, sauf autorisation d’Anthropic ou espace de travail réglé sur une conservation de 30 jours.
Un dernier changement, de comportement cette fois, ne touche pas au code mais pèse sur le coût : les consignes de prompt qui demandent moins de réflexion n’empêchent plus le modèle de réfléchir à partir de l’effort medium. Baissez plutôt le niveau d’effort. Pour comprendre comment la réflexion et l’usage d’outils s’articulent, lisez comment fonctionne Claude.
Foire aux questions
Claude Fable 5.2 est-il gratuit ?
Non. Les modèles Fable ne sont pas disponibles dans la formule Free de Claude. Sur la formule Pro et les sièges Team standard, Fable 5.2 est inclus du 9 novembre au 16 novembre 2026 (jusqu’au 17 novembre à 8 h 59, heure de Paris), jusqu’à 50 % des limites d’usage hebdomadaires, puis se paie à la consommation, en crédits d’usage.
Sur Max, Ultra et les sièges premium, il fait partie de la formule, avec le même plafond de 50 %.
Claude Code prend-il en charge Fable 5.2 ?
Oui, à partir de la version 2.1.321 de Claude Code. Sélectionnez-le avec /model fable ; le niveau d’effort par défaut y est medium. Le mode rapide fonctionne aussi dans Claude Code, mais avec un abonnement il est toujours facturé en crédits d’usage, même s’il vous reste de l’usage inclus dans votre formule.
Claude Fable 5 est-il toujours disponible ?
Oui. Fable 5, Fable 5.1 et Fable 5.2 sont tous disponibles avec une formule Claude payante, et la page des retraits de modèles d’Anthropic n’annonce aucun retrait du Fable 5 d’origine avant le 9 juin 2027. Dans Claude Code et dans les applications, vous sélectionnez les anciens modèles par leur nom.
Fable 5.2 est-il meilleur que GPT-6 Astra ?
Sur les benchmarks publiés à ce jour, oui. Le tableau de lancement d’Anthropic place Fable 5.2 devant GPT-6 Astra sur toutes les lignes où les deux ont un score, et l’indice d’Artificial Analysis lui donne 65 contre 57 au 10 novembre 2026.
Côté coût, selon la System Card d’Anthropic, Fable 5.2 en effort high obtient 45,3 % sur FrontierCode pour 6,72 $ par tâche, contre 42,8 % pour le meilleur résultat de GPT-6 Astra à 6,68 $ ; le meilleur score de Fable, en xhigh, coûte environ deux fois plus.
Sources
- Présentation de Claude Fable 5.2 et Claude Mythos 5.2 - Anthropic, 9 novembre 2026 -
anthropic.com/claude-fable-and-mythos-5-2 - System Card de Claude Fable 5.2 et Claude Mythos 5.2 - Anthropic, novembre 2026 -
anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card - Déclaration sur la directive du gouvernement américain suspendant l’accès à Fable 5 et Mythos 5 - Anthropic, 12 juin 2026 -
anthropic.com/news/fable-mythos-access - Redéploiement de Fable 5 - Anthropic, 30 juin 2026 -
anthropic.com/news/redeploying-fable-5 - Tarifs - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/about-claude/pricing - Présentation des modèles - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/models/overview - Retraits de modèles - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/about-claude/model-deprecations - Nouveautés de Claude Fable 5.2 - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2 - Guide de migration vers Claude Fable 5.2 - documentation de la Claude Platform, consulté le 10 novembre 2026 -
platform.claude.com/docs/en/models/fable-5-2/migration-guide - Refus et repli - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/build-with-claude/refusals-and-fallback - Résidence des données - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/build-with-claude/data-residency - Offres de lancement de Claude Fable 5.2 - centre d’aide Claude, mis à jour le 9 novembre 2026 -
support.claude.com/fr/articles/17506494-offres-de-lancement-de-claude-fable-5-2 - Modèles Claude Fable sur votre plan - centre d’aide Claude, mis à jour le 9 novembre 2026 -
support.claude.com/fr/articles/15424964-modeles-claude-fable-sur-votre-plan - Pourquoi Claude a changé de modèle dans votre conversation avec les modèles Fable - centre d’aide Claude, mis à jour le 9 novembre 2026 -
support.claude.com/fr/articles/15363606-pourquoi-claude-a-change-de-modele-dans-votre-conversation-avec-les-modeles-fable - Prix des formules Claude pour la France - interface de facturation d’Anthropic, relevée le 10 novembre 2026 -
claude.com/pricing - Avenant de traitement des données (DPA) - Anthropic, en vigueur depuis le 24 février 2025 -
anthropic.com/legal/data-processing-addendum - Configuration des modèles - documentation de Claude Code, mise à jour le 9 novembre 2026 -
code.claude.com/docs/en/model-config - Mode rapide - documentation de Claude Code, mise à jour le 10 novembre 2026 -
code.claude.com/docs/en/fast-mode - Fiche du modèle Claude Fable 5.2 - Amazon Bedrock, mise à jour le 10 novembre 2026 -
docs.aws.amazon.com/bedrock/latest/userguide/model-card-anthropic-claude-fable-5-2.html - Claude Fable 5.2 sur Google Cloud - documentation de Google Cloud, mise à jour le 9 novembre 2026 -
docs.cloud.google.com/vertex-ai/generative-ai/docs/partner-models/claude/fable-5-2 - Claude dans Microsoft Foundry - documentation de la Claude Platform, consultée le 10 novembre 2026 -
platform.claude.com/docs/en/build-with-claude/claude-in-microsoft-foundry - Classement des modèles et fiche de Claude Fable 5.2 - Artificial Analysis, relevés le 10 novembre 2026 -
artificialanalysis.ai/leaderboards/models - Classement GDPval-AA v2.1 - Artificial Analysis, relevé le 10 novembre 2026 -
artificialanalysis.ai/evaluations/gdpval-aa - Classement AA-Briefcase v1.1 - Artificial Analysis, relevé le 10 novembre 2026 -
artificialanalysis.ai/evaluations/aa-briefcase - Terminal-Bench 4.0 - Artificial Analysis, relevé le 10 novembre 2026 -
artificialanalysis.ai/evaluations/terminalbench-4-0 - Vals Index - Vals AI, mis à jour le 9 novembre 2026 -
vals.ai/benchmarks/vals_index - Terminal-Bench 4.0 - Vals AI, mis à jour le 9 novembre 2026 -
vals.ai/benchmarks/terminal-bench-4 - Classement FrontierCode - Cognition, relevé le 10 novembre 2026 -
cognition.com/frontiercode - [Topic unique] Claude by Anthropic, page 39 - forum HardWare.fr, 10 novembre 2026 -
forum.hardware.fr/hfr/ia/unique-claude-anthropic-sujet_7_39.htm