
Vous avez ajouté une bio d’auteur. Vous avez gagné des positions. Et ChatGPT, Perplexity et les AI Overviews de Google ne vous mentionnent toujours pas. Si l’E-E-A-T est censé être votre ticket d’entrée dans la recherche IA, pourquoi l’avoir fait dans les règles ne change-t-il rien ?
L’E-E-A-T pour la recherche IA est largement mal compris. Ce n’est ni un score à faire grimper, ni un facteur de classement à activer. C’est une étiquette posée sur les signaux de confiance que les moteurs IA vont chercher pour décider qui citer. Voici quels signaux pèsent vraiment sur cette décision, lesquels ne sont que du théâtre, et que faire quand tout est fait dans les règles et que la citation ne vient toujours pas.
Ce qu’il faut retenir
- L’E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) n’est pas un score ni un facteur de classement : c’est le vocabulaire des quality raters, les évaluateurs humains de Google, et il n’existe aucun chiffre à optimiser.
- ChatGPT, Perplexity et les AI Overviews n’appliquent pas littéralement l’E-E-A-T, mais leur récupération d’information s’appuie sur les mêmes signaux de confiance, ce qui rend le travail utile quand même.
- La confiance se joue au niveau de l’entité, pas de la page : Ahrefs mesure une corrélation de 0,664 entre les mentions de marque hors-site et les citations dans les AI Overviews, devant les ancres de marque et les recherches de marque.
- En France, les AI Overviews sont déployés depuis le 22 juillet 2026, et une étude française (The Black Room, août 2026) montre que Wikipédia en français y capte 14 % des citations, soit plus que toute la presse ACPM réunie.
- L’accessibilité aux robots passe avant tout : un moteur ne peut pas citer une page qu’il ne peut pas récupérer, donc vérifiez d’abord votre robots.txt avec l’AI Crawler Checker gratuit avant d’investir dans le reste.
Ce qu’est vraiment l’E-E-A-T
E-E-A-T signifie Experience, Expertise, Authoritativeness, Trustworthiness (expérience, expertise, autorité, fiabilité). L’acronyme vient des Search Quality Rater Guidelines de Google, le document qui encadre le travail des quality raters chargés de juger la qualité d’un contenu. Google a ajouté le second E, celui de l’expérience, en décembre 2022, pour mettre la connaissance vécue au même niveau que l’expertise théorique.
Un détail compte plus que l’acronyme lui-même : les quatre piliers ne pèsent pas le même poids. Google l’affirme sans détour : « trust is most important » (la fiabilité est le critère qui compte le plus), et les trois autres piliers existent pour l’alimenter. Une page qui n’inspire pas confiance a un mauvais E-E-A-T, même si elle affiche une expérience et une expertise réelles. Le cadre pèse davantage encore sur les sujets YMYL (Your Money or Your Life), là où une information erronée peut causer un préjudice concret.
Aucun de ces quatre piliers n’est directement lisible par une machine, et c’est le point que la plupart des guides sautent. Ce sont des concepts pensés pour des évaluateurs humains, que les systèmes de classement de Google comme les moteurs de réponse IA doivent déduire à partir de signaux observables. C’est dans cet écart, entre l’idée et le signal réellement mesurable, que la plupart des conseils E-E-A-T déraillent.
| Pilier | Ce que Google entend par là | Ce qu’un moteur IA peut observer |
|---|---|---|
| Expérience | Un usage réel et vécu du sujet | Photos originales, données, résultats datés, détails à la première personne qu’il peut extraire |
| Expertise | Connaissances, compétences ou diplômes | Un auteur identifié, avec une identité lisible par la machine et des profils concordants ailleurs sur le web |
| Autorité | Une réputation de référence sur le sujet | D’autres sites crédibles qui la citent, la mentionnent et pointent vers elle |
| Fiabilité | Exactitude, transparence et sécurité | Des faits cohérents sur l’ensemble du web, un sourcing clair, HTTPS, de vraies coordonnées de contact |
Relisez la dernière colonne. La plupart de ces signaux, l’autorité et la fiabilité en tête, sont des choses que d’autres disent de vous, pas des choses qu’on déclare sur sa propre page. Retenez-le : c’est ce qui explique l’essentiel du mécanisme de citation par l’IA.
L’E-E-A-T est-il un facteur de classement ? Non, et c’est encore plus vrai pour l’IA
Il n’existe aucun score E-E-A-T, et ce n’est pas un facteur de classement. C’est la position même de Google : « While E-E-A-T itself isn’t a specific ranking factor, using a mix of factors that can identify content with good E-E-A-T is useful » (l’E-E-A-T en tant que tel n’est pas un facteur de classement précis, mais s’appuyer sur un ensemble de facteurs qui repèrent un bon E-E-A-T est utile). Les quality raters notent des échantillons de résultats pour vérifier que les systèmes de classement fonctionnent comme prévu. Leur note ne redescend jamais sous forme de chiffre collé à une page.
Résultat : quand un outil propose de calculer votre « score E-E-A-T », il invente une métrique que Google dit ne pas exister. Même logique pour la version checklist de l’idée : ajouter un encart auteur et une mention « relu par » en espérant que le classement bouge.
C’est un mythe coûteux. Danny Sullivan, de l’équipe Search de Google, l’a dit sans ambiguïté dans des propos rapportés par Search Engine Land : les bios d’auteur ne sont pas, à elles seules, un signal de classement. Faire écrire un contenu par un expert ne le fait pas grimper par magie, et ajouter une ligne de diplômes ne déclenche rien. La bio garde son utilité, mais pas comme un levier qu’on actionne sur sa propre page : elle vaut comme preuve qu’un moteur peut relier à une personne réelle et reconnue.
Les réponses IA font monter les enjeux. Ces moteurs sont encore plus éloignés de votre page que ne l’est le robot d’exploration de Google : ils ne voient ni vos intentions ni vos efforts, seulement des signaux. Les mêmes signaux corrélés qui influencent le classement pèsent dès lors encore plus lourd quand un moteur décide quoi citer. Une page qu’il ne parvient ni à situer ni à juger fiable apparaît rarement dans une réponse.
L’E-E-A-T s’applique-t-il à ChatGPT, Perplexity et aux AI Overviews ?
Au sens strict, non. L’E-E-A-T est le vocabulaire de Google pour ses quality raters. ChatGPT, Claude et Perplexity n’exécutent aucune fonction appelée « E-E-A-T », et quiconque prétend le contraire invente.
La vraie question est de savoir si les mêmes signaux sous-jacents décident qui se fait citer. Là, la réponse est oui. Une grande partie des réponses IA repose sur de la récupération d’information (retrieval) : le moteur lance une recherche, récupère un ensemble de pages, puis rédige à partir d’elles. Le fonctionnement de la recherche IA passe d’abord par une étape de récupération, suivie d’une étape de génération. Cette récupération puise dans le même web que les moteurs classiques ont déjà trié par qualité : les signaux de confiance qu’on construit pour l’E-E-A-T sont largement ceux qui permettent d’entrer dans cet ensemble récupéré.
Les AI Overviews (Aperçus IA) de Google, déployés en France depuis le 22 juillet 2026, s’appuient sur les pages que les systèmes de classement de Google font déjà remonter, même si le lien s’est un peu distendu. Ahrefs a mesuré la part des citations d’AI Overviews provenant du top 10 organique à 76 % en juillet 2025, puis à 38 % dans une étude plus large de mars 2026 (les deux études ne mesurent pas tout à fait la même chose : la première regarde les citations les plus visibles par Aperçu, la seconde l’ensemble des 4 millions d’URL citées ; ne lisez donc pas ce recul comme un effondrement). Le classement continue d’ouvrir la porte ; il ne garantit plus la citation.
Classement et citation restent deux choses distinctes : un bon classement vous fait entrer dans la sélection, il ne vous garantit pas la citation. De nombreuses pages bien classées ne sont jamais nommées dans une réponse, et de nombreuses sources citées se trouvent loin de la première page. Voyez le classement comme le prix d’entrée, et la citation comme une seconde sélection, plus exigeante encore sur la confiance et la corroboration. La section suivante explique pourquoi cette seconde sélection tourne si souvent contre la page qui a pourtant tout fait dans les règles.
Pourquoi vous êtes 1er sur Google et toujours pas cité
La frustration la plus courante qu’on entend : « Je suis 1er sur Google, ma page a une bio d’auteur et du balisage Schema, et ChatGPT ne me nomme jamais. » La raison : les moteurs IA misent lourdement sur la confiance au niveau de l’entité (la marque, l’auteur), pas seulement au niveau de la page.
Une page peut être excellente prise isolément. Mais un moteur qui décide de citer une affirmation cherche une corroboration, et cette corroboration se trouve en dehors de votre site. Il regarde si d’autres sources crédibles parlent de vous, pointent vers vous et confirment ce que vous dites. En résumé : l’IA ne construit pas son image de vous à partir de ce que dit votre page d’accueil, mais à partir de ce que dit le reste du web.
C’est pourquoi un fil Reddit sommaire peut battre votre guide détaillé. Reddit est une entité reconnue, renforcée par des milliers de voix indépendantes, et une source avec laquelle plusieurs moteurs ont signé des accords de contenu : c’est donc une citation facile. Votre page, meilleure sur le fond mais venant d’un domaine que le moteur a à peine vu mentionné ailleurs, est un pari plus risqué. Ce n’est pas juste, mais c’est cohérent avec la logique du système.
Les chiffres vont dans le même sens. Ahrefs a mesuré que les mentions de marque hors-site sont le signal externe le plus corrélé aux citations dans les AI Overviews, avec un coefficient de 0,664, devant les ancres de marque et les recherches de marque (une étude Ahrefs plus récente, portant sur 75 000 marques, situe désormais les mentions YouTube plus haut encore, autour de 0,737, toutes surfaces IA confondues : le mécanisme reste le même, seul le classement des signaux évolue). Et une bonne part de ce que l’IA cite échappe structurellement à votre contrôle : Ahrefs a également constaté qu’environ deux tiers des sources les plus citées par ChatGPT sont hors de portée d’une stratégie marketing, dominées par Wikipédia, des sites de référence et d’autres pages qu’on ne peut pas facilement influencer par de l’outreach.
En France, ce paysage n’est pas une simple copie réduite du web anglophone. The Black Room, un collectif de consultants SEO, a mesuré 25 000 requêtes sur la SERP mobile française le 9 août 2026 : sur plus de 9 400 domaines cités par les AI Overviews de Google, Wikipédia en français arrive en tête avec 14 % des citations, soit plus que l’ensemble des titres de la presse ACPM réunis (13 %). L’étude ne couvre qu’une journée et un corpus de requêtes d’actualité et d’entités à longue traîne : à lire comme un signal, pas comme un verdict figé. Concrètement, pour un site français qui se demande où porter ses efforts de corroboration hors-site, être mentionné par une source de référence solidement installée en français (Wikipédia, presse nationale, institutions) pèse au moins autant que l’outreach vers des sites indépendants.
Le travail qui compte n’est donc pas un réglage on-page de plus. C’est devenir une entité que les moteurs reconnaissent : nommée de façon cohérente, décrite de façon cohérente, et corroborée par les sources auxquelles un moteur IA fait déjà confiance. Votre page est l’endroit où vous convertissez cette confiance en réponse, pas l’endroit où vous la créez.
Les signaux que l’IA lit, et la mise en scène qu’elle ignore
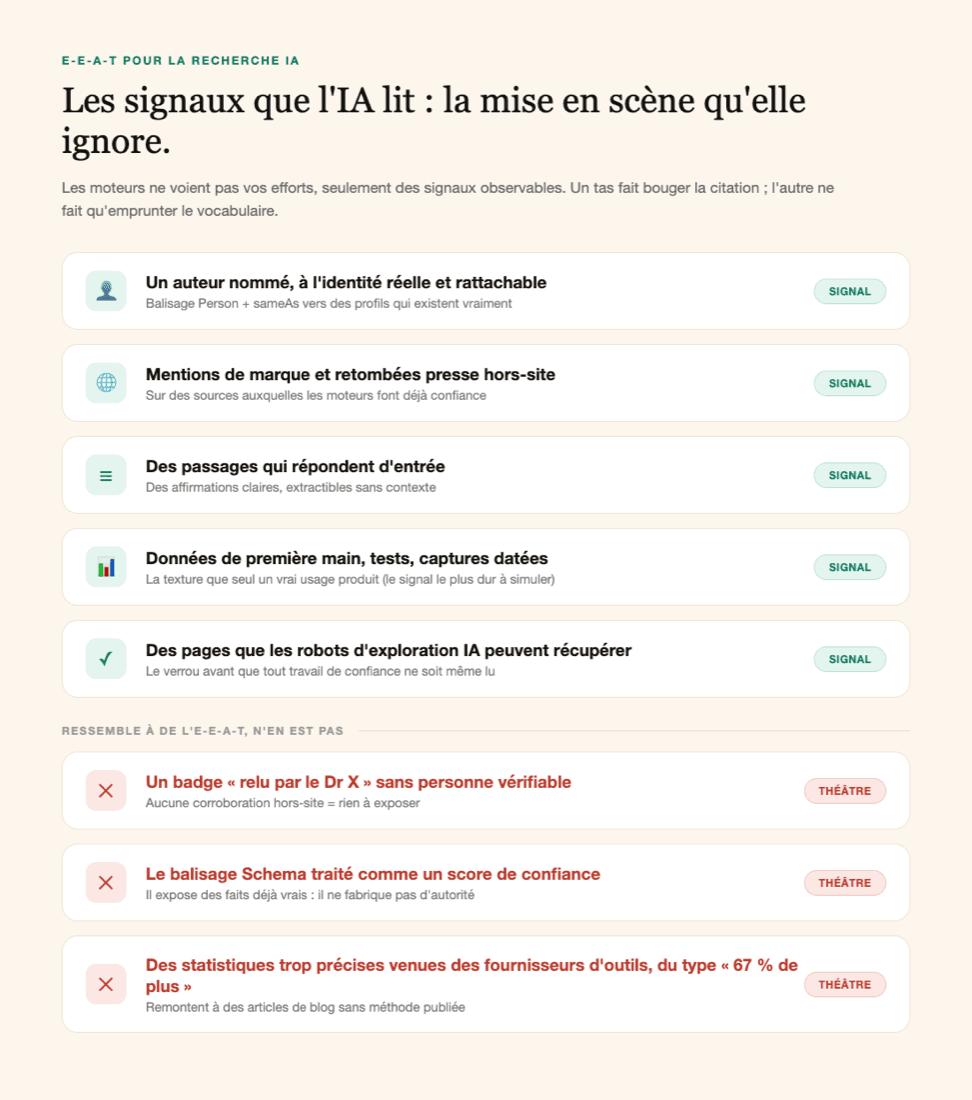
Une fois qu’on accepte que les moteurs déduisent la confiance à partir de signaux observables, la liste des tâches se trie en deux tas. L’un fait bouger la citation. L’autre n’est que du remplissage : il ressemble à de l’E-E-A-T parce qu’il en emprunte le vocabulaire.
| Ce qui compte | Mise en scène (ressemble à de l’E-E-A-T, n’en est pas) |
|---|---|
| Un auteur nommé, à l’identité réelle et rattachable (balisage Person et un sameAs vers des profils qui existent vraiment) | Un badge « relu par le Dr X » sans personne vérifiable derrière |
| Des mentions de marque hors-site et des retombées presse sur des sources auxquelles les moteurs font déjà confiance | Un balisage Schema traité comme un score de confiance en soi |
| Des passages qui répondent d’entrée, qu’un moteur peut extraire sans contexte | Un fichier llms.txt censé faire grimper les citations à lui seul |
| Des données originales de première main, des tests, des captures datées | Des statistiques trop précises venues des fournisseurs d’outils, du type « 67 % de citations en plus » |
| Des pages que les robots d’exploration IA peuvent réellement récupérer | Empiler des encarts auteur sur des pages que personne, hors du site, ne corrobore |
Deux éléments du côté mise en scène surprennent. Le Schema en fait partie. Il rend votre auteur et votre organisation lisibles par la machine, ce qui aide réellement un moteur à relier les points, mais c’est un révélateur de signal, pas un score de confiance. Quand Ahrefs a suivi 1 885 pages déjà citées qui ont ajouté du Schema, l’étude n’a trouvé aucun gain de citation notable. Utilisez le Schema pour exposer des faits déjà vrais, pas pour fabriquer de l’autorité.
L’autre, c’est toute la famille des statistiques de citation trop précises. Les chiffres du type « les passages qui répondent d’entrée obtiennent 67 % de citations en plus » remontent à des billets de blog publiés par des fournisseurs d’outils, sans méthodologie détaillée. Les constats qui tiennent dans la durée sont plus rudimentaires : de la fiabilité, de l’originalité, des pages extractibles, et des sources qui vous corroborent. Quand le travail d’écrire des pages que les LLM citent est bien fait, les citations suivent sans qu’un pourcentage magique n’y soit accolé.
Expérience contre expertise : le « E » sur lequel la plupart des contenus trichent
Les deux premiers E ne sont pas des synonymes, et cette différence est ce que la plupart des contenus ratent. L’expertise est un savoir théorique : un médecin capable de lister les symptômes de la grippe. L’expérience est vécue : un patient qui décrit ce que la grippe lui a fait ressentir. Google a ajouté l’Expérience parce que, pour beaucoup de requêtes, les lecteurs veulent la seconde version, et un résumé savant de ce que tout le monde sait déjà ne la remplace pas.
C’est aussi le signal le plus difficile à simuler, ce qui justifie d’y investir. On ne greffe pas une expérience de première main avec une simple signature. Elle se voit dans la texture que seul un vrai usage produit : le chiffre précis, la capture d’écran avec vos propres données dessus, ce détail qui a mal tourné et qu’aucun résumé ne mentionnerait, l’avant-après daté. Les moteurs comme les lecteurs récompensent ce détail, parce qu’il ne se fabrique pas à bon compte.
D’après notre expérience à auditer des pages citées face à des pages qui ne le sont jamais, les pages citables contiennent presque toujours quelque chose que l’auteur ne pouvait savoir qu’en le faisant vraiment. Les pages jamais citées se lisent comme une réécriture compétente du top 10, exactement ce qu’un modèle sait déjà produire seul, donc il n’a aucune raison d’y renvoyer qui que ce soit.
Les moteurs peuvent-ils distinguer une expérience réelle d’une simple mise en scène des qualifications ? Pas parfaitement, mais ils s’appuient sur la corroboration pour s’en approcher, et un contenu qui imite l’expertise sans aucune validation externe finit traité comme tel. La seule approche qui tienne n’est pas de jouer l’expérience, mais d’en avoir une, puis de la rendre extractible.
L’accessibilité aux robots : le verrou avant tout le reste
Il y a un signal qui se place devant tous les autres, et c’est celui que les équipes oublient. Un moteur qui parcourt le web ne peut pas citer une page qu’il n’arrive pas à récupérer. Si votre robots.txt bloque les robots d’exploration IA qui alimentent ces réponses, tout votre travail sur les signaux de confiance ne sera jamais lu, parce que la page n’entre jamais dans l’ensemble récupéré.
C’est une défaillance silencieuse et fréquente en visibilité IA, et l’une des plus faciles à corriger. OpenAI, Anthropic et Perplexity exploitent chacun un robot nommé (OAI-SearchBot, Claude-SearchBot, PerplexityBot) qu’on peut autoriser indépendamment les uns des autres, et il est fréquent d’en trouver un bloqué en silence par une règle par défaut ou un plugin de sécurité que personne n’a revérifié. Les AI Overviews de Google font exception : ils passent par le Googlebot classique, donc ce sont vos réglages de crawl et d’indexation habituels qui décident de l’inclusion, pas un robot IA séparé.
Vérifiez l'accessibilité avant tout le reste
L'AI Crawler Checker, gratuit, montre quels robots d’exploration IA votre robots.txt autorise ou bloque, avec la ligne exacte à corriger. Lancez-le avant d’investir dans les chantiers de confiance décrits plus haut.
L’accessibilité ne vous fait pas gagner une citation. Elle vous rend simplement éligible à en obtenir une. Traitez-la pour ce qu’elle est, un verrou : vérifiez-la en premier, puis construisez la confiance qui vous fera passer.
Comment mesurer votre E-E-A-T sans outil payant
Puisqu’il n’existe aucun score E-E-A-T, vous ne pouvez pas vérifier un chiffre. Mais vous pouvez vérifier ce dont ce score est censé être le reflet : ce que le web, et les moteurs qui le lisent, croient actuellement de vous. La plupart des conseils sur ce sujet renvoient tout droit vers une boîte à outils payante. Vous n’en avez pas besoin pour commencer.
La version gratuite prend dix minutes. Cherchez votre marque et vos sujets clés en excluant votre propre domaine (une requête votre marque -site:votredomaine.com), pour ne voir que ce que disent les autres sources. Puis posez aux moteurs (ChatGPT, Perplexity, les AI Overviews de Google) les questions que posent vos clients, et regardez qui est nommé. Vous cherchez trois choses : savoir si vous apparaissez, qui vous décrit, et si cette description est exacte. Le silence signifie généralement que vous n’avez pas encore franchi la barre de l’entité reconnue, même si cela peut aussi venir d’une variance de requête ou d’un sujet qui ne déclenche pas de réponse IA. Une description fausse signifie que la corroboration existe, mais pointe dans la mauvaise direction.
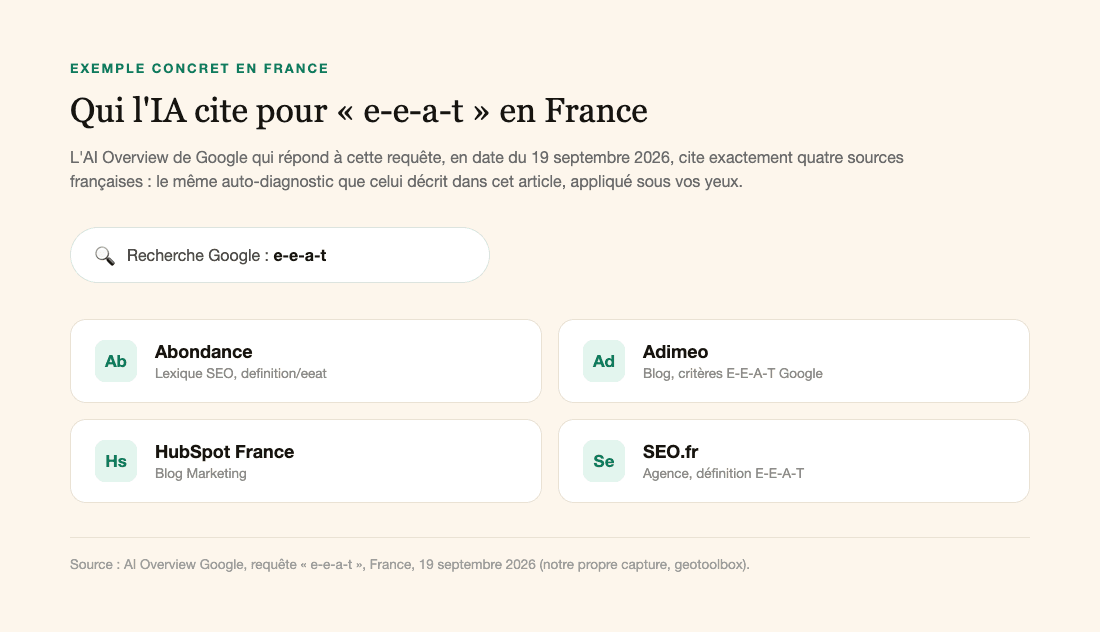
Un exemple concret, en France. Tapez « e-e-a-t » sur Google : l’AI Overview qui répond cite, au 19 septembre 2026, quatre sources françaises : Abondance, Adimeo, HubSpot France et SEO.fr. C’est ce même auto-diagnostic, appliqué sous vos yeux : sur ce terme précis, voilà les quatre entités auxquelles le système fait déjà confiance en français. Lancez la même requête sur votre propre sujet : la liste qui remonte vous dit où en est votre capital de confiance.
Google vous fournit un auto-diagnostic pour cela sans jamais nommer l’E-E-A-T. Ses consignes sur le contenu utile posent trois questions : qui a créé le contenu (y a-t-il un auteur réel et identifiable), comment il a été fabriqué (l’automatisation est-elle signalée), et pourquoi il existe (pour aider un lecteur, ou juste pour se classer). Ces trois questions recoupent précisément ce qu’un moteur IA peut vérifier : un auteur nommé qu’il peut résoudre, un contenu dont la provenance est claire, et un objectif qui n’est pas une manipulation évidente. Si vos pages ne répondent pas à Qui, Comment et Pourquoi, un moteur ne le peut pas non plus.
Ce passage manuel vous dit où vous en êtes. La version structurée, c’est ce qu’automatise notre diagnostic AI Readiness, et suivre cette mesure dans le temps est ce qui transforme un coup d'œil ponctuel en méthode pour mesurer la visibilité IA au fil de votre progression. Dans tous les cas, l’idée reste la même : arrêtez d’essayer de noter une page, et commencez à observer si les moteurs peuvent vous trouver, vous faire confiance et vous décrire correctement.
Les moteurs ne se ressemblent pas
Aucune méthode unique ne fonctionne à l’identique partout, parce que chaque moteur récupère et pondère ses sources différemment. Aucun d’eux ne publie de formule de confiance : lisez le tableau suivant comme des tendances observées, pas des facteurs figés.
| Moteur | D’où il tire ses réponses | Ce qu’il semble surpondérer |
|---|---|---|
| Google AI Overviews | Les pages que Google classe déjà (Googlebot classique) | Les mêmes signaux d’autorité qui pilotent le classement Google |
| ChatGPT (recherche) | Son propre index de recherche plus la mémoire d’entraînement du modèle | Les sources établies, largement référencées, et les marques connues |
| Perplexity | Son propre crawl, complété par des récupérations en direct | Les pages récentes et plusieurs sources indépendantes qui convergent |
| Gemini | L’index et le grounding de Google | Les entités reconnues que Google relie déjà dans son Knowledge Graph |
| Vibe (ex-Le Chat) de Mistral | Une recherche web en temps réel (mode Work), complétée par la lecture de pages via Open URL | Aucune pondération de confiance publiée ; les réponses issues du web citent leurs sources, et les requêtes d’actualité passent par les dépêches AFP et AP |
Une nuance que le tableau masque : un moteur peut nommer une marque connue directement depuis sa mémoire d’entraînement, sans aucune récupération. Devenir une entité, c’est un jeu de patience : faire partie de ce que le modèle sait déjà, pas seulement de ce qu’il peut aller chercher.
Un plan réaliste pour un site jeune ou petit
Si votre site est jeune et sans historique de liens, « construire son autorité » peut ressembler à une injonction à « être déjà célèbre ». Vous ne pouvez pas fabriquer des années de mentions de marque du jour au lendemain, mais vous pouvez privilégier les actions dont les effets s’accumulent le plus vite, y compris un plan ciblé pour obtenir des liens depuis des sites pertinents via les bonnes plateformes de link building.
Privilégiez la profondeur à l’étendue. Un seul sujet traité en profondeur, comme un cluster connecté plutôt qu’une page isolée, construit une autorité thématique qu’un moteur reconnaît plus vite que des articles éparpillés sur dix sujets. Associez cela à la seule chose qu’un concurrent plus gros ne peut pas copier : vos propres données de première main, vos propres tests, vos propres chiffres. L’originalité est le signal d’entité le moins cher qu’un petit site puisse produire, précisément parce que ce signal-là est réel.
Faites-vous ensuite mentionner là où votre audience discute déjà : dans des communautés, des podcasts, des comparatifs, partout où une source indépendante peut vous mentionner. Une poignée de mentions crédibles fait plus pour la citation IA qu’une nouvelle page auto-publiée.
Si vous êtes sur un sujet YMYL (santé, finance ou droit), la barre est plus haute. Les moteurs s’appuient davantage sur des auteurs nommés et diplômés, ainsi que sur la corroboration externe, et filtrent plus agressivement les affirmations douteuses : l’expérience de première main et un sourcing reconnu y pèsent encore davantage. La méthode complète pour optimiser son référencement IA détaille l’ordre des étapes. Pour faire court : l’accessibilité d’abord, l’originalité extractible ensuite, la corroboration en troisième.
Foire aux questions
L’E-E-A-T est-il un facteur de classement ?
Non. Google indique que l’E-E-A-T n’est pas un facteur de classement précis et qu’il n’existe aucun score E-E-A-T. C’est un cadre que ses quality raters utilisent pour juger un contenu, et leurs retours aident Google à ajuster ses systèmes de classement dans la durée. Vous optimisez pour les signaux qui y correspondent, pas pour un chiffre.
L’E-E-A-T compte-t-il pour ChatGPT et Perplexity ?
Au sens strict, non : ces moteurs n’appliquent pas le cadre E-E-A-T de Google. Mais ils récupèrent leurs sources sur un web déjà filtré par la recherche, et s’appuient sur les mêmes signaux de confiance sous-jacents : le travail que vous faites pour l’E-E-A-T est donc aussi ce qui vous rend éligible à une citation dans une réponse IA.
Pourquoi l’IA cite-t-elle Reddit plutôt que mon contenu expert détaillé ?
Parce que les moteurs IA pèsent la confiance au niveau de l’entité et préfèrent la corroboration. Reddit est une source reconnue, renforcée par des milliers de voix indépendantes, et liée à plusieurs moteurs par des accords de contenu, ce qui en fait une citation facile. Une page plus solide venant d’un domaine que le moteur voit rarement mentionné ailleurs lui inspire moins confiance, même si elle est meilleure sur le fond.
Le balisage Schema améliore-t-il les citations IA ?
Le Schema rend votre auteur et votre organisation lisibles par la machine, ce qui aide un moteur à relier votre contenu à une entité connue. Mais ce n’est pas un score de confiance en soi. Ahrefs a suivi 1 885 pages déjà citées qui avaient ajouté du Schema et n’a relevé aucun gain de citation notable : utilisez-le pour exposer des faits déjà vrais, pas pour fabriquer de l’autorité.
Écrire avec l’IA nuit-il à l’E-E-A-T ?
Pas en soi. Google indique juger le contenu sur sa qualité, pas sur le fait qu’il ait été produit par un humain ou par une IA, et ne traite comme spam que l’IA utilisée principalement pour manipuler le classement. Le vrai risque est plus subtil : l’IA excelle à produire la réécriture générique du top de résultats, exactement le type de contenu qu’un moteur a le moins de raisons de citer. Utilisez-la pour rédiger et éditer, puis ajoutez l’expérience de première main et les données originales qu’elle ne peut pas inventer.
Peut-on simuler l’E-E-A-T, et l’IA le repère-t-elle ?
Vous pouvez ajouter les marqueurs de surface (un encart auteur, une mention « relu par », une liste de diplômes), mais sans corroboration hors-site, ils ne font pas grand-chose. Les moteurs approximent l’expérience et l’autorité réelles via la validation externe, et un contenu qui imite l’expertise sans rien pour l’étayer finit traité comme tel.
Arrêtez de noter la page
L’E-E-A-T pour la recherche IA n’est ni une checklist à cocher ni un score à faire grimper. C’est la question de savoir si les moteurs peuvent accéder à votre contenu, faire confiance à l’entité qui le porte, et retrouver votre affirmation corroborée par une source à laquelle ils font déjà confiance. Réglez ces trois points et vous mettrez toutes les chances de votre côté pour être cité. Empilez des encarts auteur sur une page inaccessible et non corroborée, et vous n’irez nulle part, quel que soit le score obtenu sur un outil.
Si vous ne savez pas lequel des trois vous bloque, commencez par mesurer plutôt que par deviner. Notre diagnostic gratuit AI Readiness montre où vous en êtes sur l’accessibilité et les signaux de confiance que les moteurs IA lisent réellement, ce qui fait toute la différence entre optimiser une page et obtenir une citation. geotoolbox est le débogueur de robots IA que nous avons construit pour ça : voir votre site comme le voit un moteur de réponse, avant de passer un mois sur des signaux qu’il ne regardera jamais.
Sources
- Google Search Central, Creating Helpful, Reliable, People-First Content -
developers.google.com/search/docs/fundamentals/creating-helpful-content - Google Search Central Blog, Our latest update to the quality rater guidelines: E-A-T gets an extra E for Experience -
developers.google.com/search/blog/2022/12/google-raters-guidelines-e-e-a-t - Search Engine Land, Debunking common Google E-E-A-T misconceptions -
searchengineland.com/google-eeat-misconceptions-437445 - Ahrefs, E-E-A-T: How to Build Trust and Boost Web & AI Visibility -
ahrefs.com/blog/eeat-seo - Ahrefs, 76% of AI Overview Citations Pull From the Top 10 (juillet 2025) -
ahrefs.com/blog/search-rankings-ai-citations - Ahrefs, Update: 38% of AI Overview Citations Pull From The Top 10 (mars 2026) -
ahrefs.com/blog/ai-overview-citations-top-10 - Ahrefs, What Are ChatGPT’s Most Cited Pages? -
ahrefs.com/blog/chatgpts-most-cited-pages - Ahrefs, We Tracked 1,885 Pages That Added Schema Markup -
ahrefs.com/blog/schema-ai-citations - Ahrefs, AI Brand Visibility Correlations (75 000 marques) -
ahrefs.com/blog/ai-brand-visibility-correlations - Abondance, E-E-A-T (Expérience, Expertise, Autorité, Fiabilité) -
abondance.com/definition/eeat - Blog du Modérateur, AI Overviews : ce que les premières mesures de visibilité des médias français révèlent (étude The Black Room) -
blogdumoderateur.com/ai-overviews-premieres-mesures-visibilite-medias-francais-revelent - Mistral, Search the web (Vibe Work) -
docs.mistral.ai/vibe/work/web-search-open-url