
Wer nach „OKF vs. RAG“ sucht, stößt auf zwei Lesarten. Laut der einen hat Google RAG gerade beerdigt, laut der anderen haben die beiden nichts miteinander zu tun. Beide sind falsch.
Das Open Knowledge Format (OKF) und Retrieval-Augmented Generation (RAG) lösen unterschiedliche Probleme auf unterschiedlichen Ebenen. Sinnvoller ist deshalb nicht die Frage, wer gewinnt, sondern wo welches Werkzeug hingehört. Dazu zählt auch der Teil, den die meisten deutschsprachigen Beiträge bisher auslassen: was sich mit OKF v0.2 geändert hat.
Warum kuratiertes Wissen wichtig ist, zeigt ein kleiner Versuch. Im Juli 2026 haben wir KI-Modelle ohne Webzugriff gefragt, was OKF ist: Gemini erfand eine falsche Definition, Claude gab an, es nicht zu wissen. OKF erschien Mitte 2026, also nach dem Stichtag der Trainingsdaten beider Modelle. Richtig antworten kann hier nur ein Modell, das live auf das Web zugreift. Damit ist im Grunde schon alles gesagt, was dafür spricht, Wissen so aufzuschreiben, dass Maschinen es lesen können.
Das Wichtigste in Kürze
- OKF ersetzt RAG nicht: Das Open Knowledge Format, das Google Cloud am 12. Juni 2026 vorgestellt hat, ist ein Wissensformat, RAG ein Abrufverfahren; beide arbeiten auf unterschiedlichen Ebenen.
- Ein OKF-Bundle ist ein Verzeichnis aus Markdown-Dateien mit YAML-Frontmatter, ein Konzept pro Datei; Pflicht ist nur das Feld
type. - Die aktuelle Version 0.2 (von Google am 25. Juli 2026 vorgestellt) ergänzt eine Vertrauensebene mit
sources,verifiedundstale_after, für die es bei RAG keinen Standard gibt. - In der Praxis setzt sich eine Hybridlösung durch: ein kleiner kuratierter Kern stabiler, kritischer Fakten in OKF, der große unstrukturierte Rest in RAG.
- Für SEO ist OKF Stand November 2026 kein Rankingfaktor, und kein großer Crawler liest Bundles automatisch ein. Wer ein Bundle veröffentlicht, sollte wegen der DSGVO vorher personenbezogene Akteurskennungen durch Rollen- oder Team-Kennungen ersetzen.
Was ist das Open Knowledge Format (OKF)?
Das Open Knowledge Format (OKF) ist eine offene, herstellerneutrale Spezifikation von Google Cloud, mit der du KI-Agenten kuratiertes Wissen als einfache Markdown-Dateien übergibst. Google Cloud hat sie am 12. Juni 2026 vorgestellt. Die Idee: Fakten, die ein Unternehmen schon kennt und für richtig hält, werden einmal sauber aufgeschrieben, damit ein Agent sie direkt lesen kann, statt sie bei jeder Frage aus Rohdokumenten neu herzuleiten. Nicht zu verwechseln mit der Open Knowledge Foundation Deutschland, die ebenfalls als OKF auftritt.
Das Format selbst ist bewusst unspektakulär, und genau darin liegt sein Wert. Ein OKF-Bundle ist ein Verzeichnisbaum aus Markdown-Dateien: ein Konzept pro Datei, jede mit einem kleinen YAML-Frontmatter. Ein Konzept kann eine Metrikdefinition sein, ein Datenbankschema, eine Geschäftsregel, eine API, ein Runbook oder eine Richtlinie. Die Dateien verweisen über gewöhnliche Markdown-Links aufeinander. So entsteht ein schlanker Wissensgraph, durch den sich ein Agent bewegen kann, statt einen Haufen loser Seiten vor sich zu haben.
Laut der OKF-Spezifikation ist type das einzige Feld, das immer verpflichtend ist. Ein Konzept, das nur type enthält, ist bereits gültig. Empfohlene Felder (title, description, resource, tags) liefern Kontext, und zwei reservierte Dateinamen sorgen für die Struktur. index.md listet den Inhalt eines Verzeichnisses auf, damit sich ein Agent schrittweise vorarbeiten kann, und log.md hält den Änderungsverlauf fest.
Neu ist die Idee nicht. OKF macht einen Standard aus dem „LLM-Wiki“-Muster, das Andrej Karpathy im April 2026 beschrieben hat. Gemeint ist eine dauerhafte Sammlung von Markdown-Dateien, die ein Agent pflegt: Das Wissen wird einmal verdichtet und danach aktuell gehalten, statt bei jeder Anfrage neu zusammengesetzt zu werden. OKF gibt diesem Muster einen gemeinsamen Vertrag, sodass jeder Agent und jeder Anbieter dasselbe Bundle lesen kann.
Zwei Vorbehalte gibt es. Erstens kommt OKF von Google Cloud und steht unter der Apache-2.0-Lizenz. Die Spezifikation lag zuerst im Repository des Knowledge Catalog und ist im August 2026 in ein eigenes Repository umgezogen. Ein offener Pull Request vom November 2026 kündigt den Umzug in eine herstellerneutrale GitHub-Organisation an. Zweitens ist OKF jung: Zum Start gab es drei Beispiel-Bundles (GA4-E-Commerce, Stack Overflow und Bitcoin), mit v0.2 kam ein viertes dazu. Das Ökosystem drumherum ist Stand November 2026 noch klein.
Was ist RAG, und wo stößt es an Grenzen?
Retrieval-Augmented Generation (RAG) ist der Standardweg, ein Sprachmodell mit Wissen zu verbinden, auf das es nicht trainiert wurde. Du nimmst einen großen Dokumentenbestand, zerlegst jedes Dokument in Chunks, wandelst diese Chunks in Vektoren um und holst bei jeder Anfrage die Abschnitte, die der Frage am nächsten liegen, bevor das Modell antwortet. Für einen großen, heterogenen Bestand, der ständig in Bewegung ist, funktioniert das gut, und daran wird sich so bald nichts ändern.
Schwierig wird es, wenn RAG Wissen liefern soll, das klein, stabil und ständig gefragt ist, etwa die Definition eines aktiven Nutzers in deinem Unternehmen. Klassisches RAG speichert so eine Definition nicht als feststehenden Fakt. Es leitet sie bei jeder Abfrage aus Chunks neu her, und dabei treten vier typische Fehler auf.
Der erste ist das Chunking. Wer Dokumente in Abschnitte fester Länge zerlegt, zerschneidet dabei auch logische Einheiten, und ein Chunk kann für sich genommen irrelevant wirken, obwohl er die Antwort enthält. Der zweite: Vektorähnlichkeit belohnt Text, der relevant aussieht, nicht Text, der stimmt. Ein Abschnitt, der im Vektorraum nah an deiner Frage liegt, kann trotzdem der falsche sein, und bei einem präzisen technischen Fakt ist „fast richtig“ falsch.
Der dritte Fehler: Diese Pannen bleiben unsichtbar. RAG meldet selten einen Fehler. Es liefert eine flüssige, plausible Antwort, die knapp danebenliegt, und das ist bei einem kritischen Fakt der teuerste Fall. Der vierte betrifft die Struktur: In einem einfachen Vektor-Setup bekommt das Modell eine lose Sammlung von Chunks ohne ausgewiesene Beziehungen, also muss es jede Verbindung zwischen zwei Fakten erschließen, statt sie zu lesen. (Graph-basierte und hierarchische RAG-Varianten gleichen das teilweise aus, allerdings um den Preis zusätzlicher Infrastruktur.)
Schlecht ist RAG deshalb nicht. Es ist nur das falsche Werkzeug für den Teil des Wissens, der bereits kuratiert ist und jedes Mal exakt stimmen muss. Genau für diese Lücke ist OKF gebaut.
OKF vs. RAG: der Kernunterschied
Am einfachsten merkst du dir das so: RAG ist ein Abrufverfahren, OKF ist ein Wissensformat. Beide setzen an verschiedenen Stellen an, und deshalb ist „OKF vs. RAG“ für die meisten Entscheidungen die falsche Frage. Das eine legt fest, wie ein Agent Informationen findet. Das andere legt fest, wie diese Informationen überhaupt aufgeschrieben werden.
RAG behandelt Wissen als großen Textbestand, den man bei jeder Anfrage durchsucht. OKF behandelt eine festgelegte Menge von Konzepten als dauerhafte Fakten, die bei Bedarf gelesen werden. Während RAG die Bedeutung aus den Chunks rekonstruiert, die gerade am besten ranken, übergibt ein OKF-Bundle dem Agenten ein Konzept, das jemand bereits richtig formuliert hat, samt ausdrücklich benannten Beziehungen zu anderen Konzepten.
| OKF (Open Knowledge Format) | RAG (Retrieval-Augmented Generation) | |
|---|---|---|
| Art des Wissens | Kuratierte, bekannte Fakten, die du benennen kannst | Groß, unstrukturiert, „steht hier irgendwo drin“ |
| Zugriff des Agenten | Liest eine Konzeptdatei direkt | Ruft bei jeder Anfrage Chunks ab und sortiert sie neu |
| Struktur | Expliziter Graph über Markdown-Links | Lose Chunks, Beziehungen werden erschlossen |
| Herkunft und Vertrauen | Standardisierte Felder (sources, verified) | Metadaten je Implementierung, nicht standardisiert |
| Aktualität | Festgelegt über stale_after | Hängt davon ab, wie oft der Bestand neu indexiert wird |
| Einsatzgebiet | Stabile, kritische Fakten | Long Tail, explorative Suche |
Schau dir die Zeilen zu Herkunft und Aktualität genauer an. An diesen beiden Stellen standardisiert OKF v0.2 etwas, das beim Retrieval jeder Implementierung selbst überlassen bleibt.
Die Vertrauensebene von v0.2: Was OKF standardisiert und RAG nicht
Entscheidend ist Version 0.2. Sie liegt seit dem 24. Juli 2026 im Repository, und Google hat sie am 25. Juli vorgestellt. Stand 9. November 2026 ist sie die aktuelle veröffentlichte Fassung; eine v0.3 ist bisher nur in einem offenen Pull Request angekündigt. Version 0.2 ergänzt die Spezifikation um eine Art Vertrauensebene, und wer OKF und RAG als Entweder-oder behandelt, übersieht ausgerechnet diese Ebene. Die meisten deutschsprachigen Beiträge zu OKF, etwa die von heise und SEO Südwest vom Juni 2026, beschreiben noch v0.1 und lassen diese Ebene aus.
RAG kann dir sagen, was in einem Abschnitt steht. Wer ihn geschrieben hat, ob ihn jemand geprüft hat und ob er noch stimmt, sieht das Grundmuster nicht vor. Einzelne RAG-Systeme können das als Chunk-Metadaten nachrüsten, aber jedes Team erfindet dafür sein eigenes Schema. OKF v0.2 legt diese Angaben als gemeinsamen Vertrag im Frontmatter fest, und zwar in den folgenden optionalen Feldgruppen.
| Gruppe | Wichtige Felder | Beantwortet die Frage |
|---|---|---|
| Herkunft | sources (mit Signalen je Quelle wie usage_count) | Woher stammt das, und wie stark wird es genutzt? |
| Vertrauen | generated, verified | Wer hat es erzeugt, und wer hat es bestätigt? |
| Lebenszyklus | status, stale_after | Ist es aktuell, und wann läuft es ab? |
| Attestierung | runtime, computation, attester (bei Konzepten vom Typ Attested Computation) | Wurde dieser Wert tatsächlich berechnet, und womit? |
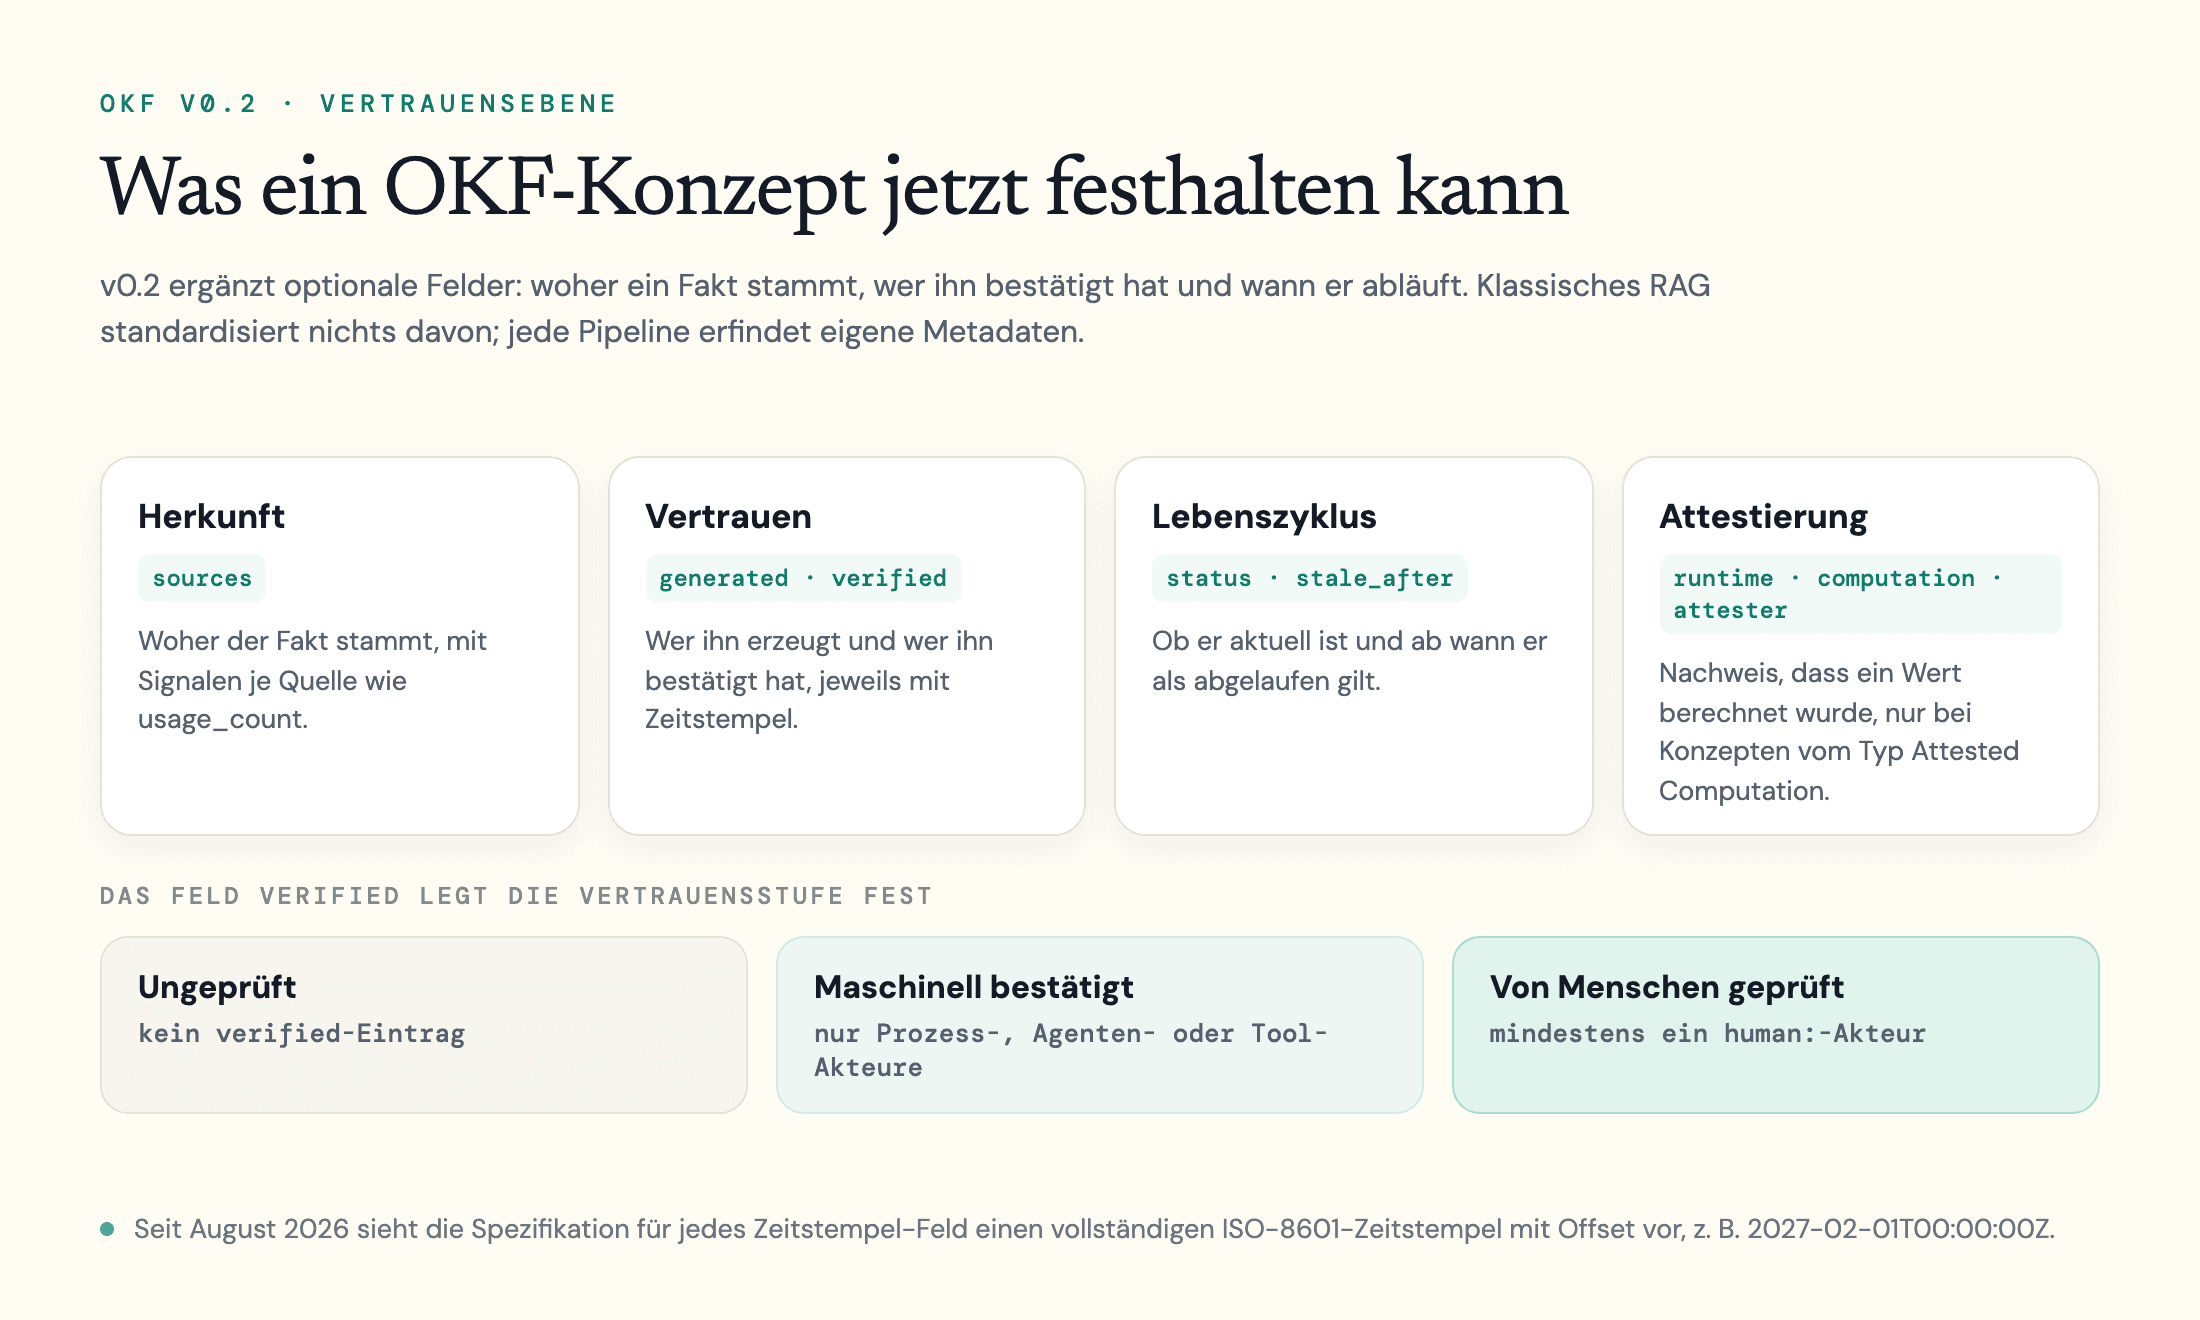
Im Zentrum steht das Feld verified. Es macht aus einer einfachen Datei eine Aussage mit Vertrauensstufe: ungeprüft, maschinell bestätigt oder von Menschen geprüft (erkennbar an einem Akteur mit dem Präfix human:). Ein Agent kann eine von Menschen geprüfte Metrikdefinition also anders behandeln als eine ungeprüfte Notiz. Ein Vektorspeicher kann das ebenfalls als Metadaten mitführen, aber bei OKF ist es ein definiertes Feld, das jeder Leser gleich auslegt, statt einer Konvention je Pipeline. Deshalb hat v0.2 auch das bisherige Einzelfeld timestamp aus v0.1 zu generated: { by, at } umgebaut: Festgehalten wird jetzt, wer einen Fakt erzeugt hat und wann, nicht nur ein bloßes Datum.
So sieht ein Konzept mit den v0.2-Feldern aus:
---
type: metric
title: Weekly Active Users
verified:
  - { by: "human:data-team", at: 2026-11-02T09:00:00Z }
stale_after: 2027-02-01T00:00:00Z
sources:
  - id: wau-sql
    resource: /queries/weekly-active-users.sql
    title: WAU definition query
---
Seit August 2026 sieht die Spezifikation für jedes Zeitstempel-Feld im Frontmatter einen vollständigen ISO-8601-Zeitstempel mit Offset vor, also 2027-02-01T00:00:00Z statt nur 2027-02-01. Reine Datumsangaben gelten weiterhin als konform.
stale_after ist das unauffälligste Feld. Klassisches RAG kennt kein eingebautes Ablaufdatum für Fakten: Solange du keine eigene TTL-Logik ergänzt, liegt ein veralteter Chunk genauso abrufbar im Index wie ein frischer. Bei OKF bringt das Wissen sein Ablaufdatum selbst mit. Dass ein Fakt veraltet ist, bleibt damit kein unsichtbarer Fehler mehr, sondern steht in einem Feld, das du abfragen und auf das du reagieren kannst. Zusammen mit dem Block sources gibt das einem Bundle eine Art Fundierung und Nachvollziehbarkeit, die ein Retrieval-Index von Haus aus nicht mitbringt.
Ersetzt OKF RAG? Die hybride Aufteilung
Nein. Die Schlagzeilen, die OKF zum RAG-Killer erklären, erzählen eine zu glatte Geschichte. Wer tatsächlich Systeme mit OKF baut, sieht das differenzierter.
Die gängige Praxis ist eine Hybridlösung, und die Aufteilung ist ungleich. Der kleine Teil der Fakten, der stabil, kritisch und ständig gefragt ist (Metrikdefinitionen, Geschäftsregeln, Schemata, regulierte Angaben), liegt in OKF: einmal aufgeschrieben, direkt gelesen. Die große Mehrheit, also der Long Tail aus unstrukturierten PDFs, Tickets, Logs und sich ändernden Dokumenten, bleibt in RAG, weil Retrieval dort die einzige vernünftige Option ist.
Ein Router vor dem Agenten entscheidet, welchen Weg eine Anfrage nimmt: Ein schlanker Klassifikator oder der Agent selbst schickt bekannte Fakten ans Bundle und alles andere an den Vektorspeicher. Das Bundle erreicht das Modell wie jede andere Datei, über ein Werkzeug zum Lesen von Dateien oder als MCP-Ressource. Mit index.md überfliegt der Agent zuerst ein Verzeichnis und lädt dann nur das eine Konzept, das er braucht, statt das ganze Bundle ins Kontextfenster zu holen.
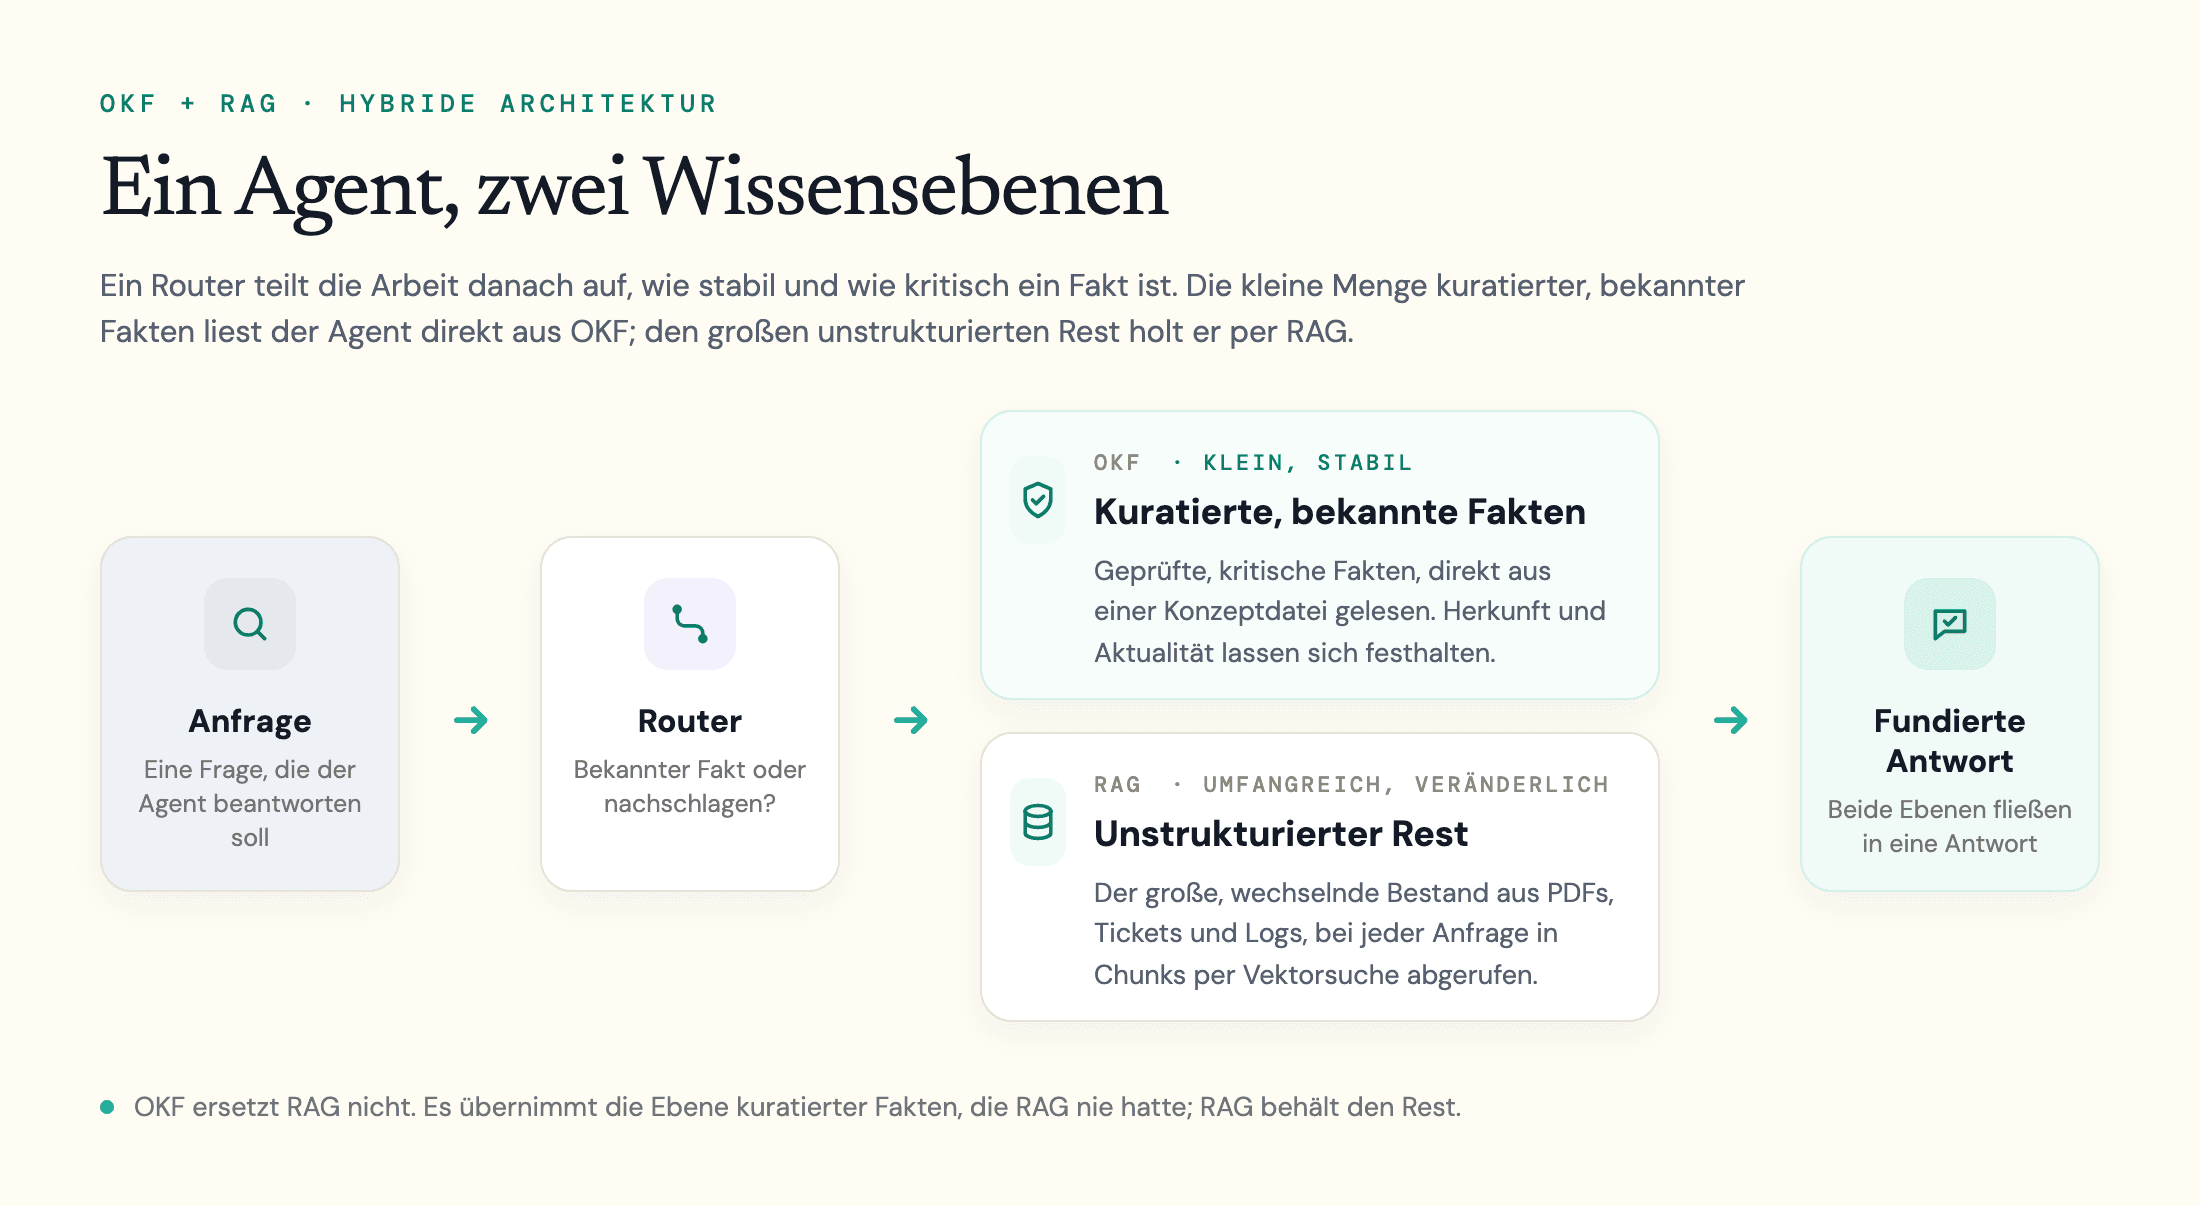
Auf Speicherebene schließen sich die beiden nicht einmal aus. Ein OKF-Bundle besteht aus sauberem, gut strukturiertem Markdown, und das ist nahezu ideales Ausgangsmaterial für eine RAG-Chunking-Pipeline: Lässt du Retrieval auf das Bundle los, bekommst du bessere Chunks als aus den Rohdokumenten. OKF verbessert das Wissen selbst, RAG sorgt weiterhin dafür, dass es auch in großen Beständen gefunden wird.
Zur Fairness gehört, auch die Minderheitsposition zu nennen. Einige Autoren, darunter Alphamatch, argumentieren, OKF mache RAG in vielen Agenten-Szenarien im Unternehmen überflüssig, weil es reine Verschwendung sei, stabile Fakten immer wieder aus Chunks zu holen. Für diesen Teil haben sie recht. Aber „ersetzt RAG für Fakten, die du schon kuratiert hast“ ist eine viel engere Aussage als „ersetzt RAG“. Die pauschale Behauptung bricht in dem Moment zusammen, in dem dein Agent etwas außerhalb dieser kuratierten Menge braucht.
Die klare Antwort auf die Frage, ob RAG 2026 überholt ist: OKF verdrängt die Vektorsuche bei kuratierten Fakten, die du gezielt abrufen kannst, und lässt den Long Tail, wo er ist.
Wann OKF, wann RAG, wann beides?
Lass die Schlagworte beiseite und stell dem Wissen selbst vier Fragen: Wie groß ist es? Wie oft ändert es sich? Wie wichtig ist es, dass der Agent richtig liegt? Und wie oft wird es wiederverwendet? Aus den Antworten ergibt sich das passende Werkzeug.
| Deine Situation | Einsatz | Warum |
|---|---|---|
| Metrikdefinitionen, Geschäftsregeln, Schemata | OKF | Klein, stabil, ständig genutzt, muss exakt stimmen |
| Millionen Support-Tickets, PDFs, Logs | RAG | Zu groß und zu unstrukturiert, um es von Hand zu kuratieren |
| Regulierte Fakten, bei denen der Agent nie danebenliegen darf | OKF | Ein verified-Eintrag mit human:-Akteur belegt die Prüfung durch einen Menschen |
| Schnell wechselnder, explorativer Recherchebestand | RAG | Kuratierung kommt mit dem Tempo nicht mit |
| Ein Unternehmensagent, der beides braucht | Hybrid | Bekannte Fakten an OKF, den Long Tail an RAG |
Die Regel hinter der Tabelle ist einfach: Wenn du den Fakt benennen kannst und ein Fehler teuer wäre, kuratiere ihn in OKF. Ist das Wissen ein Heuhaufen, den du gelegentlich durchsuchst, lass es in RAG. Die meisten Systeme in der Praxis landen bei der letzten Zeile, weil produktive Agenten beides brauchen: eine Handvoll Dinge, bei denen sie sicher sind, und einen großen Bestand, in dem sie nachschlagen können.
Eine Entscheidung solltest du früh treffen: was in den kuratierten Kern gehört. Die Versuchung ist groß, zu viel zu kuratieren und OKF in ein zweites, ungepflegtes Wiki zu verwandeln. Der Maßstab: häufige Nutzung bei hohem Fehlerrisiko. Liest ein Agent einen Fakt bei fast jeder Aufgabe und richtet eine falsche Antwort echten Schaden an, bekommt dieser Fakt eine eigene Konzeptdatei. Alles andere bleibt im Retrieval.
Bei den Kosten gilt dieselbe Logik. Für die Fakten im Bundle spart OKF Embedding-Kosten, eine Vektordatenbank und Abruflatenz. Viele Konzeptdateien zu laden, kostet dafür Kontext-Token und skaliert nicht auf Tausende Dateien. Auch das spricht für die Aufteilung: ein kleiner kuratierter Kern in OKF, der Großteil in RAG.
OKF vs. Wissensgraph, Wiki und llms.txt
Der häufigste Einwand gegen OKF lautet, es sei nichts Neues. Er verdient eine ernsthafte Antwort, denn er ist halb richtig. Ein Ordner voller Markdown-Dateien mit Metadaten ist keine neue Erfindung. Neu ist der gemeinsame Vertrag.
Gegenüber einem formalen Wissensgraphen tauscht OKF Ausdrucksstärke gegen Wartbarkeit. Ein Triple Store mit eigener Abfragesprache erlaubt komplexere Abfragen über den Graphen, verlangt aber auch Spezialwerkzeuge und Leute, die sie beherrschen. OKF besteht aus lesbaren Dateien, die jeder im Team im Texteditor bearbeiten und per Pull Request in Git prüfen kann. Die Graphstruktur bekommst du über Querverweise, ohne Graphdatenbank.
Gegenüber einem Wiki, einem Obsidian-Vault oder einer CLAUDE.md liegt der Unterschied in der Standardisierung. Das alles funktioniert, aber jede Lösung ist eine Eigenkonstruktion. OKF legt die Frontmatter-Felder und das Pflichtfeld type fest, sodass jeder Agent und jeder Anbieter, der OKF spricht, dein Bundle ohne eigenen Parser lesen kann. Im Kern geht es bei OKF um Portabilität, und deshalb greift der Vorwurf „ist doch nur ein Ordner“ zu kurz.
OKF und die llms.txt ergänzen sich, statt miteinander zu konkurrieren. Eine llms.txt ist ein Wegweiser: ein kuratiertes Verzeichnis, das einem Agenten zeigt, wo er auf deiner Website suchen soll. OKF ist das strukturierte Wissen, das der Agent liest, sobald er dort ankommt. SEO Südwest bringt es auf die Formel: „llms.txt nach außen für fremde Crawler, OKF nach innen für die eigenen Agenten.“ Du kannst beides veröffentlichen. Für die Auffindbarkeit durch KI greifen beide sauber mit Schema-Markup und Entitätsdaten ineinander, als Ebenen derselben Aufgabe: dein Wissen für Maschinen lesbar zu machen.
OKF ist also kein Durchbruch in der Datenmodellierung. Es ist ein Standard rund um ein Muster, das schon vorher funktioniert hat. Das klingt weniger aufregend, ist aber nützlicher.
So erstellst und hostest du ein OKF-Bundle
Ein Bundle zu bauen, ähnelt eher dem Schreiben einer Dokumentation als dem Aufsetzen einer Datenbank. Es sind nur wenige Schritte.
Du beginnst mit einem Verzeichnis, in dem jedes Konzept eine eigene Markdown-Datei bekommt. Jede davon erhält ein YAML-Frontmatter mit mindestens type, dazu die empfohlenen Felder title und description. Die v0.2-Felder verified und stale_after ergänzt du überall dort, wo ein Fakt kritisch genug ist. Verwandte Konzepte verknüpfst du mit normalen Markdown-Links, damit der Agent zwischen ihnen wechseln kann. Auf jeder Ebene legst du eine index.md an, damit der Agent zuerst die Übersicht liest und dann nur die Konzeptdatei öffnet, die er braucht. Das Ergebnis sieht etwa so aus:
okf/
  index.md
  metrics/
    weekly-active-users.md
    revenue.md
  policies/
    refund-policy.md
Dann geht es ans Hosting. Ein Bundle besteht nur aus Dateien, entsprechend einfach sind die Möglichkeiten: in ein Git-Repository committen, als Tarball ausliefern oder auf deiner Website unter einem Pfad wie /okf/ bereitstellen. Nichts davon setzt Vertex AI, eine Vektordatenbank oder ein Google-Konto voraus. Das ist mit „herstellerneutral“ konkret gemeint, zumindest auf dem Papier. Außerhalb von Google ist die Unterstützung bisher aber gering. Googles eigener Knowledge Catalog liest OKF-Bundles ein, und LangChains Open-Source-Tool OpenWiki schreibt seine Wikis seit Version 0.2 (Juli 2026) im OKF-Format. AWS hat außerdem ein Open-Source-Beispiel veröffentlicht, das Daten in OKF-Bundles überführt und sie Agenten per MCP bereitstellt. Abgesehen davon hat bis November 2026 kein weiterer großer Cloud-, Modell- oder Datenplattform-Anbieter OKF-Unterstützung in ein Produkt eingebaut.
Bevor du etwas veröffentlichst, ein Hinweis: Ein Bundle aus Metrikdefinitionen, Geschäftsregeln und Schemata ist internes Wissen. Mach öffentlich nur zugänglich, was öffentlich sein soll, und halte sensible Konzepte hinter einer Anmeldung oder ganz aus dem öffentlichen Verzeichnis heraus. Prüf dabei auch die Akteursfelder: Eine Kennung wie human:kliu@acme aus Googles eigenem v0.2-Beispiel verweist auf eine konkrete Person und ist damit ein personenbezogenes Datum im Sinne von Art. 4 Nr. 1 DSGVO. Nutze im öffentlichen Bundle Rollen- oder Team-Kennungen wie human:data-team. Das Präfix human: behältst du bei, damit die Stufe „von Menschen geprüft“ erhalten bleibt. Eine Rolle, die nur eine Person innehat, ist allerdings nicht anonym.
Das nützlichste Praxisbeispiel stammt vom GEO-Praktiker Suganthan Mohanadasan. Er hat seine veröffentlichten Texte in ein öffentliches Bundle umgewandelt und einen kostenlosen Generator gebaut, der ohne eine Zeile Code aus einer Website oder Sitemap ein OKF-Bundle erzeugt. Stand November 2026 umfasst sein Bundle 81 Konzepte; nur 20 davon tragen einen verified-Eintrag, und bei acht ist das stale_after-Datum bereits überschritten. So soll die Vertrauensebene wirken: Das Wartungssignal steht sichtbar in der Datei, statt in einem veralteten Index zu verschwinden (seine stale_after-Werte nutzen noch das ältere reine Datumsformat). Googles Beispiel-Bundles sind ein weiterer Einstieg, wenn du lieber etwas anpasst, als bei null anzufangen.
Damit die Erwartungen stimmen: Stand November 2026 liest kein großer Crawler OKF-Bundles automatisch ein. Ein Bundle zu veröffentlichen, ist eine Wette darauf, wohin sich agentenfähige Websites entwickeln, kein Hebel, der schon heute Traffic bringt.
OKF und KI-Sichtbarkeit: Sollten SEOs jetzt einsteigen?
Kurz beantwortet: Für internes Agentenwissen solltest du OKF jetzt einsetzen. Für die öffentliche KI-Sichtbarkeit ist es eine günstige Wette, keine Ranking-Taktik.
Für SEO-Teams nennt SEO Südwest einen naheliegenden internen Einsatz: Wer für mehrere Kunden Inhalte produziert, kann Briefings, Keyword-Maps, Redaktionsrichtlinien und frühere Analysen in einem internen Bundle zusammenführen, damit die eigenen KI-Agenten auf demselben Wissensstand arbeiten.
Ein OKF-Bundle zu veröffentlichen, ist ein günstiger, risikoarmer Weg, jedem Agenten, der deine Website liest, kuratierte Fakten zu übergeben, und es passt gut zu den anderen Ebenen der Maschinenlesbarkeit. GEO-Praktiker experimentieren aus diesem Grund schon damit, darunter Marie Haynes. Einen nachgewiesenen Effekt auf Zitate oder Rankings gibt es aber nicht, und die Skeptiker auf r/TechSEO haben recht: OKF wurde für Unternehmenswissen gebaut, nicht für die Suche. SEO Südwest schrieb dazu am 15. Juni 2026: „Es wird nicht von GPTBot oder Googlebot eingelesen. Für die klassische Suchmaschinenoptimierung ändert OKF deshalb erst einmal wenig.“ Schwerer wiegt die Frage der Verbreitung: OKF könnte ein weiterer Google-Standard werden, den niemand nutzt, in einer Reihe mit Protokollen, die Google veröffentlicht und stillschweigend wieder fallen gelassen hat. In der Datenwelt gibt es reichlich Formate, aus denen nie etwas wurde.
Wägst du beides nüchtern ab, ist der nächste Schritt klein. Ein Bundle für deine eigenen Agenten lohnt sich sofort, weil es reale RAG-Schwächen bei Fakten behebt, bei denen sich dein Agent keinen Fehler leisten kann. Die öffentliche Variante ist spekulativ. Das ist in Ordnung, solange du sie so behandelst und keine Ranking-Sprünge erwartest.
Wer ohnehin wissen will, ob KI-Systeme die eigene Website lesen und zitieren können, stellt mit OKF dieselbe Frage, nur nach innen an Agenten gerichtet statt nach außen an Suchmaschinen. Genau diese Frage stellen wir bei geotoolbox, wenn wir prüfen, ob KI-Crawler eine Website erreichen und verarbeiten können. Das Format ist neu, die Aufgabe nicht: Maschinen sollen dein Wissen lesen können.
Fazit
OKF ist nicht das Ende von RAG. Es ist die Ebene kuratierter Fakten, die RAG nie hatte. Eine sinnvolle Architektur nutzt beides: OKF für die kleine Menge an Dingen, bei denen dein Agent sicher sein muss, RAG für den großen Bestand, in dem er nachschlägt. Der eigentliche Fortschritt ist die Vertrauensebene von v0.2 mit Herkunft, Vertrauensstufen und Ablaufdatum, und auf sie solltest du bauen, nicht auf die Schlagzeile „RAG ist tot“.
Wenn du dich mit OKF beschäftigst, weil KI-Systeme dein Wissen richtig lesen sollen, geht es dir um dieselbe Frage, die auch darüber entscheidet, ob KI-Suchmaschinen dich überhaupt zitieren. Bevor du entscheidest, was du als Nächstes strukturierst, zeigt dir unser kostenloser KI-Readiness-Check, wo deine Website steht: Er prüft, ob Agenten und KI-Crawler deine veröffentlichten Inhalte tatsächlich erreichen und verarbeiten können.
Häufige Fragen
Ist RAG 2026 überholt?
Nein. OKF ersetzt RAG nur für den Teil des Wissens, der klein, stabil und bereits kuratiert ist. Für den Long Tail aus großen, unstrukturierten und sich ändernden Inhalten bleibt Retrieval das richtige Werkzeug, und die meisten produktiven Systeme nutzen beides.
Ersetzt OKF die Vektordatenbank?
Im Allgemeinen nicht. Stabile Fakten musst du nicht mehr aus einem Vektorspeicher abrufen, aber alles außerhalb deiner kuratierten Konzepte braucht weiterhin Retrieval. In hybriden Setups kann ein OKF-Bundle die RAG-Pipeline sogar mit sauberem Ausgangsmaterial versorgen, statt sie zu ersetzen.
Was ist der Unterschied zwischen OKF und einem Wissensgraphen?
Ein formaler Wissensgraph speichert Fakten als abfragbare Tripel und braucht Spezialwerkzeuge. OKF bekommt seine Graphstruktur über Markdown-Querverweise und bleibt dabei für Menschen lesbar und Git-tauglich. Du büßt etwas an Abfragemöglichkeiten ein und hast dafür deutlich weniger Pflegeaufwand.
Ist OKF ein SEO-Rankingfaktor?
Es gibt keinen Beleg dafür, dass OKF Rankings beeinflusst. OKF wurde für internes Agentenwissen entwickelt, nicht für die Suche, und noch liest kein großer Crawler Bundles automatisch ein. Ein Bundle zu veröffentlichen, ist eine Wette auf die Lesbarkeit für Agenten; mit einem Ranking-Gewinn solltest du nicht rechnen.
Quellen
- How the Open Knowledge Format can improve data sharing - Google Cloud (offizielle OKF-Ankündigung, 12. Juni 2026, mit den Beispiel-Bundles) -
cloud.google.com/blog/products/data-analytics/how-the-open-knowledge-format-can-improve-data-sharing - Open Knowledge format v0.2 tackles agentic trust - Google Cloud (Ankündigung von v0.2, 25. Juli 2026: Herkunft, Vertrauen, Lebenszyklus, Attestierung) -
cloud.google.com/blog/products/data-analytics/okf-v0-2-adds-trust-signals - SPEC.md - GoogleCloudPlatform/open-knowledge-format, GitHub (die v0.2-Spezifikation: Pflichtfelder, Vertrauensebene, ISO-8601-Zeitstempel; Apache 2.0; seit August 2026 hier statt unter knowledge-catalog/okf) -
github.com/GoogleCloudPlatform/open-knowledge-format/blob/main/SPEC.md - Open Knowledge Format: KI-Wissen als Markdown-Dateien - heise online (Moritz Förster, 15. Juni 2026; beschreibt v0.1 und die Integration in den Knowledge Catalog) -
heise.de/news/Open-Knowledge-Format-KI-Wissen-als-Markdown-Dateien-11332215.html - Google stellt das Open Knowledge Format (OKF) vor - SEO Südwest (Christian Kunz, 15. Juni 2026; OKF als internes Format, nicht von GPTBot oder Googlebot eingelesen) -
seo-suedwest.de/10825-google-stellt-das-open-knowledge-format-okf-vor.html - Verordnung (EU) 2016/679 (DSGVO), Art. 4 Nr. 1 - EUR-Lex (Begriff der personenbezogenen Daten) -
eur-lex.europa.eu/legal-content/DE/TXT/HTML/?uri=CELEX:32016R0679 - llm-wiki - Andrej Karpathy, GitHub Gist (das LLM-Wiki-Muster, das OKF standardisiert, April 2026) -
gist.github.com/karpathy/442a6bf555914893e9891c11519de94f - OpenWiki 0.2 brings OKF to codebase documentation - LangChain (16. Juli 2026) -
langchain.com/blog/openwiki-0-2-adds-okf-support - Using OKF with Knowledge Catalog to serve context for agents - Google Cloud (27. August 2026: der Knowledge Catalog liest OKF-Bundles ein) -
cloud.google.com/blog/products/data-analytics/scale-okf-bundles-across-an-organization-with-knowledge-catalog - sample-okf-llm-wiki - aws-samples, GitHub (Open-Source-Beispiel vom 6. Juli 2026: Daten als OKF-Bundles, per MCP bereitgestellt) -
github.com/aws-samples/sample-okf-llm-wiki - The OKF from Google is a new layer for agents - Marie Haynes (GEO-Praktikerin, frühe Praxistests mit OKF) -
mariehaynes.com/okf - Open Knowledge Format (OKF): Google's New Markdown Format for AI Agents - Suganthan Mohanadasan (öffentliches Bundle und kostenloser OKF-Generator) -
suganthan.com/blog/open-knowledge-format - Open Knowledge Format vs. RAG: Rethinking how AI agents get their context - HPE Community (14. Juli 2026; die Unterscheidung zwischen „neu herleiten“ und „lesen“) -
community.hpe.com/t5/ai-unlocked/open-knowledge-format-vs-rag-rethinking-how-ai-agents-get-their/ba-p/7270244 - Google's Open Knowledge Format (OKF) vs. RAG - Alphamatch (die Minderheitsposition „ersetzt RAG“) -
alphamatch.ai/blog/google-open-knowledge-format-okf-vs-rag-2026