
RAG, kurz für Retrieval-Augmented Generation, ist das Verfahren, mit dem ein KI-Modell vor der Antwort nachschlägt, statt sich nur auf sein Gedächtnis zu verlassen. Es ist auch die Technik hinter der KI-Suche: Wenn ChatGPT, Perplexity oder ein AI Overview von Google eine Frage beantwortet und dabei ein paar Seiten als Quelle nennt, ist RAG der Grund, warum genau diese Seiten ausgewählt wurden.
Die meisten Erklärungen zu RAG richten sich an die Leute, die solche Systeme bauen. Dieser Beitrag ist für die andere Seite gedacht: für alle, die Inhalte veröffentlichen und verstehen wollen, warum manche Seiten abgerufen und zitiert werden und andere nie.
Das Wichtigste in Kürze
- RAG (Retrieval-Augmented Generation) lässt ein Sprachmodell im Moment der Antwort passende Textabschnitte abrufen, in den Prompt einfügen und daraus eine belegte Antwort generieren, statt nur aus seinen Trainingsdaten zu antworten.
- Der Begriff stammt aus einem Paper von Patrick Lewis und Kollegen aus dem Jahr 2020 (Facebook AI Research, University College London, NYU), das laut Google Scholar bis November 2026 mehr als 34.000-mal zitiert wurde.
- RAG verringert Halluzinationen, beseitigt sie aber nicht: Eine Stanford-Studie fand, dass juristische RAG-Tools bei 17 bis 33 % der Anfragen falsch oder irreführend antworteten.
- Die KI-Suche ist selbst RAG: ChatGPT-Suche, Perplexity und Googles AI Overviews rufen Seiten ab, bevor sie antworten. In Deutschland gibt es die AI Overviews seit dem 26. März 2025 und den KI-Modus seit dem 8. Oktober 2025.
- Zitiert wird nur, was vorher abgerufen wurde: Erreichbarkeit für KI-Crawler und in sich geschlossene Abschnitte, die mit der Antwort beginnen, entscheiden darüber, ob eine Passage deiner Seite in einer KI-Antwort landet.
Was ist Retrieval-Augmented Generation (RAG)?
Retrieval-Augmented Generation (RAG) ist ein Verfahren, bei dem ein großes Sprachmodell (LLM) Informationen erst beim Beantworten einer Frage nachschlägt, statt sich nur auf das zu verlassen, was es im Training gelernt hat. Das RAG-System ruft passende Dokumente ab, das Modell liest diesen Kontext und schreibt daraus eine Antwort, die sich auf die gefundenen Quellen stützt. Auf Deutsch ließe sich von „Abruf-erweiterter Generierung“ sprechen, durchgesetzt hat sich aber der englische Begriff.
Am anschaulichsten ist der Vergleich mit einer Prüfung. Ein reines Sprachmodell schreibt eine Klausur ohne Unterlagen: Es antwortet aus dem Gedächtnis, und wo das Gedächtnis aussetzt, rät es mit großer Selbstsicherheit. RAG gibt demselben Modell das Lehrbuch in die Hand und lässt es die richtige Seite aufschlagen, bevor es antwortet. Das Wissen muss also nicht mehr fest in den Gewichten des Modells stecken, es lässt sich in dem Moment aus einer Quelle holen, in dem die Frage gestellt wird.
Darin liegt auch der Unterschied zwischen einem LLM und RAG: Das LLM ist das Sprachmodell selbst, RAG ist das Verfahren, das ihm vor der Antwort frisches Material zuspielt.
Hier kommen deine Inhalte ins Spiel. Sucht das Modell nach einer Seite, auf die es seine Antwort stützen kann, konkurrieren Seiten darum, abgerufen zu werden, und deine ist entweder im Rennen oder nicht. Das Ergebnis hast du sehr wahrscheinlich schon gesehen: Eine KI-Antwort mit ein paar verlinkten Quellen darunter ist RAG in Aktion.
Der Name beschreibt den Ablauf ziemlich genau: passende Dokumente abrufen (Retrieval), den Prompt damit erweitern (Augmentation), dann die Antwort generieren (Generation). Wer sich die drei Schritte in dieser Reihenfolge merkt, versteht den Rest von RAG fast von selbst.
So funktioniert RAG: abrufen, erweitern, generieren
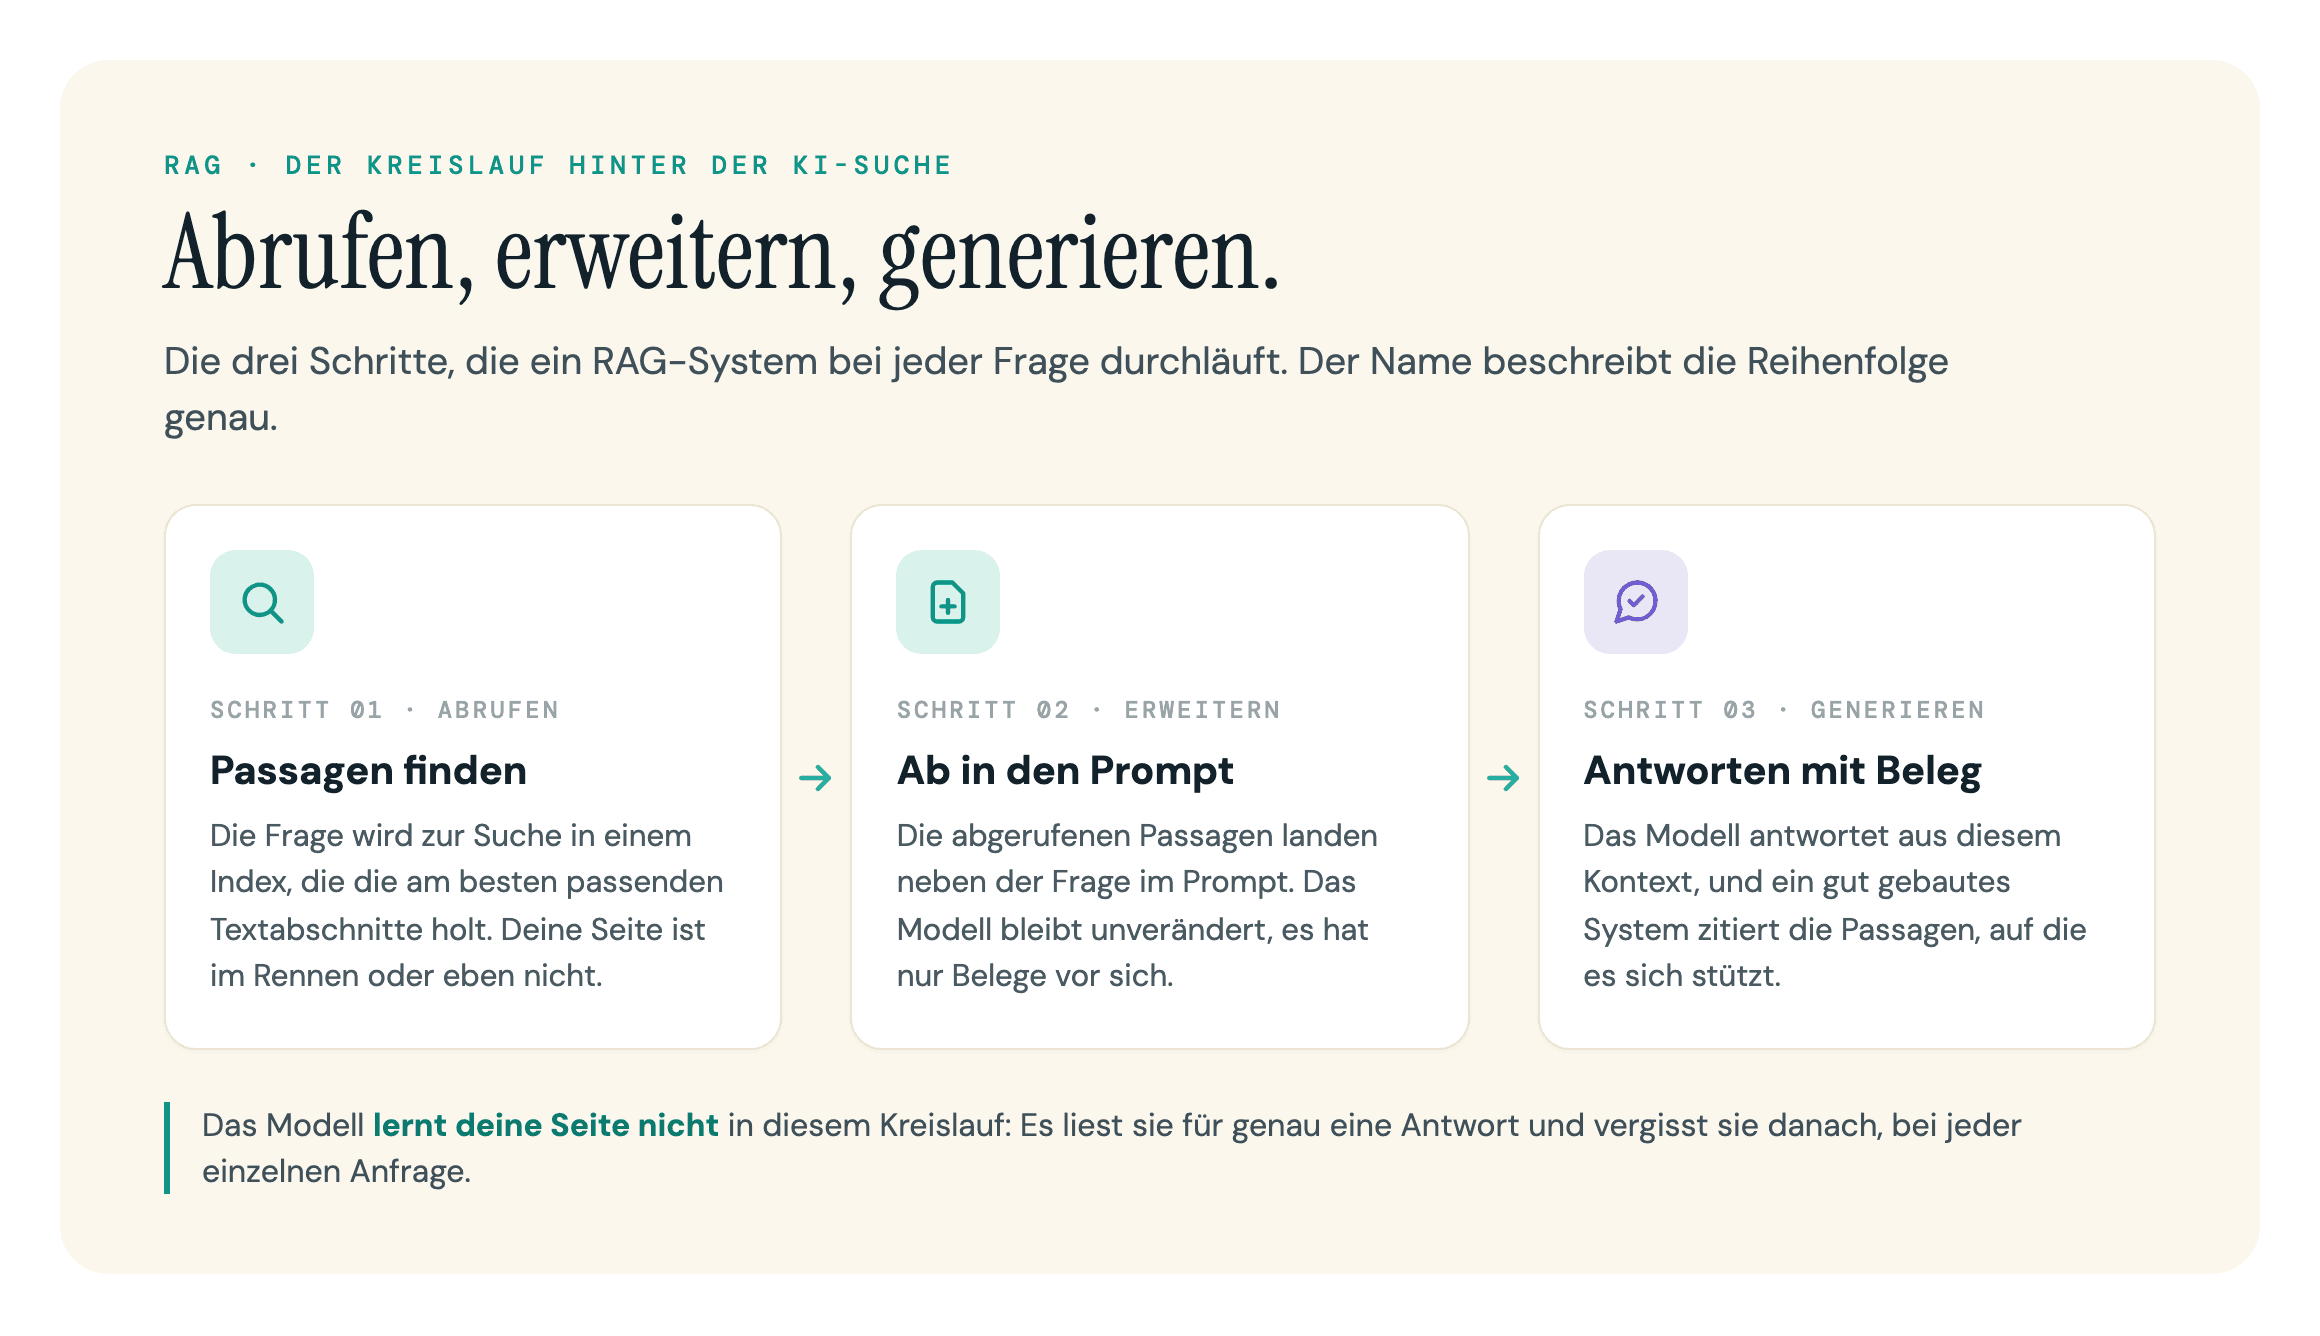
Ein RAG-System durchläuft bei jeder Frage dieselben drei Schritte.
Abrufen. Das System macht aus der Frage eine Suchanfrage und holt die passendsten Passagen aus einer Wissensdatenbank. Diese Datenbank besteht meist aus Dokumenten, die in kleine Textabschnitte (Chunks) zerlegt und in Vektor-Embeddings umgewandelt wurden: Zahlenreihen, mit denen Software Bedeutungen vergleichen kann, statt nur exakte Wörter abzugleichen. Ein Embedding-Modell übersetzt auch die Frage in einen Vektor, und der Retriever sucht die Passagen, deren Vektoren diesem am nächsten liegen. Das nennt man semantische Suche, oft kombiniert mit klassischer Stichwortsuche für Begriffe, die exakt stimmen müssen.
Erweitern. Die abgerufenen Passagen werden zusammen mit der ursprünglichen Frage in den Prompt eingefügt. Das Modell sieht jetzt die Worte der Nutzerin oder des Nutzers und dazu ein paar Absätze Belegmaterial, das es eine Sekunde vorher noch nicht hatte. Am Modell selbst ändert sich dabei nichts. Es hat für diese eine Anfrage einfach mehr Kontext vor sich.
Generieren. Das Modell formuliert seine Antwort aus diesem Kontext, und ein gut gebautes System lässt es angeben, auf welche Passagen es sich gestützt hat.
Jetzt kommt der Teil, den die meisten Erklärungen auslassen und der für dich als Publisher am wichtigsten ist. Innerhalb des RAG-Kreislaufs lernt das Modell deine Seite nicht. Es liest sie für genau diese eine Antwort und vergisst sie, sobald die Antwort fertig ist. Öffentliche Seiten können zwar im Training in die Gewichte eines Modells einfließen, aber das geschieht langsam, undurchsichtig und ohne dass du es steuern oder aktualisieren könntest. Den Abruf dagegen kannst du beeinflussen. Deine Inhalte werden bei jeder einzelnen Anfrage geholt, genutzt und wieder verworfen. Deshalb ist es wichtiger, gut strukturiert, aktuell und leicht abrufbar zu sein, als so bekannt zu sein, dass das Modell dich „kennt“.
Bei den Begriffen geraten an dieser Stelle viele durcheinander. Eine Vektordatenbank ist der übliche Ort, um diese Embeddings für einen schnellen Abruf zu speichern, aber sie ist ein Implementierungsdetail und gehört nicht zur Definition. RAG ist die allgemeine Idee, Informationsabruf mit Textgenerierung zu verbinden und die Antwort auf abgerufene Dokumente zu stützen. Die Technik darunter kann sehr unterschiedlich aussehen.
Woher RAG kommt
Der Begriff stammt aus einem Paper von 2020: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Erstautor ist Patrick Lewis, das Team kam von Facebook AI Research (heute Teil von Meta), dem University College London und der New York University; vorgestellt wurde die Arbeit auf der NeurIPS 2020. Laut Google Scholar wurde das Paper inzwischen mehr als 34.000-mal zitiert (Stand: November 2026), und es ist bis heute der Bezugspunkt, auf den sich spätere Arbeiten zum Thema stützen.
Die Unterscheidung aus diesem Paper ist nach wie vor die hilfreichste. Die Autoren verbinden ein parametrisches Gedächtnis, also das Wissen in den trainierten Gewichten des Modells, mit einem nichtparametrischen Gedächtnis: einem durchsuchbaren Index, den das Modell beim Antworten abfragen kann. In der Originalarbeit war dieser Index eine dichte Vektordarstellung der Wikipedia, erreichbar über einen neuronalen Retriever. Ersetzt du Wikipedia durch „das offene Web“, hast du eine recht treffende Skizze davon, wie KI-Suchmaschinen heute arbeiten.
Lewis hat sich übrigens für das wenig schmeichelhafte Akronym entschuldigt: „Wir hätten uns definitiv mehr Gedanken über den Namen gemacht, wenn wir gewusst hätten, dass unsere Arbeit so große Verbreitung finden würde.“ Und so kam es dann auch.
Warum es RAG gibt: was es löst und was nicht
Ein Sprachmodell für sich allein hat ein paar vorhersehbare Schwachstellen, und RAG wurde entwickelt, um sie auszugleichen.
Ein solches Modell hat einen Trainings-Stichtag. Die Trainingsdaten sind zu einem bestimmten Zeitpunkt eingefroren, sodass das Modell Monat für Monat weiter veraltet, bis es jemand neu trainiert. RAG umgeht das, indem es aktuelle Informationen erst dann holt, wenn die Frage gestellt wird. Außerdem hat das Modell keinen Zugriff auf private oder interne Daten, also auf Firmendokumente und neue Seiten, die nie in seinen Trainingsdaten waren. RAG bindet dieses externe Wissen an, ohne neu zu trainieren. Und weil ein Abruf weniger kostet, als ein Modell per Fine-Tuning mit neuen Daten nachzutrainieren, ist RAG der kostengünstige Weg, Antworten aktuell zu halten.
Der wichtigste Nutzen ist die Fundierung, im Englischen „Grounding“. Weil die Antworten in abgerufenen Quellen verankert sind, verringert RAG Halluzinationen, also die selbstsicher erfundenen Antworten, die Modelle liefern, wenn sie nur aus dem Gedächtnis arbeiten. Zugleich werden die Antworten überprüfbar, weil das System die genutzten Passagen als Quellen angeben kann.
Hier braucht es Klartext, denn bei keinem Punkt übertreibt die Branche so stark wie bei diesem: RAG verringert Halluzinationen, es beseitigt sie nicht. Das Modell kann eine richtige Quelle falsch verstehen, widersprüchliche Passagen vermengen oder etwas Unbelegtes schreiben, wenn der Abruf wenig hergibt. Die Qualität des Abrufs setzt dem ganzen System eine harte Grenze: Ein Modell kann seine Antwort nicht auf eine Passage stützen, die der Retriever nie gefunden hat.
Die Belege sind eindeutig. Eine Stanford-Studie mit dem Titel Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools hat kommerzielle juristische Recherche-Tools getestet, die selbst RAG-Systeme auf kuratierten, verlässlichen Rechtsdatenbanken sind. Lexis+ AI lieferte bei mehr als 17 % der Anfragen falsche oder irreführende Antworten, das Tool von Westlaw bei rund einem Drittel, obwohl LexisNexis „halluzinationsfreie“ Quellenverweise garantierte und Thomson Reuters versprach, Halluzinationen zu „vermeiden“. Wenn eigens dafür entwickelte RAG-Systeme auf einem sauberen juristischen Korpus so oft danebenliegen, solltest du jedem Versprechen von „halluzinationsfreier“ KI misstrauen. RAG bleibt trotzdem eine starke Gegenmaßnahme, und genau darin liegt sein Wert. Warum Modelle überhaupt halluzinieren, erklärt dieser Beitrag zu KI-Halluzinationen.
RAG vs. Fine-Tuning: das Missverständnis „ChatGPT mit unseren Dokumenten trainieren“
Wenn im Meeting jemand sagt: „Lass uns ChatGPT mit unserer Website trainieren“, ist fast immer RAG gemeint und kein Training. Die beiden Begriffe werden ständig vermischt, und wer das falsche Verfahren wählt, zahlt drauf.
Fine-Tuning (Feinabstimmung) verändert das Modell selbst. Du trainierst es weiter, damit sich neue Muster in seinen Gewichten festsetzen. Danach steckt das Wissen im Modell, es gibt keinen Nachschlageschritt mehr, und jede Aktualisierung heißt: noch einmal trainieren. Fine-Tuning ist das richtige Werkzeug, um einem Modell einen Stil, ein Format oder ein Verhalten beizubringen.
RAG lässt das Modell unangetastet und legt ihm beim Antworten Dokumente zum Lesen vor. Das Wissen liegt in einem separaten Index, den du jederzeit aktualisieren kannst, und das Modell kann angeben, was es abgerufen hat. RAG ist das richtige Werkzeug für Fakten, die sich ändern oder die das Modell nie gelernt hat.
| Frage | RAG | Fine-Tuning |
|---|---|---|
| Was wird verändert? | Ein externer Index mit Dokumenten | Die Gewichte des Modells selbst |
| Wann kommt das Wissen dazu? | Bei der Antwort, pro Anfrage | Vorab, in einem Trainingslauf |
| Wofür eignet es sich? | Aktuelle oder interne Fakten | Stil, Tonalität, Format, Verhalten |
| Wie wird aktualisiert? | Index bearbeiten, kein Neutraining | Modell neu trainieren oder nachjustieren |
| Kann es Quellen nennen? | Ja | Nicht von sich aus und nicht verlässlich belegt |
Konkurrenten sind die beiden nicht. Systeme im Produktivbetrieb nutzen oft Fine-Tuning für das Verhalten und RAG für aktuelle Fakten. Schon die Autoren des Original-Papers beschrieben ihre Methode als „general-purpose fine-tuning recipe“, also als allgemeines Fine-Tuning-Rezept, mit dem man RAG-Modelle baut. Die Faustregel: Lautet das Problem „das Modell kennt diesen Fakt nicht“, nimm RAG. Lautet es „das Modell antwortet nicht so, wie wir es brauchen“, nimm Fine-Tuning.
Ein Punkt, den du in Deutschland mitdenken solltest: Bei RAG liegt das Wissen in einem Index, den du selbst kontrollierst. Laut der Orientierungshilfe der Datenschutzkonferenz (DSK) zu RAG vom Oktober 2025 lassen sich die Einträge darin, anders als im Modell erlerntes Wissen, „einfach aktualisieren, löschen und beauskunften“. Wer welche Bereiche der Vektordatenbank und welche Referenzdokumente abfragen darf, lässt sich dort laut DSK über ein Rechte- und Rollenkonzept regeln. Läuft das Sprachmodell aber als Cloud-Dienst eines externen Anbieters, gehen die abgerufenen Passagen bei jeder Antwort an diesen Anbieter. Enthalten sie personenbezogene Daten, besteht nach der allgemeinen KI-Orientierungshilfe der DSK von 2024 „häufig ein Auftragsverarbeitungsverhältnis“. Liegt eine solche Auftragsverarbeitung vor, brauchst du einen AV-Vertrag nach Art. 28 Abs. 3 DSGVO. Wer das gesamte RAG-System selbst betreibt (on-premise), kann laut DSK vermeiden, dass personenbezogene Daten an die Online-Betreiber großer Sprachmodelle übertragen werden.
Für Publisher ist der Unterschied aus einem Grund besonders wichtig: Die KI-Engines, die dich zitieren könnten, arbeiten mit RAG und trainieren ihre Modelle nicht per Fine-Tuning mit deiner Website. Damit sind wir bei dem Teil, der deinen Traffic direkt betrifft.
RAG ist das, was in der KI-Suche wirklich passiert
Die RAG-Systeme, mit denen die meisten Menschen tatsächlich zu tun haben, sind dieselben KI-Suchmaschinen, in denen du ohnehin sichtbar werden willst. Diesen Zusammenhang lassen die Erklärseiten der Cloud-Anbieter aus. Sie beschreiben RAG als Unternehmenstechnik: ein Support-Chatbot, der Fragen anhand interner Daten beantwortet, eine interne Wissenssuche, ein Assistent, der Firmendokumente auswertet. Diese Anwendungen gibt es durchaus, sie machen aber den kleineren Teil aus.
Wenn ChatGPT für eine Antwort im Web sucht, läuft der Abruf über die ChatGPT-Suche. Laut OpenAI greift sie auf externe Suchanbieter und auf Inhalte zurück, die Partner direkt bereitstellen. Damit eine Website dort überhaupt auftauchen kann, muss sie OpenAIs Crawler OAI-SearchBot zulassen. Perplexity sucht laut eigener Hilfeseite in Echtzeit im Web und versieht jede Antwort mit nummerierten Quellenangaben. Und Google nennt Retrieval-Augmented Generation sogar selbst als eine der Techniken hinter den KI-Funktionen seiner Suche: Die zentralen Ranking-Systeme rufen relevante, aktuelle Seiten aus dem Google-Suchindex ab, auf die sich die Antwort dann stützt. Die Engines unterscheiden sich, die drei Schritte bleiben dieselben: abrufen, erweitern, generieren. So funktioniert KI-Suche unter der Haube.
In Deutschland läuft dieser Kreislauf längst in der Google-Suche: Die AI Overviews (auf Deutsch: „Übersicht mit KI“) starteten hier am 26. März 2025, der KI-Modus (engl. „AI Mode“) am 8. Oktober 2025, und beide sind heute auf Deutsch verfügbar. Wie das konkret aussieht, zeigte eine Stichprobe am 9. November 2026: Für „was ist rag“ blendete google.de eine „Übersicht mit KI“ ein, die unter anderem den Blog des Fraunhofer IESE, die deutschen Erklärseiten von AWS und Google Cloud sowie die deutsche Wikipedia als Quellen verlinkte. Ob und mit welchen Quellen die Übersicht erscheint, ändert sich allerdings von Suche zu Suche.
Am Beispiel ChatGPT sieht man gut, wie die Teile zusammenpassen. Das Basismodell ist ein Sprachmodell, doch im Such- und Browsing-Modus läuft es in einem RAG-Ablauf, der Live-Seiten abruft, bevor es antwortet. Das Modell ist der Generator, das Produkt drumherum ist das RAG-System.
Diese Sichtweise ändert, was „zitiert werden“ bedeutet. Wenn KI-Suche RAG ist, beginnt jedes Zitat damit, dass eine RAG-Pipeline deine Seite abruft. Der Abruf ist die Qualifikationsrunde: Welche der abgerufenen Quellen zitiert werden, entscheidet danach noch das Modell, aber eine Seite, die nie abgerufen wird, kann auch nie zitiert werden. Es gibt keine Liste mit zehn blauen Links zum Durchscrollen, sondern eine einzige zusammengefasste Antwort mit ein paar Quellen. Auf diesen Wettbewerb sind die meisten Seiten nie ausgelegt worden.
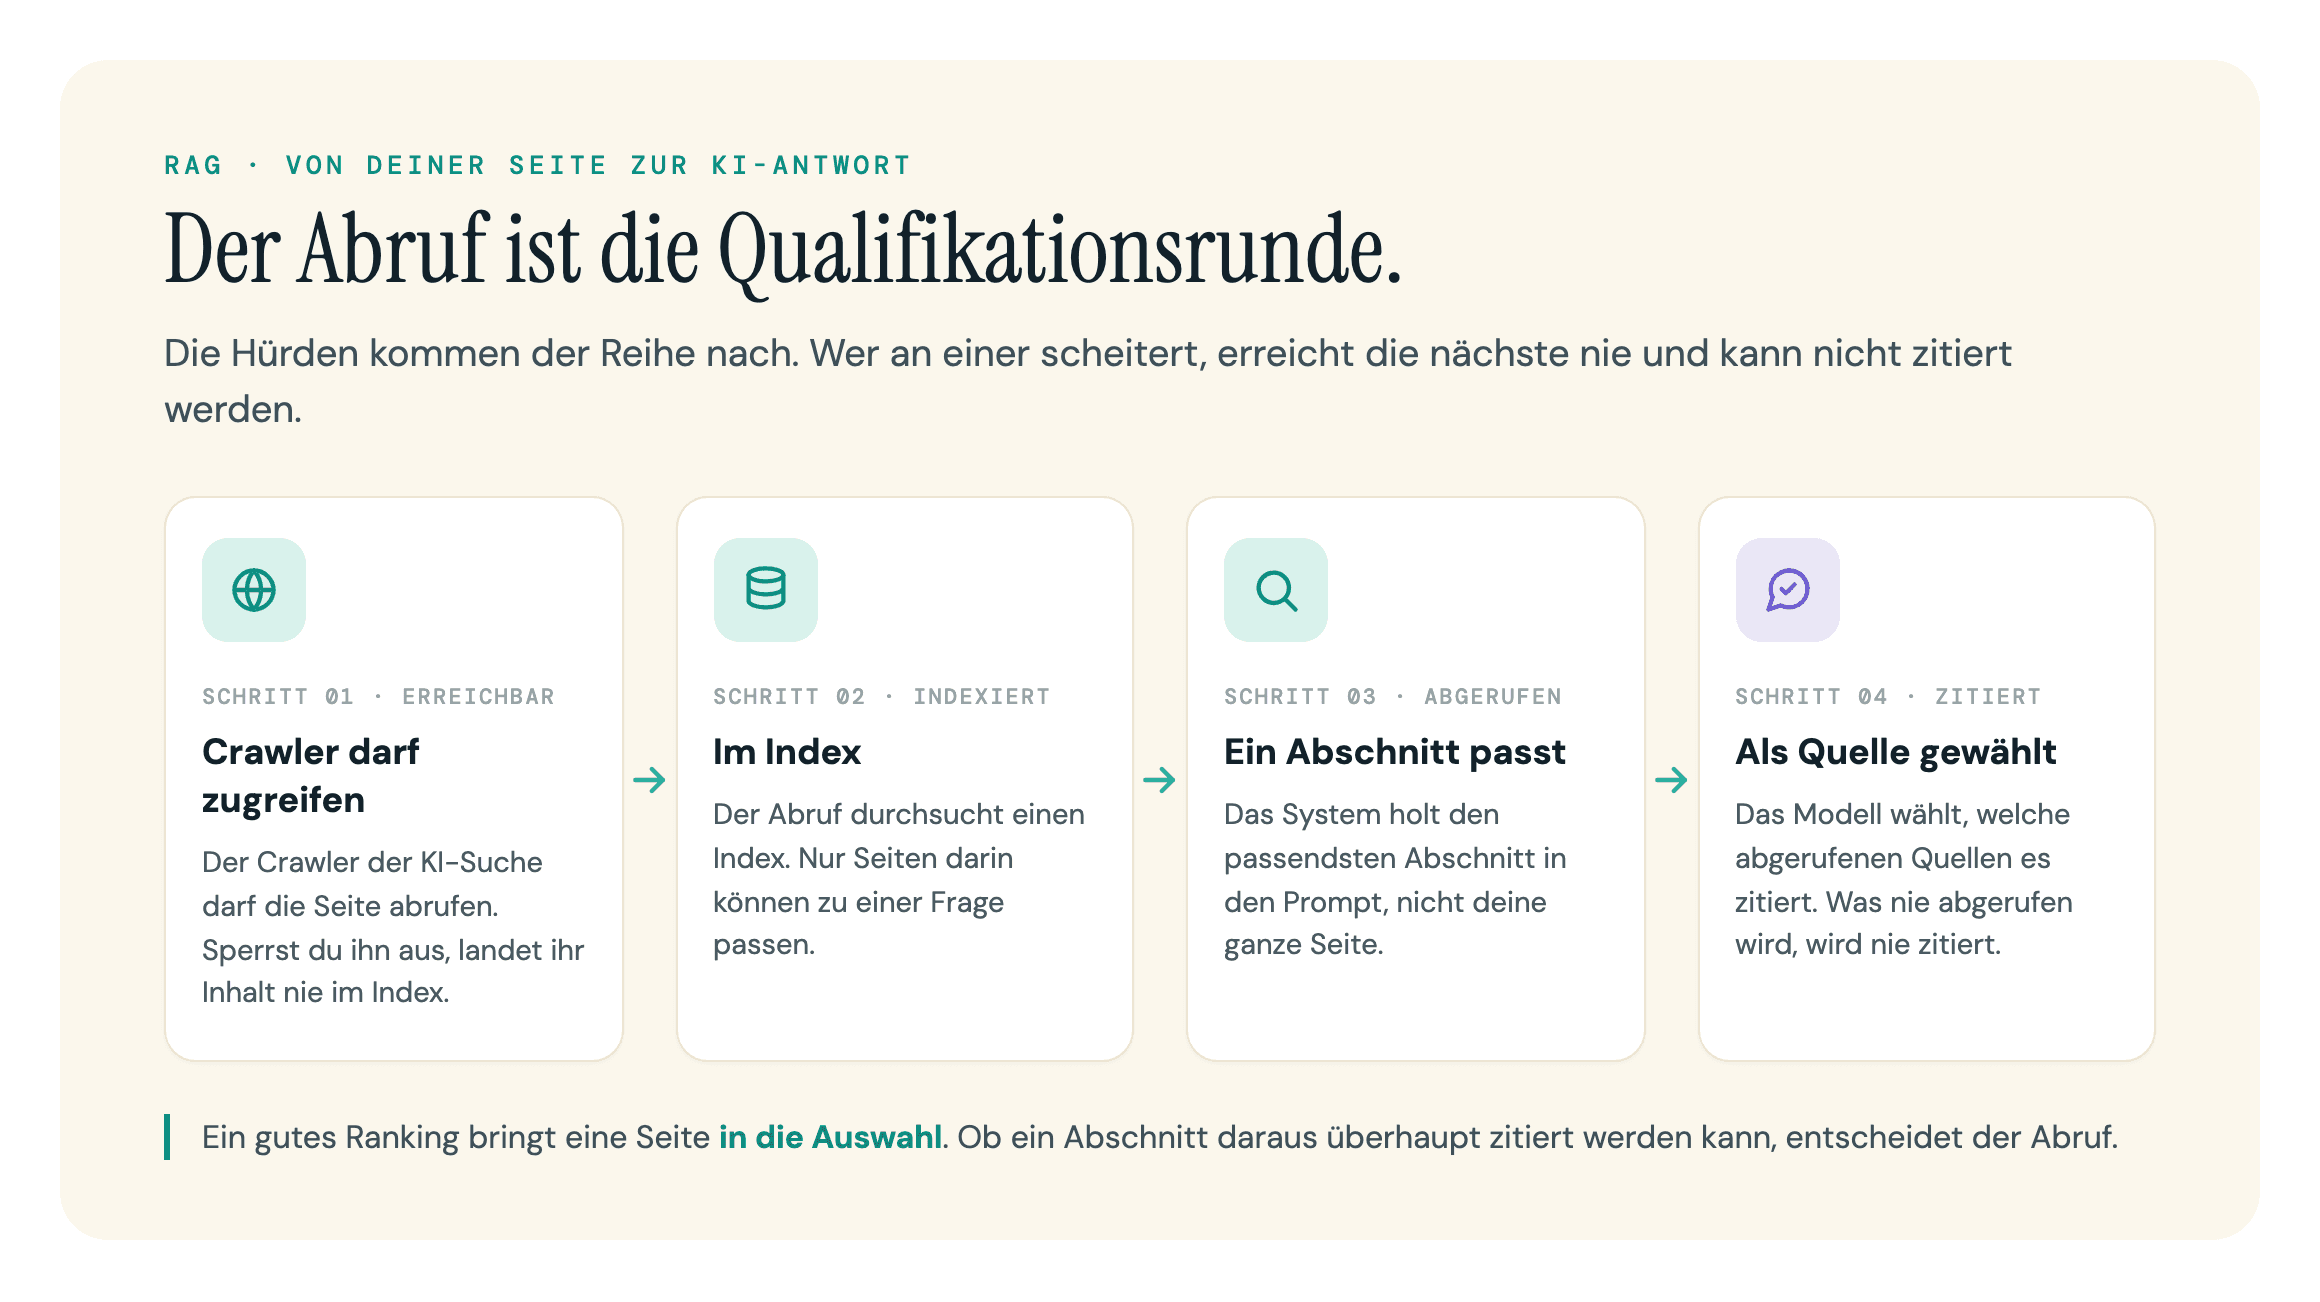
So wird deine Seite abgerufen
Wenn deine Seiten in KI-Antworten auftauchen sollen, müssen sie sich leicht abrufen lassen. Hier wird RAG vom Hintergrundwissen zur Content-Strategie, und aus der Funktionsweise der Pipeline ergeben sich direkt ein paar Regeln.
Abgerufen werden Passagen, nicht Seiten. Ein RAG-System zerlegt Dokumente in Chunks und ruft den Abschnitt ab, der am besten zur Anfrage passt, nicht deinen ganzen Artikel. Jeder Abschnitt muss deshalb für sich allein verständlich sein. Setz die Antwort auf eine Frage direkt unter eine klare, als Frage formulierte Überschrift: in die ersten ein, zwei Sätze, noch vor Kontext und Einschränkungen.
Nach unserer Erfahrung aus Audits zur KI-Sichtbarkeit ist das der häufigste behebbare Fehler. Die Antwort steht zwar auf der Seite, aber erst nach drei Sätzen Vorlauf mitten in einem Absatz. Abgerufen wird dann die Einleitung statt der eigentlichen Aussage. Schreib jeden Abschnitt so, dass jemand, der direkt dort landet, die Antwort trotzdem bekommt. Das ist derselbe Gedanke wie beim Content-Chunking, mit einer Einschränkung: Gemeint sind in sich geschlossene Abschnitte für Leserinnen und Leser, nicht Seiten, die du für Maschinen in künstliche Fragmente zerhackst. Dazu gleich mehr.
Was nicht erreichbar ist, kann nicht abgerufen werden. Der Abruf läuft über einen Index, und in den Index kommt deine Seite nur, wenn der Crawler der Engine sie abrufen darf. Stell sicher, dass du keine KI-Crawler blockierst, von denen du zitiert werden willst. Erreichbarkeit ist die Grundvoraussetzung; ohne sie ist alles andere umsonst.
Schreib unmissverständlich. Ist eine Quelle vage oder setzt sie Wissen von außerhalb voraus, verstehen Modelle sie falsch. Formuliere Aussagen klar und in sich vollständig, damit ein abgerufener Ausschnitt auch ohne den Rest der Seite eindeutig bleibt.
Aktualität hilft, mit einem Vorbehalt. Aktualität gehört zu den wenigen Signalen, die mit Zitaten zusammenhängen: Der Abruf soll gerade das veraltete Gedächtnis des Modells ausgleichen. Echte Aktualisierungen lohnen sich, das bloße Hochsetzen des Datums nicht. Behandle Aktualität aber als Korrelation, nicht als garantierten Hebel.
| Was du tun solltest | Warum es beim Abruf hilft |
|---|---|
| Die Antwort an den Anfang jedes Abschnitts stellen, unter klaren Überschriften | Der abgerufene Chunk enthält die Antwort, nicht die Einleitung |
| Absätze in sich geschlossen schreiben (ein Gedanke pro Absatz) | Ein Chunk ergibt auch ohne Umfeld noch Sinn |
| Die KI-Crawler zulassen, von denen du zitiert werden willst | Abgerufen werden kann nur, was im Index ist |
| Aussagen klar, konkret und eindeutig formulieren | Das Risiko sinkt, dass eine Passage falsch verstanden wird |
| Seiten wirklich aktuell halten | Aktualität hängt damit zusammen, ob Seiten in Antworten landen |
Gut zu ranken und zitiert zu werden ist nicht dasselbe. Ein Ranking kann eine Seite in die Auswahl bringen, aber ob eine ihrer Passagen überhaupt zitiert werden kann, entscheidet der Abruf. Eine Seite kann also ganz oben bei Google stehen und trotzdem nie in einer KI-Antwort auftauchen.
Und nein, das ist nicht einfach SEO mit neuem Logo, auch wenn es näher dran ist, als der Hype vermuten lässt. Google schreibt selbst, dass du Inhalte nicht in winzige Abschnitte zerlegen musst: Seine Systeme können „die Nuancen mehrerer Themen auf einer Seite verstehen und Nutzern den relevanten Teil anzeigen“, und die Grundlagen von GEO und AEO bleiben SEO. Unterm Strich: dieselben Grundlagen (thematische Tiefe, Autorität, Klarheit), dazu eine echte Verschiebung der Abrufeinheit von der Seite zur Passage. Das komplette Vorgehen findest du in unseren Leitfäden dazu, wie du für die KI-Suche optimierst und wie du Seiten schreibst, die von LLMs zitiert werden.
Ist RAG tot? Agentic RAG und die Debatte um lange Kontextfenster
Weder riesige Kontextfenster noch der Trend zu KI-Agenten machen den Abruf überflüssig, auch wenn Schlagzeilen wie „RAG ist tot“ anderes behaupten. Dahinter stehen meist zwei Argumente: Modelle, die inzwischen einen ganzen Dokumentenbestand in einem einzigen Prompt verarbeiten können, und Agenten, die immer selbstständiger arbeiten.
Der Slogan meint eigentlich naives RAG, die einfachste Form, die einmal abruft und einmal generiert. Diese Grund-Pipeline reicht für mehrstufige Aufgaben oft nicht aus. Die Branche bewegt sich in Richtung Agentic RAG: Ein Agent entscheidet, wann er abruft, formuliert die Anfrage um, ruft erneut ab und prüft das Ergebnis, bevor er antwortet. Abgerufen wird dabei öfter als bei naivem RAG, und zwar mit besserem Urteil darüber, wann und wonach gesucht wird.
Modelle mit langem Kontext sind für manche Aufgaben eine echte Alternative. Alles in den Prompt zu kippen, ist aber langsamer und teurer, als die wenigen Passagen abzurufen, auf die es ankommt, und für das offene Web funktioniert das in dieser Größenordnung nicht. Der Abruf bleibt damit zentral.
Für alle, die Inhalte veröffentlichen, ändert sich an der praktischen Konsequenz nichts. KI-Suchmaschinen rufen weiterhin Seiten ab, bevor sie antworten. Ob das System naiv oder agentisch arbeitet: Es muss deine Seite finden, um sie zu zitieren. Abrufbar zu sein bleibt die Eintrittskarte.
Häufige Fragen
Ist ChatGPT ein RAG-Modell?
Das zugrunde liegende Modell nicht, der Such- und Browsing-Modus von ChatGPT aber schon. Wenn ChatGPT vor der Antwort etwas nachschlägt, ruft es Live-Seiten aus dem Web ab, fügt sie dem Prompt hinzu und generiert eine belegte Antwort. Dieser Dreischritt aus Abrufen, Erweitern und Generieren ist RAG, und das Modell ist darin der Generator.
Verhindert RAG Halluzinationen?
Es verringert sie, verhindert sie aber nicht. Antworten, die auf abgerufenen Quellen beruhen, enthalten seltener Erfundenes, doch das Modell kann eine Quelle falsch verstehen oder Lücken füllen, wenn der Abruf schwach ist. Eine Stanford-Studie fand, dass kommerzielle juristische RAG-Tools bei 17 bis 33 % der Anfragen halluzinierten. Begegne jedem Versprechen von „halluzinationsfreier“ KI deshalb mit Vorsicht.
Was ist der Unterschied zwischen RAG und einer Vektordatenbank?
RAG ist das gesamte Verfahren, die Antwort eines Modells auf abgerufene Dokumente zu stützen. Eine Vektordatenbank ist eine Komponente, die manche RAG-Systeme nutzen, um Embeddings zu speichern und schnell nach Ähnlichkeit zu suchen. RAG funktioniert auch ohne Vektordatenbank, etwa mit Stichwortsuche oder einem Wissensgraphen. Die Vektordatenbank ist ein verbreiteter Baustein, aber keine Voraussetzung.
Muss ich ein eigenes RAG-System bauen, um von KI-Suche zu profitieren?
Nein. Die meisten Publisher werden von fremden RAG-Systemen abgerufen und bauen kein eigenes. Deine Aufgabe ist es, deine bestehenden Inhalte leicht abrufbar und zitierbar zu machen, nicht eine eigene Pipeline aufzusetzen.
Du landest nicht im Modell. Du wirst abgerufen.
Die praktische Arbeit ist überschaubar, hört aber nie auf: Halte deine Seiten erreichbar, schreib Abschnitte, die für sich allein stehen, bleib aktuell und gib jedem Abschnitt eine direkte Antwort, die es wert ist, zitiert zu werden. Dann optimierst du für den Abrufschritt, den jede KI-Engine durchläuft, statt einem Ranking hinterherzulaufen, das vielleicht nie zu einem Zitat wird.
Als Erstes solltest du prüfen, ob KI-Engines deine Seiten überhaupt erreichen und lesen können, denn davon hängt alles andere ab. Genau das testet unser AI Readiness Check. Danach kannst du messen, wie oft du tatsächlich zitiert wirst, und zwar in den Engines, die mit Abruf arbeiten.
Quellen
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks – Lewis et al., NeurIPS 2020 –
arxiv.org/abs/2005.11401 - Was ist Retrieval-Augmented Generation (RAG)? – NVIDIA, 31. Januar 2025, aktualisiert 21. Juli 2025 –
blogs.nvidia.de/was-ist-retrieval-augmented-generation-rag - Retrieval-Augmented Generation – Wikipedia –
de.wikipedia.org/wiki/Retrieval-Augmented_Generation - Google Scholar, Suchergebnis für „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“ – abgerufen am 9. November 2026 („Cited by 34544“) –
scholar.google.com/scholar?q=Retrieval-Augmented+Generation+for+Knowledge-Intensive+NLP+Tasks - Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools – Magesh et al., Stanford RegLab & HAI, arXiv 2024; Journal of Empirical Legal Studies 2025 –
reglab.stanford.edu/publications/hallucination-free-assessing-the-reliability-of-leading-ai-legal-research-tools - Leitfaden von Google zur Optimierung für generative KI-Funktionen in der Google Suche – Google Search Central, aktualisiert 15. Juli 2026 –
developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=de - Introducing ChatGPT search – OpenAI, 31. Oktober 2024 –
openai.com/index/introducing-chatgpt-search - Searching the web with ChatGPT – OpenAI Help Center –
help.openai.com/en/articles/9237897-searching-the-web-with-chatgpt - How does Perplexity work? – Perplexity Help Center, aktualisiert 26. Oktober 2026 –
perplexity.ai/help-center/en/articles/10352895-how-does-perplexity-work - Übersicht mit KI startet in Deutschland und weiteren Ländern – Google-Blog Deutschland, 26. März 2025 –
blog.google/intl/de-de/produkte/suchen-entdecken/uebersicht-mit-ki-start - Der KI-Modus startet in Deutschland, Österreich und der Schweiz – Google-Blog Deutschland, 8. Oktober 2025 –
blog.google/intl/de-de/produkte/suchen-entdecken/ki-modus-startet-in-dach - Orientierungshilfe zu datenschutzrechtlichen Besonderheiten generativer KI-Systeme mit RAG-Methode, Version 1.0 – Datenschutzkonferenz (DSK), Oktober 2025 –
datenschutzkonferenz-online.de/media/oh/DSK_OH_RAG.pdf - Orientierungshilfe Künstliche Intelligenz und Datenschutz, Version 1.0 – Datenschutzkonferenz (DSK), 6. Mai 2024 –
datenschutzkonferenz-online.de/media/oh/20240506_DSK_Orientierungshilfe_KI_und_Datenschutz.pdf