
Le SEO programmatique publie des milliers de pages à partir d’un template et d’une base de données : une page pour chaque variante d’une recherche, comme « dollar en euro » ou « appartement à vendre à Lyon ». La méthode fonctionne quand chaque page apporte les données dont l’internaute a besoin. Elle échoue quand seul le mot-clé change d’une page à l’autre.
C’est ce second cas que vise la règle de Google sur l’utilisation abusive de contenu à grande échelle, quelle que soit la façon dont les pages sont rédigées. Et les réponses IA citent-elles ces pages ? Nous avons passé en revue 300 réponses des Aperçus IA en France et lancé 12 prompts en français : dans notre échantillon, les réponses aux questions de données citent souvent des pages générées, tandis que, pour les tutoriels d’intégration, elles renvoient davantage aux contenus des éditeurs d’applis.
Ce qu’il faut retenir
- Le SEO programmatique consiste à publier une page par ligne d’une base de données, à partir d’un même template ; il fonctionne dès lors que chaque ligne apporte des données qui lui sont propres, par exemple un taux de change ou un prix au m² par ville.
- Google ne pénalise pas la méthode, mais ses règles anti-spam visent l’utilisation abusive de contenu à grande échelle et les pages satellites, et elles s’appliquent aussi aux Aperçus IA et au Mode IA (AI Mode).
- Dans notre test du 14 novembre 2026 en France, 85 des 147 citations de ChatGPT, Perplexity et du Mode IA sont allées à des pages générées ; dans les Aperçus IA, sur 100 réponses qui citent SeLoger, 89 renvoient à ses pages d’annonces ou à ses pages par ville, contre 0 sur 100 pour les pages d’intégration de Zapier.
- En France, des pages « [service] à [ville] » sans établissement réel peuvent aussi relever des pratiques commerciales trompeuses (article L121-2 du Code de la consommation).
- Lancez d’abord un lot pilote de 25 à 50 pages, mesurez l’indexation et les impressions par template, et fixez une règle d’élagage avant de publier davantage.
Qu’est-ce que le SEO programmatique ?
Le SEO programmatique (programmatic SEO, ou pSEO) consiste à publier un grand nombre de pages conçues pour la recherche à partir d’un template et d’une base de données structurée, une page par ligne. Chaque page vise une variante d’une requête qui se répète, comme « intégration [appli] + [appli] » ou « appartements à [ville] ».
Comment fonctionne le SEO programmatique ? Nitin Manchanda le découpe en trois parties : un schéma de requête répétable, une base de données structurée et un template.
- Un schéma de requête : un terme principal et des modificateurs que les internautes combinent de mille façons, chaque combinaison n’ayant qu’un petit volume de recherche
- Une base de données : les lignes qui distinguent chaque page, comme des taux de change, des annonces, des prix ou les déclencheurs que deux applis partagent
- Un template : la mise en page qui transforme une ligne en une réponse
Un script ou un import dans le CMS publie ensuite chaque ligne comme une landing page à part entière sur votre site.
Dans son guide publié par Search Engine Journal le 10 novembre 2026, Manchanda présente le SEO programmatique comme une façon de publier, et non comme un type de contenu.
| SEO programmatique | Pages SEO classiques | |
|---|---|---|
| Unité de travail | Un template et une base de données | Une page à la fois, rédigée à la main |
| Cible | Des centaines ou des milliers de variantes de longue traîne d’un même schéma | Un terme principal ou un groupe de requêtes proches |
| Ce qui rend la page unique | La ligne de données qui l’alimente | La rédaction, la recherche et les exemples |
| Risque principal | Contenu pauvre et contenu dupliqué à grande échelle | Production lente et sujets non couverts |
| Où mesurer | Par template (l’ensemble des pages) | Page par page |
Tout se joue sur deux lignes de ce tableau, « Ce qui rend la page unique » et « Risque principal » : un template multiplie ce qu’il contient, les bonnes données comme le remplissage, sur toutes les URL à la fois.
Exemples de SEO programmatique : les données qui alimentent chaque page
Ces exemples de SEO programmatique ont un point commun : chaque page contient les données que l’internaute est venu chercher.
| Site | Schéma de requête | Ce qui change d’une page à l’autre |
|---|---|---|
| Zapier | « intégration [appli] [appli] » | Les déclencheurs, les actions et les flux de travail prêts à l’emploi pour cette paire d’applis |
| Wise | « [devise] en [devise] » | Le taux moyen du marché de la paire et l’historique du cours |
| SeLoger | « appartement à vendre [ville] » | Les annonces en cours, leurs prix et les filtres pour cette ville |
| SeLoger, prix au m² | « prix immobilier [ville] » | Le prix au m² de la ville, sa fourchette, son évolution et la date de mise à jour |
Zapier publie une page pour chaque appli et pour chaque paire d’applis qu’il relie, avec les déclencheurs, les actions et les flux de travail prêts à l’emploi propres à cette paire.
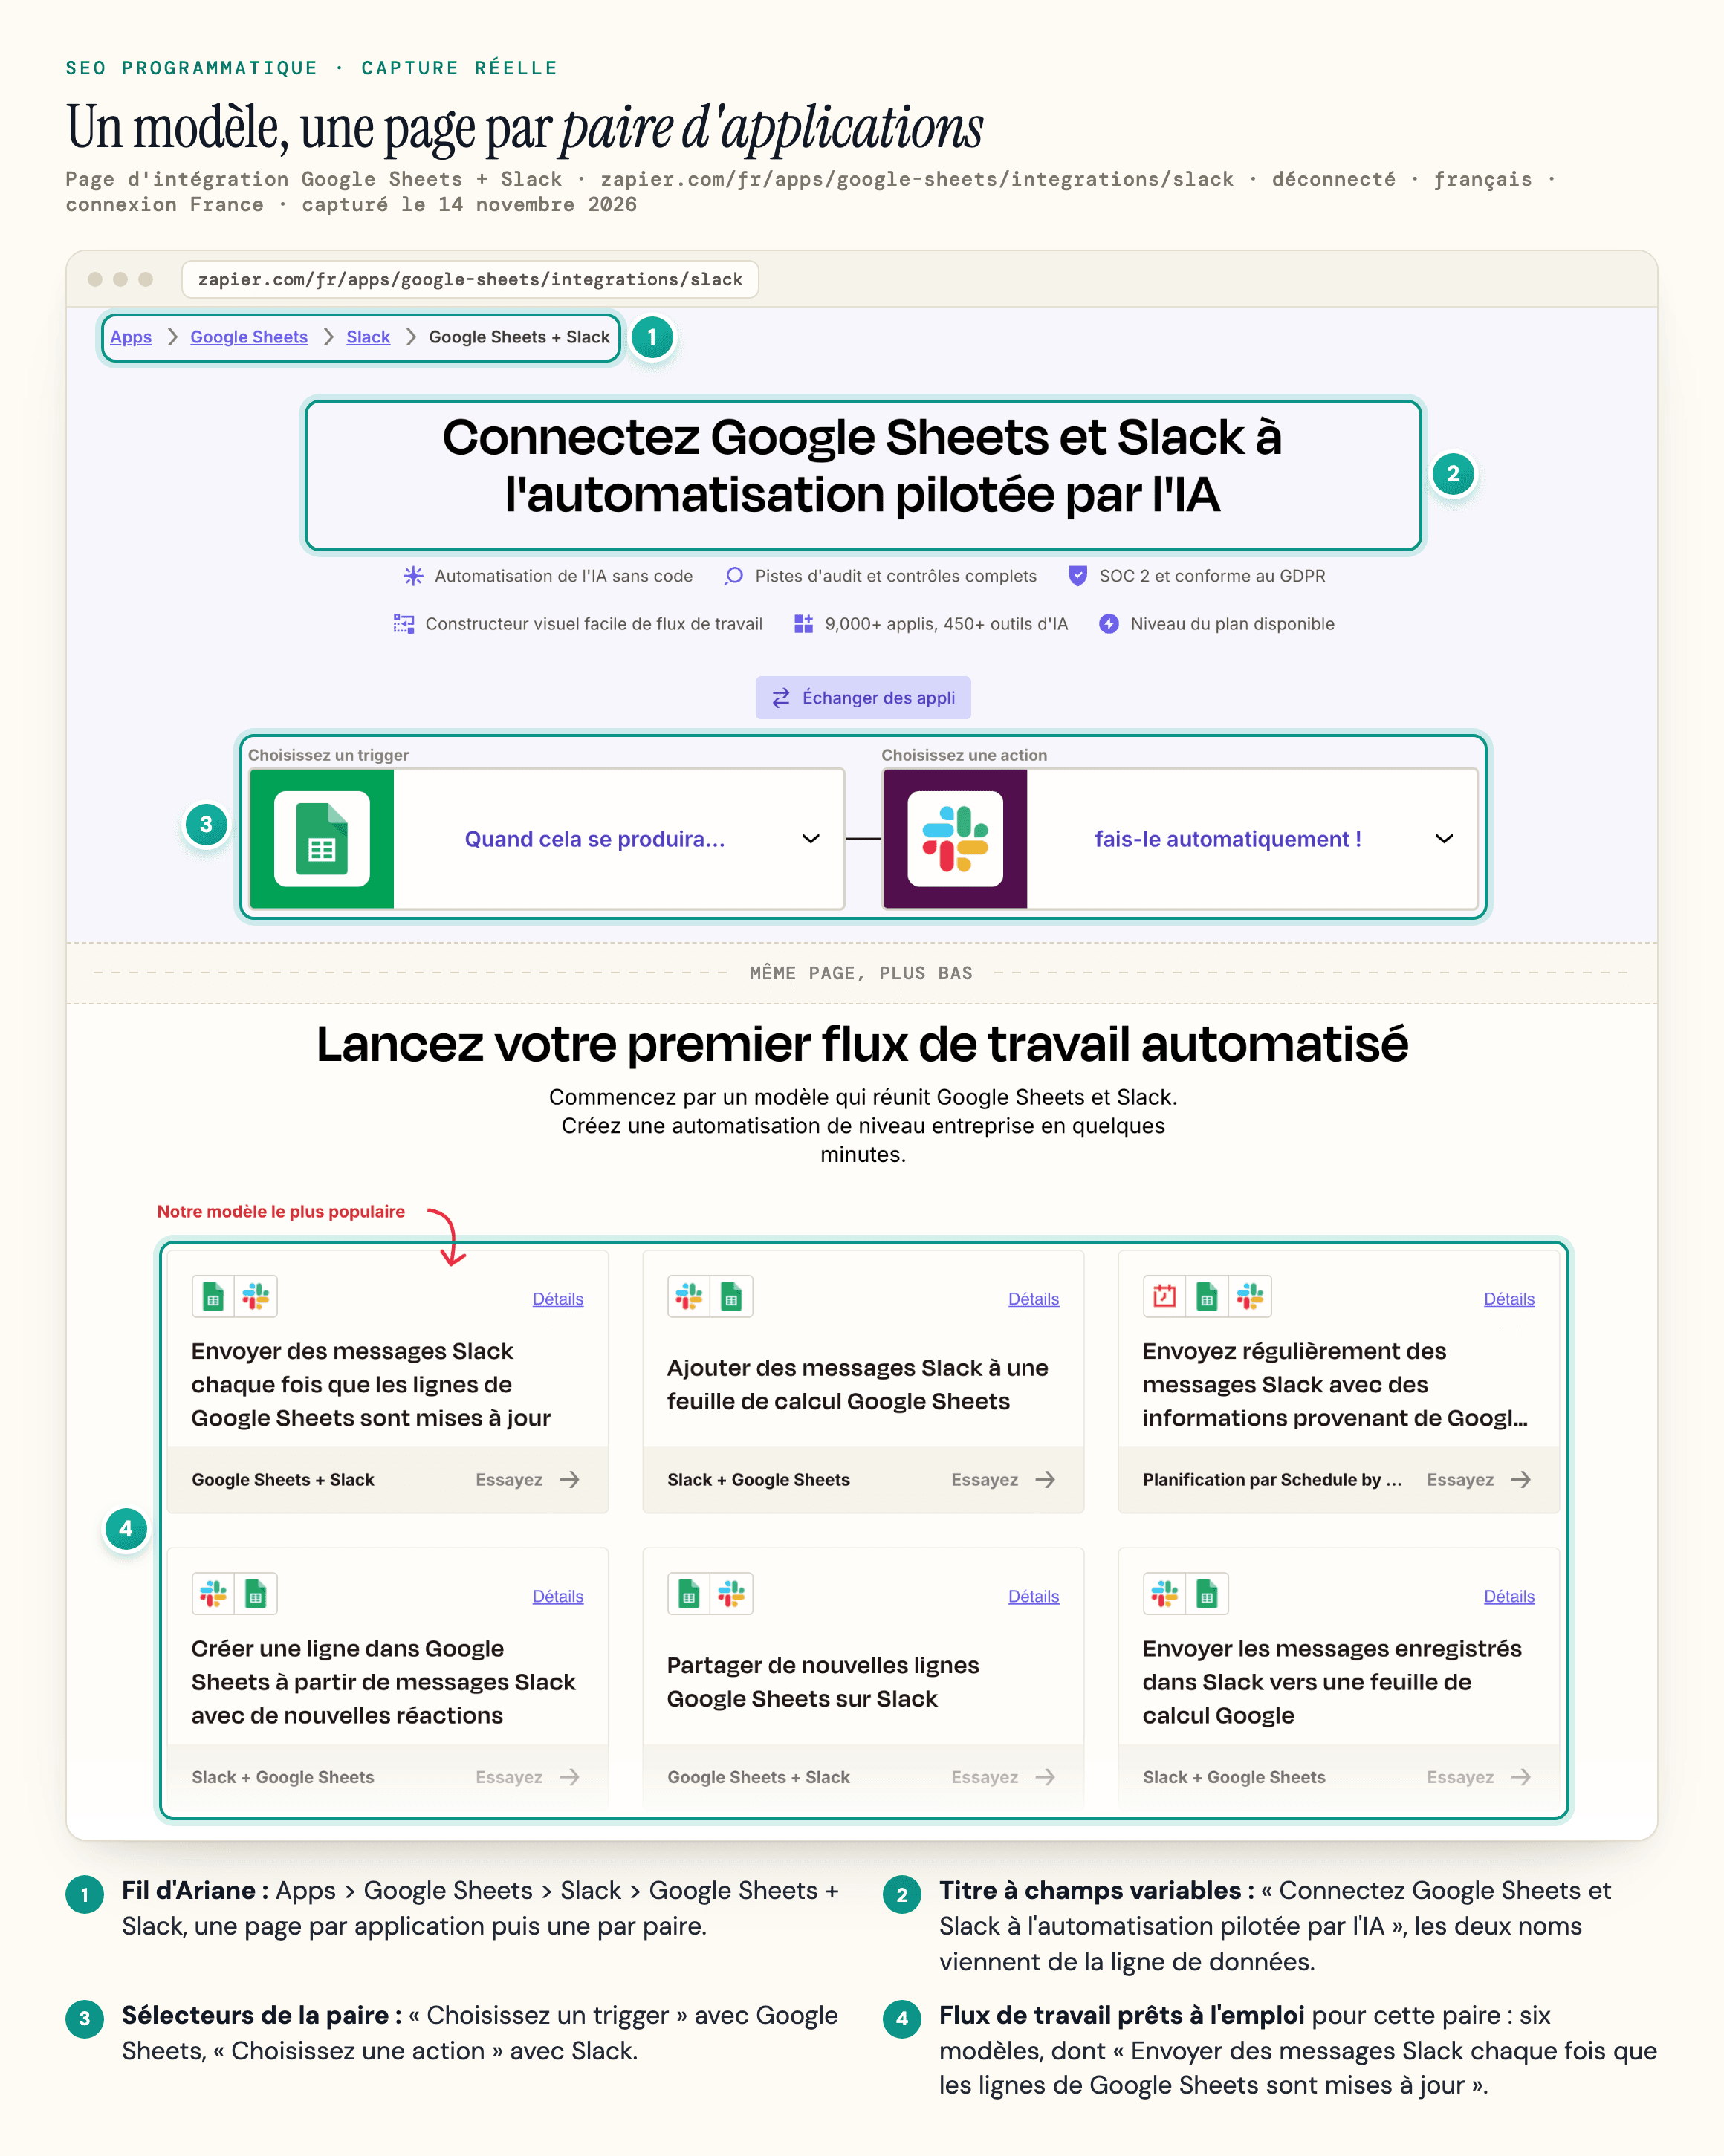
Les éditeurs de logiciels appliquent la même recette avec les pages d’intégration que nous détaillons dans notre guide du SEO pour SaaS.
Wise publie une page de conversion pour chaque paire de devises, avec le taux moyen du marché de la paire en temps réel et l’historique de son cours.
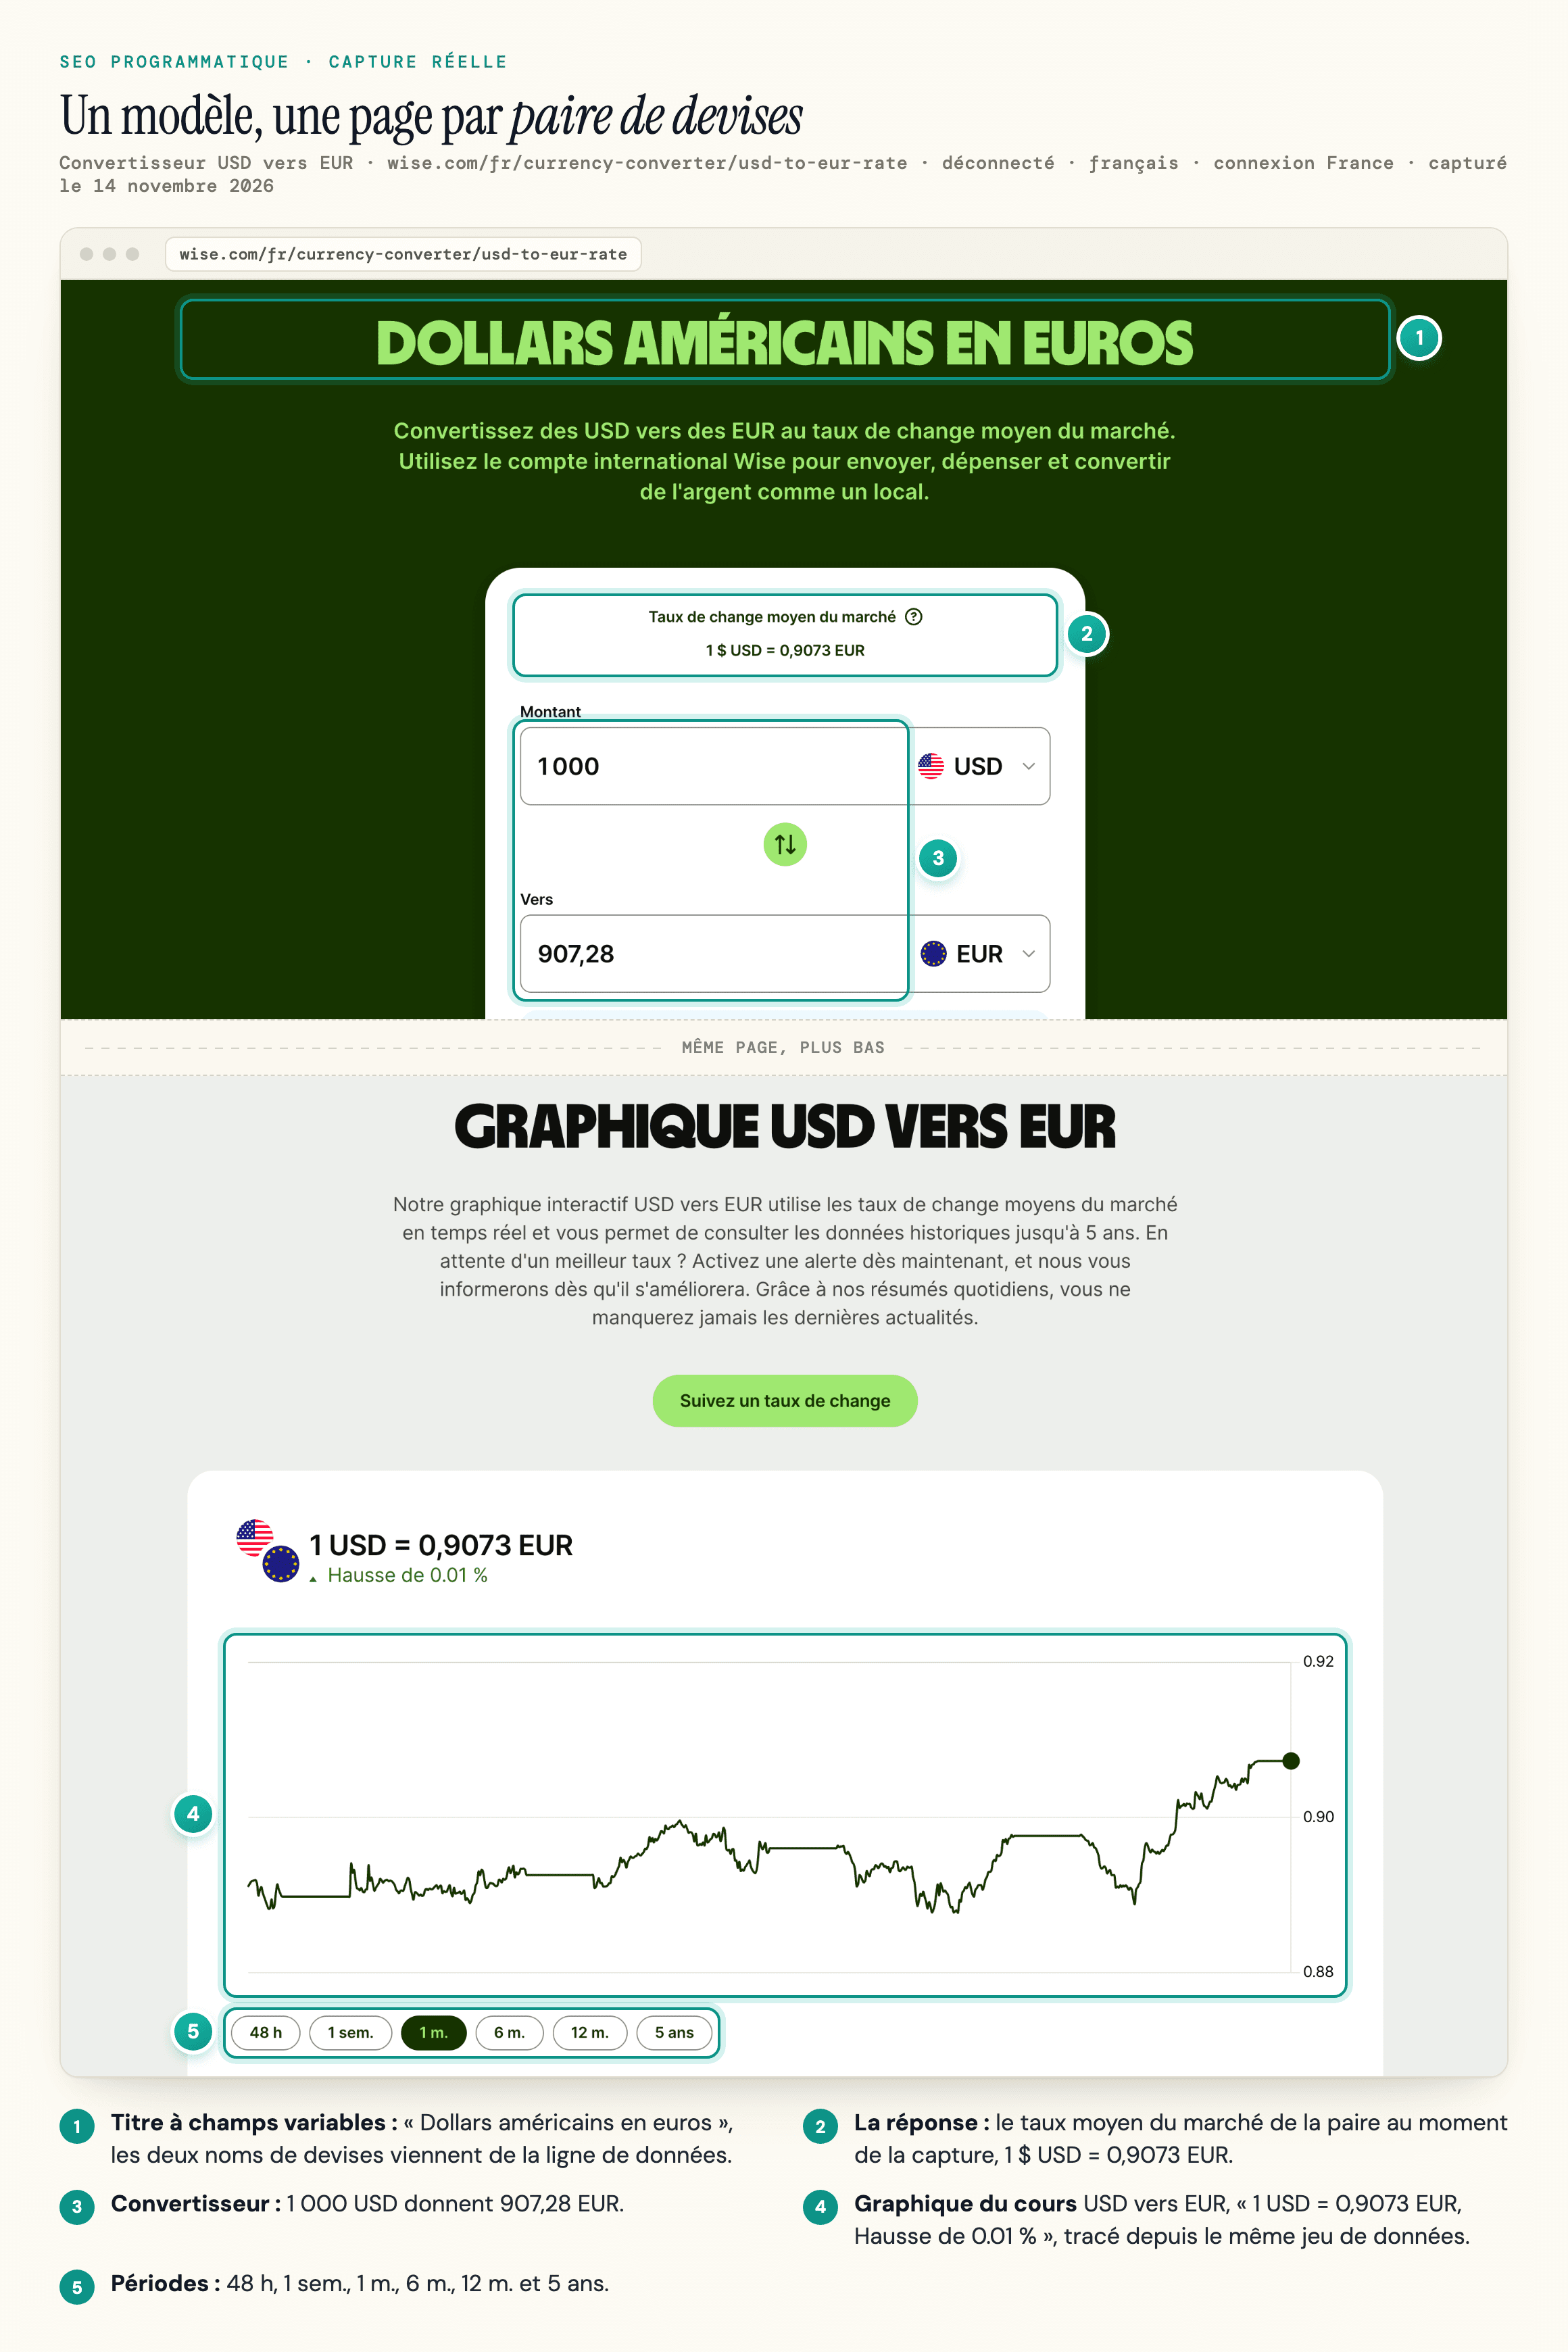
SeLoger construit une page d’annonces pour chaque ville et chaque type de bien : une recherche d’appartements à vendre à Lyon aboutit à une page remplie d’annonces en cours.
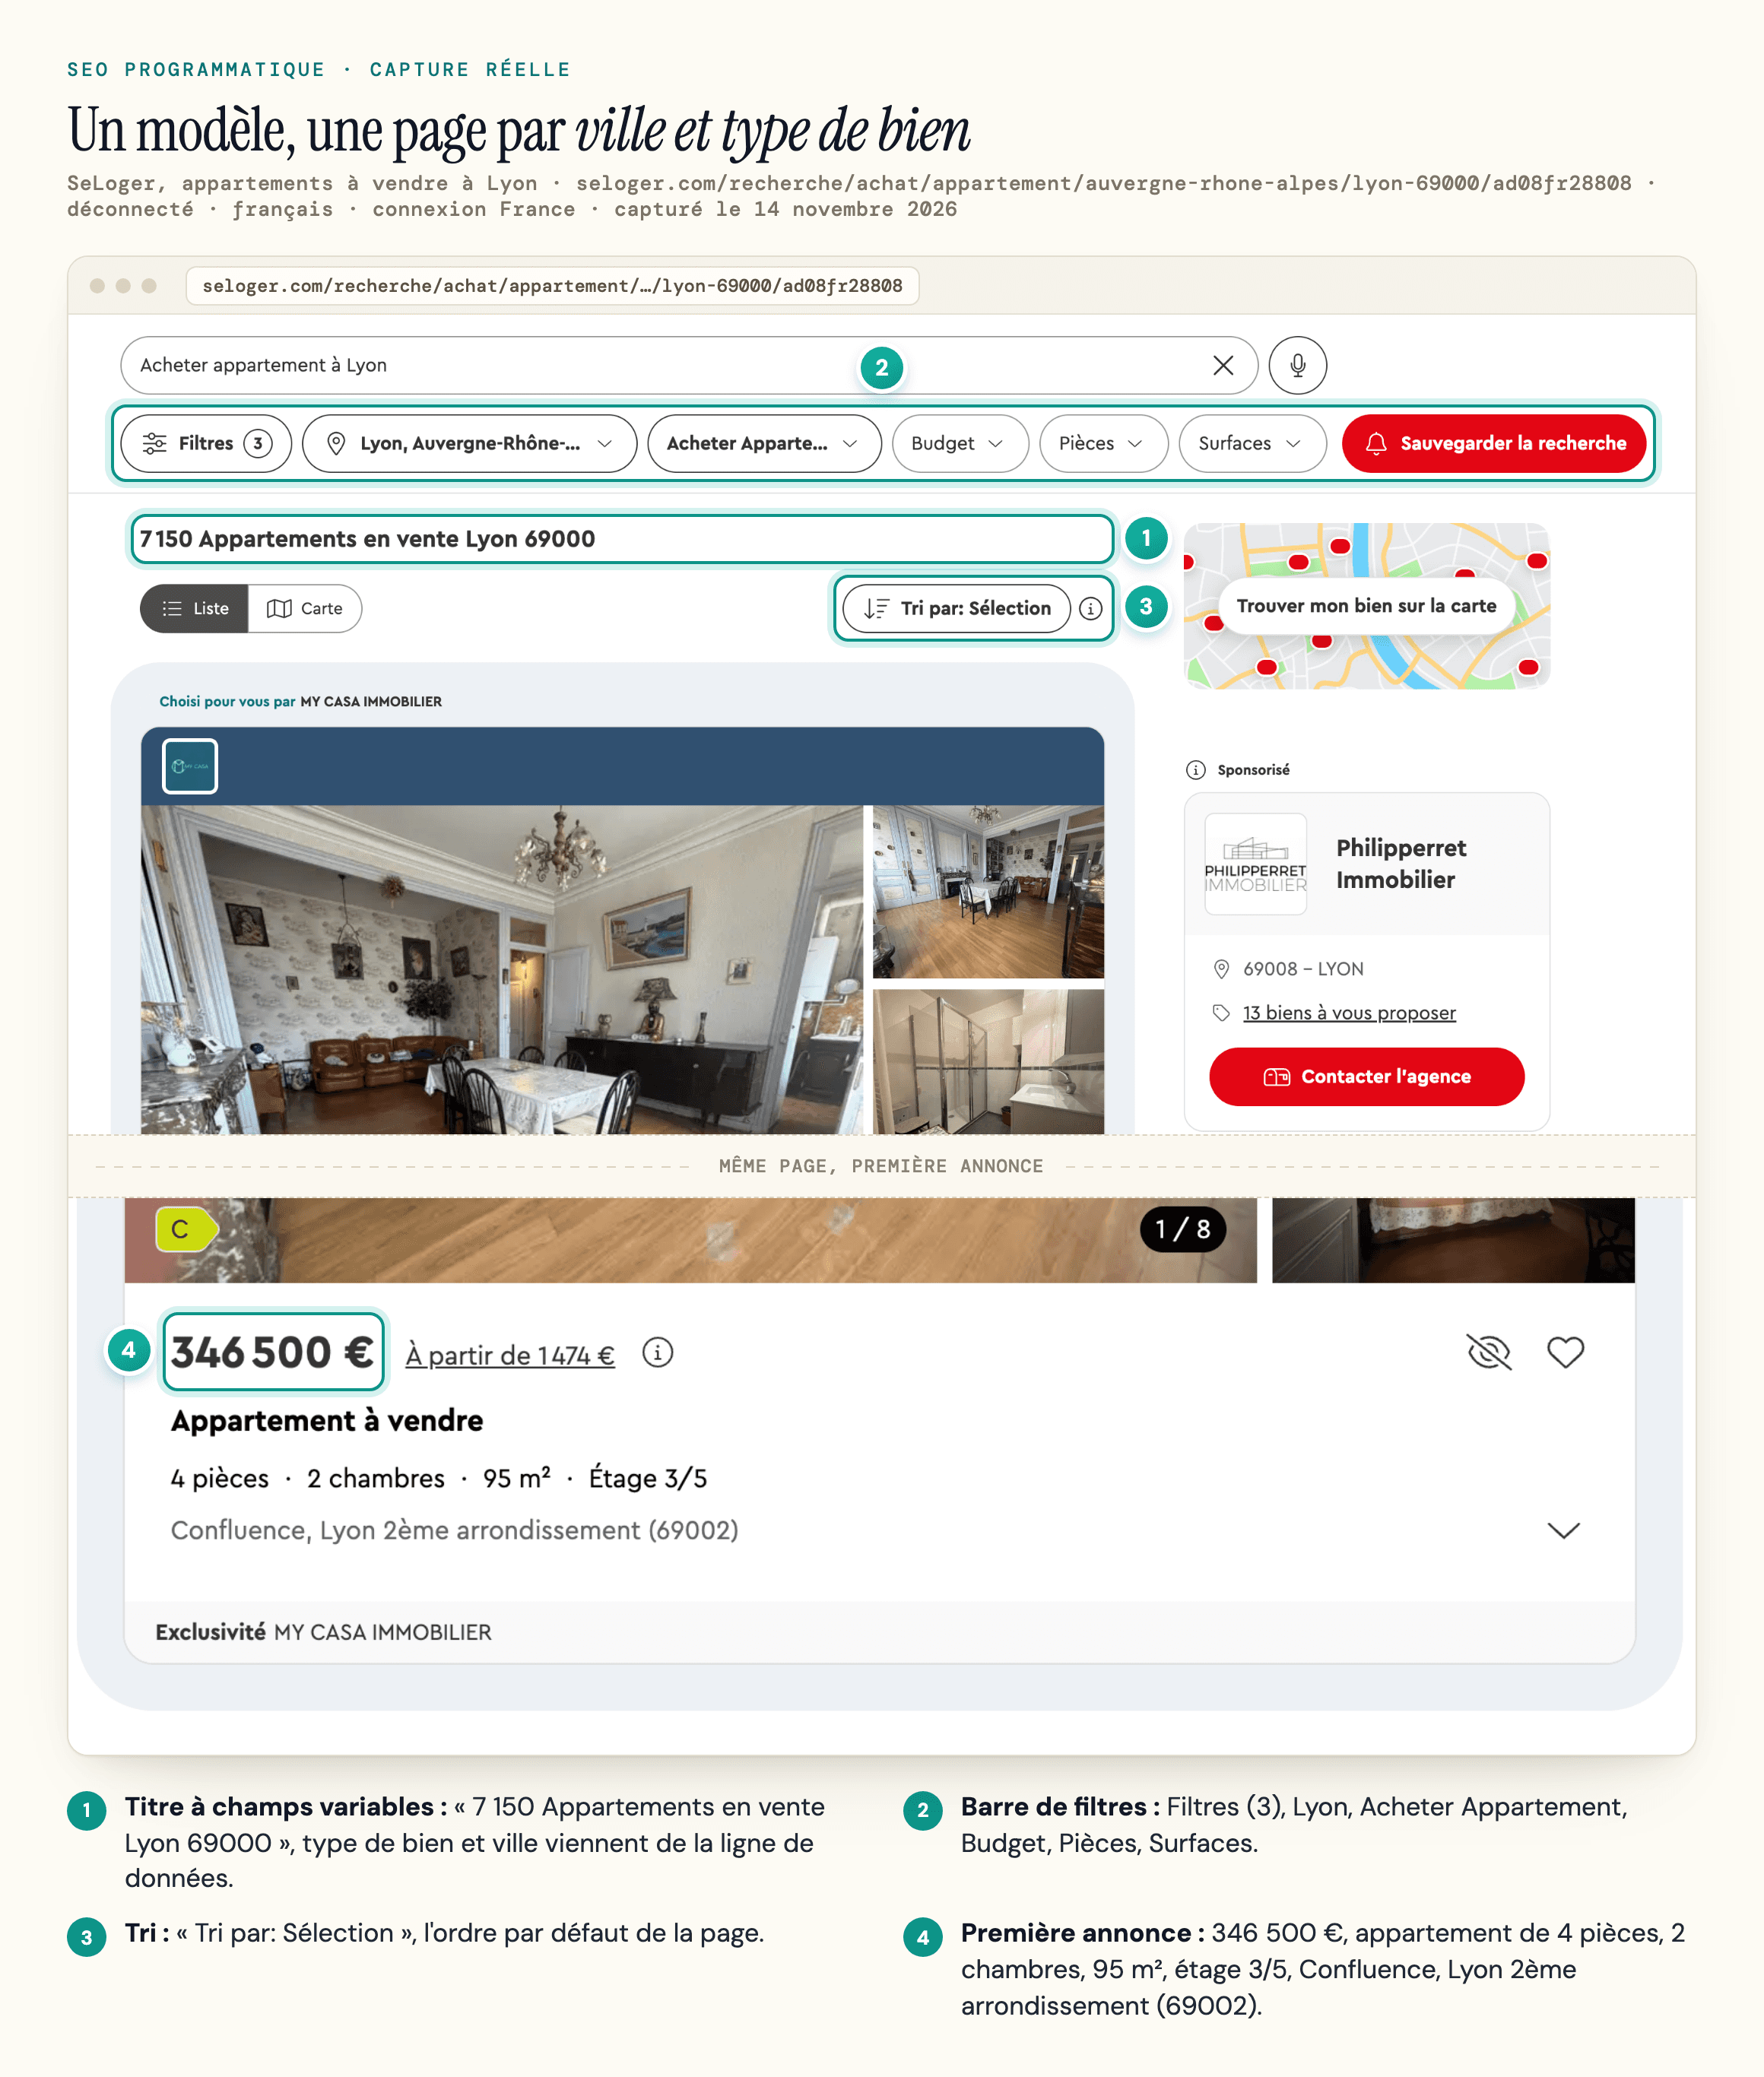
Dans notre test, présenté plus bas, les réponses IA ont aussi cité ce type de page chez Le Figaro Immobilier, Meilleurs Agents et Leboncoin et, côté finance, chez Boursorama et chez XE (pages de codes SWIFT).
Si vos pages ne se distinguent que par le mot-clé du titre, vous avez une liste de mots-clés, pas de quoi construire un ensemble de pages.
Le SEO programmatique fonctionne-t-il encore ? Les règles de Google sur le contenu à grande échelle et les pages satellites
Oui, à condition de respecter deux règles de Google : celle sur le contenu à grande échelle et celle sur les pages satellites. Google ne pénalise pas le SEO programmatique en tant que méthode : ses règles anti-spam visent l’usage qu’on fait souvent des templates.
Les règles de Google concernant le spam définissent l'utilisation abusive de contenu à grande échelle : « L’utilisation abusive de contenus à grande échelle désigne le fait de générer de nombreuses pages dans le but principal de manipuler le classement dans la recherche Google et non d’aider les utilisateurs. » Il s’agit généralement de « grandes quantités de contenus non originaux qui présentent peu ou pas d’intérêt pour les utilisateurs, quelle que soit la façon dont ils sont créés ». Google a ajouté cette règle le 5 mars 2024.
La même page définit l'utilisation abusive des pages satellites (doorway) : des pages créées « pour bien se classer pour des requêtes de recherche spécifiques similaires », qui redirigent les internautes « vers des pages intermédiaires qui ne sont pas aussi utiles que la destination finale ». Parmi les exemples que Google donne pour ces deux règles, trois ressemblent à des erreurs de SEO programmatique :
- « Plusieurs pages ou noms de domaine qui ciblent des régions ou des villes spécifiques, et qui canalisent les internautes vers une seule page »
- « Créer des pages sensiblement similaires qui sont plus proches des résultats de recherche qu’une arborescence clairement définie et facile à parcourir »
- « Utilisation d’outils d’IA générative ou d’autres outils similaires pour générer de nombreuses pages sans ajouter de valeur pour les utilisateurs »
Google applique la même règle à ses fonctionnalités d’IA. Sur l’idée de créer un contenu distinct pour chaque variante de recherche, son guide d’optimisation pour les fonctionnalités d’IA générative précise que « le faire essentiellement pour manipuler les classements ou les réponses de l’IA générative dans la recherche Google enfreint les règles Google concernant le spam et l’utilisation abusive de contenus à grande échelle ». Il ajoute qu’il s’agit « d’une stratégie inefficace sur le long terme ».
Le Google Search Status Dashboard recense des mises à jour anti-spam en mars, juin, août et septembre 2026, et indique qu’une mise à jour principale (core update), distincte, est en cours de déploiement depuis le 10 novembre 2026.
Le test qui distingue un template d’une page satellite
Les règles anti-spam ne nomment jamais le SEO programmatique. Elles décrivent des pages conçues pour se positionner sans rien apporter de neuf au lecteur. Ces trois questions permettent de repérer le problème avant Google :
- Quand la ligne change, qu’est-ce qui change d’autre ? Sur une page de devises, le taux, le graphique et l’historique bougent. Sur une page satellite, seul le nom de la ville change.
- D’où vient chaque chiffre, et de quand date-t-il ? Une page dont les données proviennent d’une base tenue à jour réussit le test. Des chiffres devinés par un modèle de langage, sans source ni date, y échouent.
- Chaque page répond-elle à sa propre intention de recherche ? Deux lignes dont les modificateurs désignent la même recherche, comme « CRM pour dentistes » et « CRM pour cabinets dentaires », ne font qu’une page. Danny Sullivan, rapporte Search Engine Journal, propose de se demander si l’intention était de capter du trafic plutôt que de répondre à ce qu’un internaute attendait vraiment.
John Mueller, de Google, a commenté un site qui, selon lui, déclinait des combinaisons de noms de domaine, de technologies et d’attributs. Dans sa réponse, citée par Search Engine Roundtable, il écrit que ce type de SEO programmatique mène souvent à un site qui relève du spam, frôle le spam ou manque de qualité, et que les systèmes de Google ont peut-être perdu confiance dans ce site à cause de ses anciennes pages.
Quand le SEO programmatique est un mauvais choix
Renoncez-y, ou voyez petit, dans les cas suivants :
- Aucune ligne n’apporte de données, d’outil ou de comparaison introuvables ailleurs. Les pages ne seraient que des réécritures d’un même paragraphe.
- Vos modificateurs ne changent pas l’intention. Les synonymes et les variantes orthographiques vont sur une seule page.
- Le schéma ne donne que quelques dizaines de pages. Les rédiger à la main revient généralement moins cher.
- Les données viendraient d’autres sites et n’ajouteraient presque rien. Parmi ses exemples d’utilisation abusive de contenu à grande échelle, Google cite : « Détournement de flux, de résultats de recherche ou d’autres contenus pour générer de nombreuses pages », lorsque ces pages présentent peu d’intérêt pour les utilisateurs.
- Vos pages feraient croire à une présence locale que vous n’avez pas. Des pages « plombier à [ville] » qui présentent l’entreprise comme implantée là où elle n’a pas d’établissement peuvent relever des pratiques commerciales trompeuses : l’article L121-2 du Code de la consommation vise les allégations fausses ou trompeuses sur l’existence du service et sur l’identité ou les qualités du professionnel, et l’article L132-2 prévoit 2 ans d’emprisonnement et 300 000 € d’amende, portés à 5 ans et 750 000 € pour une pratique commise en ligne. Indiquez plutôt votre zone d’intervention réelle.
Les réponses IA citent-elles des pages générées ? Notre test en France
Souvent, dans notre test, quand la question porte sur des données qu’une page générée contient. Pour les tutoriels d’intégration, les réponses renvoient plutôt vers les éditeurs d’applis eux-mêmes.
Notre méthode
Chez geotoolbox, nous avons mené deux vérifications en France et en français le 14 novembre 2026. La version anglaise de cet article repose sur le même protocole, appliqué aux États-Unis la veille avec des prompts en anglais.
Mots-clés les plus recherchés. Dans la base LLM Mentions de DataForSEO, qui recense des réponses des Aperçus IA de Google, nous avons extrait pour Zapier, Wise et SeLoger les 100 mots-clés au plus fort volume dont la réponse, vue pour la dernière fois entre le 4 août et le 14 novembre 2026, citait le site. Beaucoup sont des variantes orthographiques d’une même recherche : les 100 réponses citent 52 pages distinctes de Zapier, 68 de Wise et 85 de SeLoger.
Nous avons classé ces pages en pages générées (pages d’intégration, de paire de devises, de code bancaire et d’annonces, pages par ville) et en autres pages (articles, pages d’accueil, index, outils), avec des règles d’URL fixées avant l’extraction. Nous avons ensuite corrigé ces règles à deux reprises. La première fois, des pages par ville de SeLoger nous avaient échappé ; leur ajout n’a pas changé le nombre de réponses. La seconde, nous avons retiré deux outils de vérification de Wise et une page index nationale de SeLoger, qui ne sont pas des pages par ligne : Wise est passé de 43 à 40 réponses sur 100, SeLoger de 92 à 89.
Prompts de longue traîne. Nous avons écrit 12 prompts auxquels une page générée devrait répondre, répartis à parts égales entre intégrations, devises et codes bancaires, et immobilier dans des villes françaises. Aucun ne nommait un site de pages générées comme Zapier, Wise ou SeLoger (les prompts d’intégration devaient nommer les deux applis). Chacun se terminait par « Citez vos sources. » et a été lancé une fois dans ChatGPT (recherche web forcée), dans l’API Sonar de Perplexity et dans le Mode IA de Google. Une page ne comptait que si le moteur la citait dans sa réponse. Par « page générée », nous entendons ici toute page d’un ensemble construit sur un même schéma, quel que soit le site. Les outils paramétrés par l’URL, comme le convertisseur de XE, n’en font pas partie (en les comptant, on passerait à 89 citations sur 147).
Ce que nous avons constaté
Sur les 100 mots-clés de notre sélection, aucune réponse citant Zapier ne renvoie à l’une de ses pages générées : ses 102 citations sont allées à des articles de blog sur des sujets larges, comme les générateurs d’images IA ou la recherche d’image inversée, ainsi qu’à sa page d’accueil et à l’index de ses applis. Une page par paire d’applis ne peut pas répondre à ces recherches. Les pages par ligne de Wise (paires de devises, pages par devise, codes SWIFT) sont citées dans 40 réponses sur 100, les pages d’annonces et les pages par ville de SeLoger dans 89.
Sur les 12 prompts, 85 des 147 citations vont à des pages générées, et 30 des 36 réponses en citent au moins une. La réponse du Mode IA sur l’euro face à la livre sterling ne citait aucune source retenue par notre règle de comptage : ses références renvoyaient toutes à Google Finance.
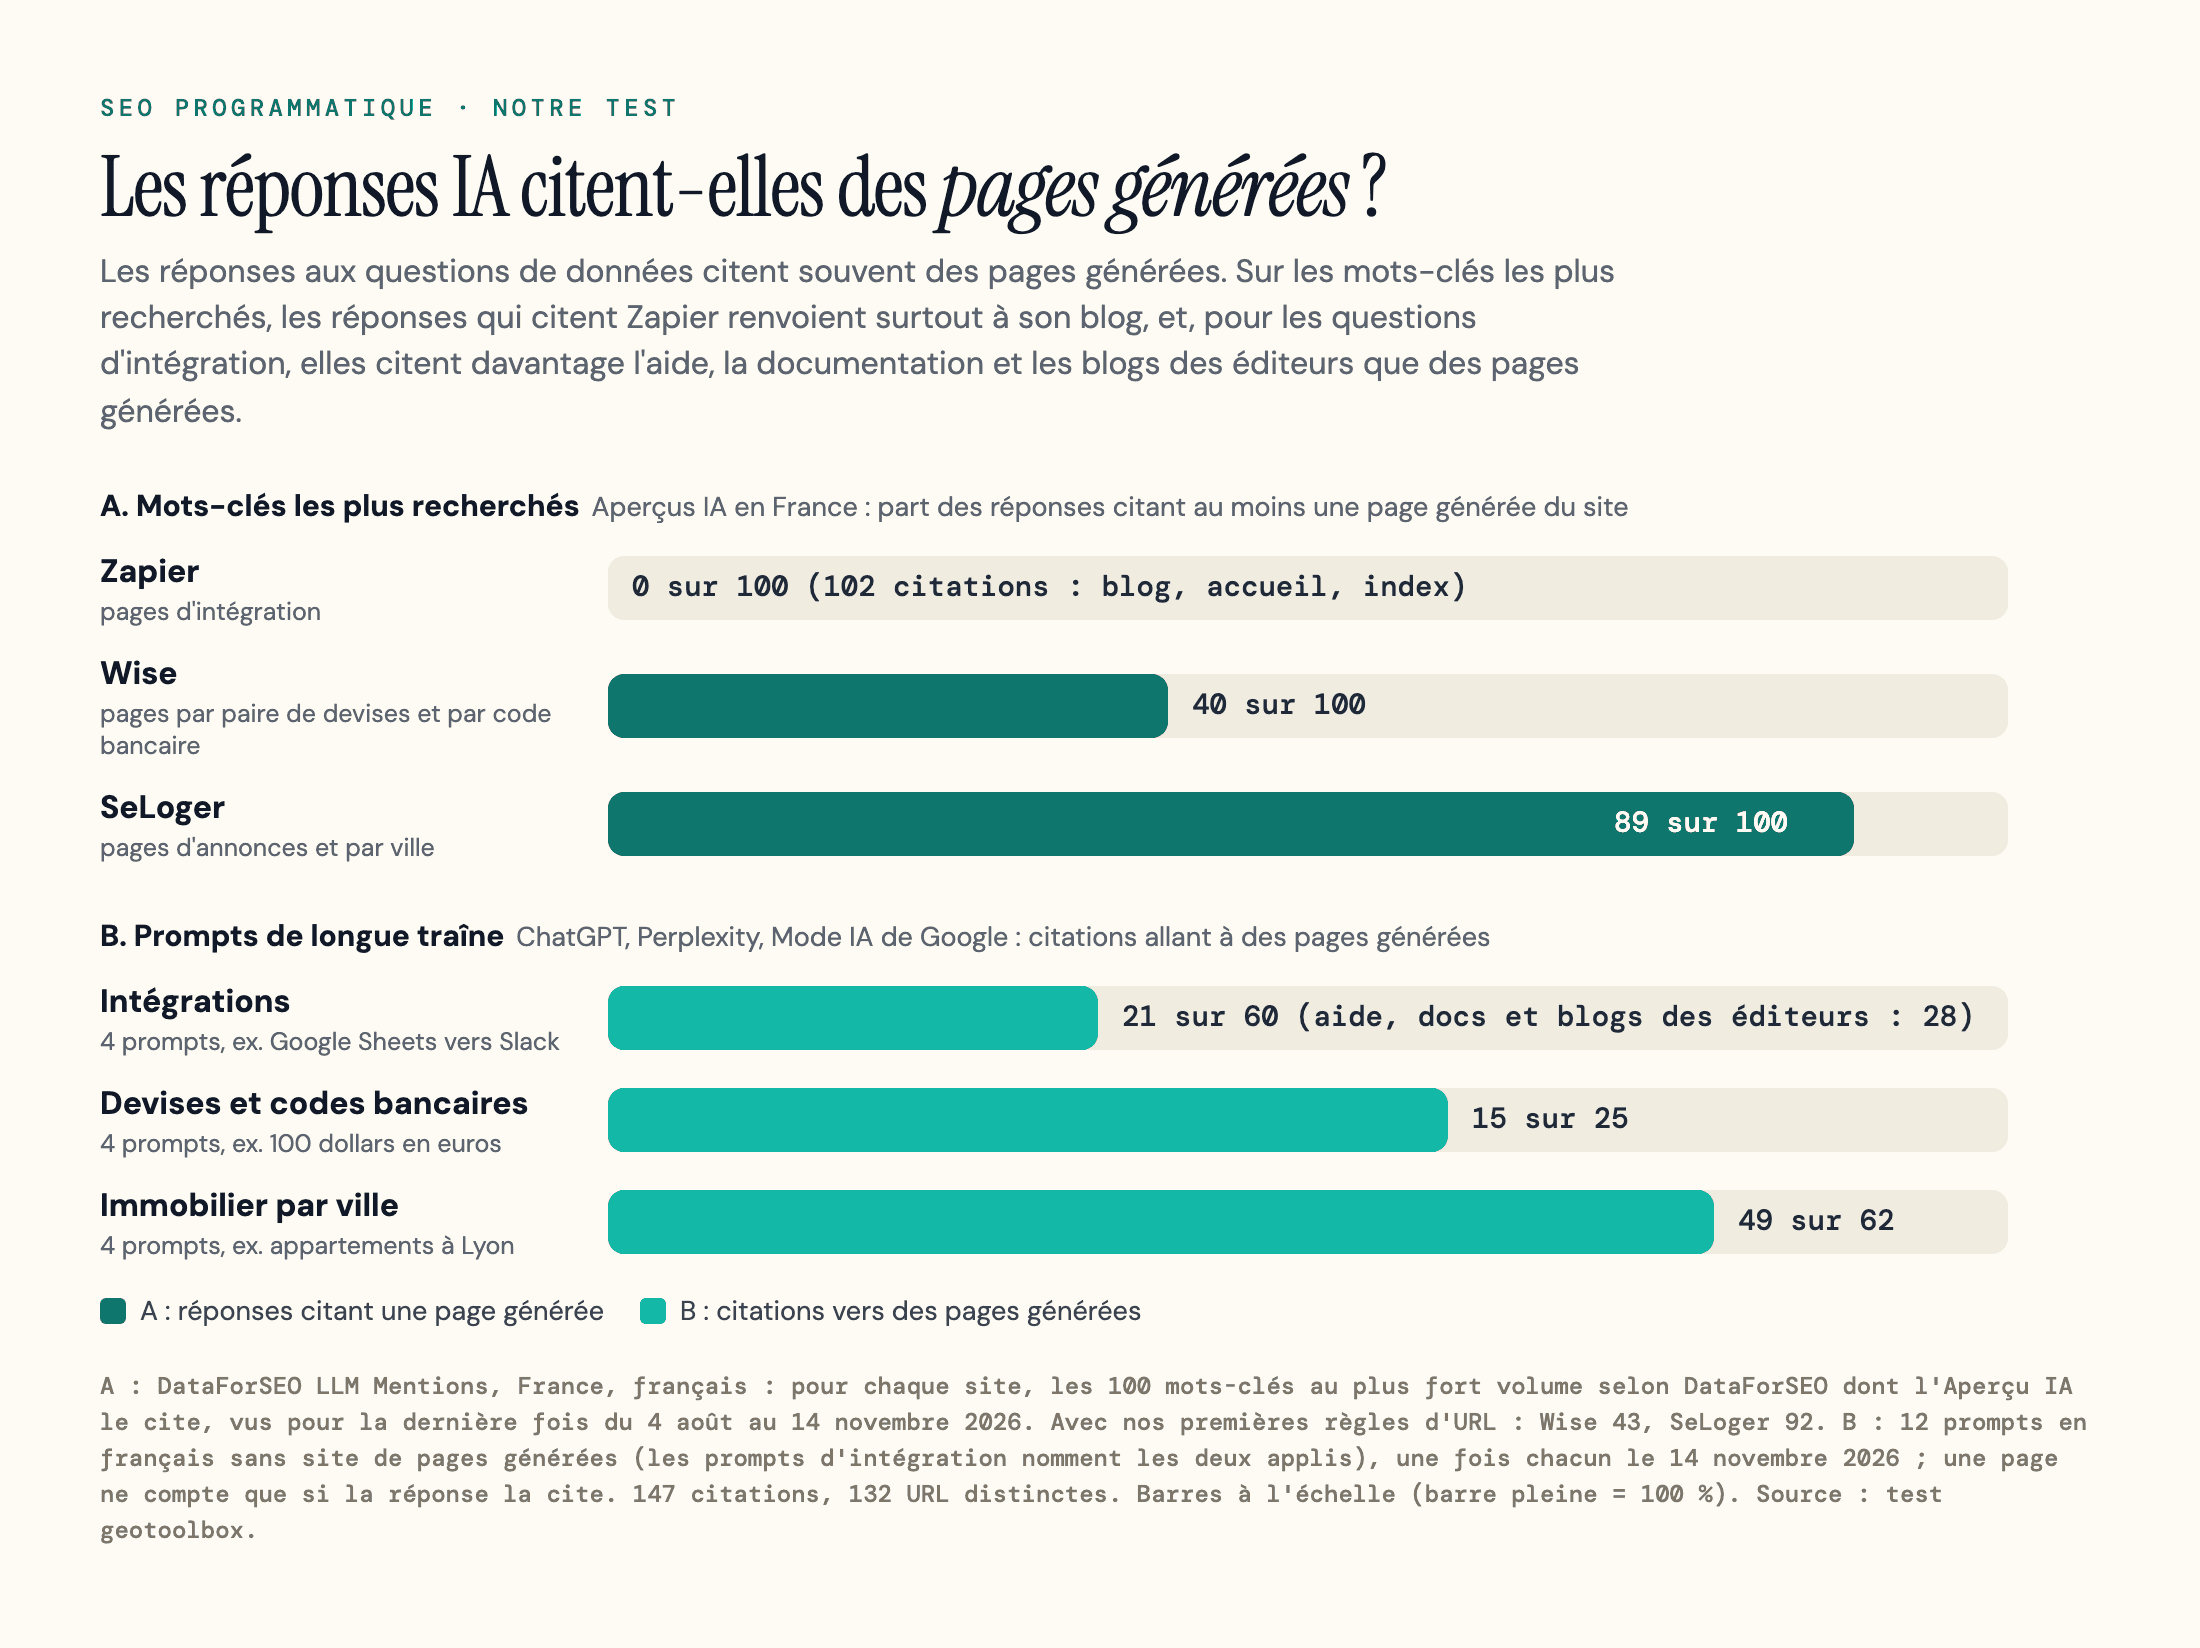
C’est sur les questions de données que les pages générées sont le plus citées : 15 citations sur 25 pour les devises et les codes bancaires, 49 sur 62 pour l’immobilier. Pour les prompts d’intégration, les citations se répartissent autrement : 21 sur 60 renvoient à des pages d’intégration ou de marketplace, 28 aux pages d’aide, à la documentation et aux blogs des éditeurs d’applis (dont 14 pour Calendly, toutes sur un seul prompt) et 11 à d’autres tutoriels.
Deux questions de données ont fait exception. Sur le taux de change de l’euro en franc suisse, aucune page générée n’a été citée : les moteurs ont renvoyé vers la Banque nationale suisse et vers le convertisseur de XE. Sur le loyer moyen d’un studio à Paris, 2 citations sur 13 seulement concernent des pages générées ; le reste revient à des baromètres et à des articles de sites de location.
Lors du test, à la question sur le code BIC de BNP Paribas à Paris, le Mode IA de Google n’a cité que des pages générées : les pages de codes SWIFT de Wise et de Remitly. Sur les trois moteurs, 6 citations sur 7 concernent ce type de page.
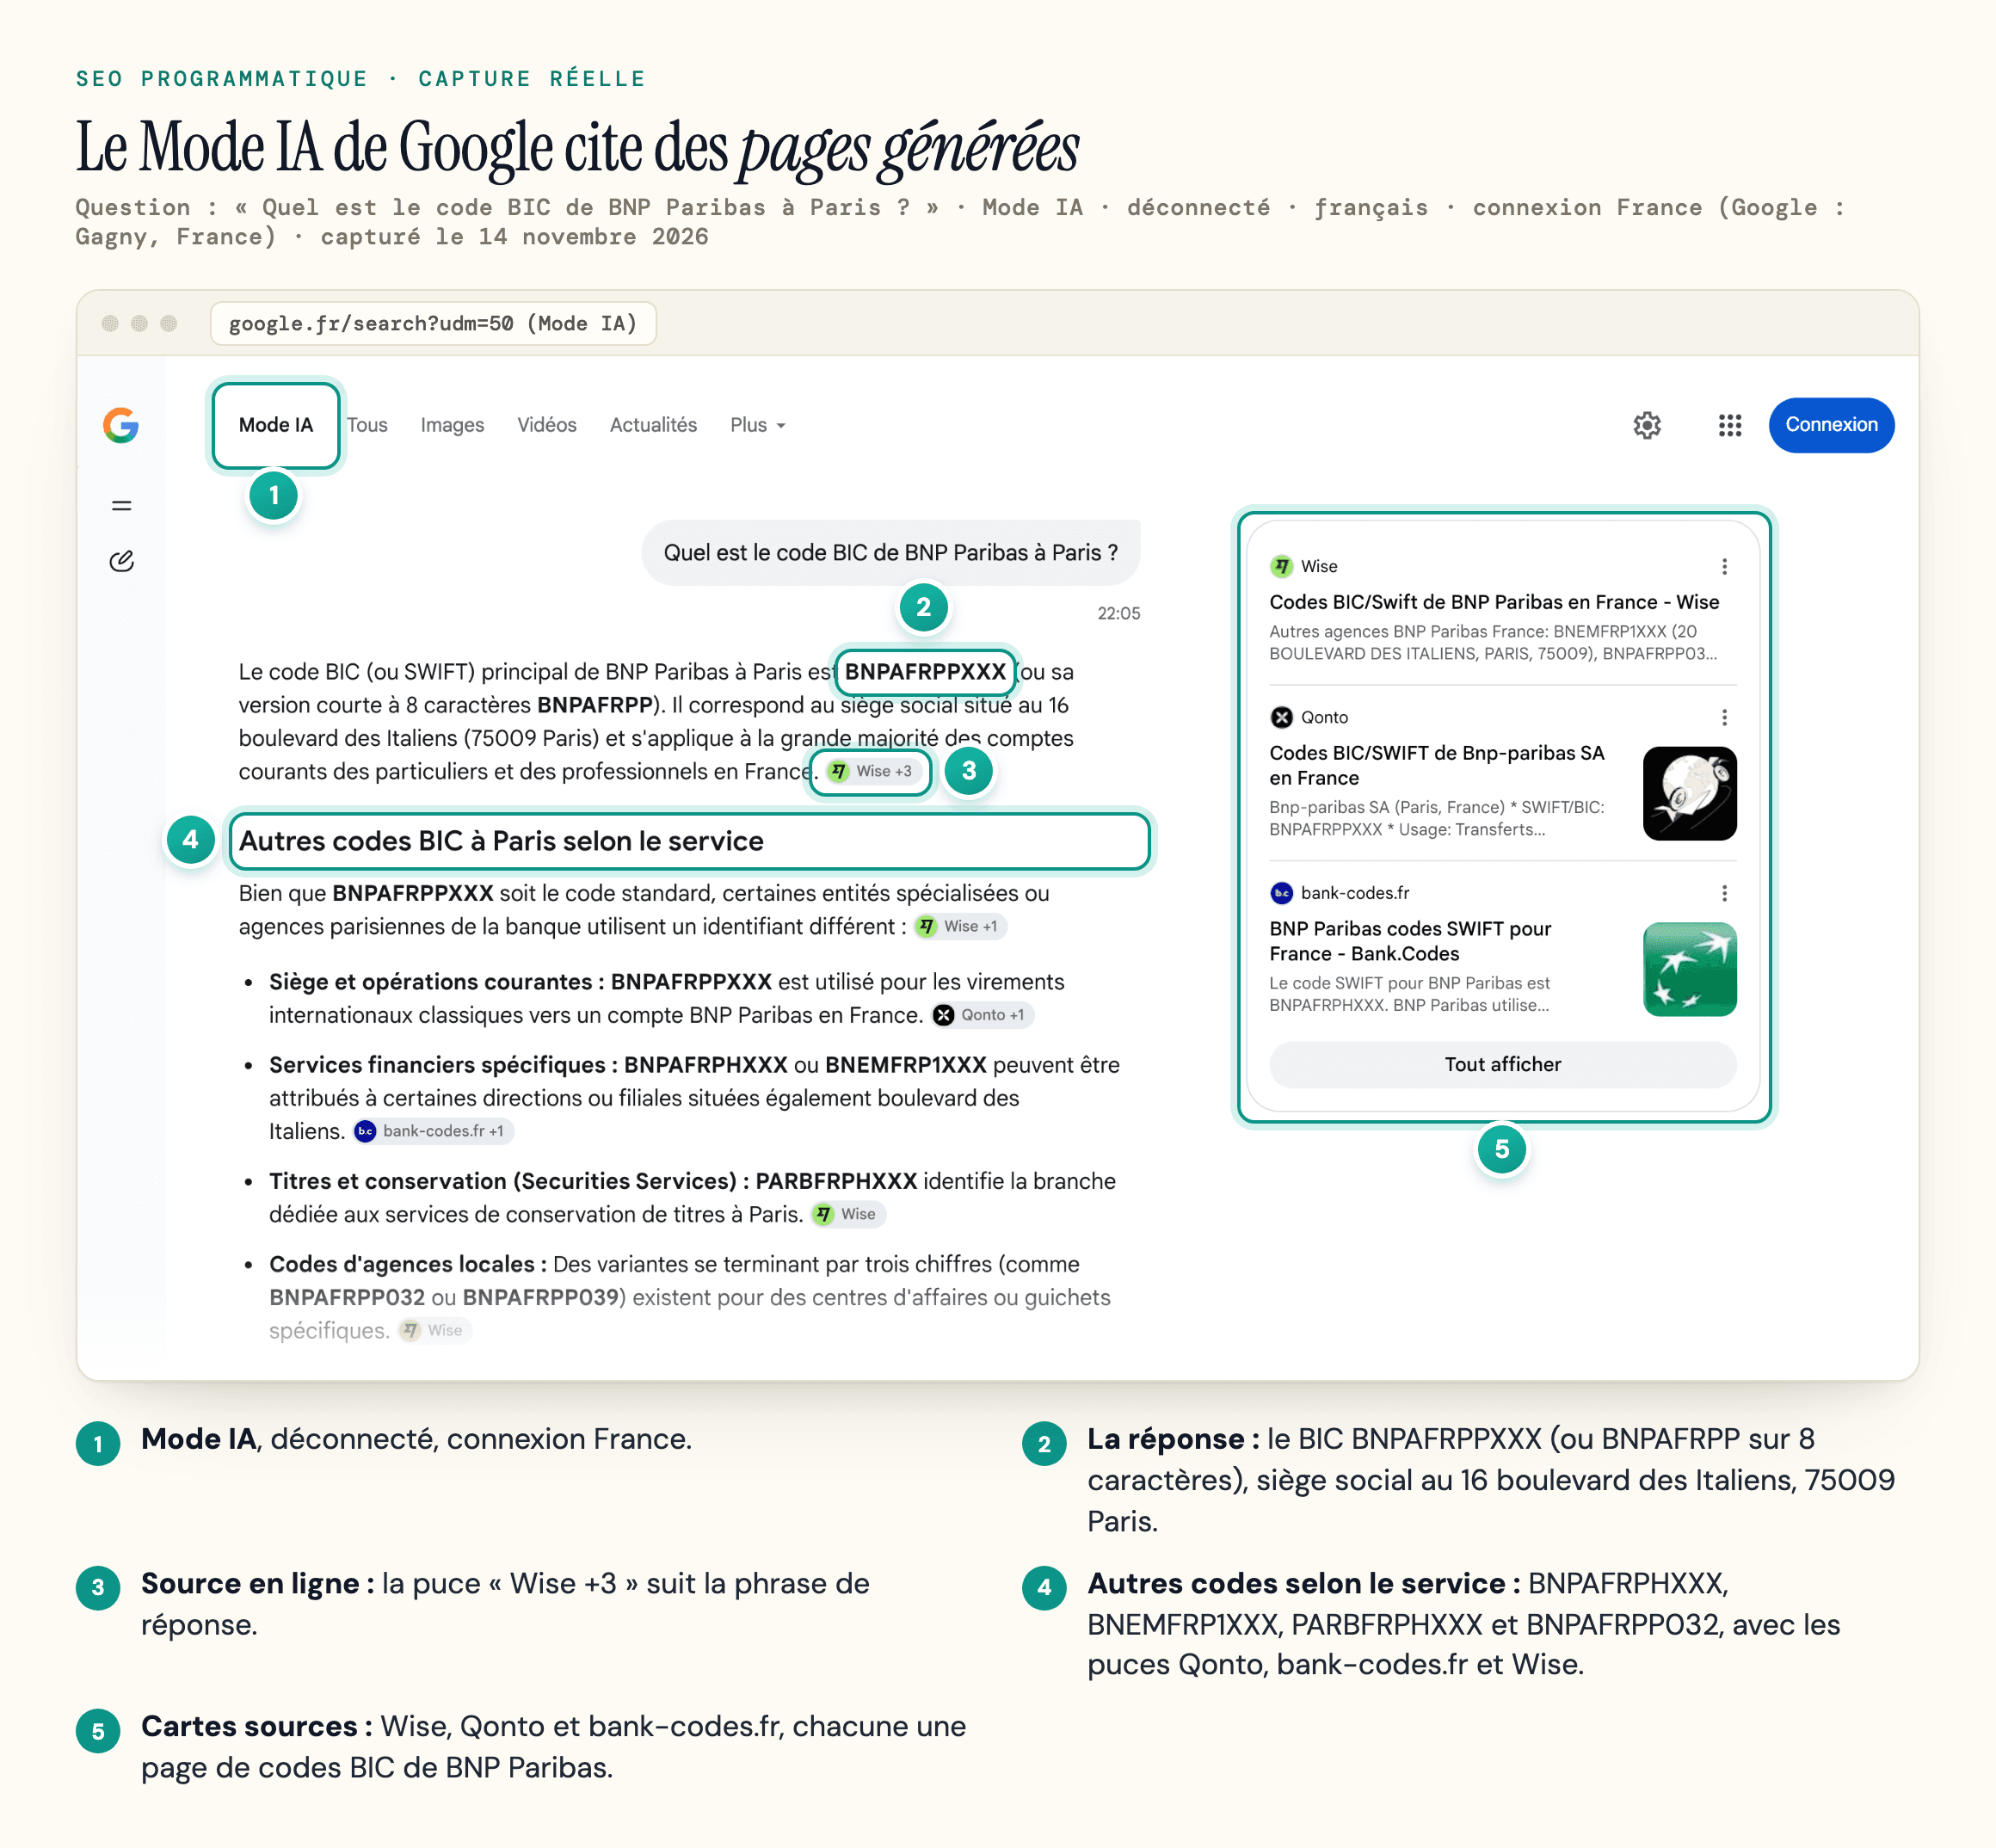
Ce qui rend une page générée citable
Douze prompts lancés une fois ne permettent pas d’isoler des causes. Mais quand un prompt demandait un code, une annonce ou un prix par ville, la plupart des citations sont allées à des pages générées (prix des maisons à Lille : 12 sur 14). La page d’intégration d’un éditeur est aussi une page générée : la page Salesforce de Calendly figure parmi les 21 citations comptées plus haut, et les articles d’aide de Calendly ont recueilli, de leur côté, 14 citations.
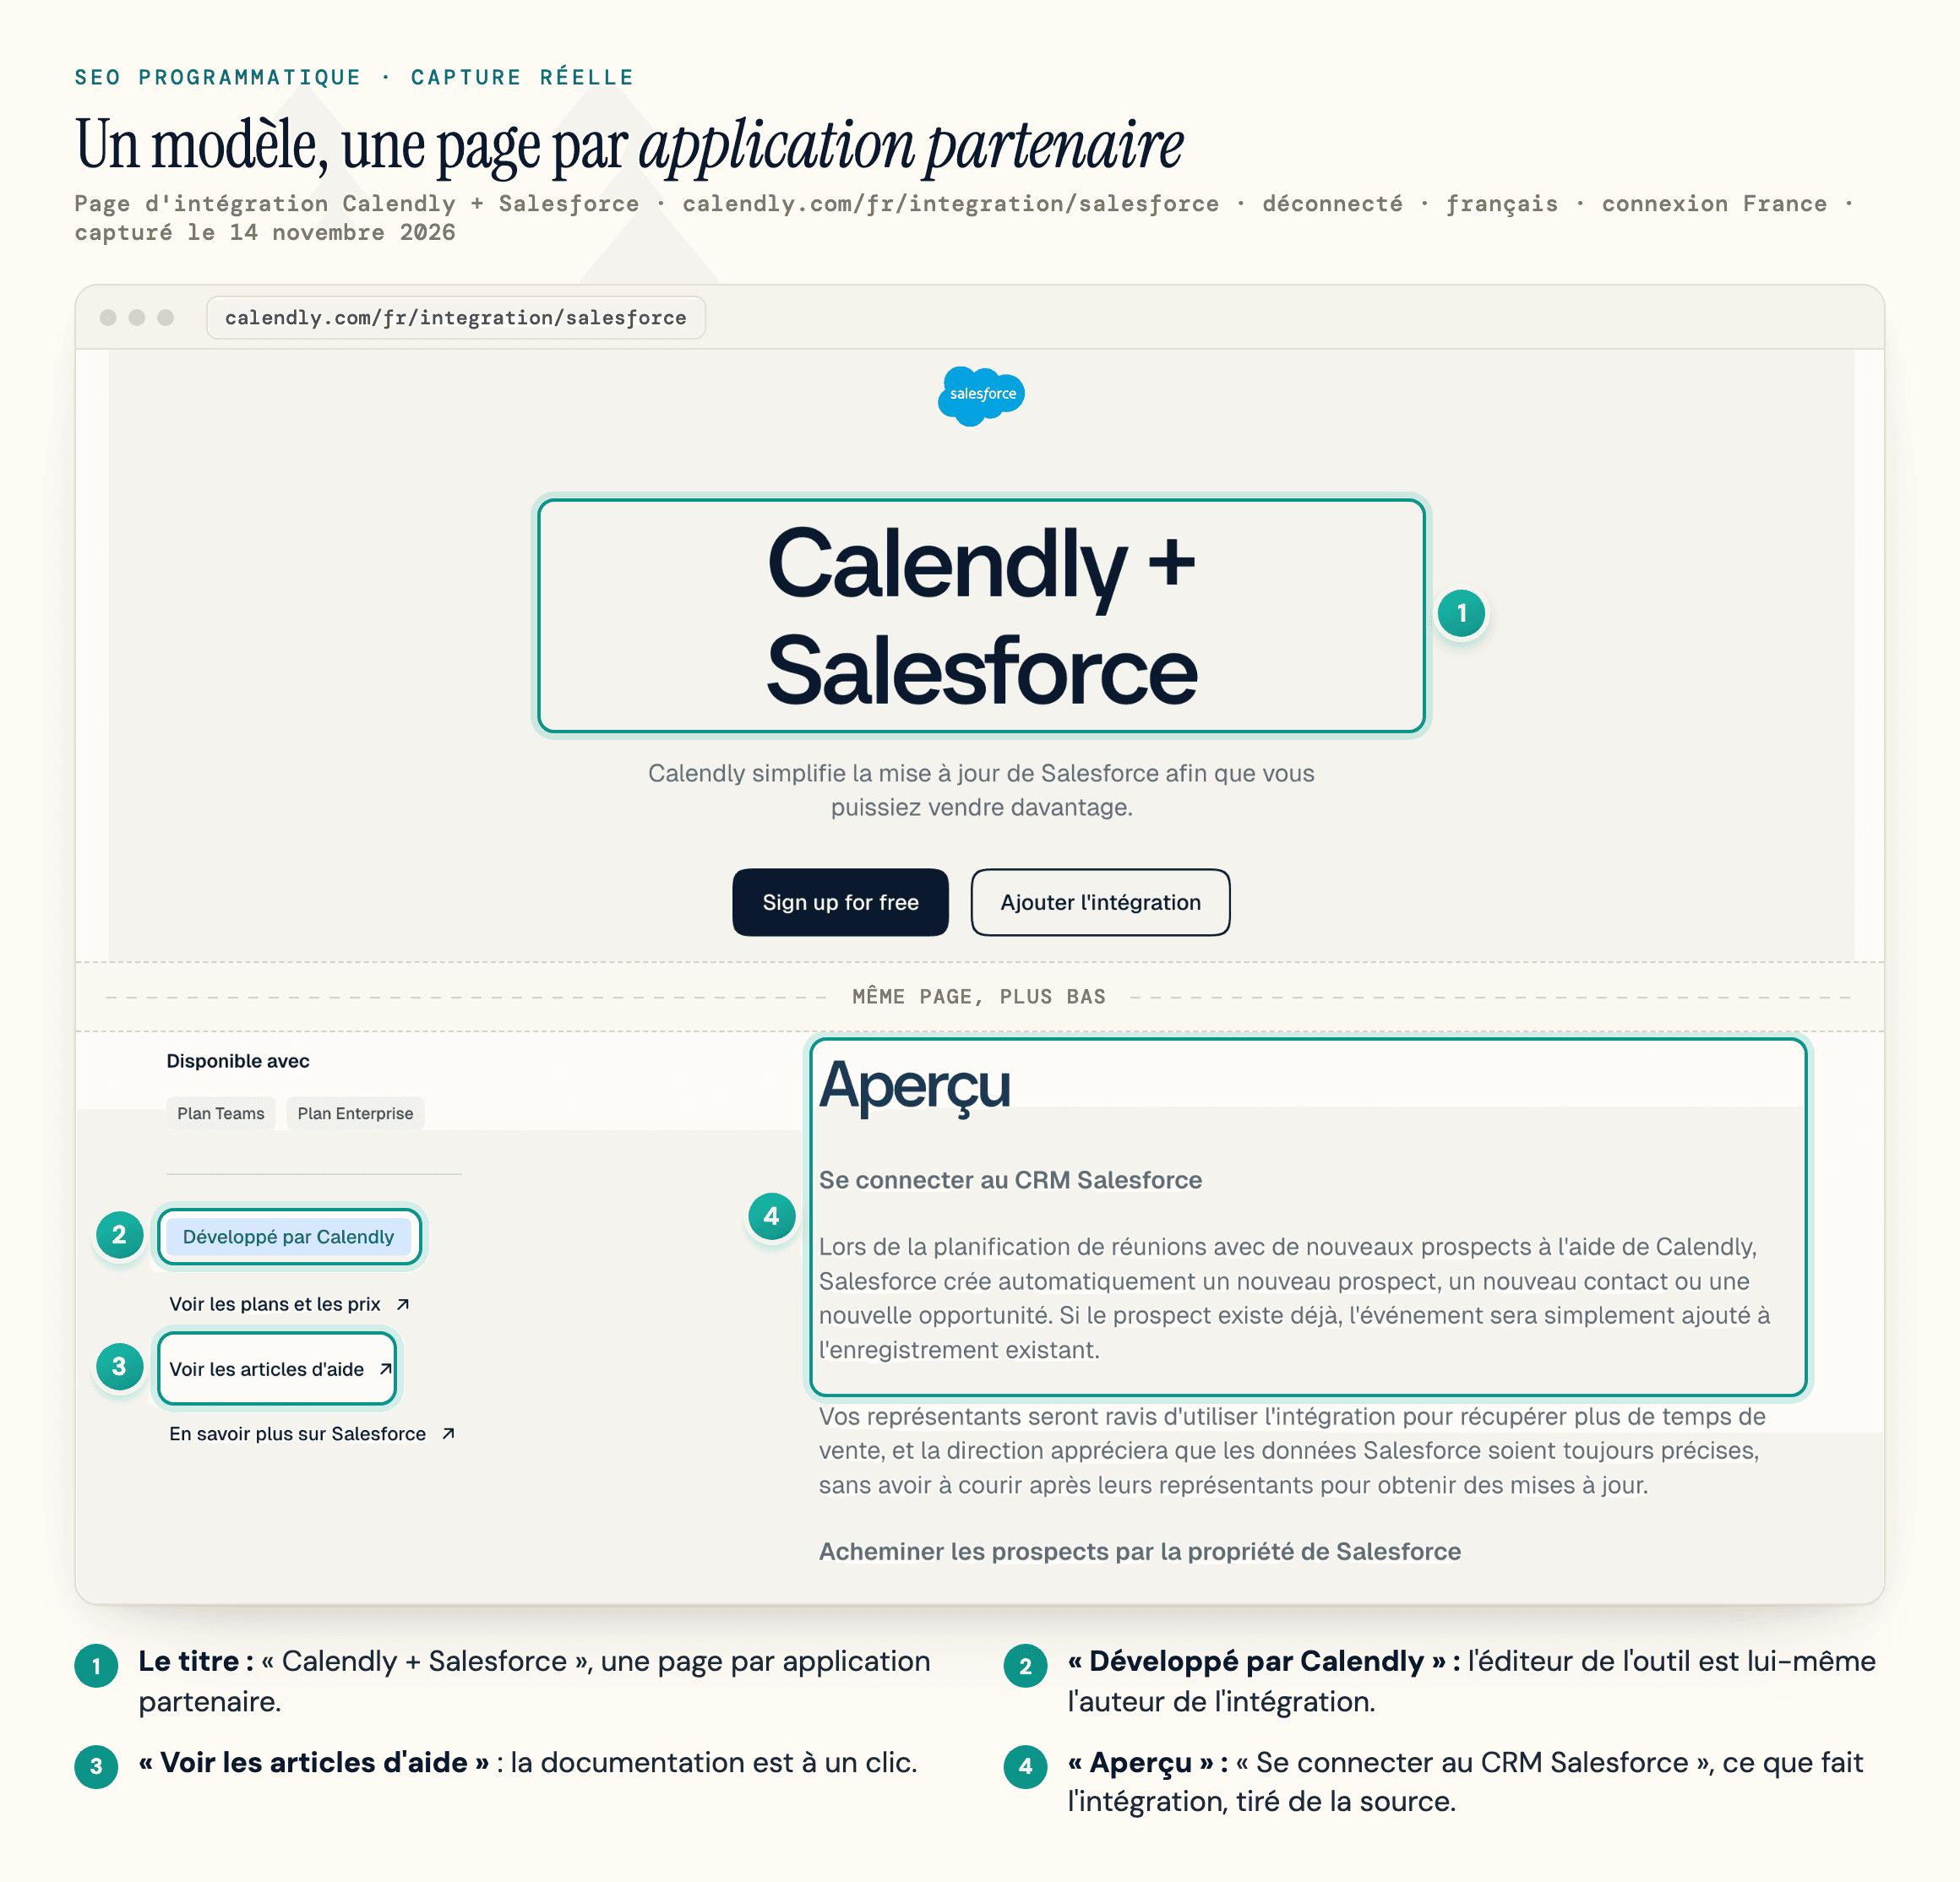
Sur les mots-clés larges, ce sont les articles de Zapier qui sont cités : continuez donc à bâtir une autorité thématique autour de vos ensembles de pages. Vérifiez aussi l’accès des robots d’exploration : dans le robots.txt, une règle de blocage visant un robot d’IA arrête le robot de ce service, alors que les fonctionnalités d’IA de Google s’appuient sur Googlebot et que certains assistants récupèrent les pages à la demande d’un utilisateur (notre guide des robots d’exploration IA précise lesquels).
Construire un projet de SEO programmatique, étape par étape
Dans une stratégie de SEO programmatique, les données et les contrôles qualité passent avant le volume : chaque ligne est soumise à un contrôle de complétude avant de pouvoir devenir une page, et seul un lot pilote est mis en ligne dans un premier temps.
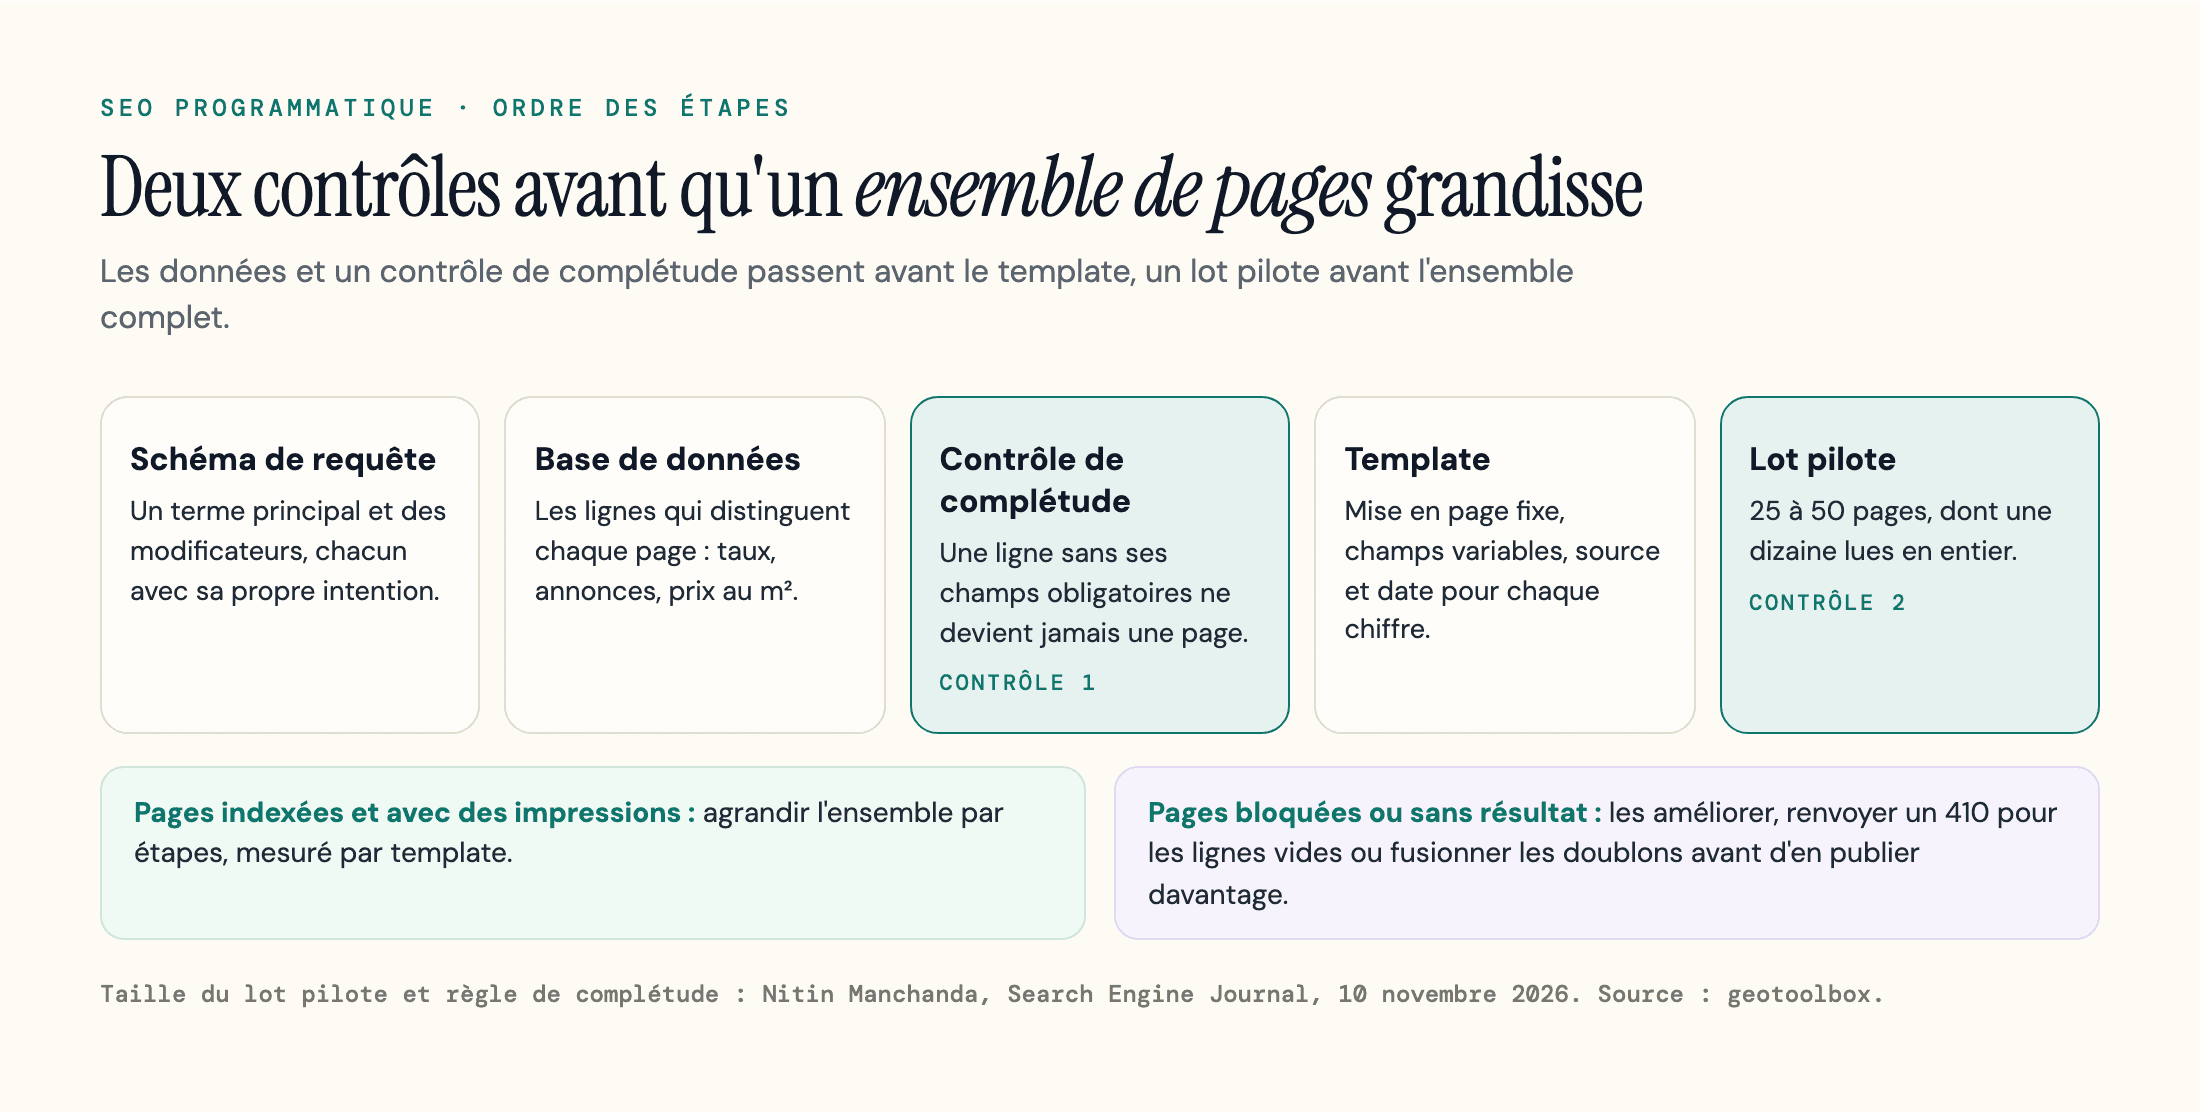
1. Trouver un schéma de requête avec une vraie demande
Partez d’un terme principal et des modificateurs que les internautes y associent : « intégration [appli] + [appli] », « [outil A] vs [outil B] », « [produit] pour [secteur] ». Lancez une recherche de mots-clés sur un échantillon de combinaisons pour vérifier qu’elles ont du volume.
Contrôlez également que chaque modificateur change l’intention de recherche : des modificateurs qui désignent la même recherche vont sur une seule page. En SEO B2B, un schéma « [service] pour [secteur] » ne tient que si chaque page sectorielle apporte ses propres caractéristiques et ses propres preuves.
2. Réunir des données qui changent sur chaque page
Plusieurs sources conviennent : vos propres données produit, les flux de partenaires, des jeux de données publics sous licence, des API ou le contenu généré par les utilisateurs, par exemple les avis. Fixez un seuil avant toute mise en ligne. La checklist de Manchanda est claire : définissez le niveau minimal de complétude qu’une ligne doit atteindre pour générer une page, et faites-le respecter dans le code.
Désignez un responsable et prévoyez un rythme de mise à jour pour chaque champ qui change, sinon tout l’ensemble de pages vieillit d’un coup. Chez SeLoger, la page de prix de chaque ville repose sur le même template, mais les prix au m² viennent des données de cette ville, et la page indique la date de leur dernière mise à jour (« Prix estimé mis à jour le 01 novembre 2026 » pour Lille).
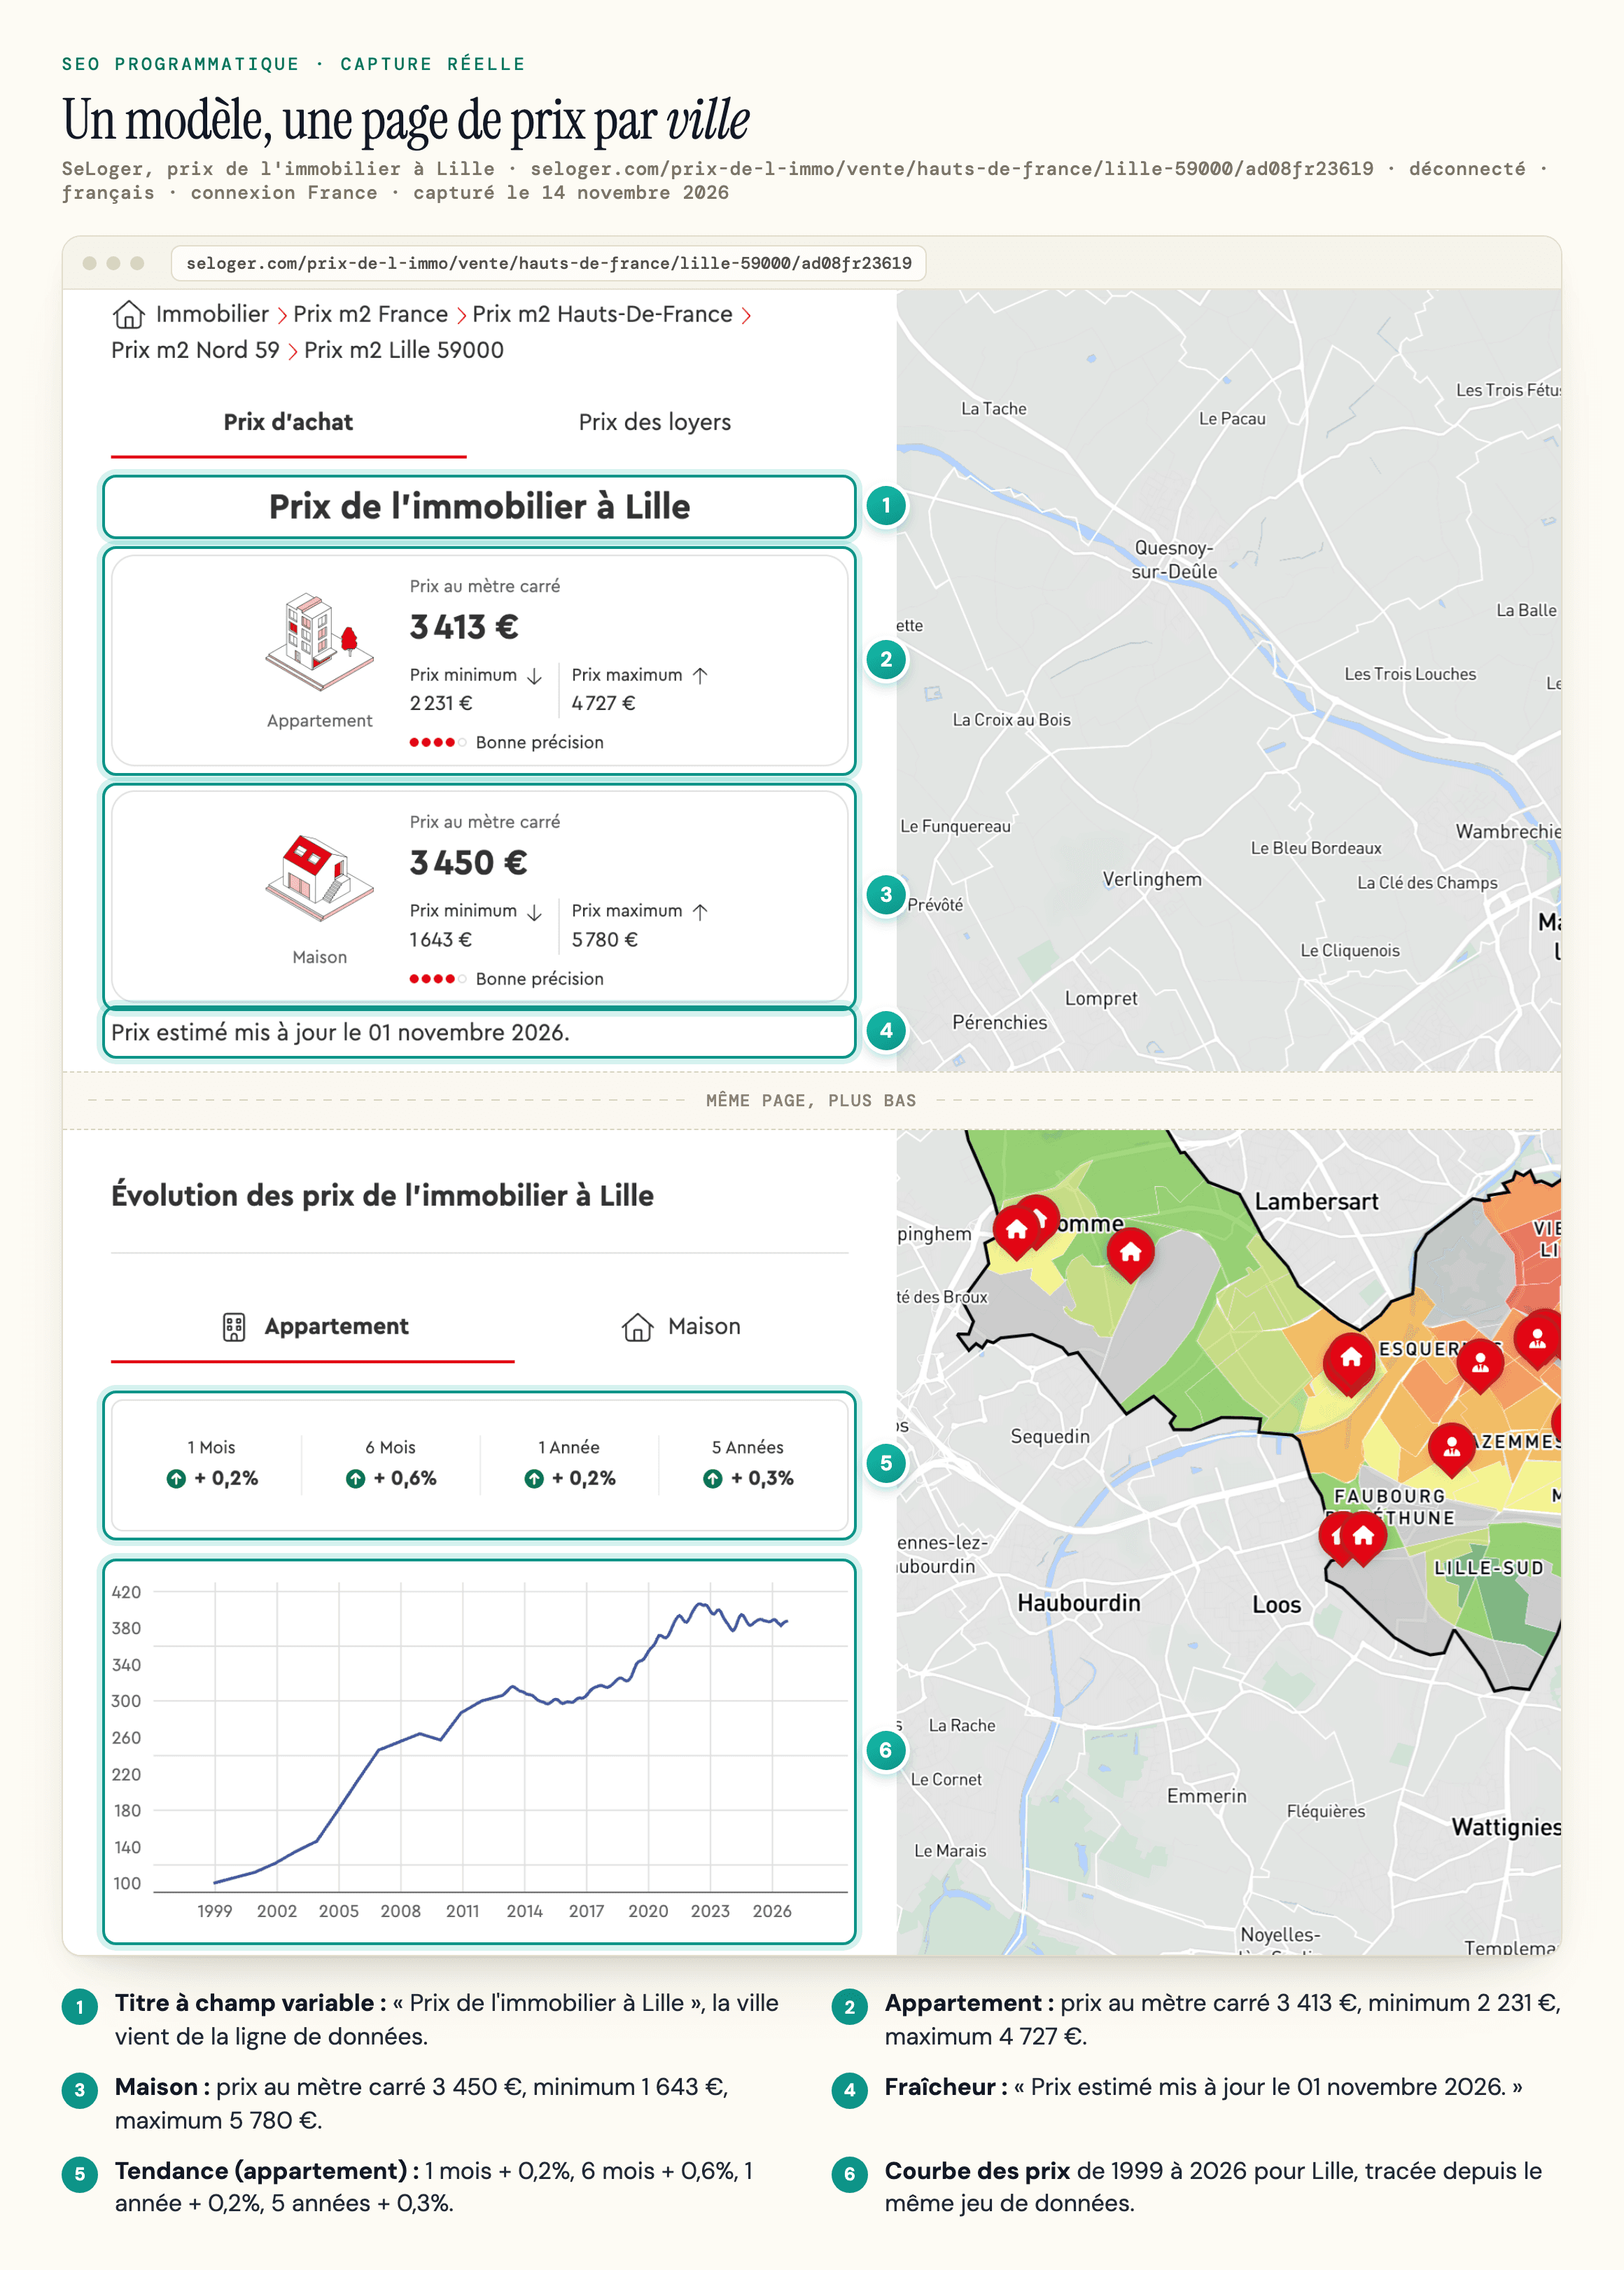
3. Concevoir le template autour des données
Séparez le template en parties fixes (mise en page, notes de méthode, navigation) et en parties variables, remplies à partir de la ligne. Indiquez d’où vient chaque chiffre et quand il a été mis à jour. Faites varier les titres et les meta descriptions avec les données, et générez les données structurées JSON-LD de la page à partir de la même ligne (voir notre guide du balisage Schema pour l’IA).
Les noms de lieux français demandent un soin particulier. Le guide de Google sur la structure des URL recommande des mots dans la langue de votre audience (translittérés le cas échéant) et l’encodage-pourcent des caractères non ASCII dans les liens. Choisissez une seule forme de slug par ligne (avec ou sans accents), générez-la dans le template et redirigez l’autre en 301. La France compte 34 969 communes d’après l’API Géo de l’État, et 1 441 noms sont portés par plusieurs communes (Saint-Denis par quatre) : ajoutez le numéro de département au slug quand un nom est partagé. Gérez enfin dans le template les prépositions et les élisions (à Lyon, au Mans, d’Angers).
4. Choisir des outils de SEO programmatique adaptés à votre équipe
Les petites équipes s’appuient sur un tableur ou une base Airtable qui alimente Webflow ou WordPress via une extension d’import. Les plus grandes génèrent les pages depuis une base de données dans un framework comme Next.js.
Si une IA rédige les phrases qui entourent les données, les consignes de Google sur le contenu généré par IA s’appliquent : « concentrez-vous sur l’exactitude, la qualité et la pertinence, en particulier lorsque vous générez automatiquement du contenu ». Demandez au modèle de décrire vos données, puis relisez ce qu’il écrit.
5. Lancer un lot pilote
Publiez d’abord 25 à 50 pages. Pour Manchanda, publier 10 000 pages avant de connaître le taux d’indexation est l’erreur la plus fréquente de la discipline ; il conseille de lire une dizaine de pages en entier au lancement.
6. Intégrer les pages au site
Planifiez le maillage interne : donnez à chaque ensemble de pages une page hub, un fil d’Ariane et des liens entre lignes proches (villes voisines, autres paires pour la même appli). Les pages accessibles uniquement par le sitemap sont explorées et indexées de façon moins fiable. Répondez aux sous-questions connexes sur la page dont elles relèvent, comme nous l’expliquons dans notre guide de la décomposition des requêtes (query fan-out).
Faire indexer des milliers de pages
Publier un ensemble de pages ne suffit pas à le faire indexer. Dans le rapport sur l’indexation des pages de la Search Console, les pages programmatiques s’accumulent souvent sous deux statuts :
- « Détectée, actuellement non indexée » : Google a trouvé l’URL mais ne l’a pas encore explorée. Selon sa page d’aide, Google voulait en général explorer l’URL, mais l’exploration a été reportée « car votre site risquait d’être surchargé ».
- « Explorée, actuellement non indexée » : Google a récupéré la page et a choisi de ne pas l’indexer. Google juge ce message courant, mais si une grande part des pages d’un même template se retrouve sous ce statut, vérifiez qu’elles ne se ressemblent pas trop.
Le budget d’exploration (crawl budget), abordé dans notre guide du SEO technique, compte surtout à grande échelle. Le guide de Google sur le budget d’exploration s’adresse aux sites de plus d’un million de pages dont le contenu change environ une fois par semaine, aux sites de plus de 10 000 pages qui changent chaque jour, et à ceux dont une grande part des URL est classée « Détectée, actuellement non indexée ». Google précise : « Il ne s’agit pas de seuils exacts. »
Ces corrections traitent les causes les plus courantes sur un ensemble de pages :
- Renvoyez un code 404 ou 410 pour les lignes qui n’auront jamais de données, plutôt qu’une page « aucun résultat » servie avec un code 200. Le guide prévient que ces pages soft 404 « continuent à être explorées et consomment donc inutilement une partie de votre budget », et il déconseille la balise noindex pour les pages que vous ne voulez pas voir explorées. Une page dont la liste est vide pour l’instant peut rester en ligne si elle affiche encore des chiffres utiles.
- Découpez le sitemap XML par template, pour voir le nombre de pages indexées par ensemble (voir notre guide des sitemaps XML).
- Regroupez les vrais doublons, comme une variante de filtre qui renvoie la même liste qu’une autre URL, avec des balises canoniques. Une page de filtre qui a ses propres résultats, comme les appartements à vendre à Lyon, peut rester indexable.
- Contrôlez le HTML rendu sur les frameworks JavaScript, où un titre manquant ou un mauvais code d’état peut passer pour un problème de contenu (notre guide du SEO JavaScript détaille les vérifications).
Mesurer par template et réagir quand le trafic chute
Jugez un ensemble de pages comme un tout : le rapport sur l’indexation des pages de la Search Console donne la part des URL d’un template qui sont indexées, et le rapport sur les performances, avec un filtre de page par expression régulière (regex) comme /integrations/, donne les impressions, les clics organiques et la position. Suivez dans votre outil d’analyse les conversions que ces pages génèrent.
Les rapports sur les performances dans l’IA générative de la Search Console, lancés le 3 juin 2026 et, selon Google, déployés sur tous les sites Web dans le monde depuis le 31 août 2026, indiquent combien de fois vos URL apparaissent dans les Aperçus IA et le Mode IA. Ils valent donc pour un site français : les deux fonctionnalités sont disponibles en France depuis le 22 juillet 2026. Là encore, regroupez ces URL par template.
Fixez une règle d’élagage avant le lancement. Celle de Manchanda : si une part donnée d’un ensemble de pages n’obtient aucune impression, fonctionnalités d’IA comprises, dans un délai donné, supprimez ces pages ou fusionnez-les. Choisissez la part et le délai avant de publier, et vérifiez que les pages sont bien indexées avant d’élaguer.
Quand un ensemble de pages perd du trafic après une mise à jour, ouvrez d’abord le rapport sur les actions manuelles. Une action manuelle liste les formats d’URL concernés, ou le site entier, et exige une correction suivie d’une demande de réexamen ; une baisse algorithmique demande un diagnostic, une correction et du temps. Adaptez ensuite la correction à la page :
| Situation | Action | Pourquoi |
|---|---|---|
| La page a des données utiles mais une présentation pauvre | L’améliorer : ajouter les champs, les sources et les dates manquants | Ce sont les données qui justifient la page |
| La ligne n’a pas de données et n’en aura pas | Renvoyer un 410 (ou un 404) | Indique à Google que la page n’existe plus : elle sortira de l’index à la prochaine exploration |
| La page fait doublon avec une page plus solide de l’ensemble | Rediriger en 301 vers cette page, ou fusionner les deux | Une URL par intention |
| La page aide les visiteurs du site mais n’a pas de demande en recherche | La garder, avec une balise noindex | Reste utile dans la navigation, hors de l’index ; à grande échelle, bloquez plutôt dans le robots.txt les chemins pas encore indexés |
| La majorité de l’ensemble est quasi dupliquée | Arrêter de publier, ne garder que les pages que vous défendriez une par une | Les systèmes de Google peuvent juger le site entier, pas seulement les pages faibles |
La remontée est lente. Dans la même réponse, Mueller écrivait que régler ce problème prend généralement du temps et demande un effort important pour démontrer la valeur du site.
Commencez par un seul template
Choisissez le schéma de requête pour lequel vos données sont la meilleure réponse qui existe, publiez un petit lot pilote et lisez vous-même les pages avant d’en publier davantage.
Assurez-vous enfin que les robots d’exploration y ont accès. Le robots.txt Tester gratuit de geotoolbox (interface en anglais) confronte n’importe quelle URL au robots.txt d’un site, avec les règles de correspondance de Google : vous vérifiez ainsi qu’un chemin de template comme /integrations/ est ouvert avant de passer à l’échelle.
Sources
- Règles concernant le spam dans la Recherche sur le Web Google - Google Search Central, mis à jour le 31 août 2026 (FR) -
developers.google.com/search/docs/essentials/spam-policies - Ce que les créateurs Web doivent savoir sur notre mise à jour principale de mars 2024 et les nouvelles règles concernant le spam - Google Search Central Blog, 5 mars 2024 -
developers.google.com/search/blog/2024/03/core-update-spam-policies - Guide Google pour optimiser les fonctionnalités d’IA générative dans la recherche Google - Google Search Central, mis à jour le 13 juillet 2026 (FR) -
developers.google.com/search/docs/fundamentals/ai-optimization-guide - History for Ranking - Google Search Status Dashboard, consulté le 14 novembre 2026 -
status.search.google.com/products/rGHU1u87FJnkP6W2GwMi/history - Google Can Lose Faith In Sites Based On Low Value Programmatic SEO Pages - Search Engine Roundtable, 7 septembre 2026 -
seroundtable.com/google-lose-faith-42032.html - Good vs. Bad pSEO: Learnings From A Decade Of Building Scalable Content Engines - Search Engine Journal (Nitin Manchanda), 10 novembre 2026 -
searchenginejournal.com/good-vs-bad-pseo-learnings-from-a-decade-of-building-scalable-content-engines/594204/ - Rapport sur l’indexation des pages - Aide sur la Search Console -
support.google.com/webmasters/answer/7440203 - Gestion du budget d’exploration - Infrastructure d’exploration de Google, mis à jour le 16 septembre 2026 (FR) -
developers.google.com/crawling/docs/crawl-budget - Conseils de la recherche Google concernant le contenu généré par l’IA sur votre site Web - Google Search Central, mis à jour le 5 octobre 2026 (FR) -
developers.google.com/search/docs/fundamentals/using-gen-ai-content - Présentation des rapports sur les performances dans l’IA générative dans la Recherche de la Search Console - Google Search Central Blog, 3 juin 2026 -
developers.google.com/search/blog/2026/06/gen-ai-performance-reports - Rapport sur les actions manuelles - Aide sur la Search Console -
support.google.com/webmasters/answer/9044175 - Lancement des Aperçus IA et du Mode IA dans la Recherche Google en France - Blog Google France, 22 juillet 2026 -
blog.google/intl/fr-fr/nouveautes-produits/explorez-obtenez-des-reponses/recherche-ia-apercus-mode/ - Bonnes pratiques concernant la structure des URL pour la recherche Google - Google Search Central, mis à jour le 25 octobre 2026 (FR) -
developers.google.com/search/docs/crawling-indexing/url-structure - Code de la consommation, articles L121-2 et L132-2 - Légifrance -
legifrance.gouv.fr/codes/article_lc/LEGIARTI000044563114,legifrance.gouv.fr/codes/article_lc/LEGIARTI000049532070 - API Géo (découpage administratif, communes) - État français, consultée le 14 novembre 2026 -
geo.api.gouv.fr/communes - Nos données de test : DataForSEO LLM Mentions (Aperçus IA, France, français, réponses vues pour la dernière fois du 4 août au 14 novembre 2026) et 12 prompts en français dans ChatGPT, Perplexity Sonar et le Mode IA de Google, 14 novembre 2026