
Le SEO technique détermine si les moteurs de recherche peuvent atteindre, rendre et indexer vos pages : c’est la base sur laquelle reposent le contenu et les liens. En 2026, il s’adresse à deux publics. D’un côté Googlebot, qui exécute le JavaScript et alimente à la fois les résultats classiques et les Aperçus IA ; de l’autre les robots IA d’OpenAI, d’Anthropic et de Perplexity, qui lisent souvent le seul HTML renvoyé par votre serveur.
C’est sur les règles qui divergent que les sites perdent de la visibilité sans le vouloir : quel jeton du robots.txt gère l’entraînement plutôt que la recherche IA, quel robot exécute le JavaScript, quel réglage vous retire des Aperçus IA.
Ce qu’il faut retenir
- Le SEO technique fait en sorte qu’une page soit accessible, rendue et indexable : pour Google, cela veut dire une page accessible à Googlebot, un code HTTP 200 et du contenu indexable, ce qui la rend seulement éligible.
- Googlebot exécute le JavaScript, la plupart des robots IA non : les robots d’OpenAI, d’Anthropic et de Perplexity lisent surtout le HTML brut d’après les mesures publiées, avec une exception pour OAI-SearchBot sur certains sites en 2026.
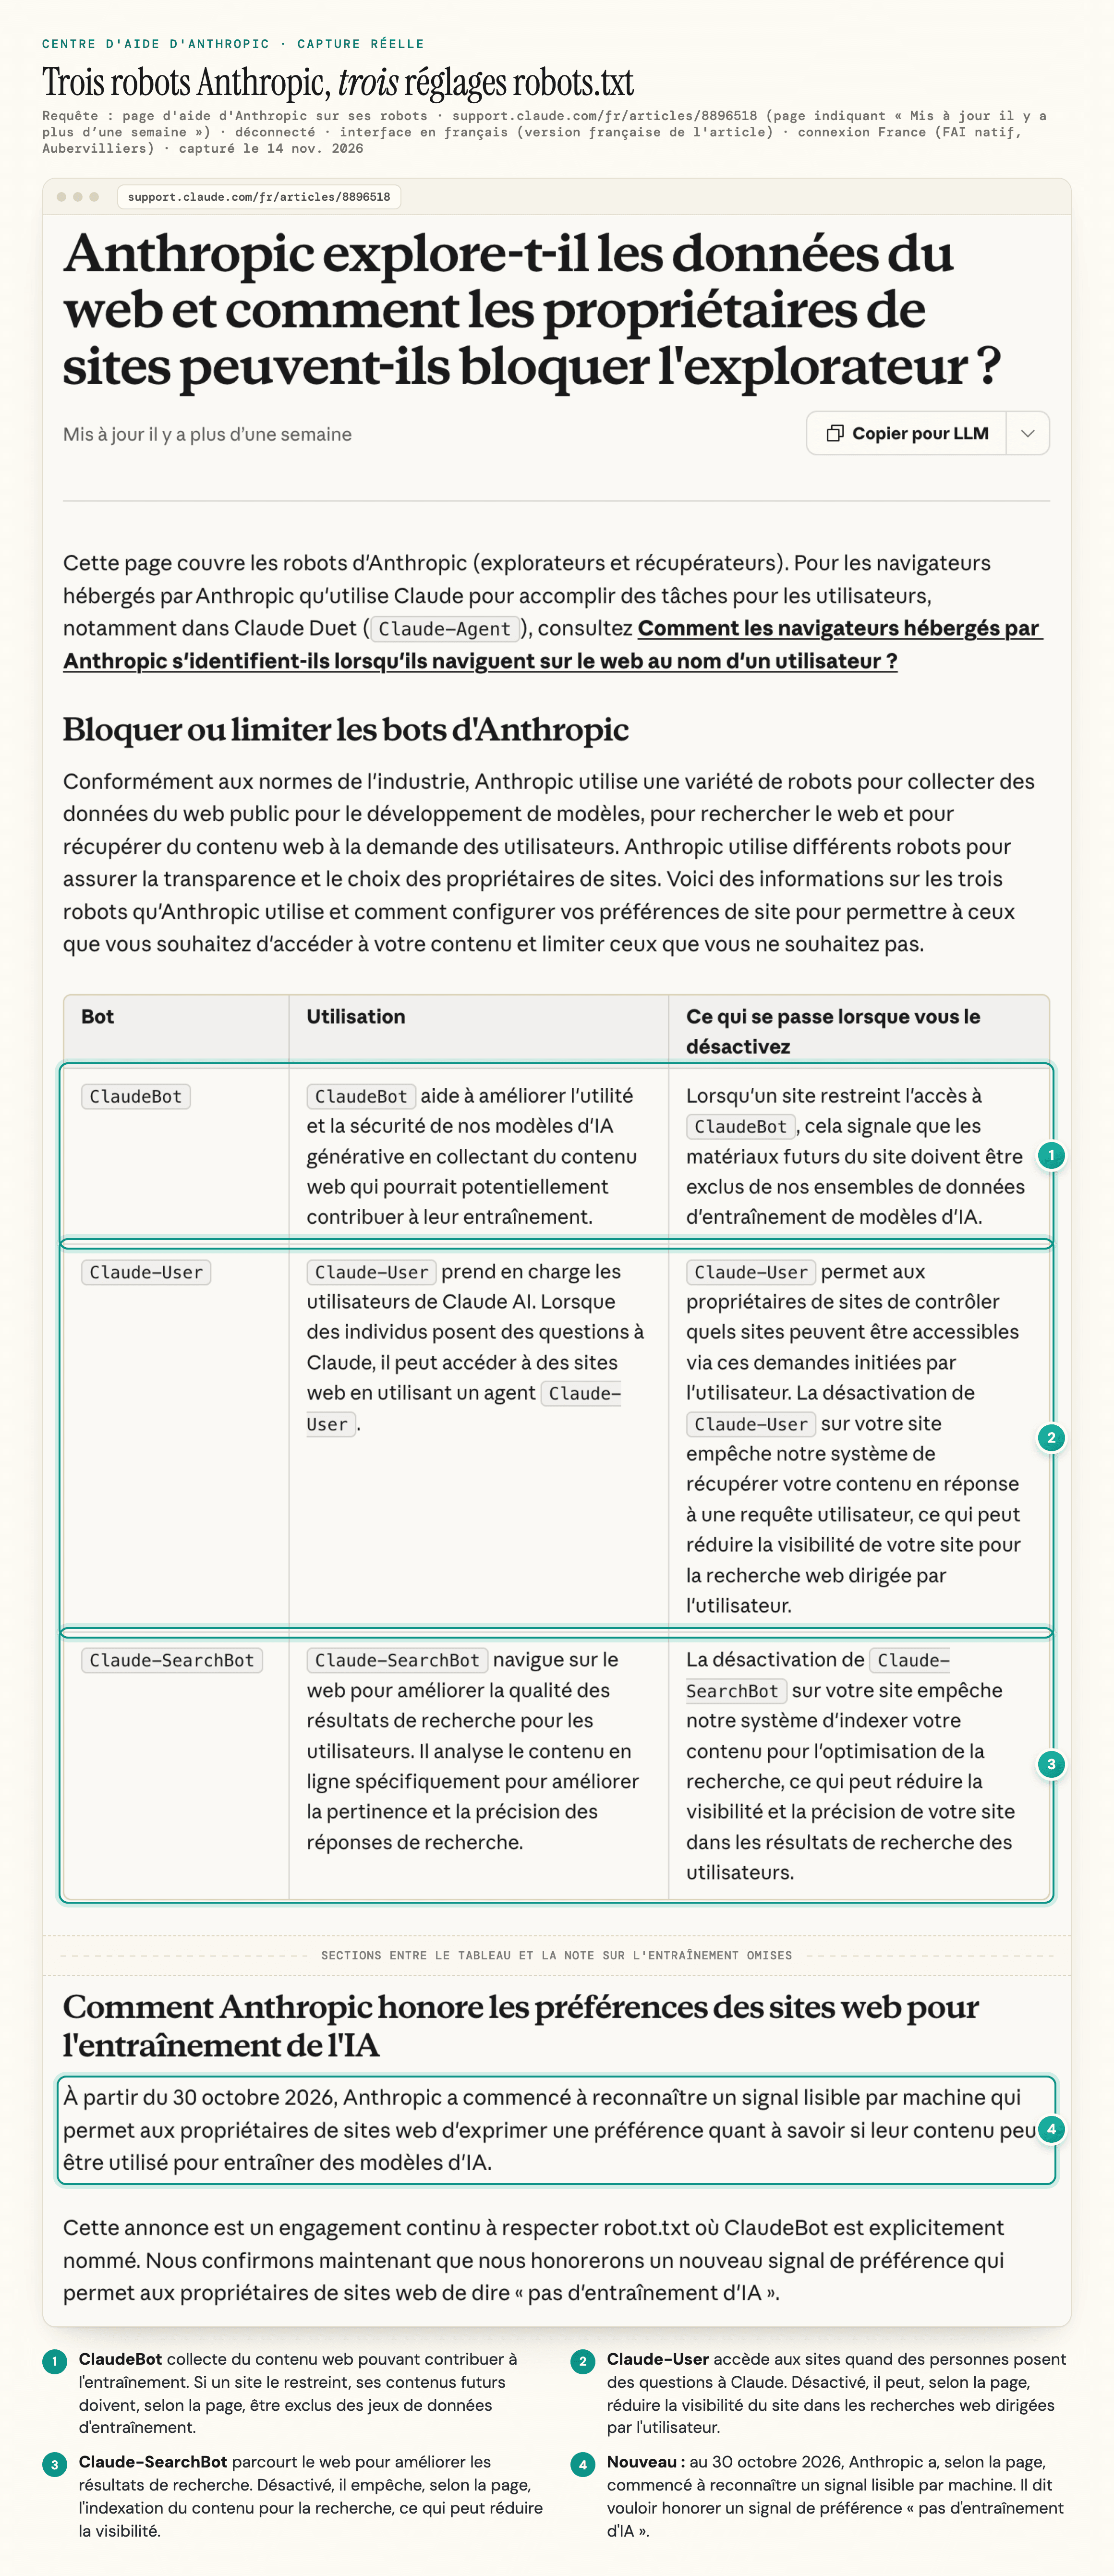
- Bloquer GPTBot ou ClaudeBot ne vous retire pas de la recherche de ChatGPT ou de Claude, et Google-Extended ne change rien à votre présence dans les Aperçus IA : chaque usage a son propre jeton.
- En France, les Aperçus IA et le Mode IA sont en ligne depuis le 22 juillet 2026 : vos pages doivent être indexées et éligibles à un extrait, et le réglage « IA générative dans la Recherche » de la Search Console doit rester actif.
- Le droit français permet de s’opposer à la fouille de textes et de données « par tout moyen » (articles L. 122-5-3 et R. 122-28 du CPI), et ces textes ne citent pas le robots.txt : combinez une mention dans vos CGU et des groupes robots.txt par usage.
Qu’est-ce que le SEO technique ?
Le SEO technique (ou référencement technique) regroupe tout ce qui permet aux moteurs de recherche et aux robots IA d’atteindre vos pages, de les rendre, de les indexer puis de les afficher.
Le minimum fixé par Google tient en trois points : la page doit être accessible à Googlebot, renvoyer un code HTTP 200 et présenter un contenu indexable. Google appelle cela les exigences techniques de la recherche, et les remplir rend seulement une page éligible, sans rien garantir de plus.
On présente souvent le SEO en trois piliers (technique, contenu, popularité). Côté métier, les tâches se répartissent plutôt ainsi :
| Couche | Ce qu’elle couvre | Tâches typiques | Qui s’en charge d’habitude |
|---|---|---|---|
| SEO technique | Accès, rendu, indexation, structure du site, vitesse | Règles du robots.txt, codes de statut, balises canoniques, sitemaps, Core Web Vitals, données structurées | Le SEO avec un développeur |
| SEO on-page | Ce que dit chaque page et la façon dont elle est balisée | Couverture du sujet, balises title, titres, ancres des liens internes | Le SEO avec un rédacteur |
| SEO off-page | Les signaux venus d’autres sites | Backlinks, mentions de marque, avis | SEO, relations presse, partenariats |
Comment Google et les robots IA traitent une page
Google fait tourner un seul pipeline. Il traite les pages JavaScript en trois phases : exploration, rendu et indexation ; le rendu, mis en file d’attente après la première récupération, s’effectue dans un Chromium sans interface. Les Aperçus IA (AI Overviews) et le Mode IA (AI Mode) puisent leurs liens de soutien dans ce même index de recherche, et c’est pourquoi Google leur applique les exigences habituelles de la recherche.
En France, Google affiche les Aperçus IA et le Mode IA depuis le 22 juillet 2026. Vos pages françaises suivent les mêmes règles : être indexées, pouvoir s’afficher avec un extrait et ne pas être exclues par le réglage « IA générative dans la Recherche » de la Search Console, disponible en France dès le lancement et pour tous les sites depuis le 31 août 2026.
Comment les éditeurs d’IA séparent leurs robots par usage
Les éditeurs d’IA répartissent l’exploration par usage, et chaque usage a son propre user-agent :
- Les robots d’entraînement collectent des pages pour entraîner les modèles : GPTBot, ClaudeBot
- Les robots de recherche construisent l’index d’un produit de recherche IA : OAI-SearchBot, Claude-SearchBot, PerplexityBot
- Les récupérateurs à la demande chargent une page parce que quelqu’un vient de poser une question à son sujet : ChatGPT-User, Claude-User, Perplexity-User
Mistral suit la même logique dans sa documentation avec trois jetons : MistralAI-Training pour l’entraînement, MistralAI-Index pour l’index de la recherche Mistral, qui alimente les réponses de Vibe, et MistralAI-User pour les visites déclenchées par une question.
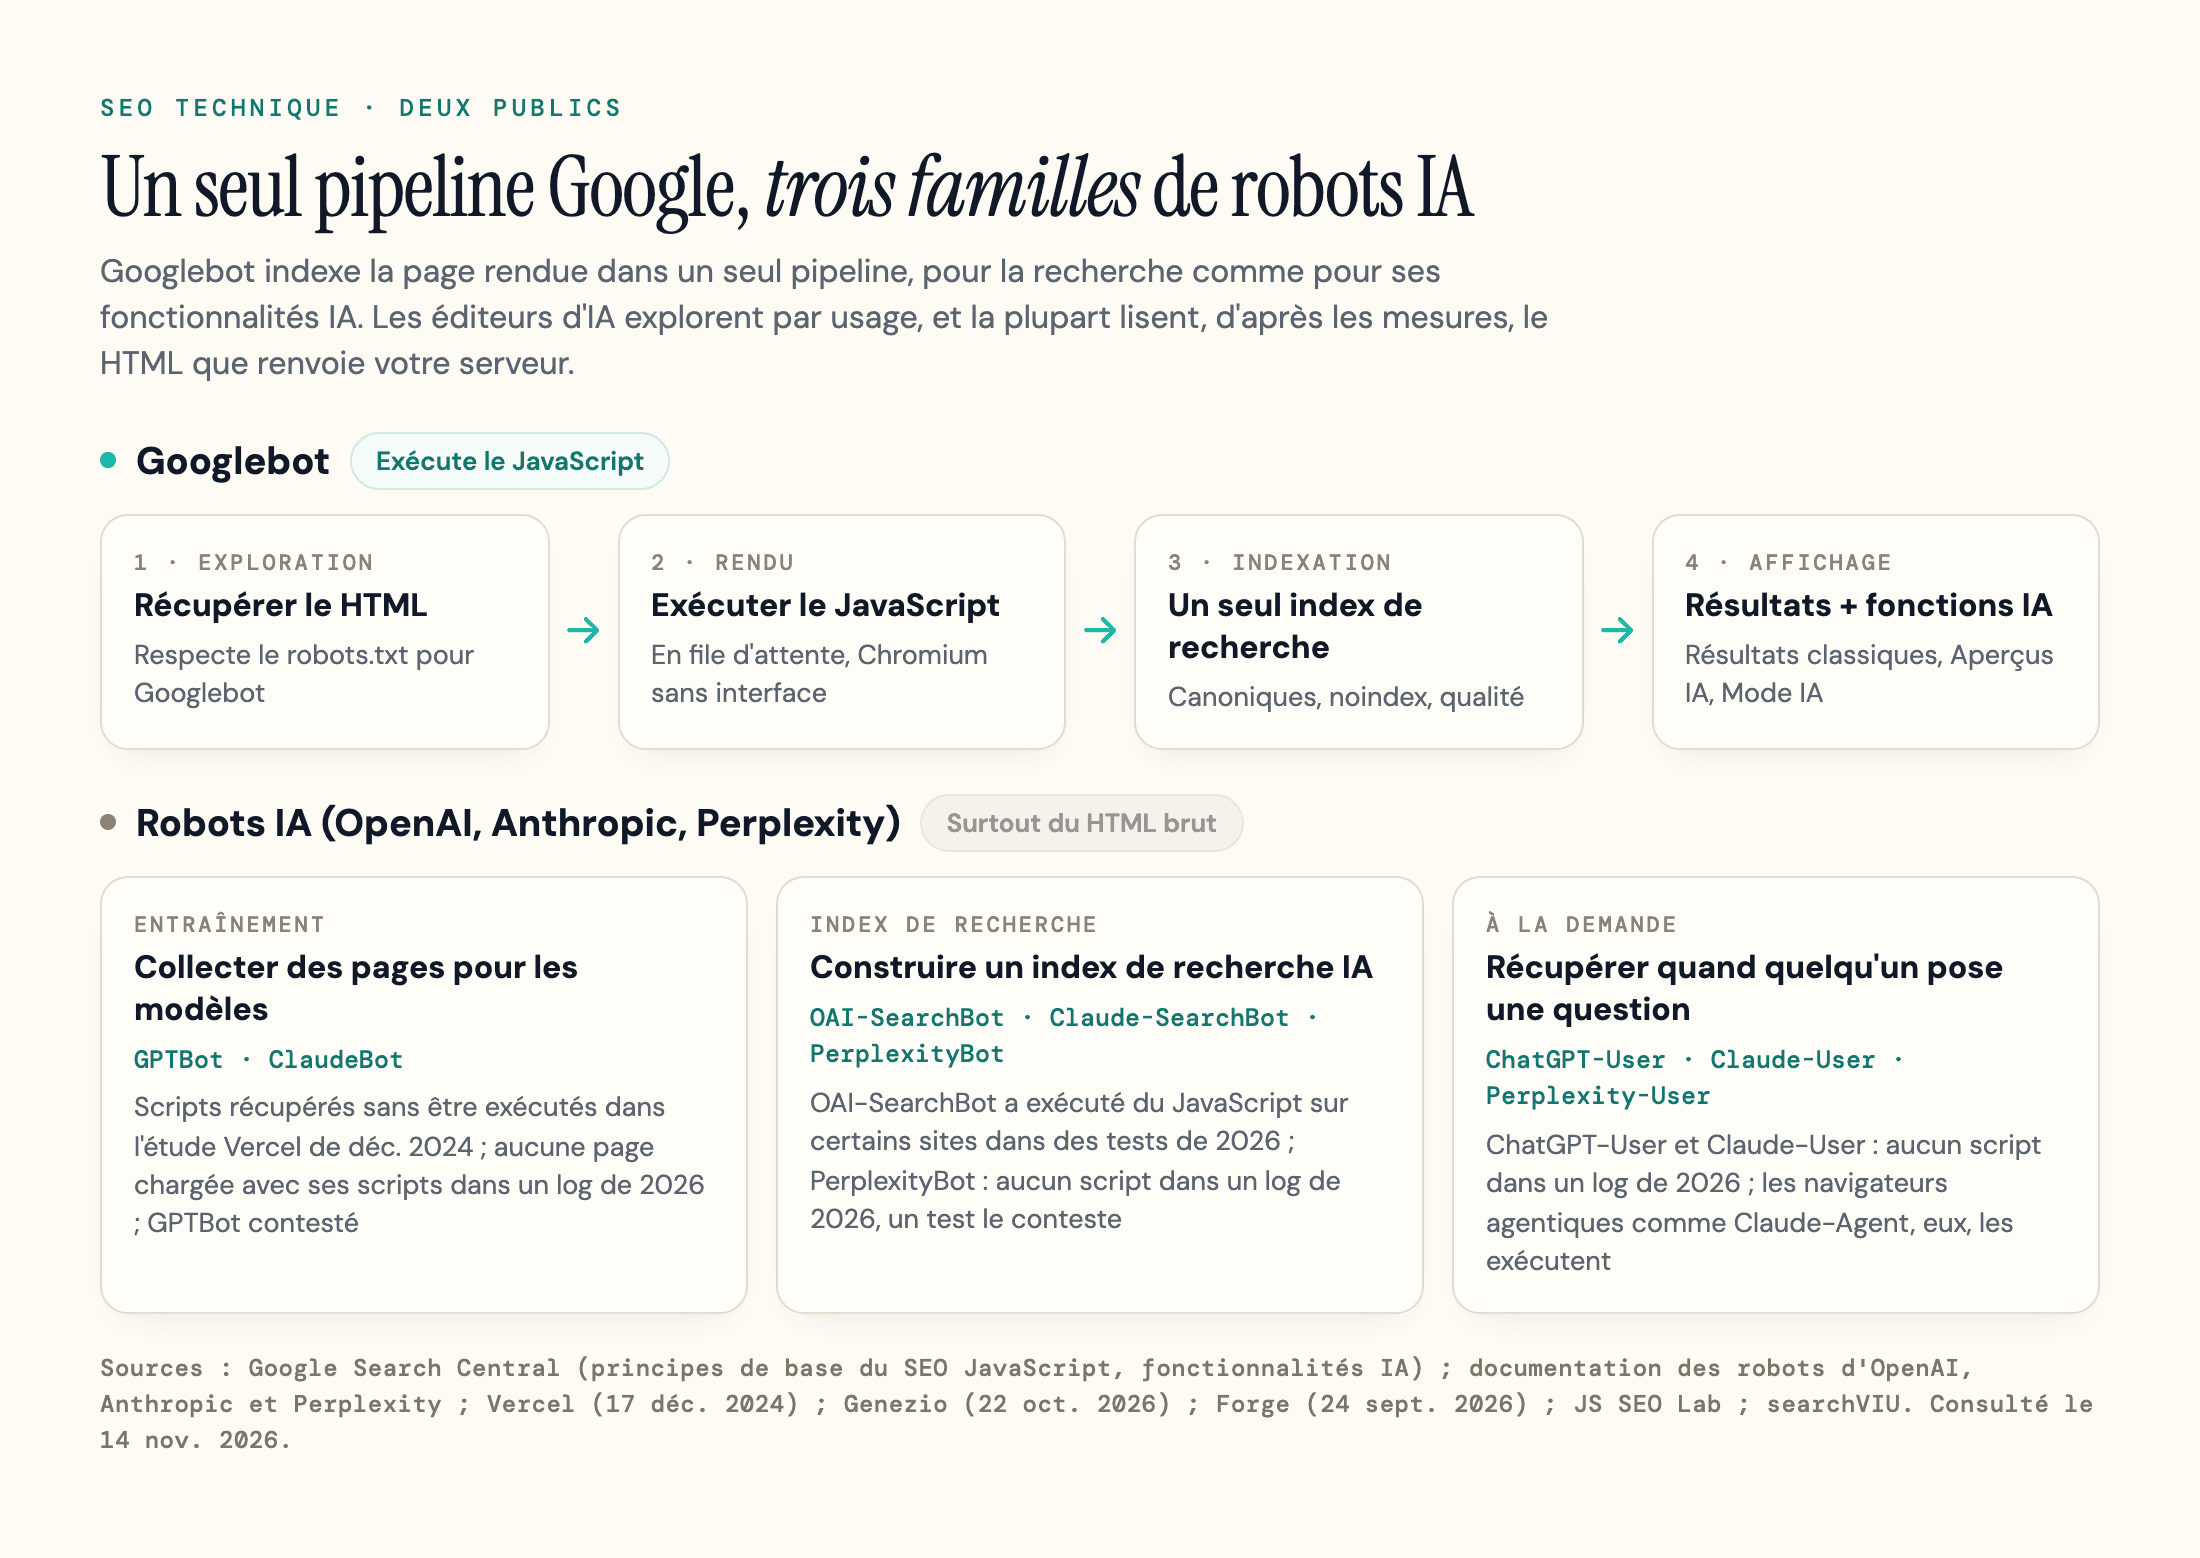
La vraie différence tient à ce que chacun lit. Googlebot indexe la page rendue, alors que les robots d’OpenAI, d’Anthropic et de Perplexity, d’après les mesures publiées, lisent surtout le HTML que renvoie votre serveur (le robot de recherche d’OpenAI fait exception sur certains sites). Pour la liste complète des user-agents, consultez notre liste des robots IA.
Google et robots IA : la matrice des exigences
Pour ses fonctionnalités IA, Google demande une page indexée et éligible à un extrait, ainsi qu’un réglage laissé actif. Les éditeurs d’IA ont leurs propres règles, et elles divergent sur les deux questions décisives : quel jeton contrôle quel usage, et le robot exécute-t-il le JavaScript ?
La matrice ci-dessous repose sur la documentation de chaque éditeur, consultée le 14 novembre 2026, et sur les tests de rendu indépendants présentés dans la partie sur le rendu.
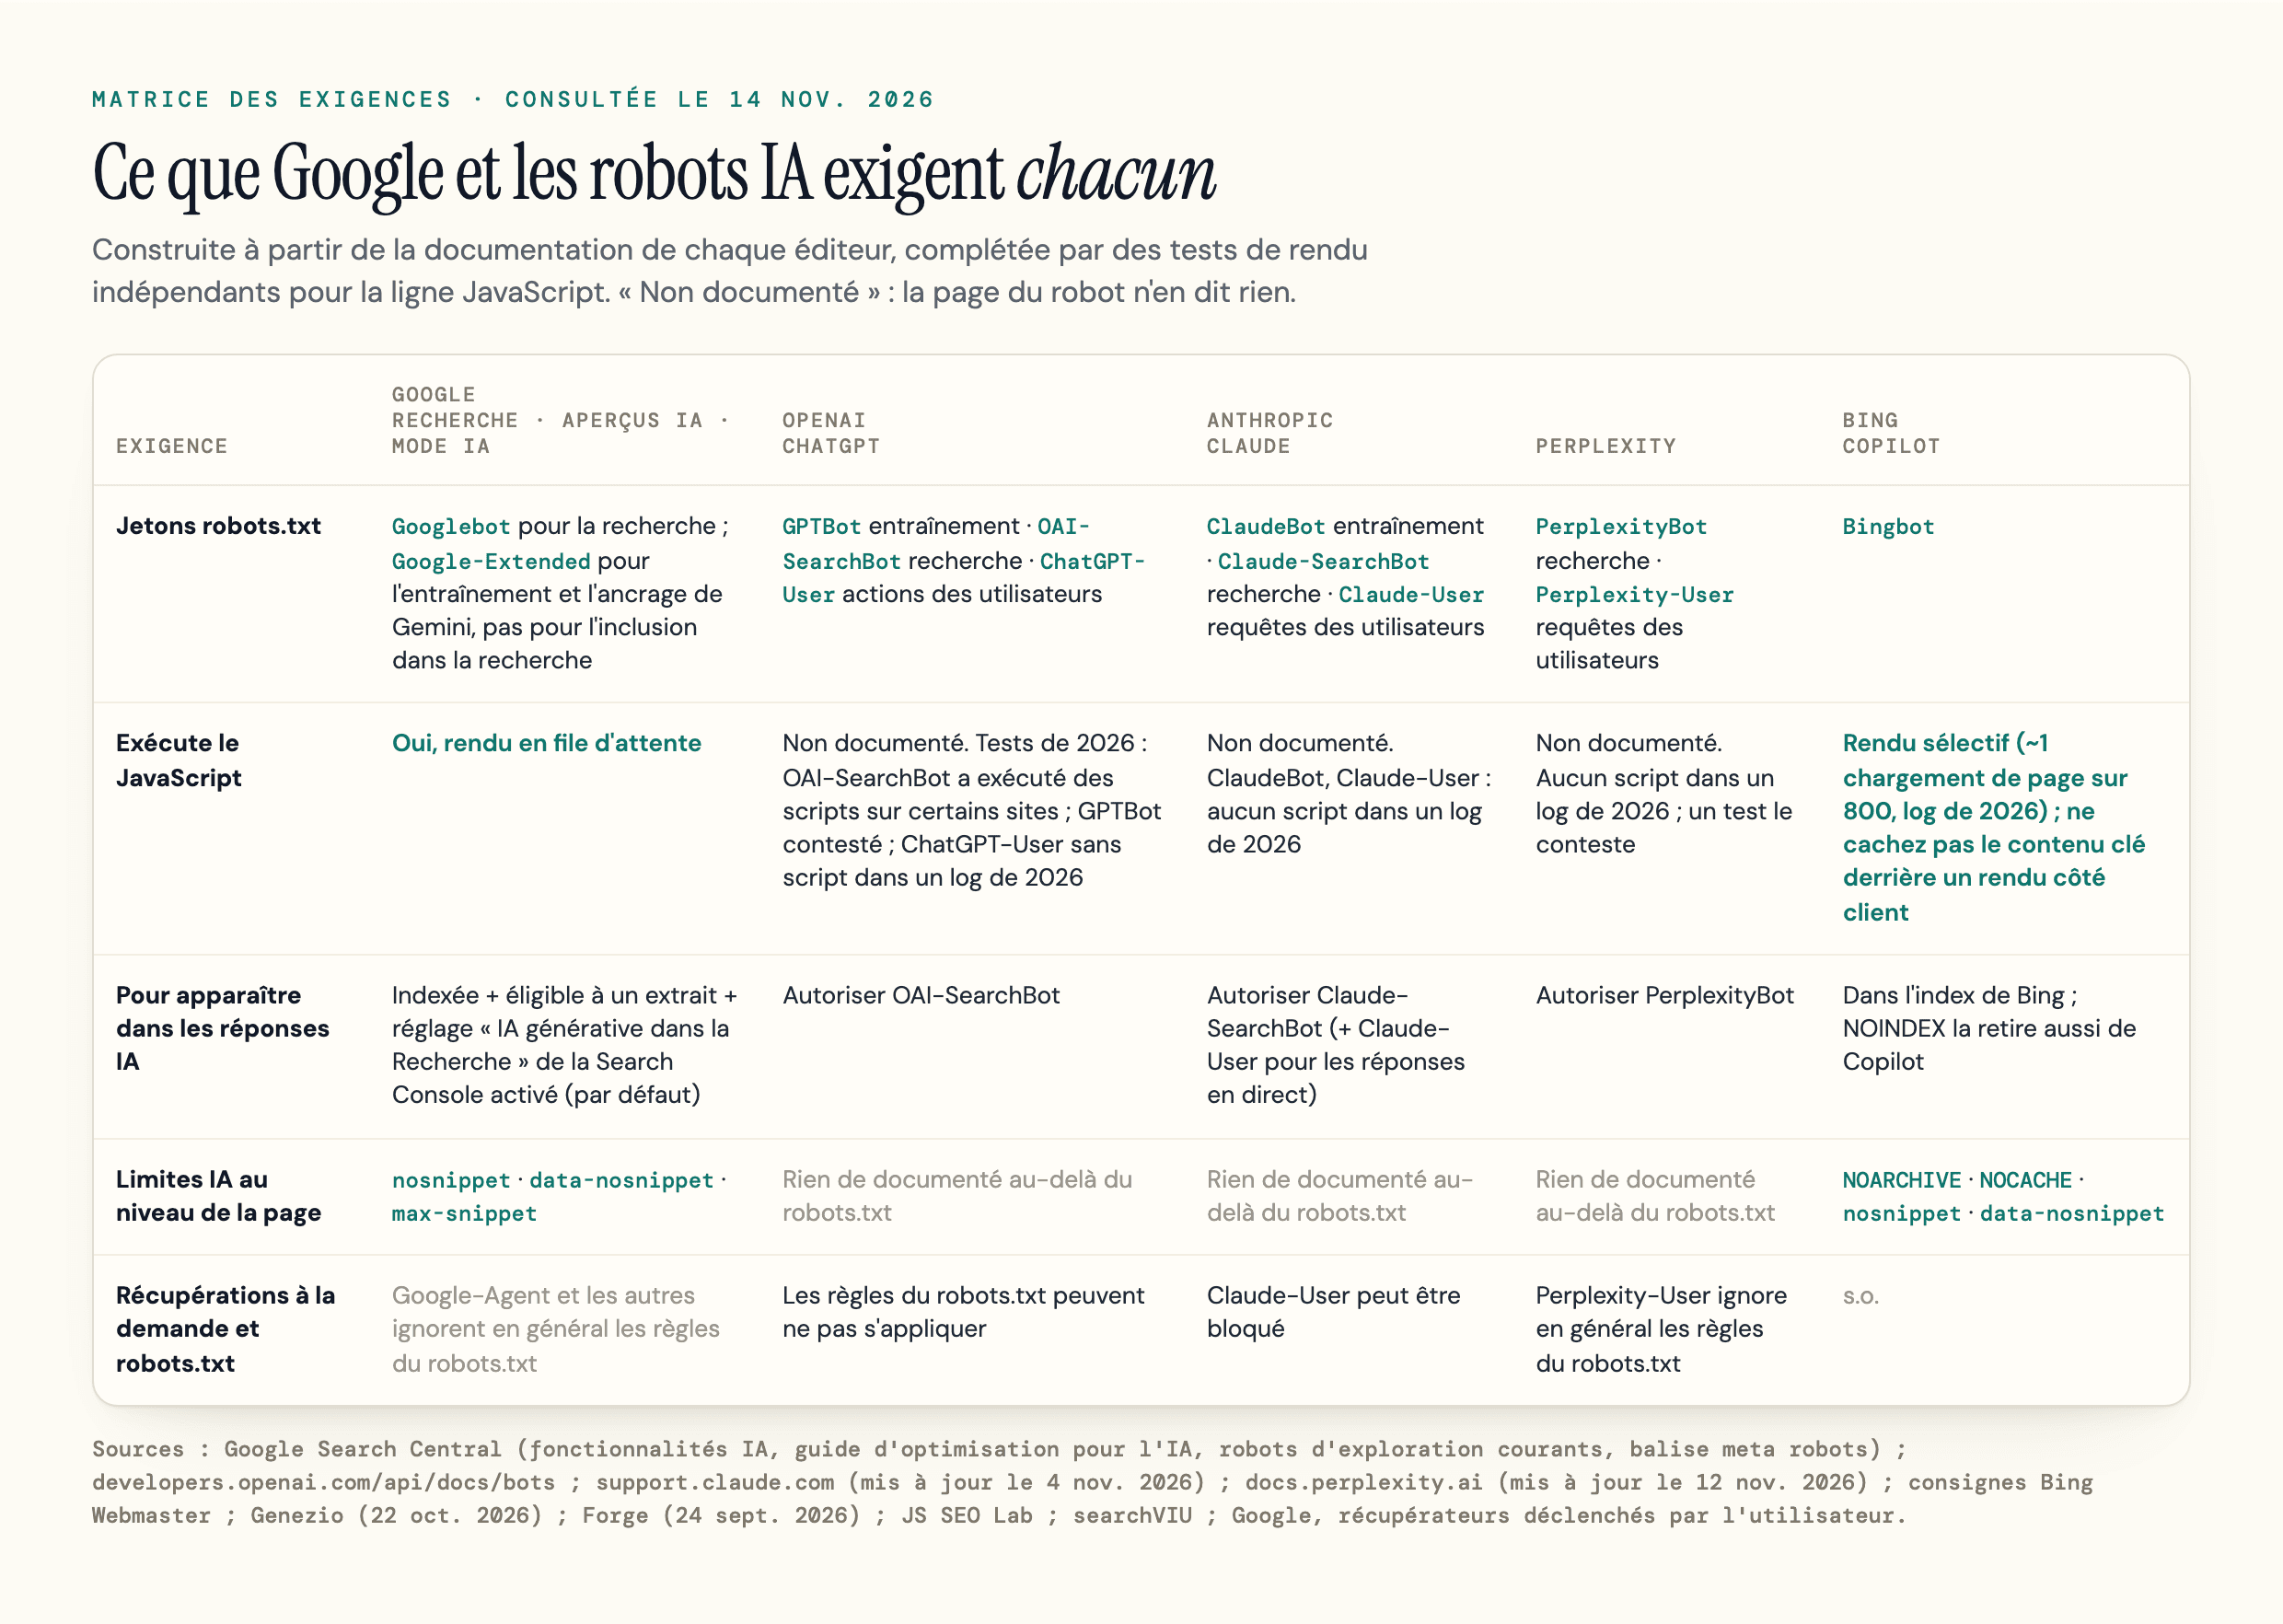
| Exigence | Google (recherche, Aperçus IA, Mode IA) | OpenAI (ChatGPT) | Anthropic (Claude) | Perplexity | Bing (Copilot) |
|---|---|---|---|---|---|
| Jetons du robots.txt | Googlebot pour la recherche ; Google-Extended pour l’entraînement et l’ancrage de Gemini, pas pour l’inclusion dans la recherche | GPTBot (entraînement), OAI-SearchBot (recherche), ChatGPT-User (actions des utilisateurs) | ClaudeBot (entraînement), Claude-SearchBot (recherche), Claude-User (requêtes des utilisateurs) | PerplexityBot (recherche), Perplexity-User (requêtes des utilisateurs) | Bingbot |
| Exécute le JavaScript | Oui, dans une étape de rendu mise en file d’attente | Non documenté. OAI-SearchBot a exécuté des scripts sur certains sites lors de tests en 2026 ; le cas de GPTBot est contesté ; ChatGPT-User n’a récupéré aucun script dans un log de 2026 | Non documenté. ClaudeBot et Claude-User n’ont récupéré aucun script en chargeant une page dans un log de 2026 | Non documenté. PerplexityBot n’a récupéré aucun script dans un log de 2026 ; un test de 2025 le conteste | Rendu sélectif (environ 1 chargement de page sur 800 dans un log de 2026) ; Bing demande de ne pas cacher le contenu essentiel derrière un rendu côté client |
| Pour apparaître dans les réponses IA | Page indexée, éligible à un extrait, et réglage « IA générative dans la Recherche » de la Search Console laissé actif (par défaut) | Autoriser OAI-SearchBot | Autoriser Claude-SearchBot (et Claude-User pour les réponses en direct) | Autoriser PerplexityBot | Être indexé par Bing ; NOINDEX retire aussi l’URL de Copilot |
| Limites d’usage par l’IA au niveau de la page | nosnippet, data-nosnippet, max-snippet | Rien de documenté au-delà du robots.txt | Rien de documenté au-delà du robots.txt | Rien de documenté au-delà du robots.txt | NOARCHIVE, NOCACHE, nosnippet, data-nosnippet |
| Récupérations à la demande et robots.txt | Google-Agent et les autres récupérateurs déclenchés par l’utilisateur « ignorent généralement les règles du fichier robots.txt » | ChatGPT-User : selon OpenAI, les règles du robots.txt peuvent ne pas s’appliquer | Claude-User peut être bloqué dans le robots.txt | Perplexity-User ignore en général les règles du robots.txt, selon Perplexity | Sans objet |
Ce que montre la matrice
Trois constats ressortent.
D’abord, OpenAI et Anthropic séparent l’entraînement de la recherche, et Perplexity affirme que son robot ne sert pas à entraîner des modèles.
Ensuite, le HTML brut reste la valeur sûre, quel que soit le robot. Google rend les pages, mais ChatGPT-User et Claude-User n’ont récupéré aucun script dans le log de 2026 cité plus bas. Font exception les navigateurs agentiques comme Claude-Agent, avec lequel Claude accomplit des tâches pour ses utilisateurs : un navigateur exécute les scripts.
Enfin, seuls Google et Bing documentent des contrôles au niveau de la page pour l’usage par l’IA.
Le guide d’optimisation pour l’IA de Google ajoute une exigence : « En plus des exigences techniques pour la Recherche, un site doit être inclus dans les fonctionnalités d’IA générative dans la Recherche dans la Search Console pour pouvoir s’afficher dans les fonctionnalités d’IA générative de la recherche Google. »
Tous les sites sont inclus par défaut, et une propriété hérite du réglage de la propriété parente la plus proche qui l’a modifié : vérifiez aussi votre propriété de domaine. La page plus ancienne de Google sur les fonctionnalités IA (décembre 2025) affirme encore : « Il n’y a aucune exigence technique supplémentaire. »
Exploration : robots.txt, codes de statut et budget de crawl
L’exploration, c’est la capacité d’un robot à demander une URL et à obtenir une réponse exploitable, et beaucoup de problèmes de SEO technique naissent à cette étape.
Le robots.txt gère l’exploration, pas l’indexation
Le robots.txt demande aux robots de ne pas visiter certains chemins ; il ne retire pas une URL de Google. Google précise qu’une page bloquée dans le robots.txt peut quand même être indexée si d’autres sites pointent vers elle. Le standard lui-même, la RFC 9309, le dit en toutes lettres (en anglais) : « These rules are not a form of access authorization. »
Protégez par mot de passe un site de préproduction ou une page privée : ni le robots.txt ni le noindex ne sont des mesures de sécurité. Pour une page publique qui doit seulement rester hors de la recherche, Google recommande le noindex. Ne bloquez pas en plus cette URL dans le robots.txt, car Google doit explorer la page pour voir la balise.
Notre guide du SEO SaaS passe en revue ce qu’un éditeur de logiciel doit garder hors de l’index sur son domaine : l’application elle-même, la préproduction et les anciennes versions de la documentation.
Googlebot ne tient pas compte de la directive crawl-delay, que sa spécification du robots.txt range parmi les champs non pris en charge, alors qu'Anthropic indique que ses robots la respectent le cas échéant.
Chaque robot suit le groupe qui nomme son user-agent et se rabat sur * sinon : il suffit donc de nommer les robots que vous voulez traiter différemment. Les groupes ci-dessous demandent à OpenAI, Anthropic et Google de ne pas entraîner leurs modèles sur vos pages (Google-Extended est un jeton de contrôle, pas un robot) et ne changent rien aux règles appliquées aux robots de recherche.
Relisez aussi les groupes existants pour ces robots : le robots.txt combine les groupes qui visent le même user-agent, et une ligne Allow plus précise l’emporte quand même sur Disallow: /. Le groupe Google-Extended retire également vos pages de l’ancrage dans les applications Gemini : ne l’ajoutez pas si vous voulez que les réponses de Gemini s’appuient sur elles.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
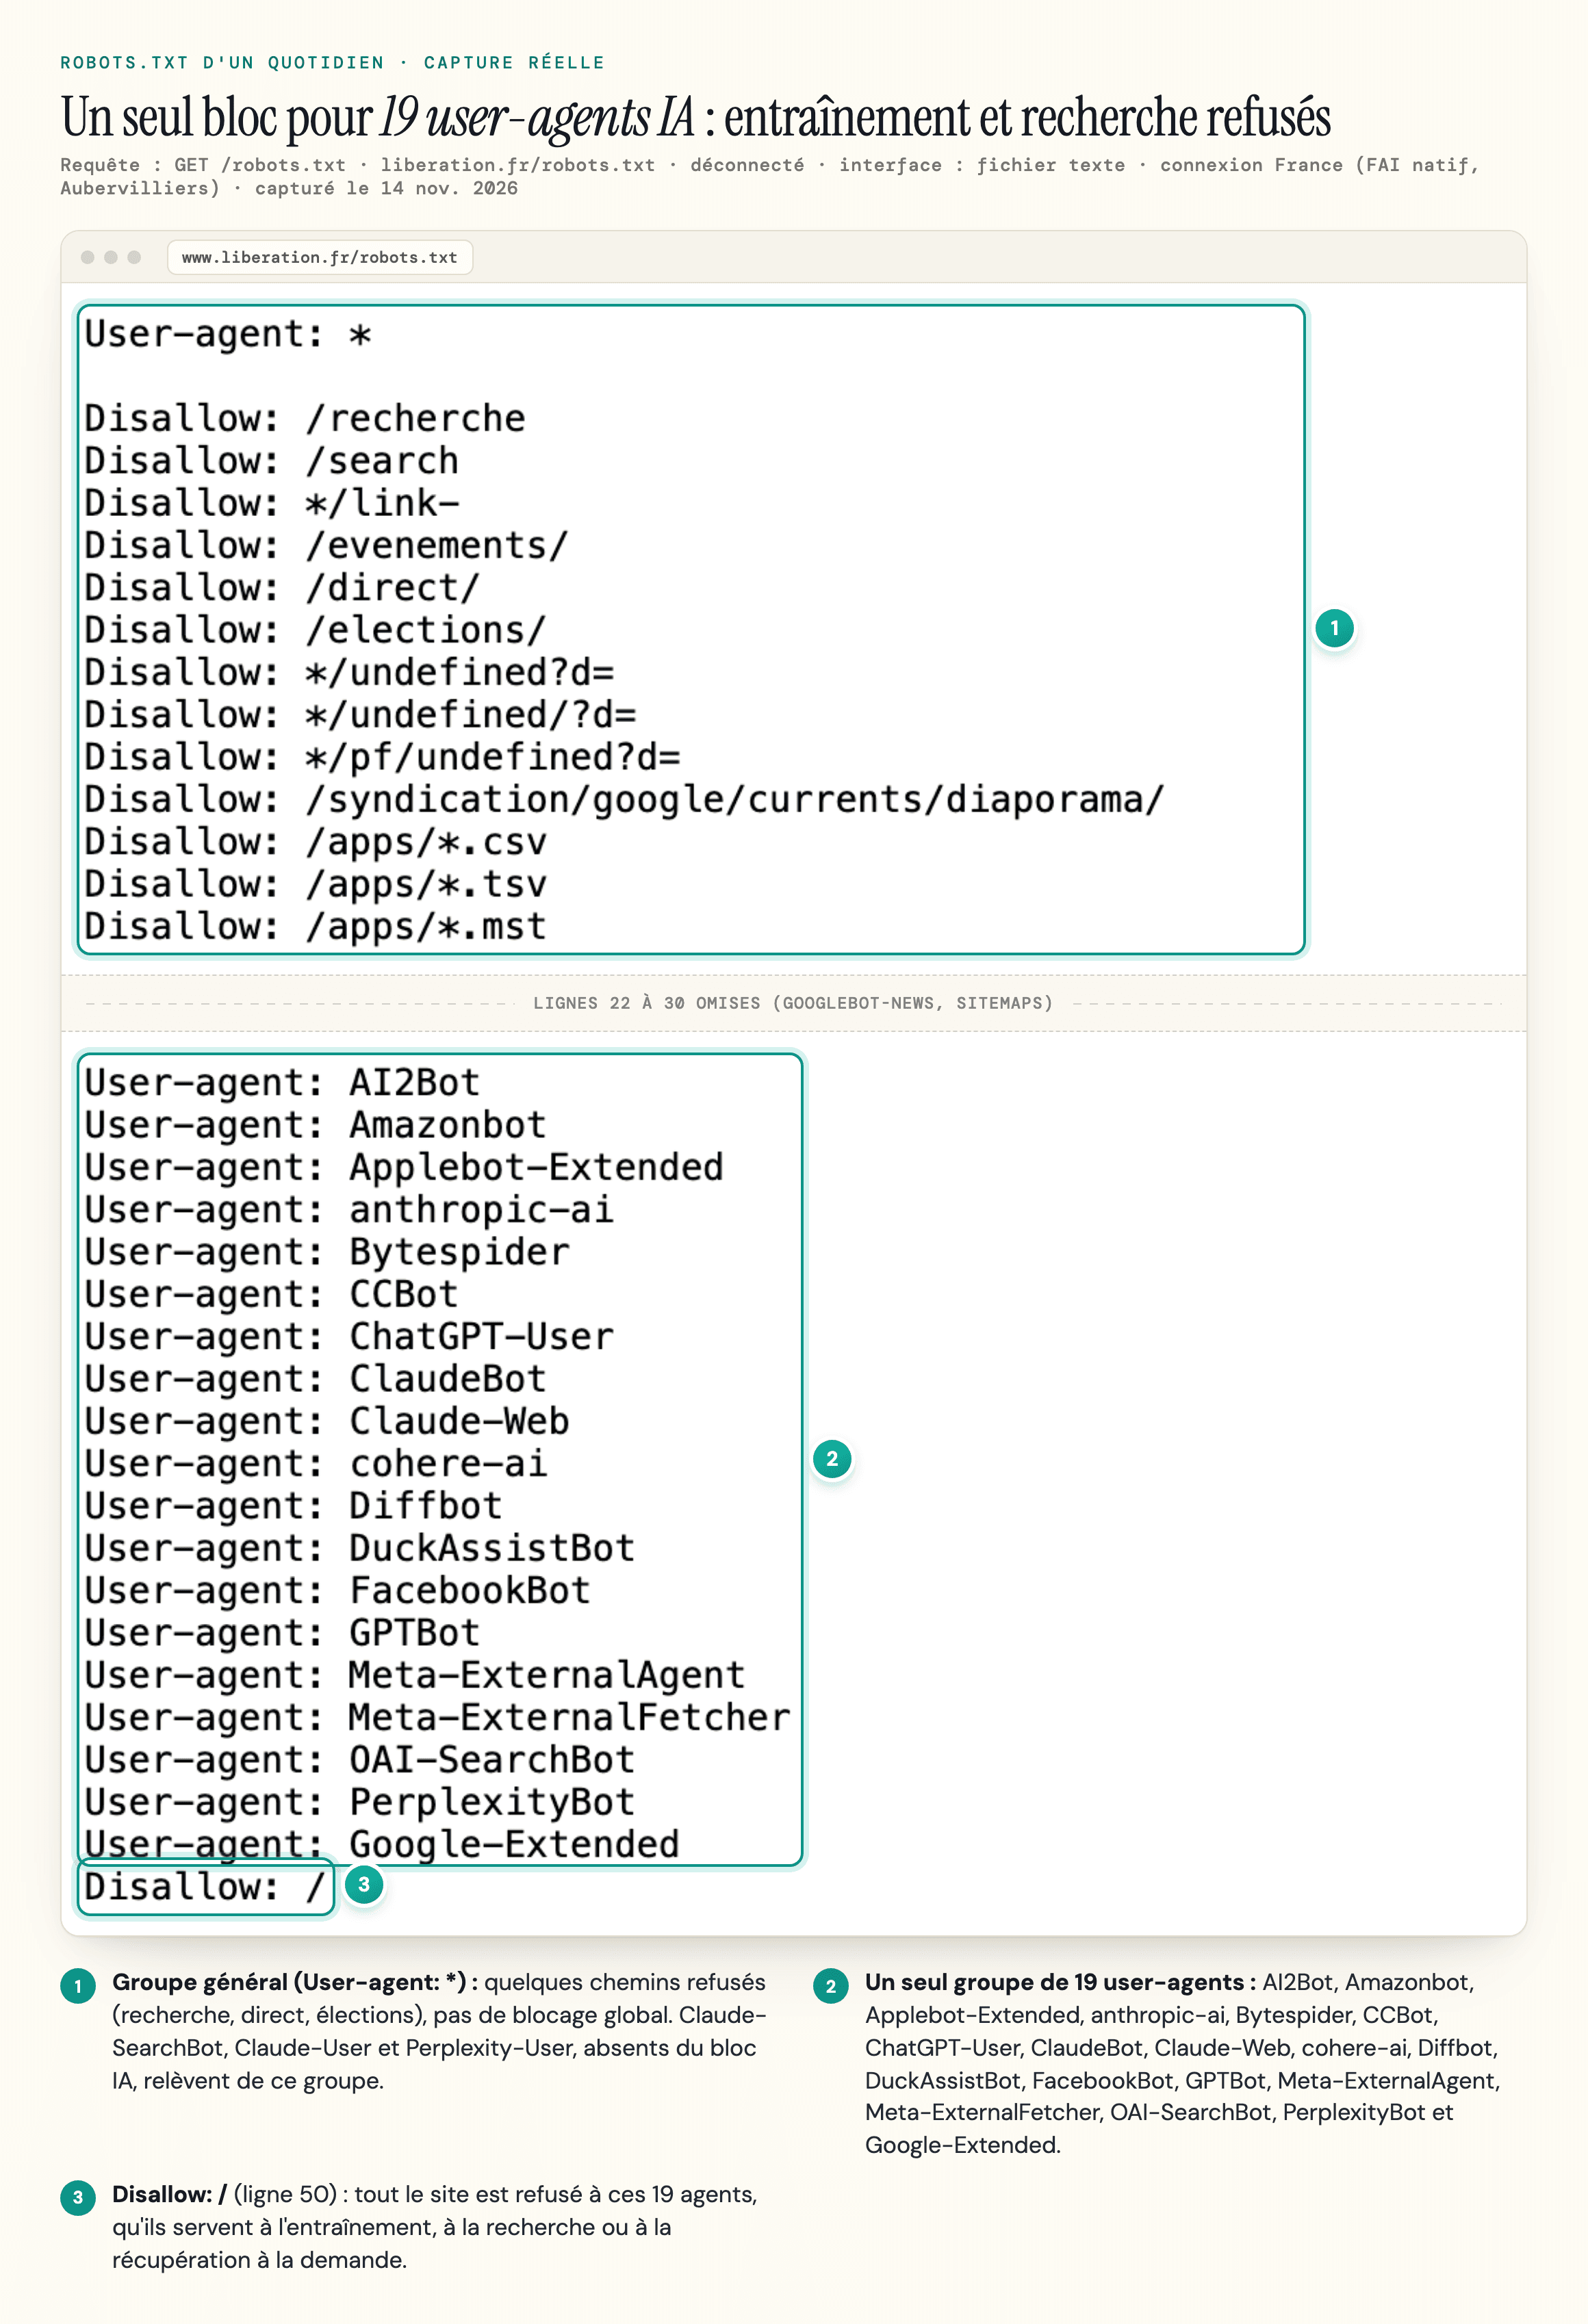
Pour voir quels robots un fichier en ligne bloque sur le chemin de votre page d’accueil, collez un domaine dans notre AI Crawler Checker. Il confronte le robots.txt à 34 user-agents de robots, en majorité des robots IA, et affiche la ligne responsable quand l’un d’eux est bloqué.
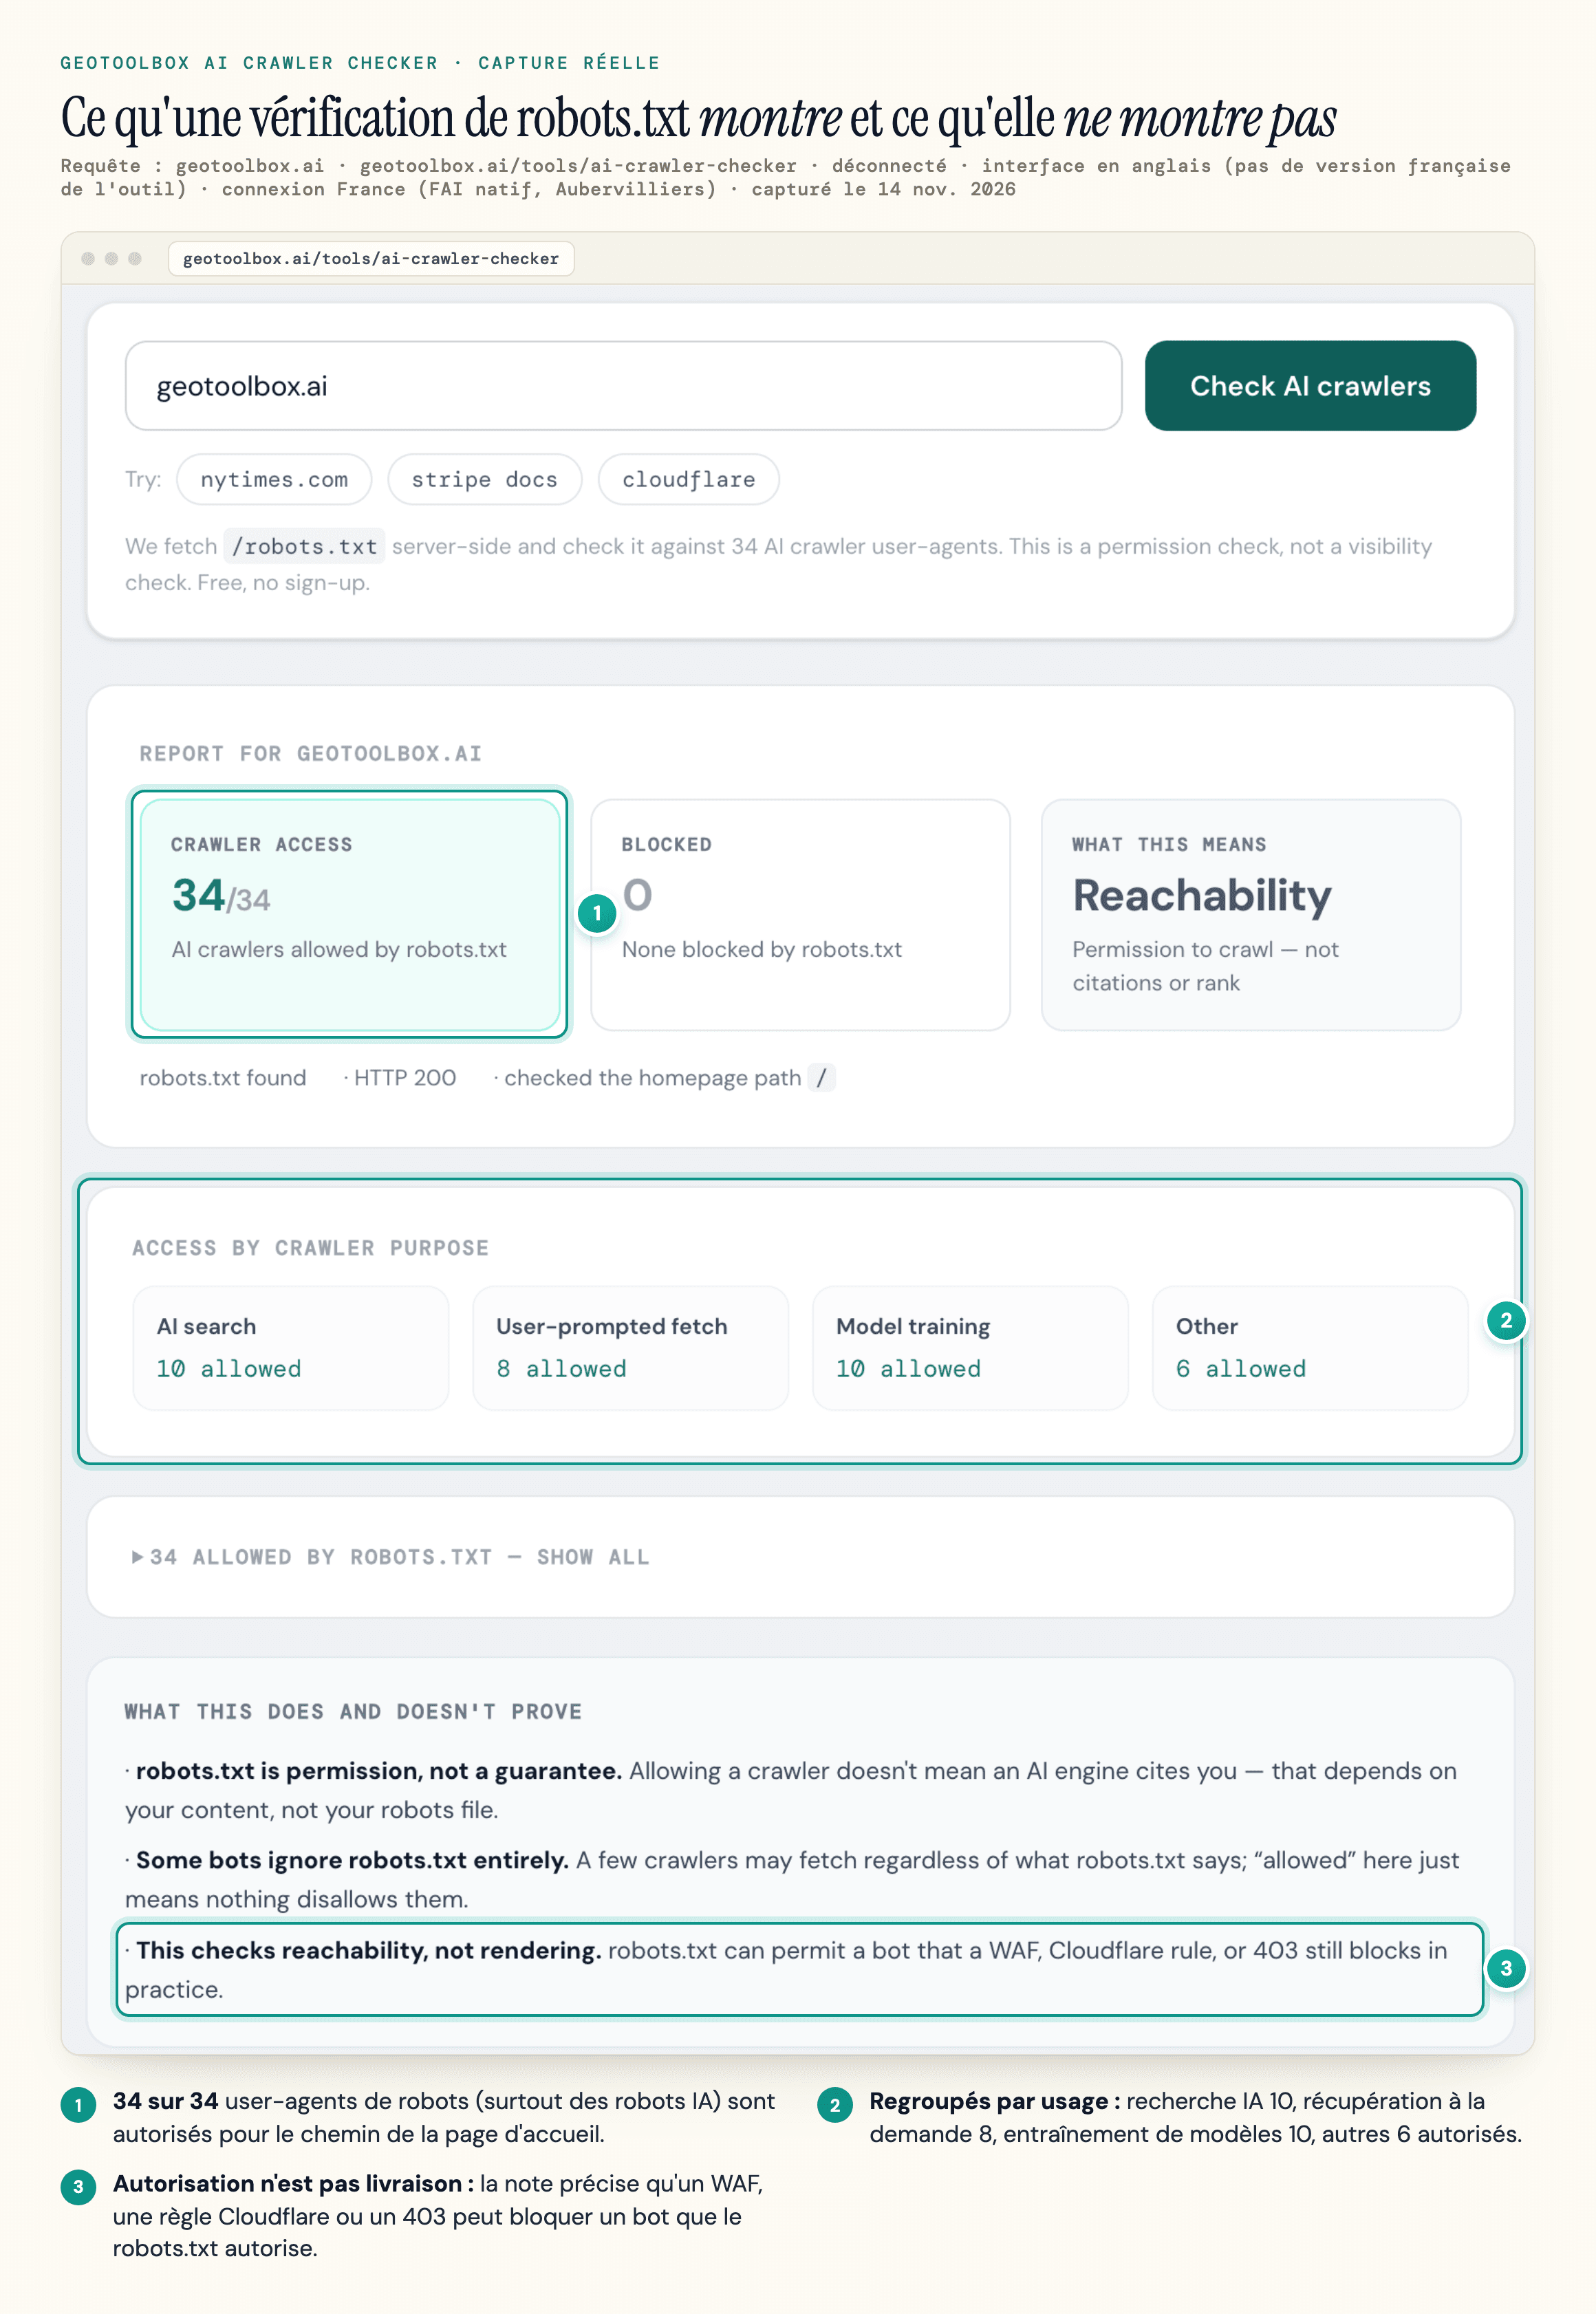
Le code de statut du fichier lui-même compte aussi. Selon la RFC 9309, une erreur 4xx autorise un robot à tout explorer, tandis qu’un fichier inaccessible (erreur serveur) l’oblige à considérer que tout est interdit.
Votre CDN peut passer outre le robots.txt
Les règles anti-bots d’un CDN ou d’un pare-feu s’appliquent avant toute lecture du robots.txt : un fichier qui autorise OAI-SearchBot ne sert à rien si le réseau renvoie une erreur 403. Cloudflare, par exemple, a commencé, le 1er juillet 2025, à demander à chaque nouveau domaine s’il voulait autoriser les robots IA, avec le blocage par défaut. Le 15 septembre 2026, Cloudflare a annoncé, pour les nouveaux domaines, des préréglages qui laissent passer les robots de recherche et, pour les sites financés par la publicité, interdisent l’entraînement IA et bloquent les agents sur les pages avec publicité ; les sites sans publicité autorisent les trois.
La documentation des robots de Perplexity prévient que les propriétaires de sites devront peut-être autoriser explicitement ses robots dans un pare-feu applicatif (WAF).
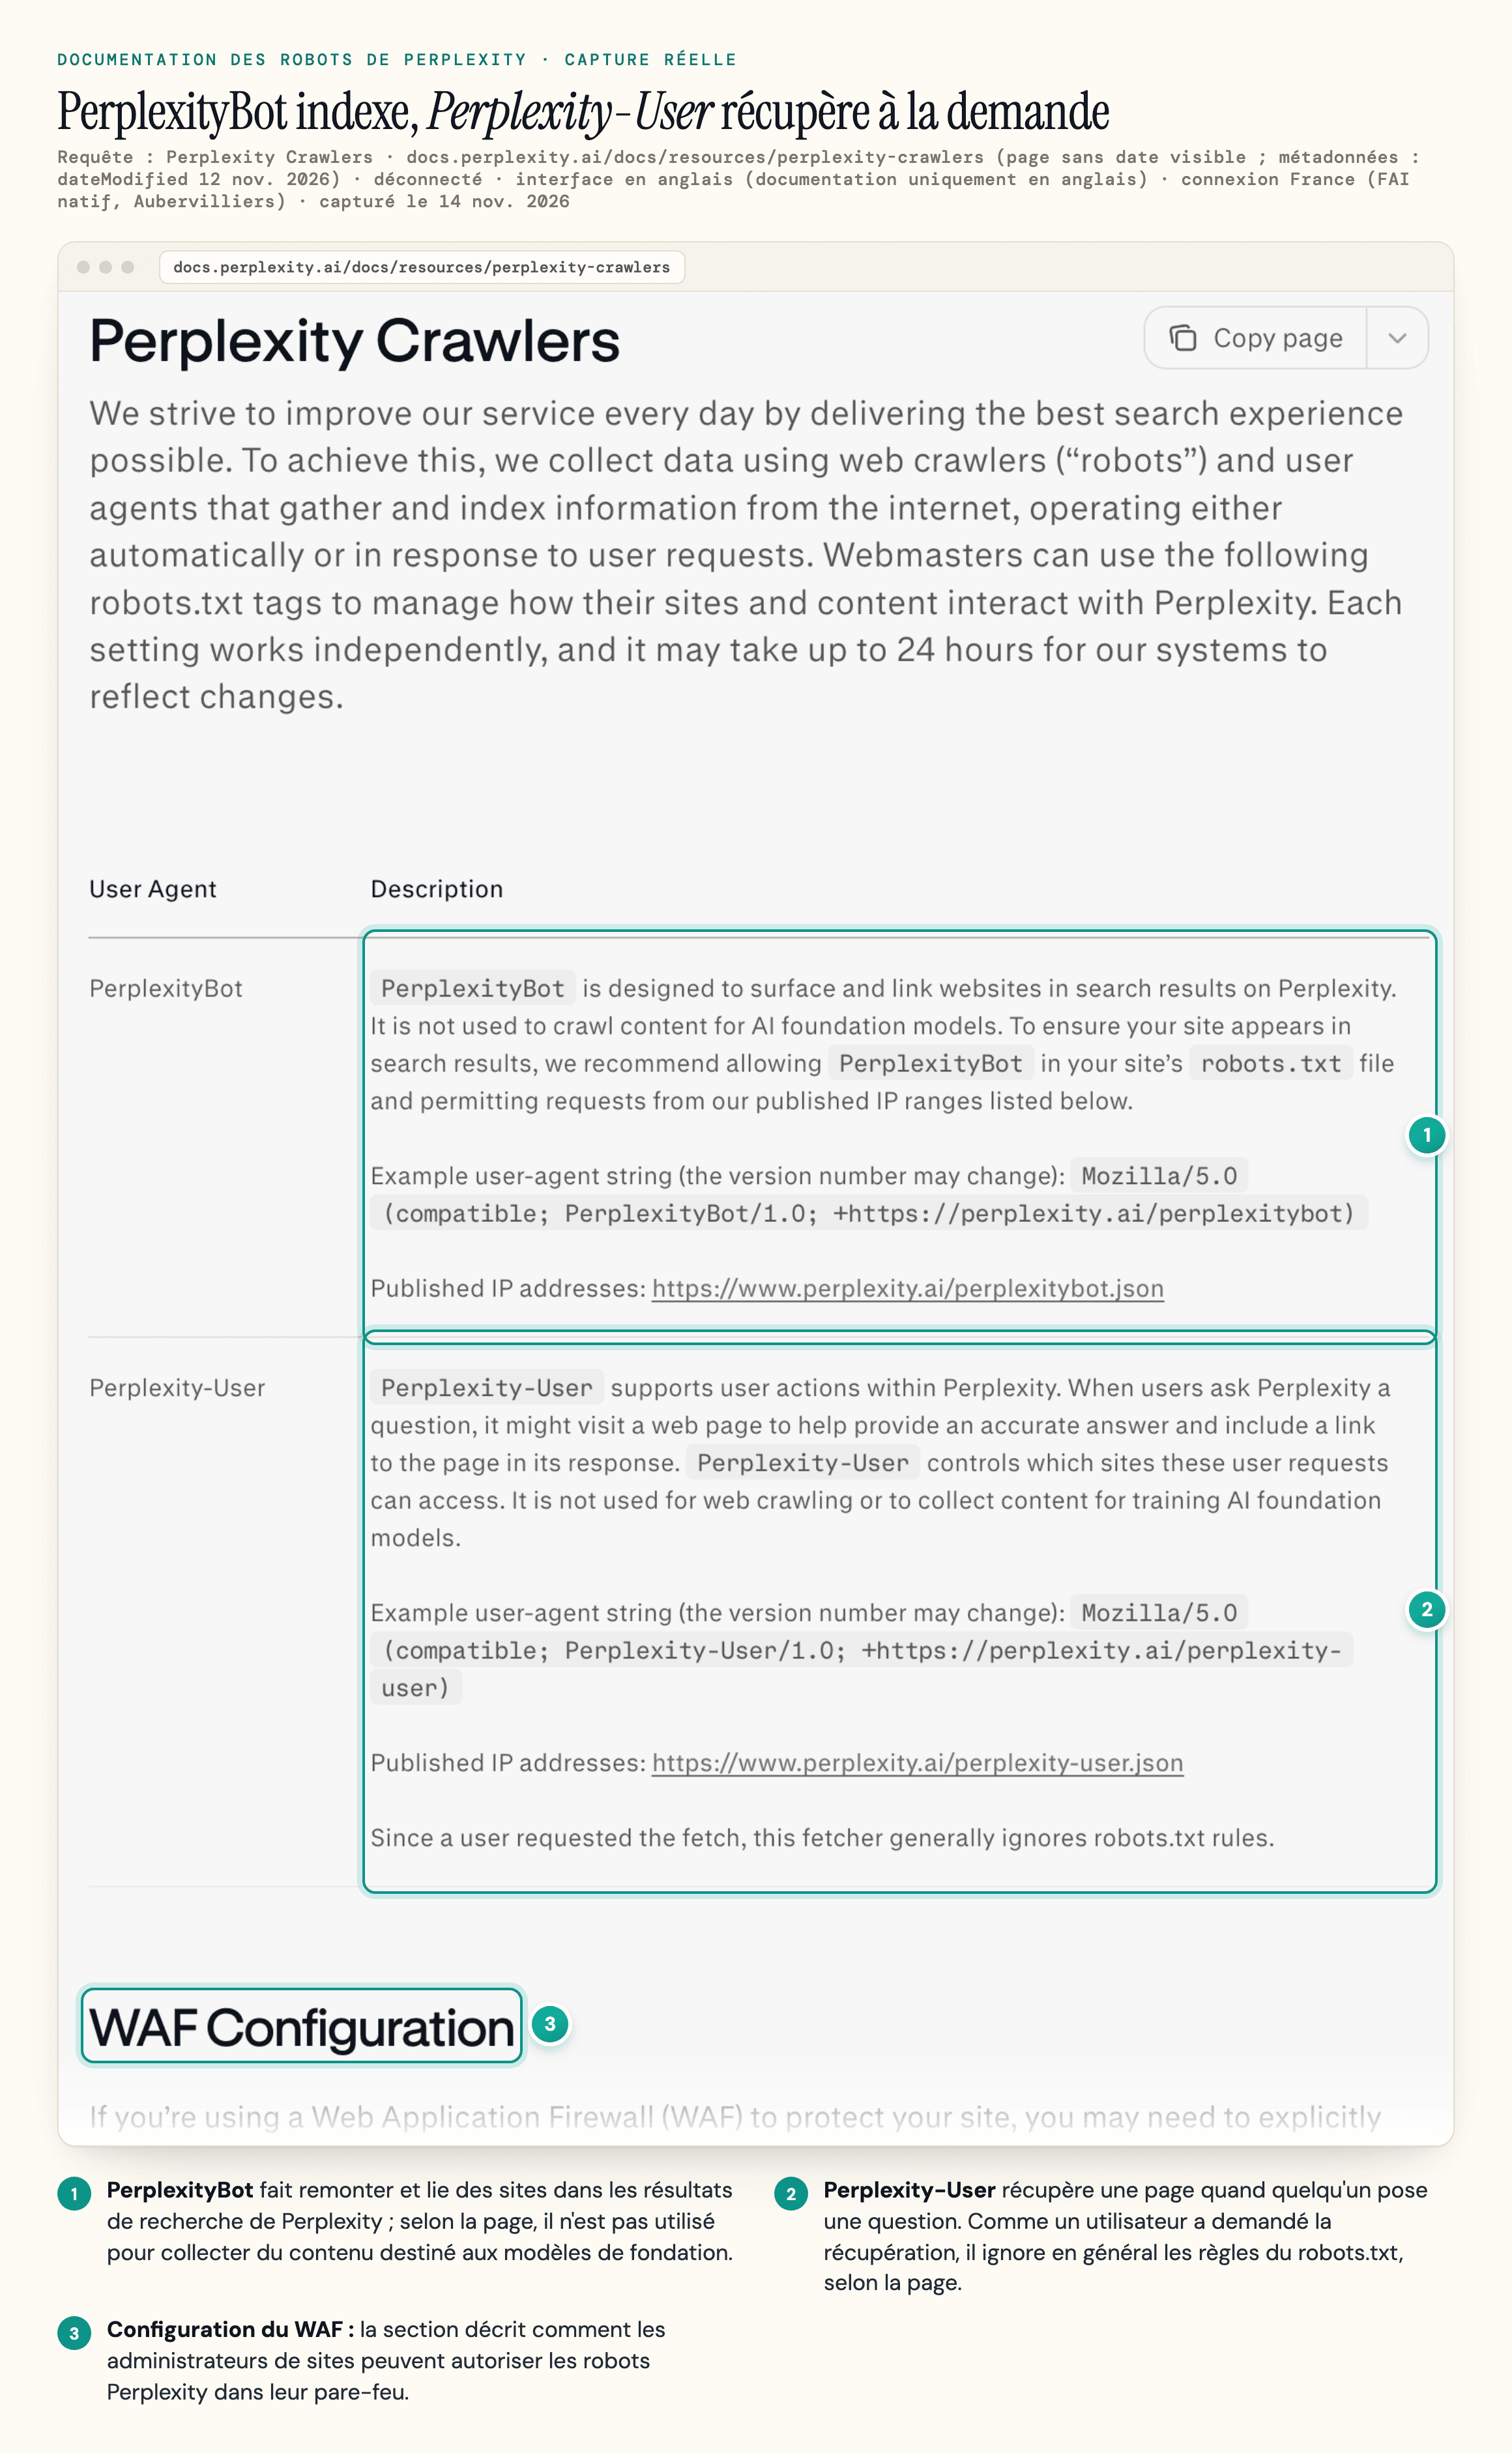
Testez donc ce que chaque robot reçoit, pas seulement ce que disent les règles. Le scan Agent Readiness de geotoolbox interroge votre site avec six user-agents de robots depuis notre serveur et signale les erreurs 403 et les blocages du pare-feu. Un pare-feu qui vérifie les robots par adresse IP peut toutefois traiter le vrai robot autrement : vérifiez-le dans les réglages anti-bots ou les logs de votre CDN.
Le budget de crawl ne concerne que les grands sites
Le guide de Google sur le budget d’exploration vise les sites de plus de 1 million de pages uniques modifiées chaque semaine, de plus de 10 000 pages modifiées chaque jour, ou dont une grande partie des URL reste en « Détectée, actuellement non indexée », et Google précise que « les chiffres indiqués ici sont une approximation générale ». En dessous, une page non indexée a le plus souvent une autre cause, comme du contenu dupliqué ou trop mince. Si vous publiez des milliers de pages à partir d’un même gabarit, notre guide du SEO programmatique explique comment les faire explorer et indexer.
Ce qui fait explorer pour rien, quelle que soit la taille du site : les chaînes de redirections, les soft 404 (« Les pages soft 404 continuent à être explorées et consomment donc inutilement une partie de votre budget »), et les serveurs lents ou en panne. Google réduit sa cadence d’exploration quand les réponses ralentissent ou renvoient des codes 5xx ou 429.
Rendu : ce que chaque robot voit vraiment
Si votre texte principal n’apparaît qu’une fois le JavaScript exécuté, Google le verra d’ordinaire, mais les robots d’OpenAI, d’Anthropic et de Perplexity, la plupart du temps, non.
Google rend les pages dans la seconde étape décrite plus haut, mise en file d’attente, qui peut prendre du retard sur l’exploration. Les consignes de Bing demandent de ne pas cacher le contenu essentiel derrière un rendu côté client, car un contenu qui ne peut pas être rendu de façon fiable risque de n’être ni indexé ni retenu pour ancrer des réponses.
En décembre 2024, l'analyse de logs de Vercel et MERJ sur le réseau de Vercel concluait (en anglais) que « none of the major AI crawlers currently render JavaScript ». Sur nextjs.org, le robot de ChatGPT consacrait 11,50 % de ses requêtes à des fichiers JavaScript et celui de Claude 23,84 %, sans jamais les exécuter.
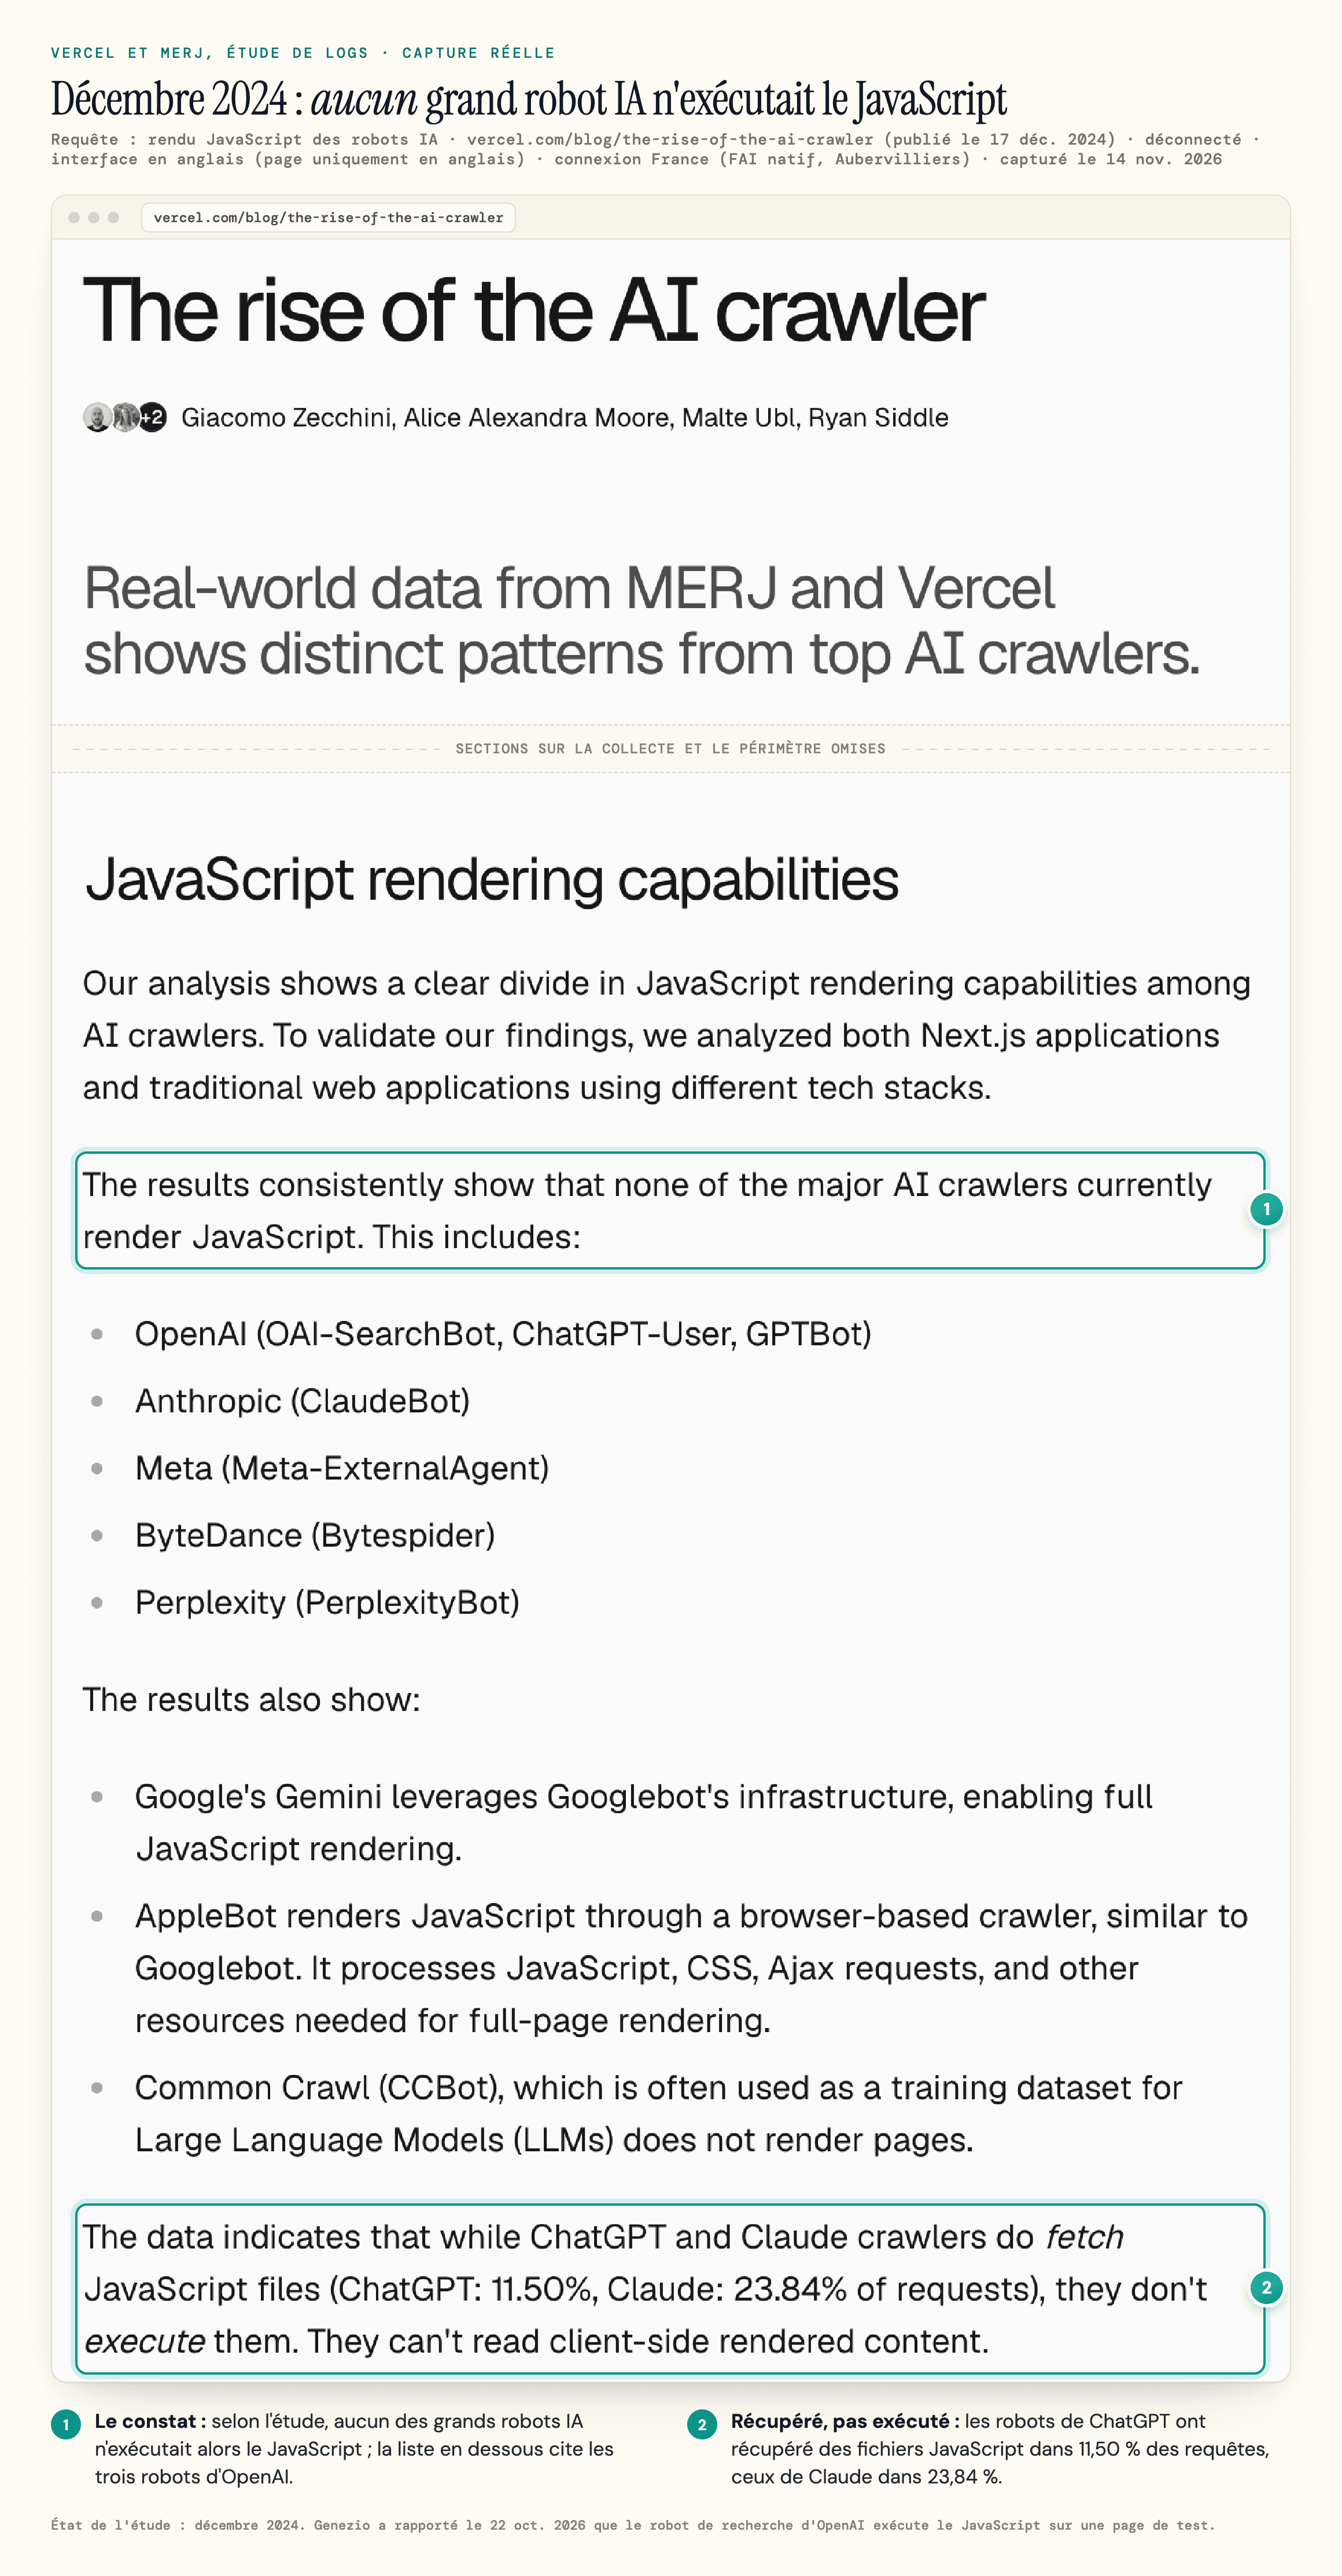
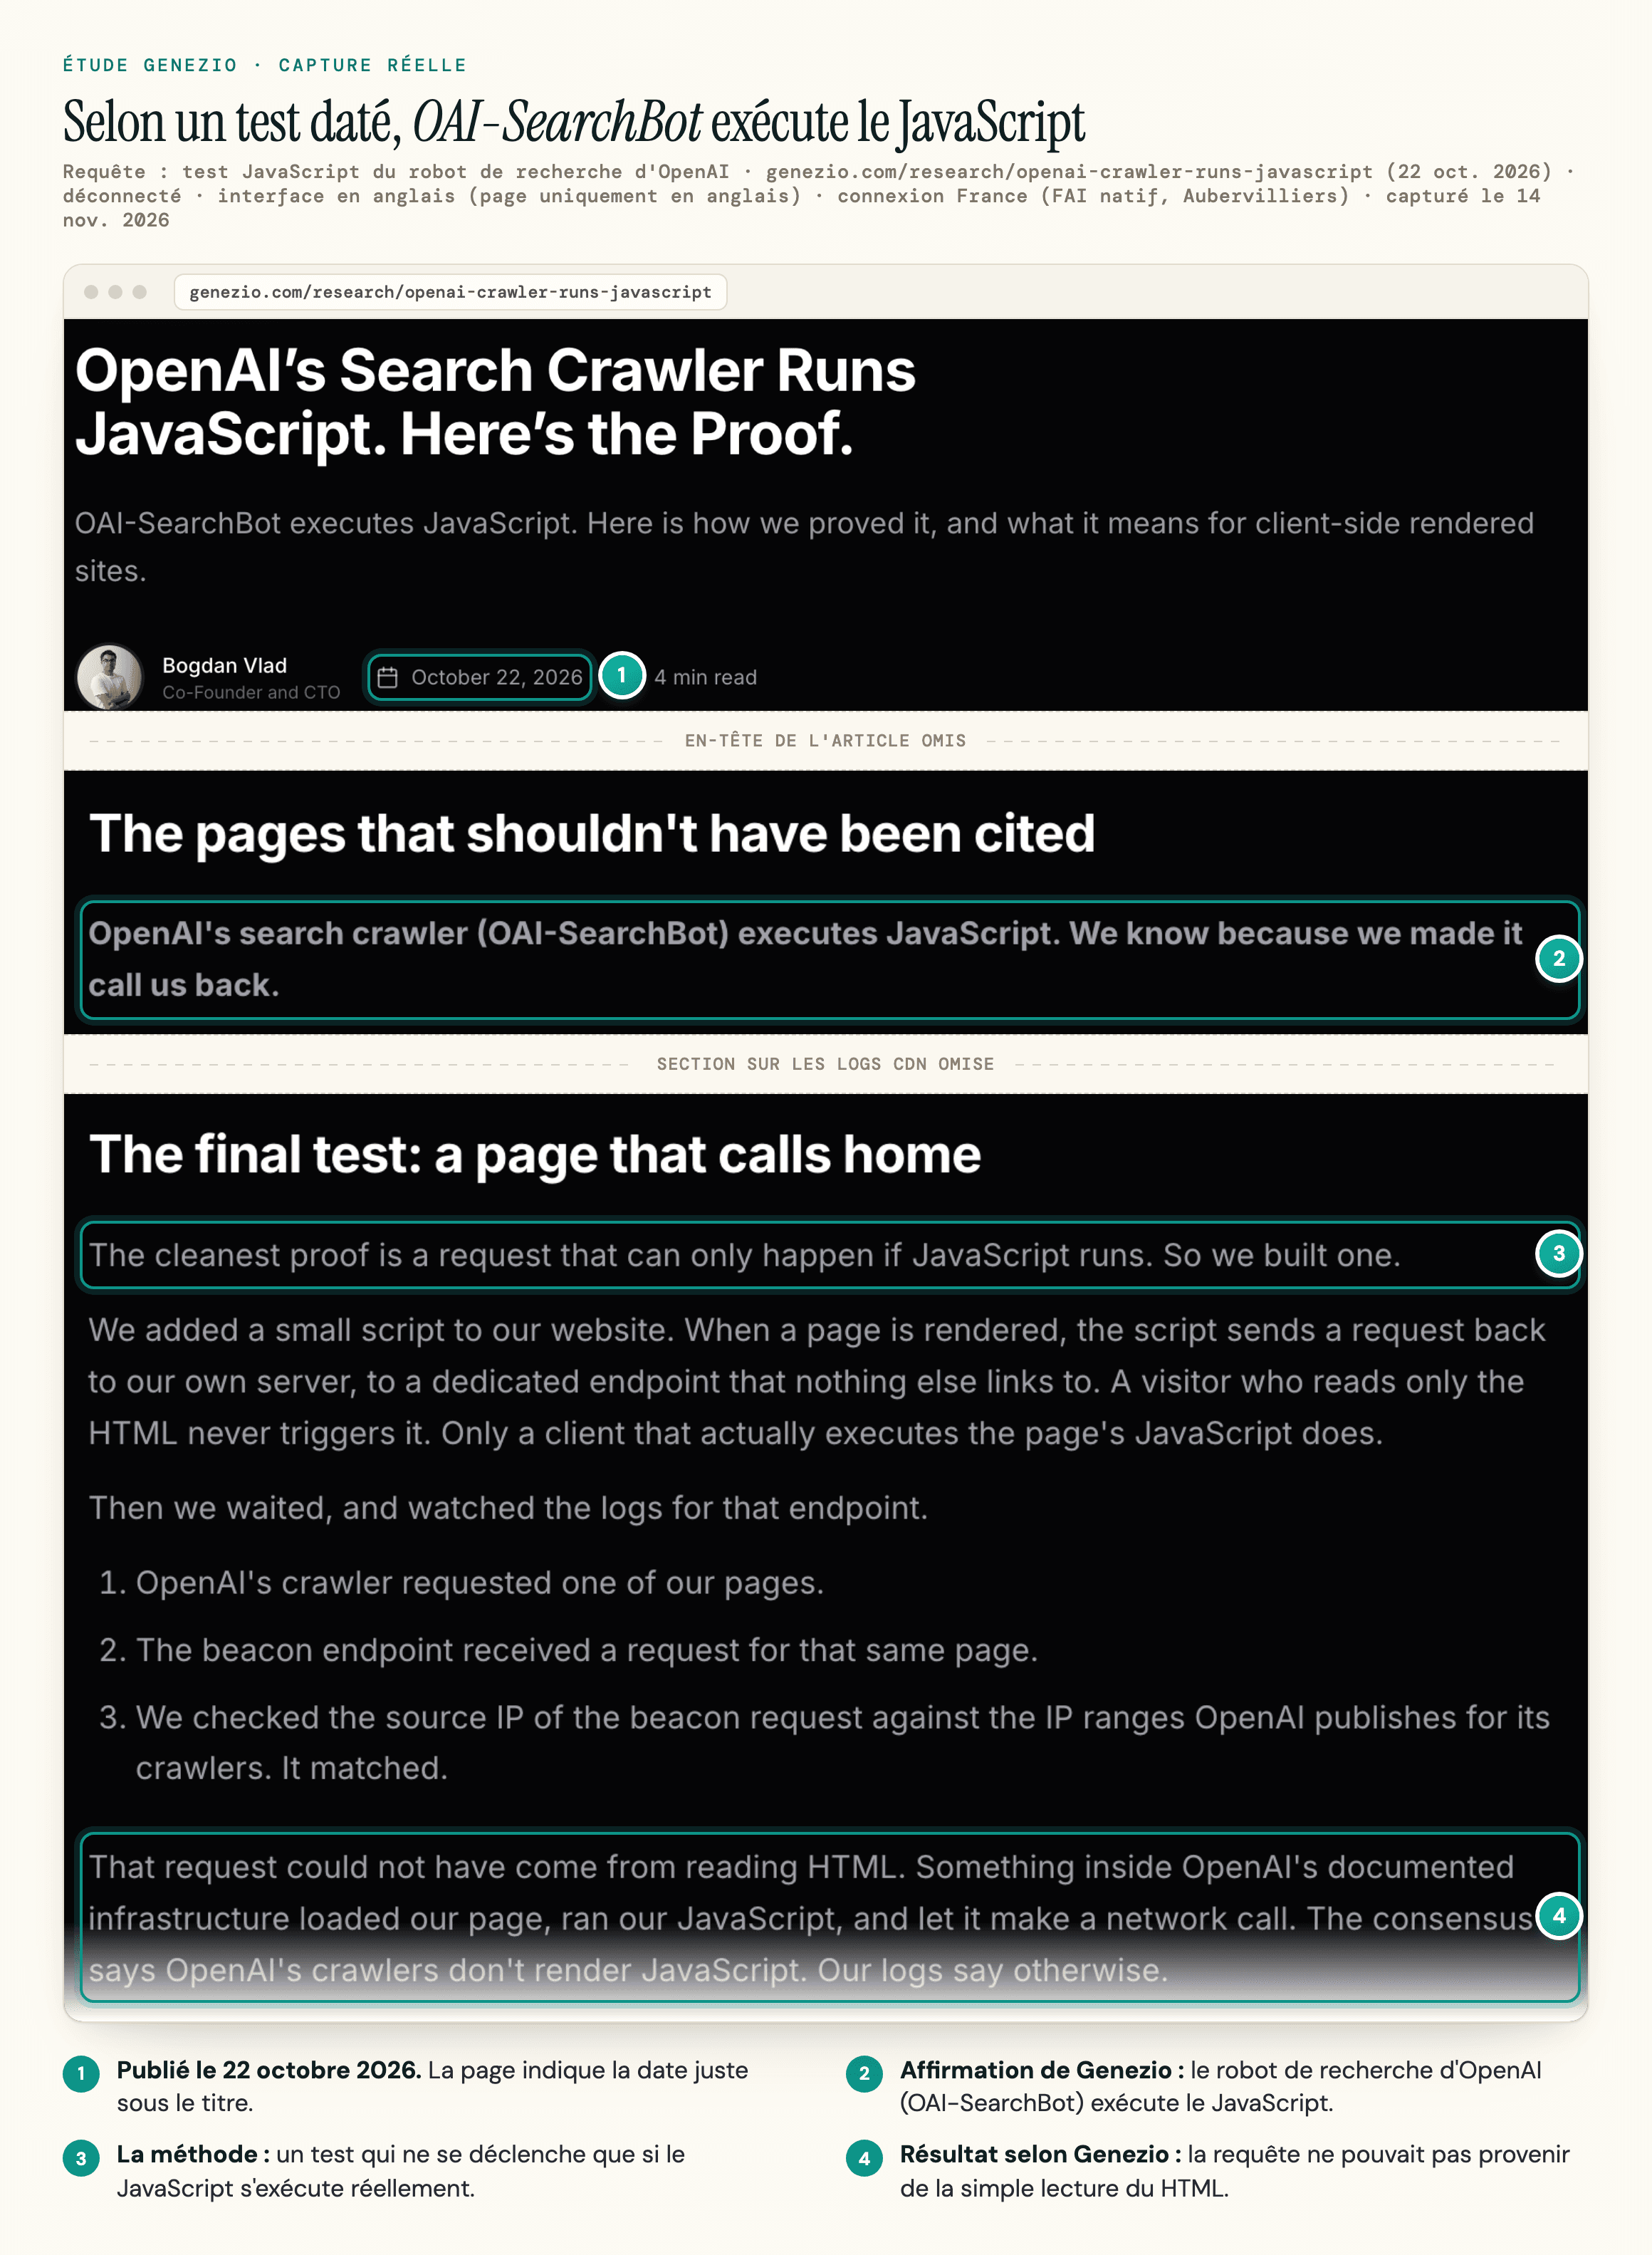
Pour le robot de recherche d’OpenAI, la situation a changé. Le 22 octobre 2026, Genezio, qui vend un logiciel de visibilité dans l’IA, a publié un test mené sur son propre site : un robot venu des plages d’adresses IP d’OpenAI a appelé un point de terminaison que seule l’exécution du JavaScript permettait d’atteindre.
Le log de 30 jours d’un site d’actualité publié par Forge, arrêté au 24 septembre 2026, a surpris OAI-SearchBot en train de charger une page comme le ferait un navigateur, une seule fois sur 1 738 requêtes portant ce nom de robot (Forge ne les a pas comparées à la liste d’IP d’OpenAI), et Forge précise qu’un log ne peut pas montrer si les scripts ont tourné.
OpenAI n’a rien documenté de tout cela. Dans le même log, ChatGPT-User, Claude-User et PerplexityBot n’ont récupéré aucun script.
Deux autres tests brouillent les pistes. Un test par balise web (beacon) de JS SEO Lab a enregistré GPTBot en train d’exécuter des scripts intégrés à la page, et un test de searchVIU mené le 30 octobre 2025 laisse penser qu’un contenu écrit par script peut atteindre l’index de Perplexity.
Le test du code source
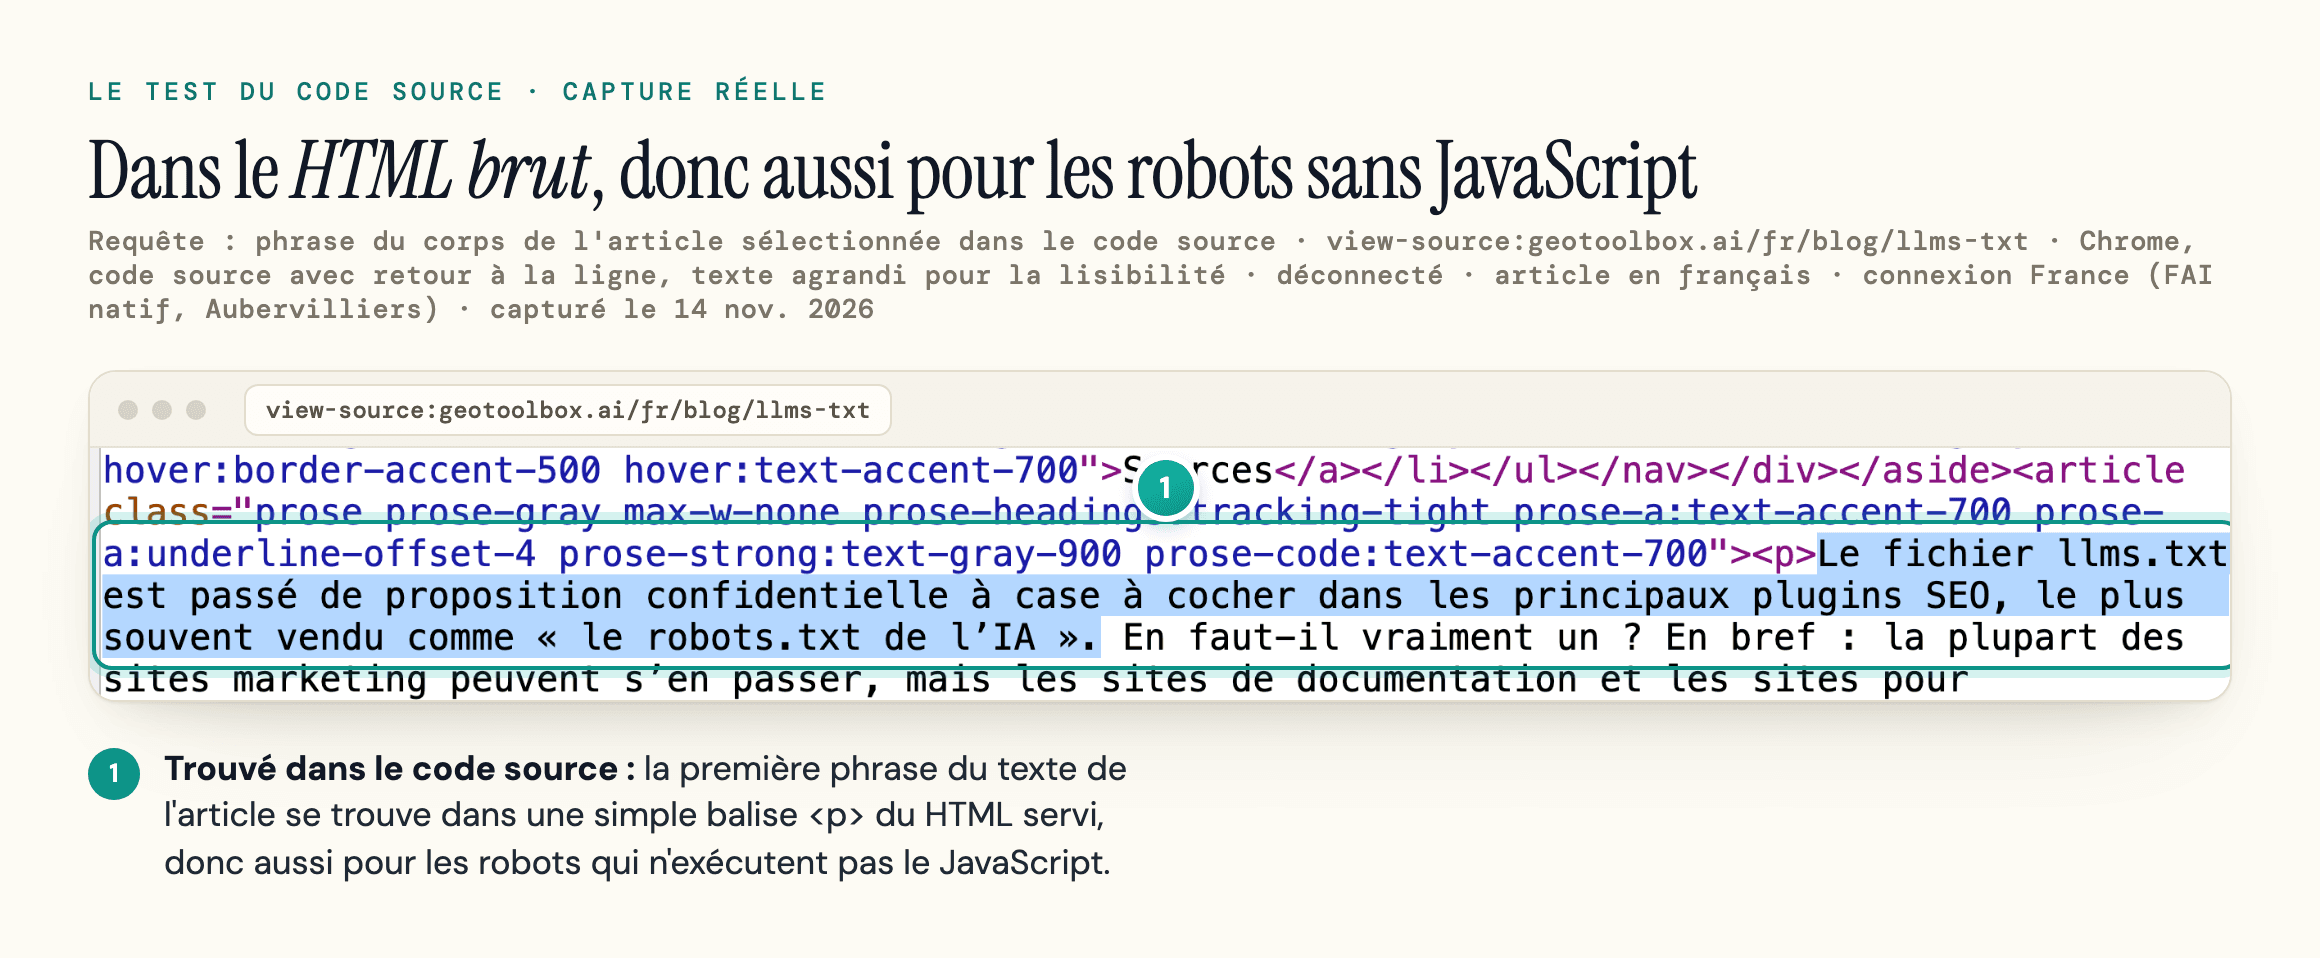
Ouvrez le code source de la page (Ctrl+U, ou Cmd+Option+U sur Mac), cherchez une phrase de votre contenu principal et vérifiez qu’elle s’y trouve. Si elle n’est pas dans le code source, les robots qui lisent le HTML brut ne peuvent pas la citer.
La solution passe par le rendu côté serveur, la génération statique ou le prérendu pour les pages de contenu. Notre guide du SEO JavaScript détaille les résultats des tests robot par robot et les options selon le framework.
Indexation, balises canoniques et sitemaps
L’indexation reste une décision de Google, que vous influencez par des signaux cohérents : une seule URL canonique par contenu, aucun noindex accidentel et un sitemap qui ne liste que les pages à indexer.
Dans la Google Search Console, le travail de SEO technique commence par le rapport « Indexation des pages », qui regroupe les URL laissées de côté par Google selon le motif qu’il donne.
Google traite la balise canonique comme un signal fort, pas comme un ordre : elle fonctionne mieux quand les liens internes, les sitemaps et les redirections vont dans le même sens. Notre guide des balises canoniques explique comment Google et les moteurs IA choisissent une URL.
Sitemaps et IndexNow
D’après Google, un site d'environ 500 pages ou moins dont toutes les pages sont reliées par des liens internes peut se passer de sitemap. Bing ajoute IndexNow, un signal qui le prévient quand une URL est ajoutée, modifiée ou supprimée, et ses consignes relient cette fraîcheur aux réponses de Copilot.
Pour soumettre un sitemap à Google, ajoutez-le dans le rapport sur les sitemaps de la Search Console, qui indique aussi quand Googlebot l’a lu et les éventuelles erreurs de traitement, ou déclarez-le sur une ligne Sitemap: du robots.txt (l’API Search Console fonctionne aussi). Pour Google, l’envoi n’est qu’une suggestion : il ne garantit pas que Google télécharge le fichier ni qu’il l’utilise. Pour la mise en place, voyez notre guide du sitemap XML.
« Explorée, actuellement non indexée »
Dans la Google Search Console, cet état signifie que Google a récupéré la page et a choisi de ne pas l’indexer, pour l’instant. Ce n’est pas un code d’erreur : comme le rappelle l'aide de Google, « Google n’indexe pas toutes les pages du Web. Ce message est donc courant pour de nombreux sites et n’indique pas nécessairement un problème qui requiert votre attention. »
Procédez dans cet ordre :
- Vérifiez si la page duplique une autre URL et si Google a retenu une autre URL canonique
- Comptez les liens internes qui pointent vers elle, et d’où ils viennent
- Demandez-vous si elle apporte quelque chose que les pages indexées sur le même sujet n’apportent pas
Le bouton « Demander une indexation » de l'outil d’inspection d’URL demande seulement à Google d’explorer l’URL de nouveau : il change rarement le résultat tant que la cause est toujours là.
Navigation à facettes
Filtres et ordres de tri peuvent produire des milliers d’URL presque identiques. Pour éloigner les robots des combinaisons que personne ne recherche, les recommandations de Google sur la navigation à facettes privilégient le blocage dans le robots.txt ou le passage des filtres dans des fragments d’URL ; Google y juge les balises canoniques généralement moins efficaces pour cela. Si ces URL sont déjà indexées, passez-les d’abord en noindex et ne les bloquez qu’une fois sorties de l’index. Notre guide du SEO e-commerce déroule ce choix filtre par filtre.
Les catalogues B2B ajoutent un autre problème d’exploration : des fiches techniques et des certificats publiés uniquement en PDF ou derrière des formulaires, un cas traité dans notre guide du SEO B2B.
Pagination
Les longues listes, comme les pages catégories et les archives de blog, s’étalent sur plusieurs pages. Les bonnes pratiques de pagination de Google demandent une URL unique par page, par exemple ?page=2, avec sa propre URL canonique : ne faites pas pointer la balise canonique de chaque page vers la page 1. Reliez chaque page à la suivante par un simple lien <a href>, et ne placez pas les numéros de page dans des fragments #, que Google ignore. Google n’utilise plus rel="next" ni rel="prev".
Architecture du site et maillage interne
Les moteurs de recherche et les robots IA découvrent la plupart des pages en suivant des liens : votre maillage interne détermine ce qui est découvert en premier et ce qui semble important.
Utilisez de simples liens <a href>. Les consignes de Bing demandent exactement cela, avec des ancres pertinentes. Un lien qui n’existe qu’après l’exécution d’un gestionnaire de clic reste invisible pour les robots qui n’exécutent pas le JavaScript.
Gardez les pages importantes proches de la page d’accueil grâce aux pages catégories et au fil d’Ariane. Chaque page à indexer doit être reliée par un chemin de liens explorable. Conservez des URL courtes, lisibles et stables, car chaque changement exige des redirections.
Pages orphelines et liens cassés
Les pages orphelines, vers lesquelles aucun lien interne ne pointe, sont les victimes habituelles des refontes et des migrations de CMS.
Les liens internes cassés gaspillent les requêtes de tous les robots, robots IA compris. Un audit complet, comme dans notre checklist d’audit SEO, repère les pages orphelines et les liens cassés à grande échelle.
Redirections : 301, 302 ou 404
Quand vous déplacez ou supprimez une URL, redirigez-la vers une page qui la remplace vraiment, avec une redirection permanente côté serveur (301 ou 308). Google traite une redirection permanente comme un signal indiquant que la cible doit être canonique, et affiche la cible dans les résultats. Une redirection temporaire (302 ou 307) sert à un déplacement que vous annulerez : Google continue en général d’afficher la page source et n’utilise pas la redirection comme signal de canonicité, même si d’autres signaux peuvent faire indexer la cible. Si aucune page ne la remplace, renvoyez un code 404 ou 410, que Google recommande pour les pages supprimées définitivement, et mettez à jour les liens qui pointaient vers elle.
Expérience de page : Core Web Vitals, mobile et HTTPS
Les Core Web Vitals sont les critères de SEO technique mesurés lors de visites réelles : chargement, réactivité et stabilité visuelle. Google indique que de bons scores sont en adéquation avec ce que ses principaux systèmes de classement « cherchent à récompenser », mais ces scores ne forment qu’un signal parmi beaucoup d’autres, et la pertinence passe avant.
| Métrique | Ce qu’elle mesure | Bon |
|---|---|---|
| Largest Contentful Paint (LCP) | Le chargement : le moment où le contenu principal s’affiche | 2,5 secondes ou moins |
| Interaction to Next Paint (INP) | La réactivité aux clics, appuis et frappes au clavier | 200 millisecondes ou moins |
| Cumulative Layout Shift (CLS) | La stabilité visuelle (décalages de mise en page imprévus) | 0,1 ou moins |
Le guide des Core Web Vitals de web.dev fixe ces seuils au 75e centile des chargements de page, mesurés séparément sur mobile et sur ordinateur. L’INP a remplacé le First Input Delay (FID) comme métrique de réactivité, même si plusieurs guides français citent encore le FID. Au-delà de 500 millisecondes, l’INP est jugé mauvais.
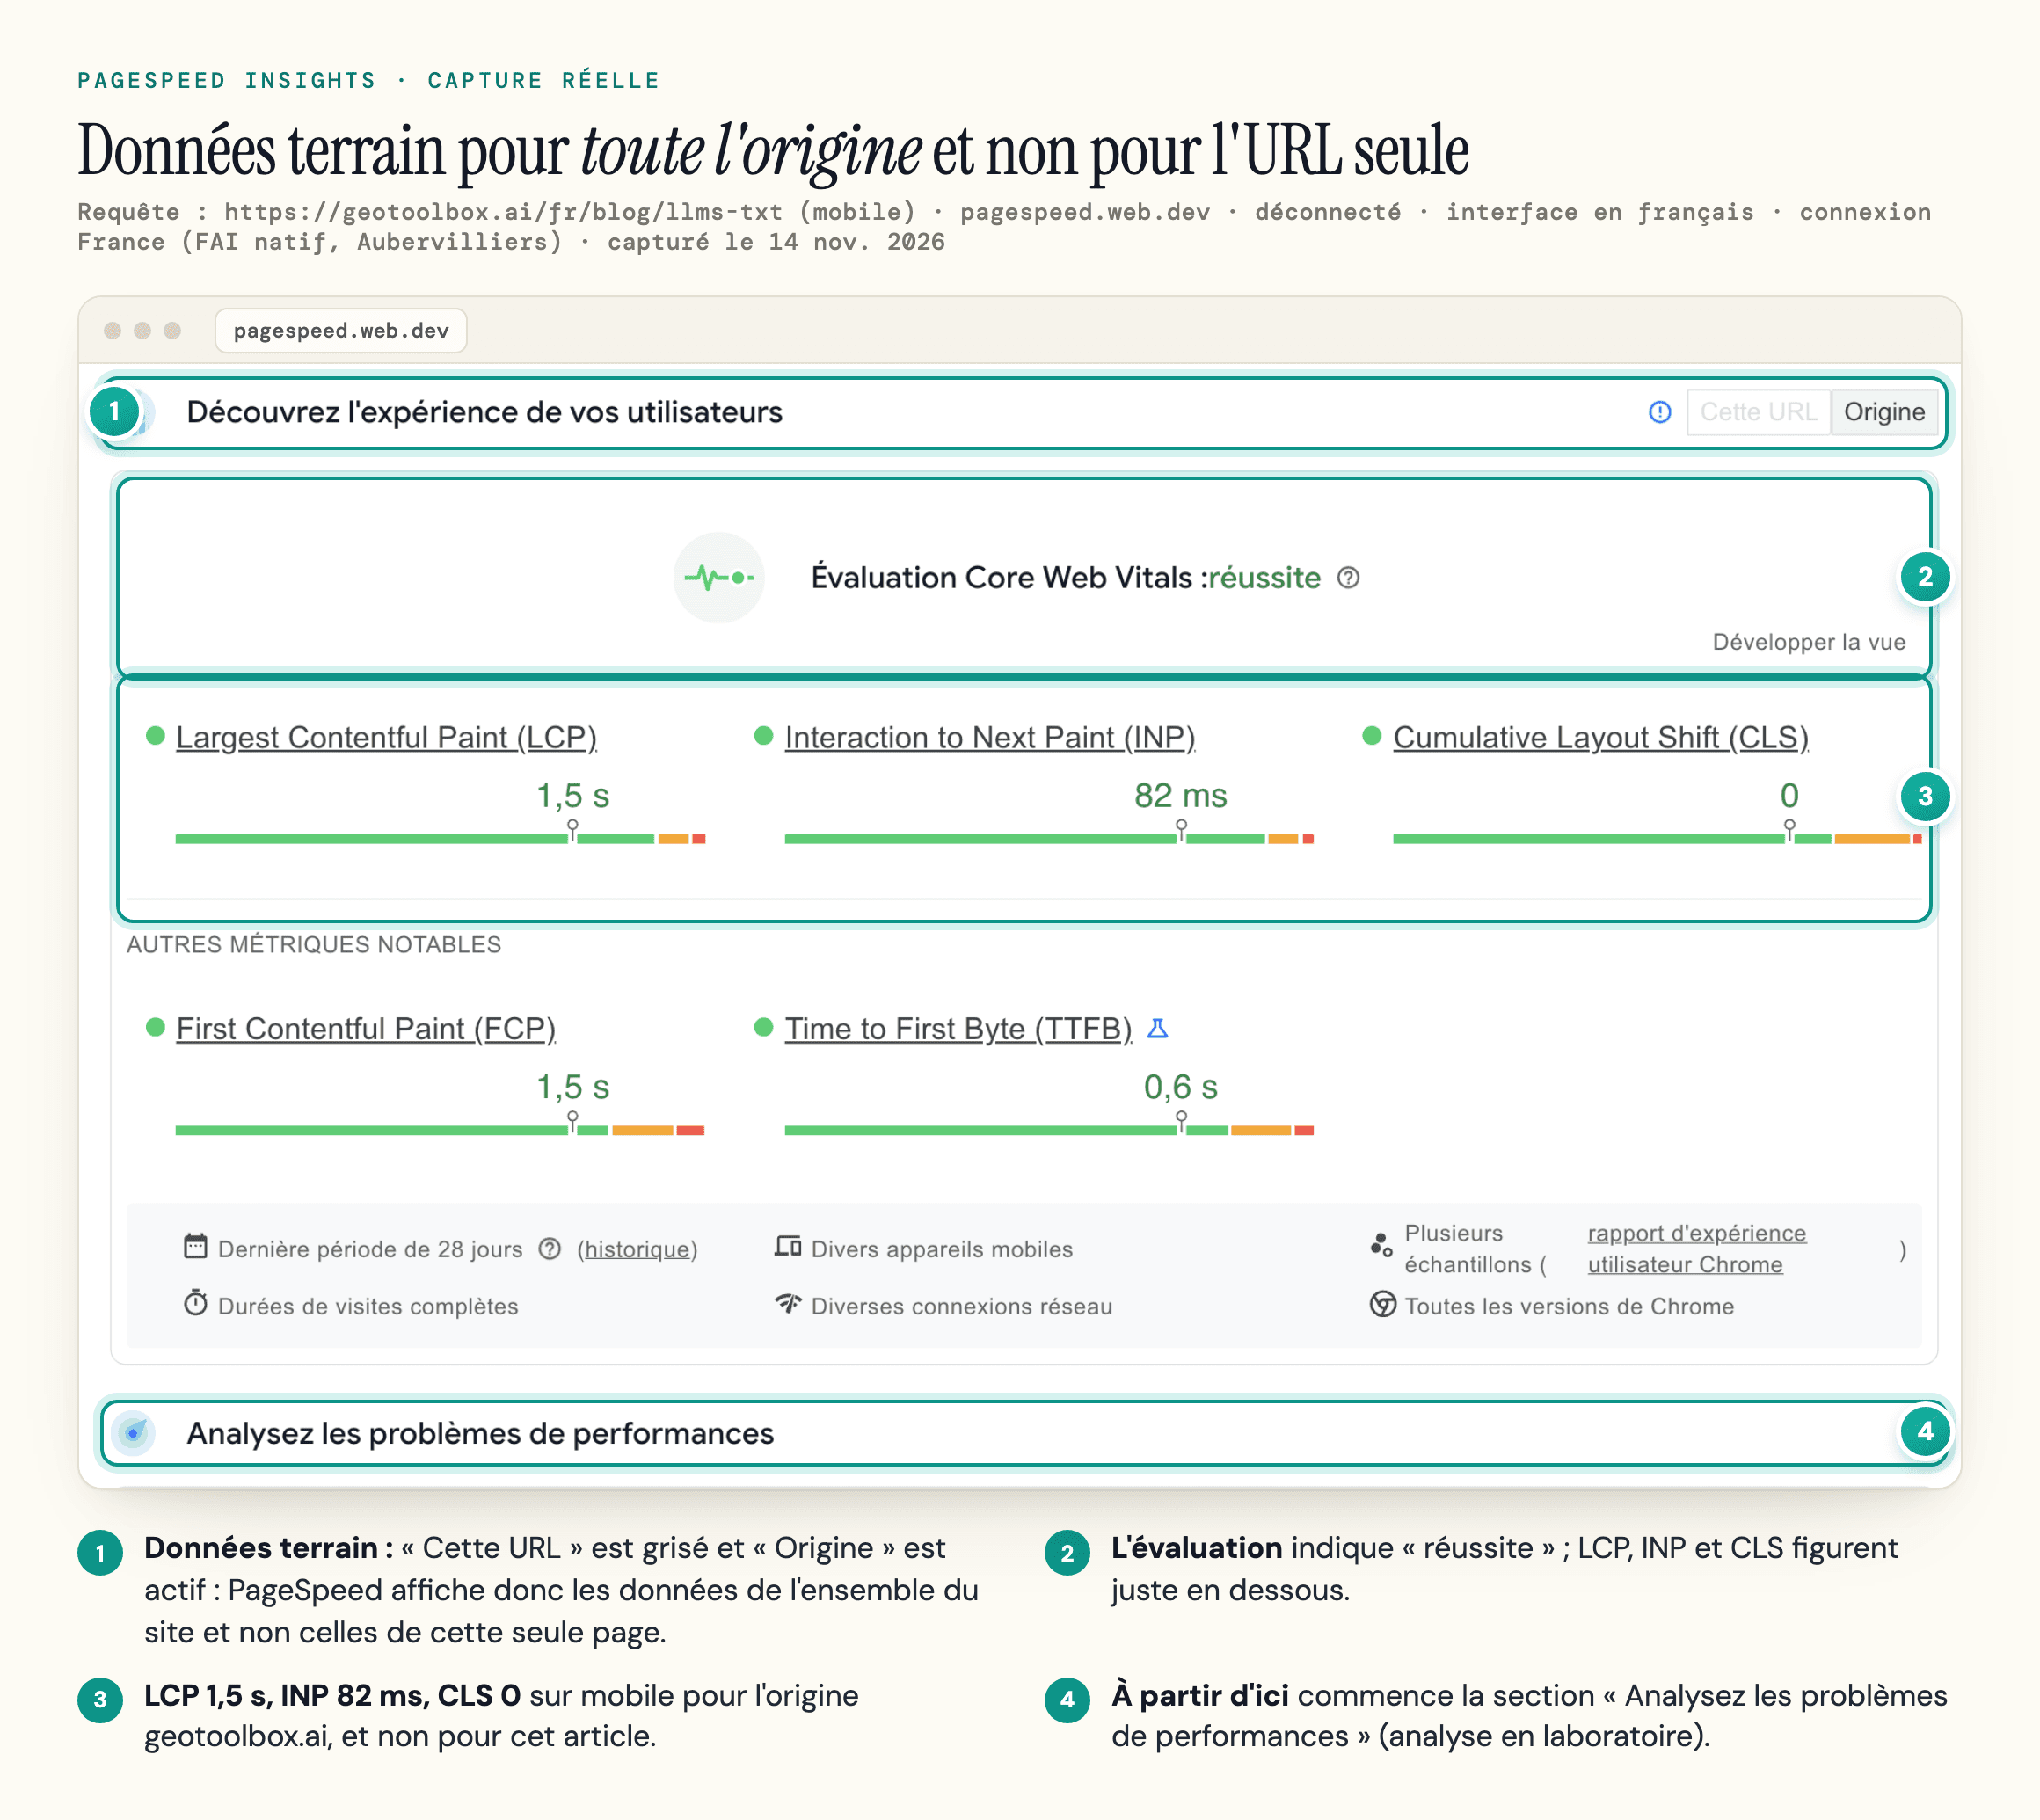
Fiez-vous aux données terrain, pas au score de laboratoire : le chiffre de laboratoire varie d’un test à l’autre, alors que les données terrain viennent de vrais utilisateurs de Chrome. Quand une URL a trop peu de trafic, PageSpeed Insights affiche à la place les données terrain de toute l’origine, si celle-ci en a assez, comme dans la capture ci-dessous.
Comment accélérer une page lente
Pour le LCP, le guide d’optimisation de web.dev cite notamment ces leviers :
- Images : ne chargez jamais l’image LCP en différé (lazy loading), et compressez les images dans des formats modernes comme AVIF ou WebP
- Code bloquant le rendu : minifiez et compressez le CSS critique, et différez ou intégrez dans la page le JavaScript qui bloque le rendu
- Cache et distance : une politique cache-control efficace rend les chargements répétés quasi instantanés, et un CDN sert les fichiers plus près des visiteurs
- Réponse du serveur : un temps de réponse initial (TTFB) lent, souvent dû à des chaînes de redirections ou à des réponses que le CDN ne peut pas mettre en cache, retarde tout ce qui suit
Pour l’INP, le guide INP de web.dev recommande de découper les longues tâches JavaScript en tâches plus courtes, pour que la page réagisse plus vite aux interactions.
Indexation mobile first et HTTPS
Google indexe la version mobile de vos pages, explorée avec son agent pour smartphone : un contenu ou un lien absent sur mobile est absent pour Google. Les pages doivent aussi être servies en HTTPS sur un seul hôte, les URL en HTTP et l’autre version de l’hôte (avec ou sans www) redirigeant vers lui.
La vitesse aide-t-elle à être cité par les IA ?
Nous n’avons vu aucune preuve publiée qui l’établisse, et aucune des pages d’OpenAI, d’Anthropic ou de Perplexity sur leurs robots que nous avons consultées ne parle de vitesse de chargement.
Données structurées et hreflang
Les données structurées décrivent le sujet d’une page dans un format que les machines lisent sans avoir à deviner. Écrivez-les en JSON-LD et gardez-les identiques à ce que la page affiche.
Le guide d’optimisation pour l’IA de Google le dit à propos des données structurées : « ces données ne sont pas une obligation pour la recherche par IA générative et aucun balisage schema.org spécial n’est nécessaire ». Google recommande toujours le balisage pour être éligible aux résultats enrichis. Selon les consignes de Bing, les données structurées peuvent rendre l’ancrage des réponses plus clair, sans garantir ni visibilité ni trafic issu de cet ancrage.
Dans la seule étude d’intervention que nous connaissions, Ahrefs a suivi 1 885 pages après l’ajout d’un balisage schema et a constaté que leurs citations par l’IA bougeaient à peine. Notre analyse du balisage schema pour la recherche IA passe ces études en revue.
Valider les données structurées
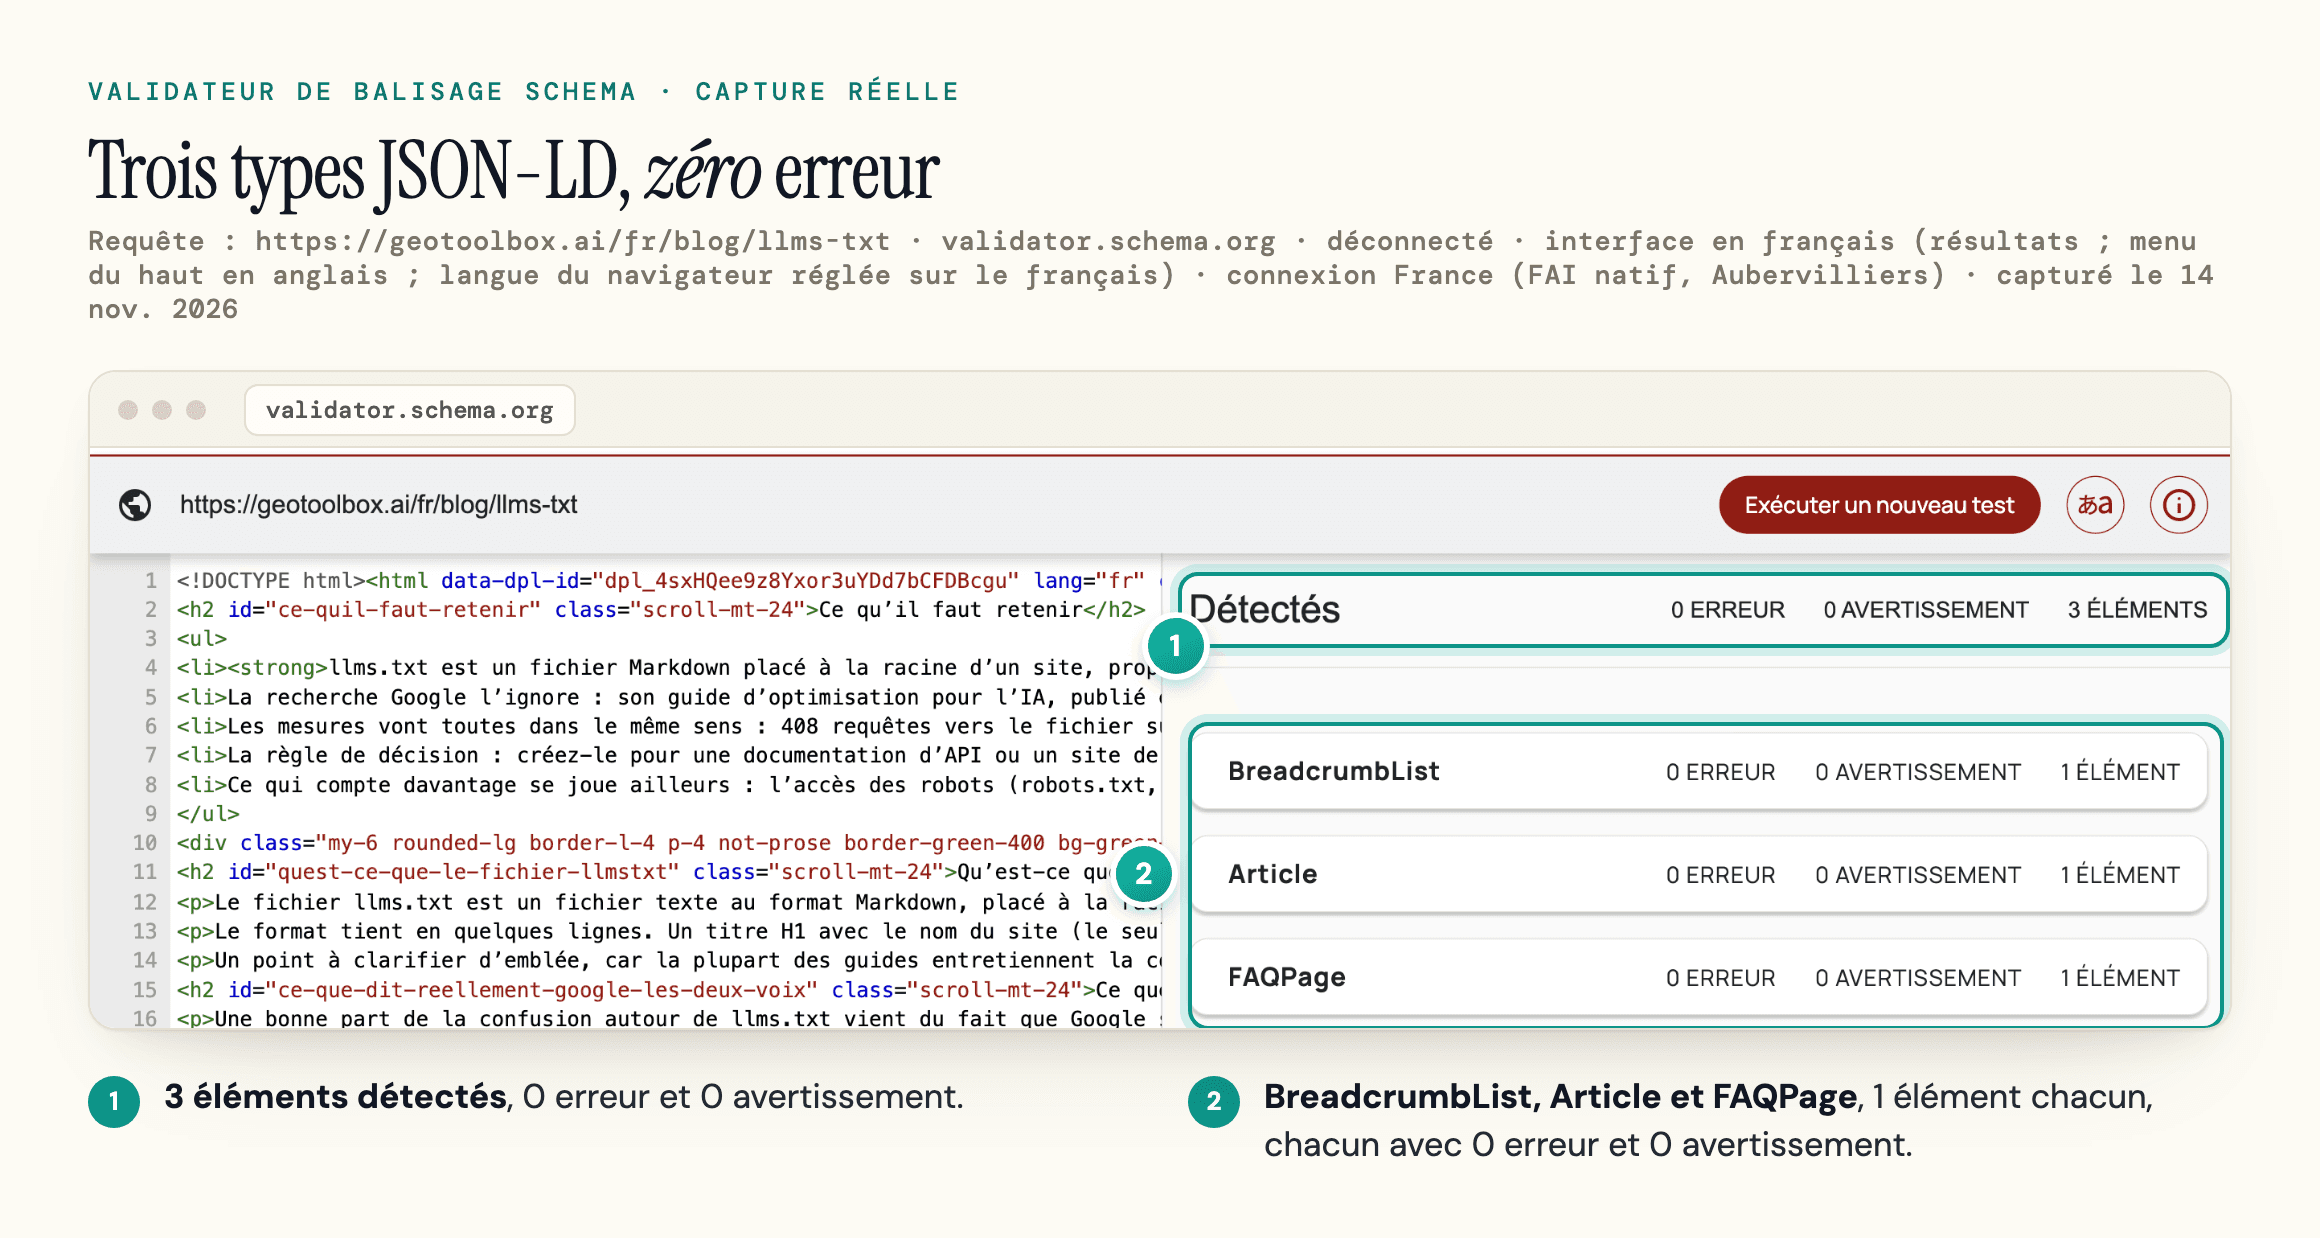
Un bloc JSON-LD qui contient une erreur de syntaxe ne peut pas être lu du tout, et Bing prévient qu’un balisage trompeur risque d’être ignoré.
Utiliser hreflang sur un site multilingue
L’attribut hreflang indique à Google quelle version linguistique ou régionale d’une page afficher. Chaque valeur est un code de langue au format ISO 639-1, éventuellement suivi d’un code de région (fr-FR, fr-CA).
Les erreurs courantes sont les annotations à sens unique (la page française cite la page anglaise, mais pas l’inverse) et les annotations qui pointent vers des URL redirigées ou en noindex. Reliez chaque version linguistique à elle-même et à toutes les autres, ne pointez que vers des URL canoniques et ajoutez une valeur x-default pour la page de repli.
Les pages des éditeurs d’IA sur leurs robots que nous avons consultées ne disent rien de hreflang. Ce que ces robots peuvent exploiter, c’est une URL distincte et explorable par langue, qui fonctionne en HTML simple.
Contrôles de la recherche IA : ce que change chaque réglage
La plupart des erreurs commises en voulant se retirer de l’IA viennent d’un contrôle prévu pour l’entraînement qu’on utilise pour régler un problème de recherche, ou l’inverse.
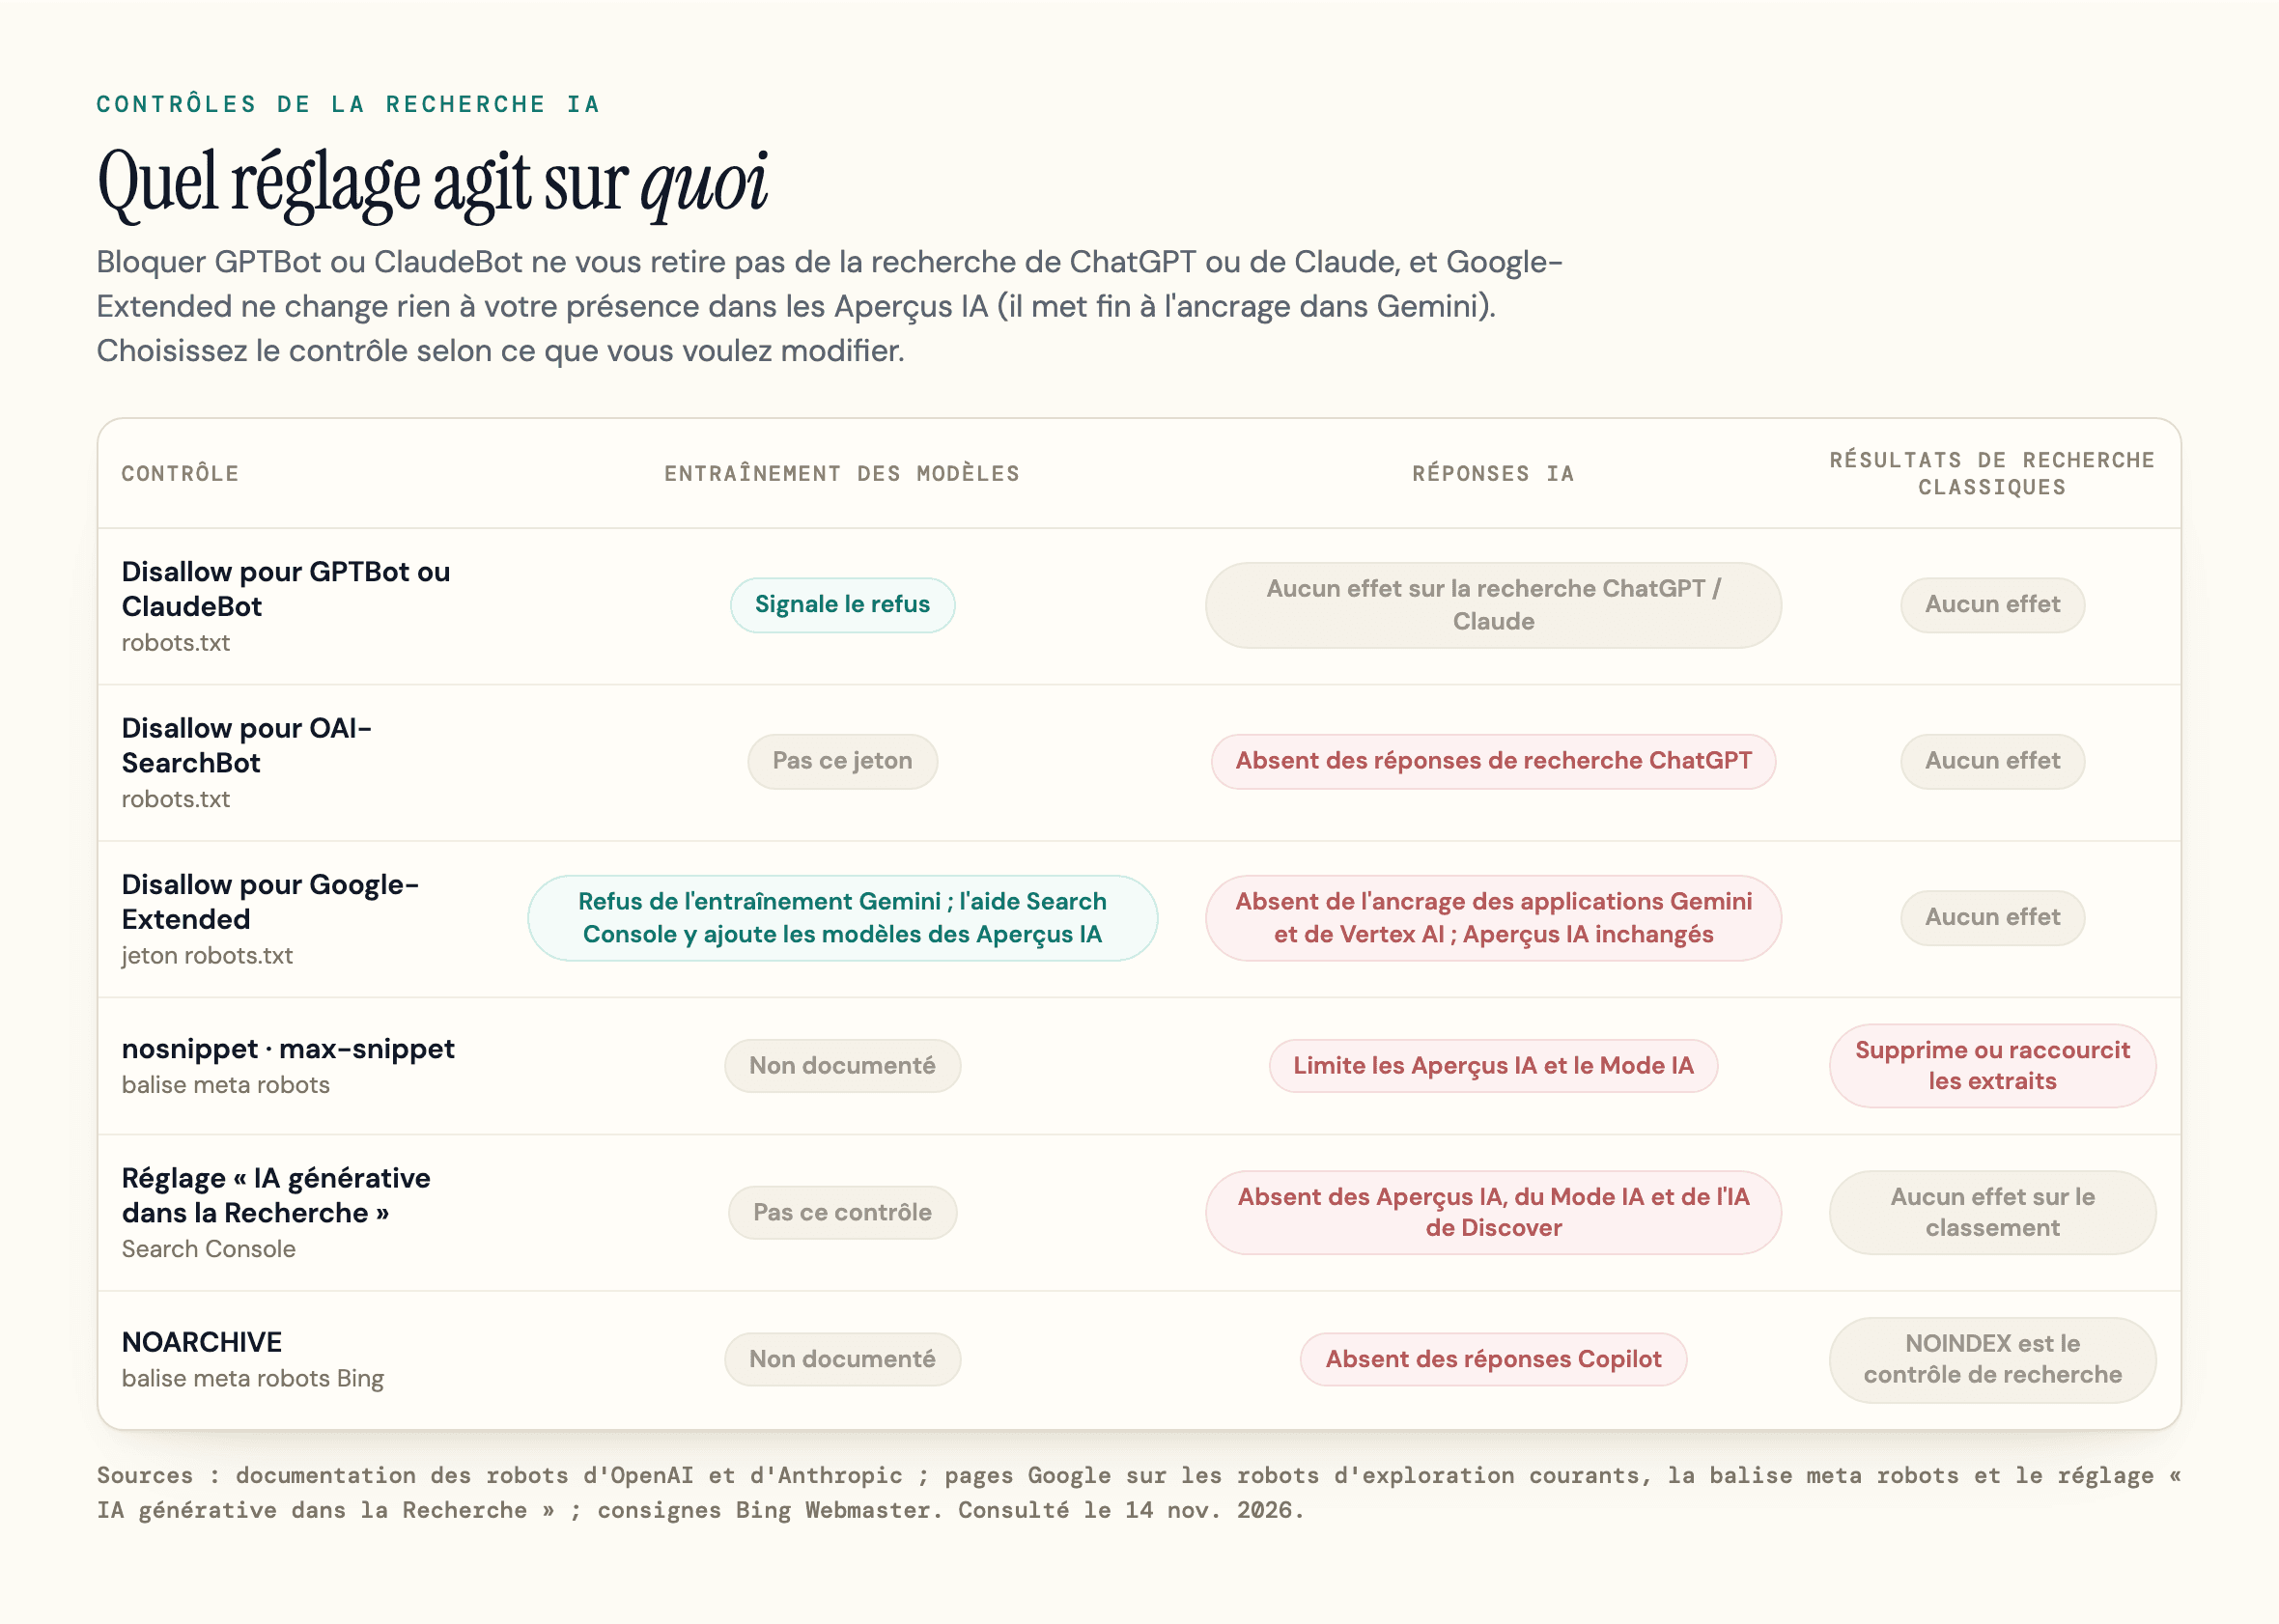
| Contrôle | Ce qu’il fait | Ce qu’il ne fait pas |
|---|---|---|
| Disallow pour GPTBot ou ClaudeBot | Signale que votre contenu ne doit pas servir à l’entraînement des modèles | Vous retirer de la recherche de ChatGPT ou de Claude |
| Disallow pour OAI-SearchBot | Écarte vos pages des réponses de recherche de ChatGPT | Supprimer les liens de navigation vers votre site |
| Disallow pour Google-Extended | Exclut vos pages de l’entraînement des modèles Gemini et de l’ancrage dans les applications Gemini et Vertex AI ; l’aide de la Search Console y ajoute l’entraînement des modèles derrière les Aperçus IA et le Mode IA | Changer votre présence dans la recherche Google, les Aperçus IA ou le Mode IA |
| Ajouter nosnippet ou max-snippet | Bloque ou limite le texte que Google peut utiliser comme source directe des Aperçus IA et du Mode IA, et peut aussi réduire ou supprimer les extraits classiques | Limiter le contenu que vous concédez sous licence à Google ou fournissez sous forme de données structurées dans la page (max-snippet) |
| Désactiver « IA générative dans la Recherche » dans la Search Console | Exclut la propriété, et les propriétés enfants qui héritent de son réglage, des Aperçus IA, du Mode IA et des fonctionnalités d’IA générative de Discover | Modifier le classement ailleurs dans la recherche |
| Ajouter NOARCHIVE (Bing) | Écarte le contenu des réponses de Copilot et de leur ancrage | Retirer l’URL de la recherche Bing (c’est le rôle de NOINDEX) |
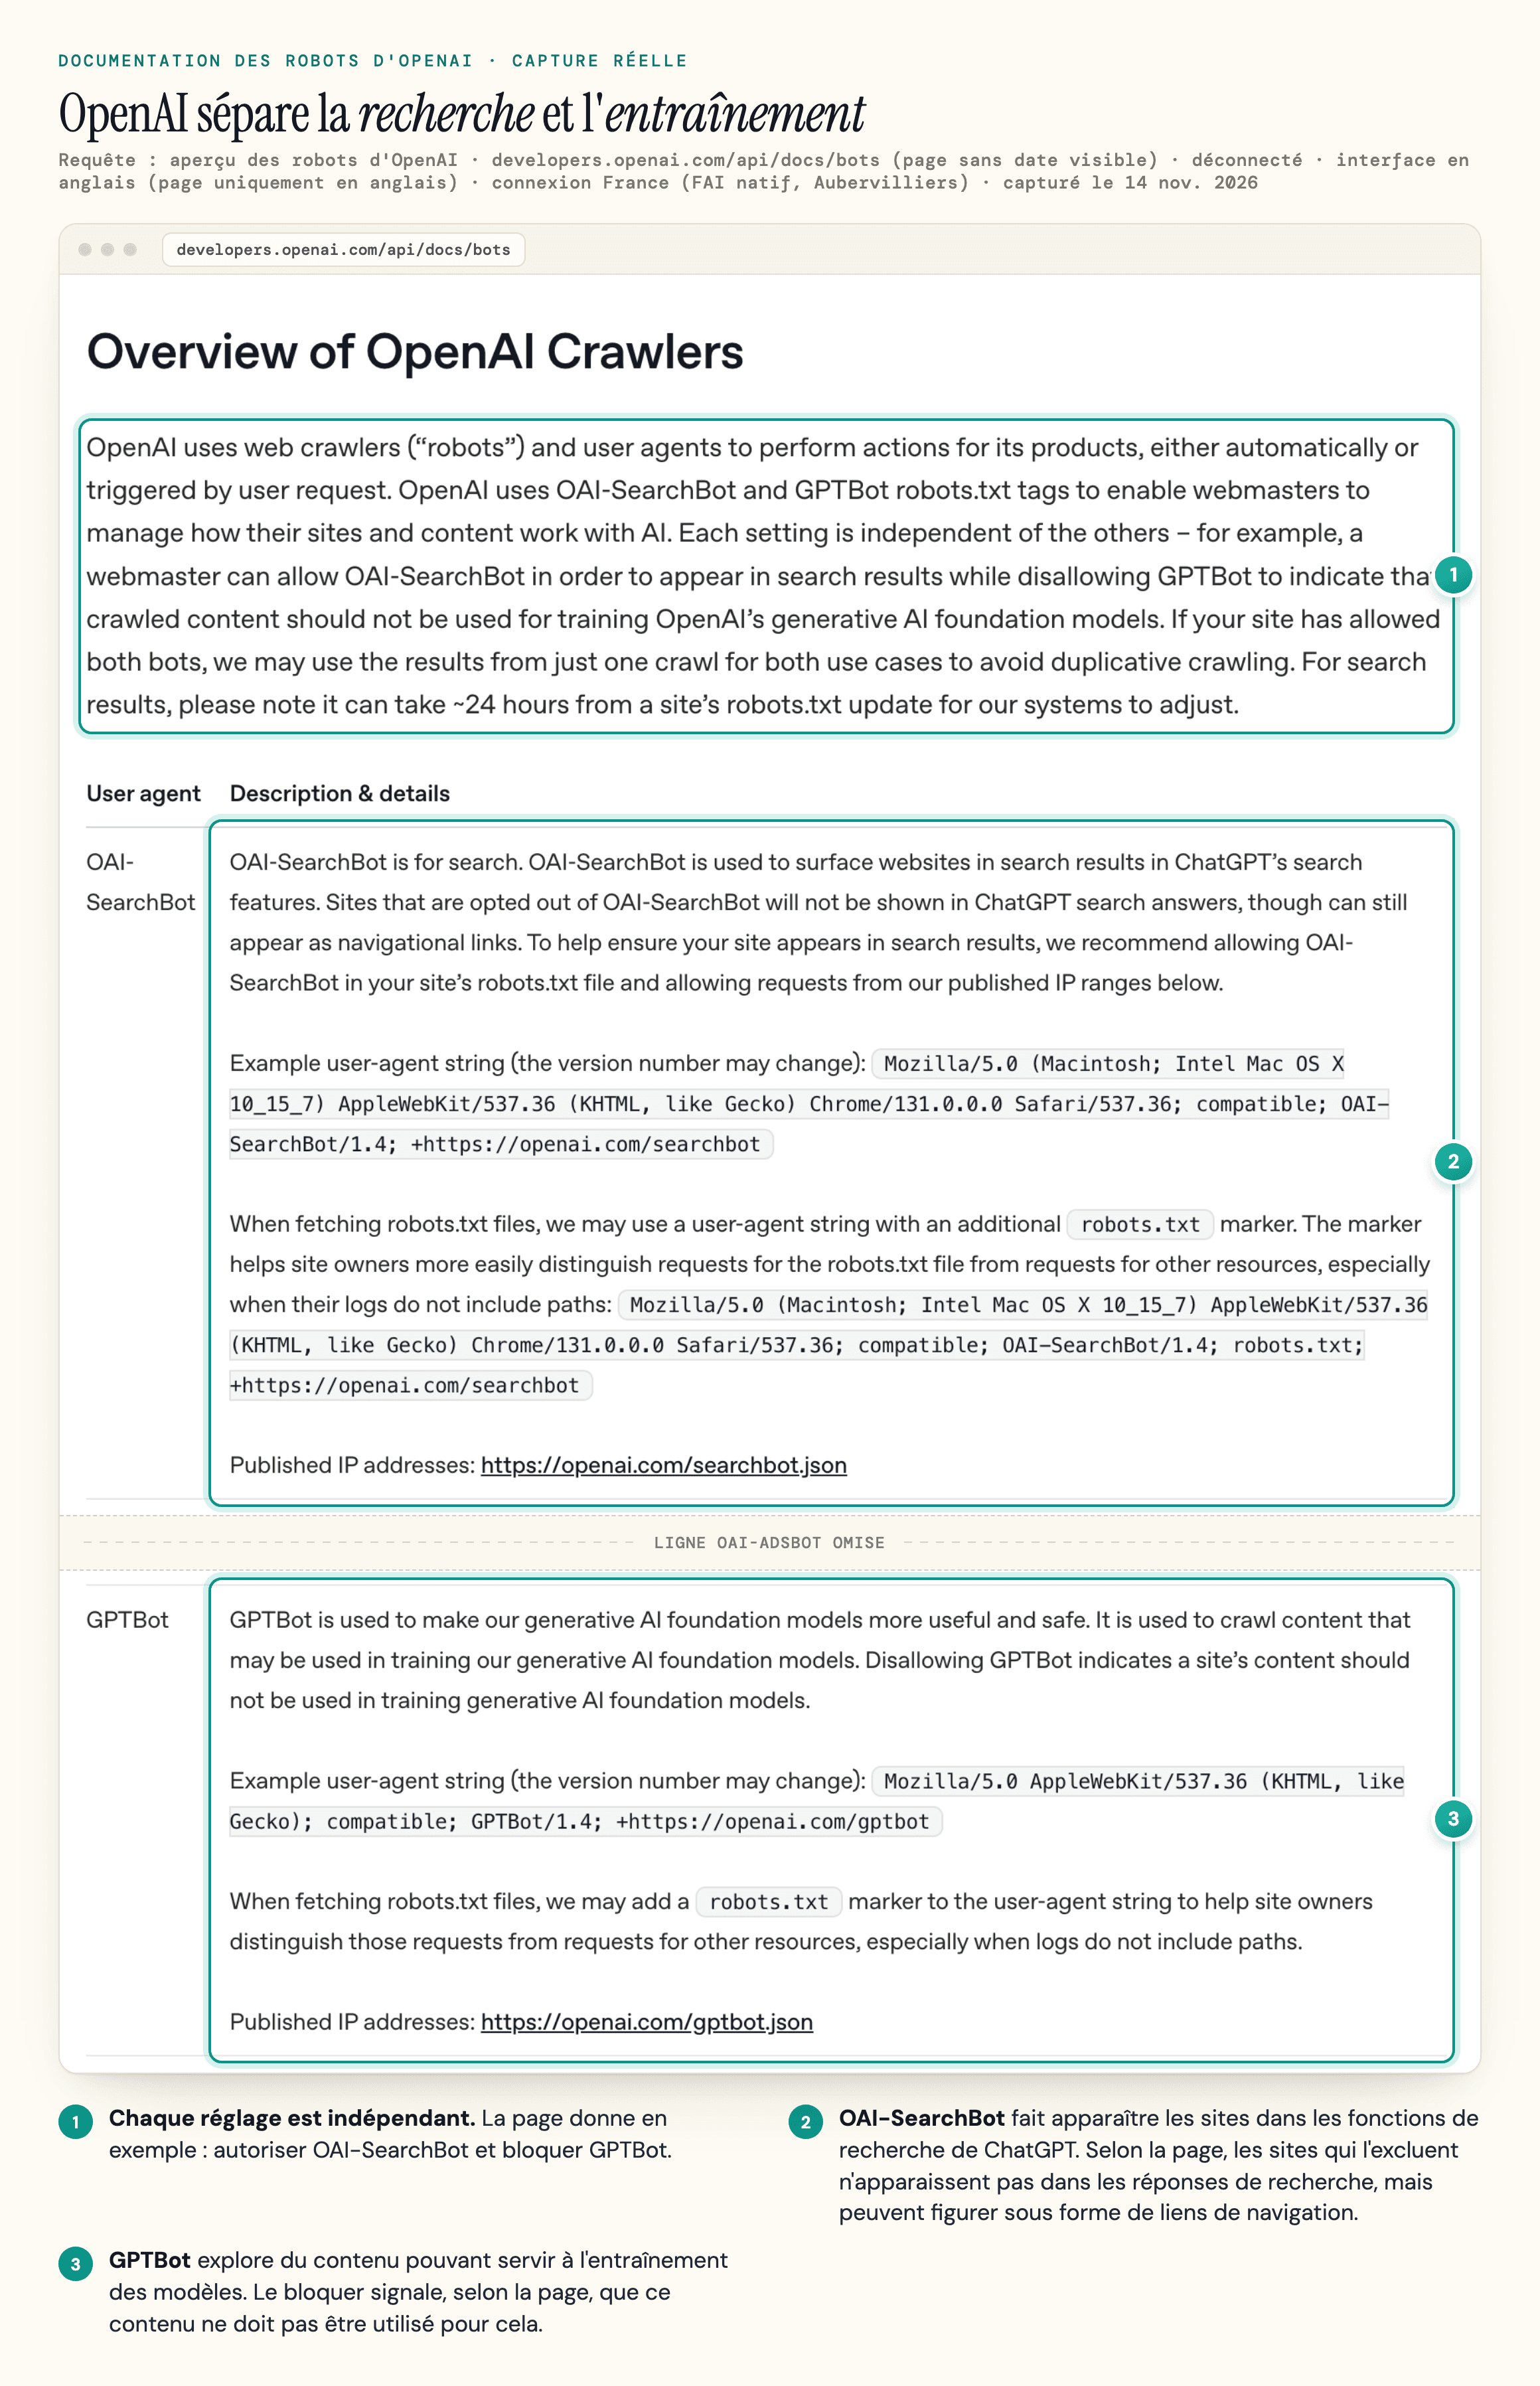
D’après la page d’OpenAI sur ses robots, les sites qui excluent OAI-SearchBot n’apparaissent plus dans les réponses de recherche de ChatGPT, mais peuvent encore figurer sous forme de liens de navigation. La page de Google sur ses robots courants le dit clairement : « Google-Extended n’a aucune incidence sur l’inclusion d’un site dans la recherche Google ».
Pour les Aperçus IA, les leviers sont la famille nosnippet et le réglage « IA générative dans la Recherche », désormais ouvert à tous les sites. L’exclusion prend en général quelques jours : selon Google, « le contenu sera exclu un à deux jours après le déploiement du paramètre », et une partie peut rester visible plus longtemps à cause de la mise en cache.
Un fichier que vous pouvez ignorer pour Google : son guide d’optimisation pour l’IA indique que les fichiers llms.txt n’aident ni ne nuisent à la visibilité dans la recherche Google. Pour les autres moteurs, consultez notre analyse du llms.txt ; pour les étapes du retrait, notre guide comment désactiver les Aperçus IA.
Un signal commun contre l’entraînement
Un tel signal se met en place. D’après la page d’Anthropic sur ses robots, l’entreprise a commencé, au 30 octobre 2026, à reconnaître un signal lisible par machine qui permet aux propriétaires de sites de dire s’ils acceptent que leur contenu serve à entraîner des modèles d’IA ; ce signal suit un projet de norme issu du groupe de travail aipref de l’IETF. Côté Google, la page sur les robots courants annonce que « Google prévoit de prendre en charge le signal de préférence d’entraînement partagé lisible par machine AIPREF (avec "user-agent: __usage_ai-training") début 2027 ».
En France, ce signal technique rencontre le droit. L'article L. 122-5-3 du Code de la propriété intellectuelle, en vigueur depuis le 26 novembre 2021, permet de s’opposer à la fouille de textes et de données « de manière appropriée, notamment par des procédés lisibles par machine » pour les contenus en ligne, et l'article R. 122-28, issu du décret du 23 juin 2022 et en vigueur depuis le 25 juin 2022, précise que cette opposition peut être exprimée « par tout moyen », métadonnées et conditions générales d’utilisation comprises. Aucun des deux textes ne cite le robots.txt. Un rapport de mission présenté au CSPLA en décembre 2024 estime que ce protocole « ne saurait être l’unique système accepté » par les fournisseurs d’IA ; de leur côté, les signataires du code de bonnes pratiques européen sur l’IA à usage général (10 juillet 2025) s’engagent à utiliser des robots qui respectent le robots.txt. Concrètement : une mention datée dans vos CGU, et des groupes robots.txt par usage, que les robots peuvent lire.
Une checklist de SEO technique courte
Ces bonnes pratiques de SEO technique s’appuient les unes sur les autres. Une page impossible à récupérer ne gagne rien à un balisage schema : les premiers points comptent le plus.
- Accès : les URL importantes renvoient un code 200, le robots.txt autorise les robots voulus et votre CDN ne les bloque pas
- Rendu : le texte principal et les liens figurent dans le HTML brut (le test du code source)
- Indexation : aucun noindex égaré, une URL canonique par page, un sitemap limité aux URL canoniques, soumis dans la Search Console ou déclaré dans le robots.txt
- Architecture : chaque page importante est reliée par un chemin de liens internes explorable ; les URL déplacées ou supprimées redirigent de façon permanente (301) vers un vrai remplaçant, ou renvoient 404 ou 410 s’il n’y en a pas
- Expérience de page : l’évaluation des Core Web Vitals est réussie sur les données terrain mobiles, et le site est servi en HTTPS
- Données structurées : un JSON-LD valide et conforme à la page visible ; hreflang relie chaque version linguistique à elle-même et à toutes les autres
- Contrôles IA : chaque groupe du robots.txt, chaque réglage d’extrait et chaque réglage de la Search Console est choisi en connaissance de cause
- Mesure : le rapport sur les performances dans l’IA générative de la Google Search Console, le rapport AI Performance de Bing et les logs serveur filtrés par user-agent
Commencez par le point 1. Collez votre domaine dans l’AI Crawler Checker gratuit de geotoolbox pour voir quels robots IA votre robots.txt bloque sur le chemin de la page d’accueil, puis lancez le scan Agent Readiness pour voir ce que votre pare-feu leur renvoie.
Mesurer les robots IA et les citations
N’importe qui peut usurper un user-agent : dans vos logs, vérifiez les robots IA déclarés en les comparant aux listes d’adresses IP qu’OpenAI, Anthropic et Perplexity publient pour leurs robots. Côté Google, le guide d’optimisation pour l’IA renvoie au « Rapport sur les performances dans l’IA générative » de la Google Search Console.
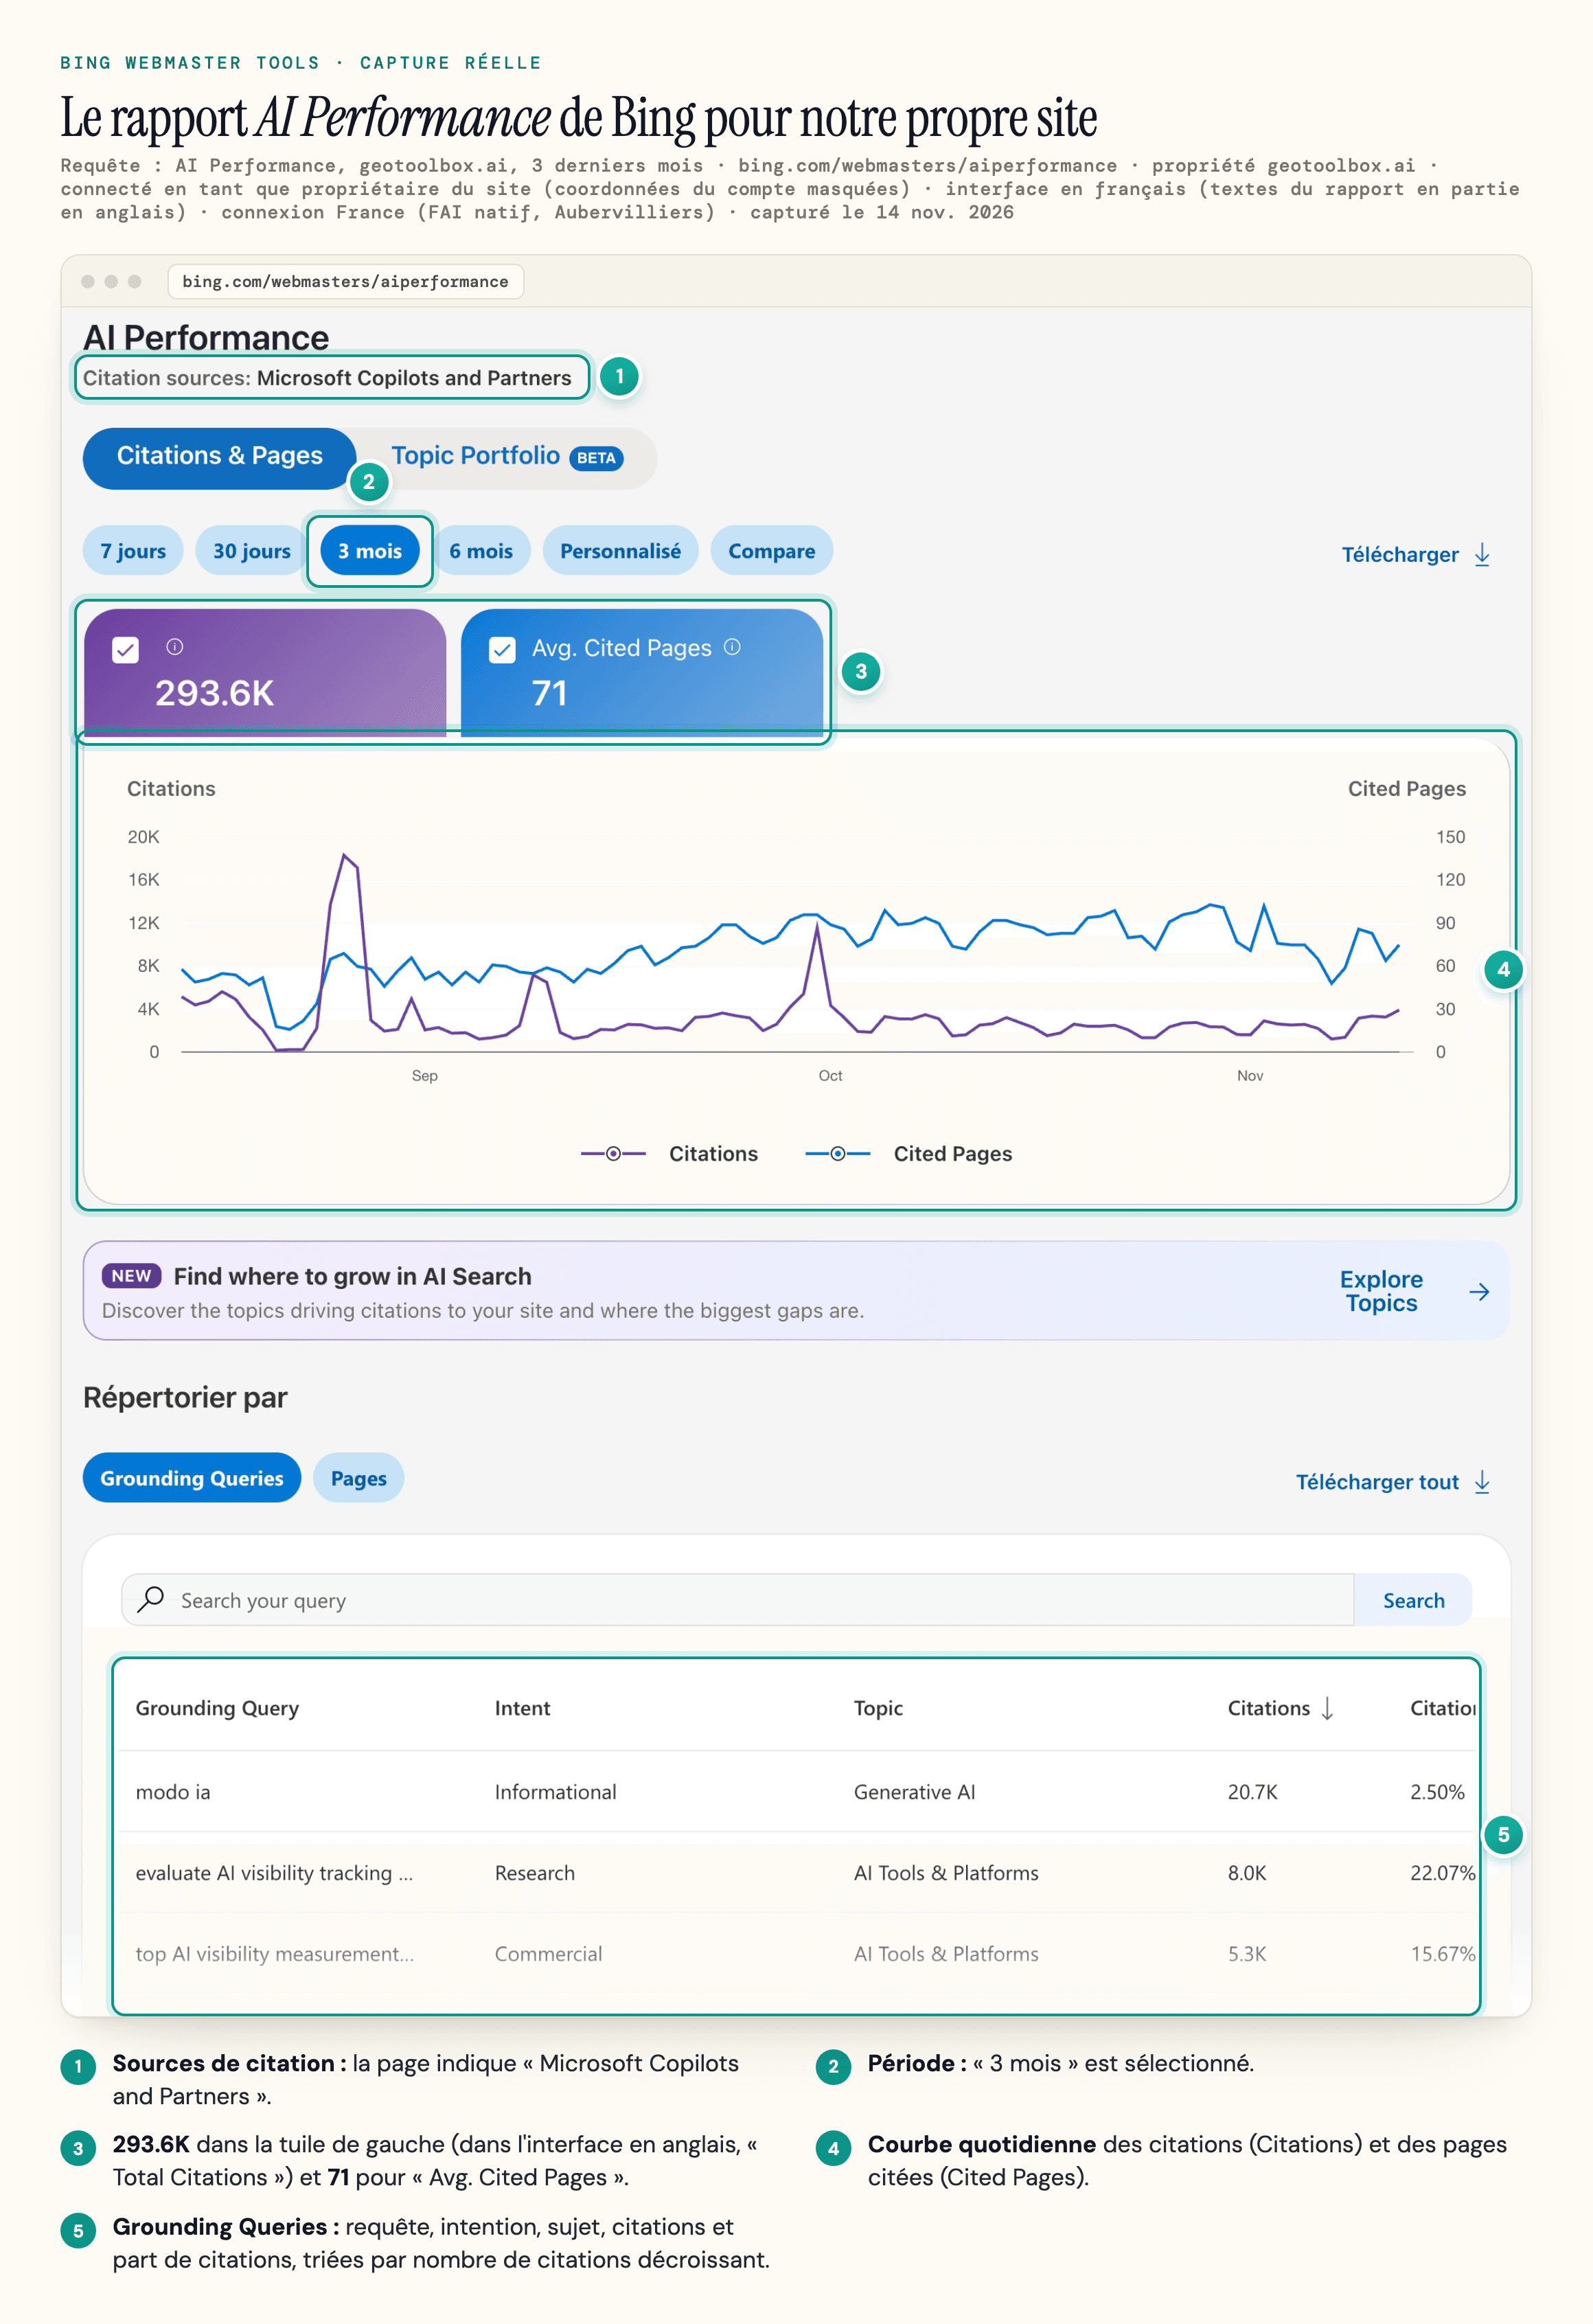
Le rapport AI Performance de Bing montre quelles pages de votre site Copilot et les résumés IA de Bing citent, ainsi que les requêtes d’ancrage qui les déclenchent. Il compte les citations et ne dit rien des clics.
Foire aux questions
Faut-il savoir coder pour faire du SEO technique ?
Non, mais il faut savoir lire du code. L’essentiel du travail relève du diagnostic : lire un robots.txt, des codes de statut, le code source d’une page et les rapports de la Search Console. Les corrections comme le rendu côté serveur ou les règles de redirection reviennent le plus souvent à un développeur.
Le SEO technique compte-t-il encore avec la recherche IA ?
Oui, et sans doute davantage. Copilot s’appuie sur l’index de Bing, et les robots IA qui lisent le HTML brut sont moins tolérants que Googlebot. Une page qu’ils ne peuvent pas récupérer, ou pas lire, ne peut pas être citée.
Qu’est-ce que la règle des 80/20 en SEO technique ?
L’essentiel de l’impact vient de quelques vérifications : les pages importantes peuvent-elles être explorées, rendues et indexées ? Réglez l’accès, la présence du contenu dans le HTML brut et les signaux d’indexation avant de passer du temps sur des scores comme le score de performance de Lighthouse ou sur des avertissements mineurs du validateur.
ChatGPT peut-il faire du SEO technique ?
Il peut expliquer une erreur, rédiger des règles de robots.txt, des redirections ou du JSON-LD, et résumer un export de crawl que vous lui collez. Il ne voit ni vos logs serveur, ni vos données de la Search Console, ni ce que chaque robot a réellement reçu : vérifiez ses suggestions à l’aune de ces données avant de mettre un changement en ligne.
Sources
- Google Search Central - Exigences techniques liées à la recherche Google (mis à jour le 18 décembre 2025) -
developers.google.com/search/docs/essentials/technical?hl=fr - Google Search Central - Fonctionnalités d’IA et votre site Web (mis à jour le 31 décembre 2025) -
developers.google.com/search/docs/appearance/ai-features?hl=fr - Google Search Central - Guide Google pour optimiser les fonctionnalités d’IA générative dans la recherche Google (mis à jour le 13 juillet 2026) -
developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=fr - Aide Search Console - Contrôle de l’IA générative dans la Recherche (consulté le 14 novembre 2026) -
support.google.com/webmasters/answer/16908024?hl=fr - Google France - Lancement des Aperçus IA et du Mode IA dans la Recherche Google en France (22 juillet 2026) -
blog.google/intl/fr-fr/nouveautes-produits/explorez-obtenez-des-reponses/recherche-ia-apercus-mode - Infrastructure d’exploration de Google - Robots d’exploration courants de Google, Google-Extended (mis à jour le 4 novembre 2026) -
developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers?hl=fr - Infrastructure d’exploration de Google - Récupérateurs déclenchés par l’utilisateur (mis à jour le 18 septembre 2026) -
developers.google.com/crawling/docs/crawlers-fetchers/google-user-triggered-fetchers?hl=fr - Google Search Central - Spécifications des balises Meta pour les robots (mis à jour le 26 mars 2026) -
developers.google.com/search/docs/crawling-indexing/robots-meta-tag?hl=fr - Google Search Central - Comprendre les bases du SEO JavaScript (mis à jour le 10 novembre 2026) -
developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics?hl=fr - Google Search Central - Présentation du fichier robots.txt (mis à jour le 18 décembre 2025) -
developers.google.com/search/docs/crawling-indexing/robots/intro?hl=fr - Infrastructure d’exploration de Google - Comment Google interprète la spécification robots.txt (mis à jour le 27 octobre 2026) -
developers.google.com/crawling/docs/robots-txt/robots-txt-spec?hl=fr - Infrastructure d’exploration de Google - Gestion du budget d’exploration (mis à jour le 16 septembre 2026) -
developers.google.com/crawling/docs/crawl-budget?hl=fr - Infrastructure d’exploration de Google - Gérer l’exploration des URL de navigation à facettes (mis à jour le 6 mars 2026) -
developers.google.com/crawling/docs/faceted-navigation?hl=fr - Google Search Central - Qu’est-ce qu’un sitemap ? (mis à jour le 18 décembre 2025) -
developers.google.com/search/docs/crawling-indexing/sitemaps/overview?hl=fr - Google Search Central - Créer et envoyer un sitemap (mis à jour le 15 juillet 2026) -
developers.google.com/search/docs/crawling-indexing/sitemaps/build-sitemap?hl=fr - Google Search Central - Bonnes pratiques de pagination pour Google (mis à jour le 18 décembre 2025) -
developers.google.com/search/docs/specialty/ecommerce/pagination-and-incremental-page-loading?hl=fr - Google Search Central - Redirections et recherche Google (mis à jour le 5 mai 2026) -
developers.google.com/search/docs/crawling-indexing/301-redirects?hl=fr - Google Search Central - Versions localisées de vos pages (mis à jour le 24 septembre 2026) -
developers.google.com/search/docs/specialty/international/localized-versions?hl=fr - Google Search Central - Indexation orientée mobile : bonnes pratiques (mis à jour le 20 février 2026) -
developers.google.com/search/docs/crawling-indexing/mobile/mobile-sites-mobile-first-indexing?hl=fr - Google Search Central - Comprendre les métriques Core Web Vitals et les résultats de recherche Google (mis à jour le 18 décembre 2025) -
developers.google.com/search/docs/appearance/core-web-vitals?hl=fr - Aide Search Console - Rapport sur l’indexation des pages (consulté le 14 novembre 2026) -
support.google.com/webmasters/answer/7440203?hl=fr - Aide Search Console - Outil d’inspection d’URL (consulté le 14 novembre 2026) -
support.google.com/webmasters/answer/9012289?hl=fr - web.dev - Web Vitals (mis à jour le 31 octobre 2024) -
web.dev/articles/vitals - web.dev - Interaction to Next Paint (INP) (mis à jour le 2 septembre 2025) -
web.dev/articles/inp - web.dev - Optimize Largest Contentful Paint (mis à jour le 31 mars 2025) -
web.dev/articles/optimize-lcp - web.dev - Optimize Interaction to Next Paint (mis à jour le 2 septembre 2025) -
web.dev/articles/optimize-inp - IETF - RFC 9309, Robots Exclusion Protocol (septembre 2022) -
www.rfc-editor.org/rfc/rfc9309.html - OpenAI - Overview of OpenAI Crawlers (consulté le 14 novembre 2026) -
developers.openai.com/api/docs/bots - Anthropic - Anthropic explore-t-il les données du web et comment les propriétaires de sites peuvent-ils bloquer l’explorateur ? (mis à jour le 4 novembre 2026) -
support.claude.com/fr/articles/8896518 - Perplexity - Perplexity Crawlers (mis à jour le 12 novembre 2026) -
docs.perplexity.ai/docs/resources/perplexity-crawlers - Mistral AI - Mistral crawlers (consulté le 14 novembre 2026) -
docs.mistral.ai/robots - Microsoft Bing - Bing Webmaster Guidelines (consulté le 14 novembre 2026) -
www.bing.com/webmasters/help/webmaster-guidelines-30fba23a - Microsoft Bing - AI Performance in Bing Webmaster Tools (consulté le 14 novembre 2026) -
www.bing.com/webmasters/help/ai-performance-9f8e7d6c - Vercel - The rise of the AI crawler (17 décembre 2024) -
vercel.com/blog/the-rise-of-the-ai-crawler - Genezio - OpenAI’s Search Crawler Runs JavaScript (22 octobre 2026) -
genezio.com/research/openai-crawler-runs-javascript - JS SEO Lab - JavaScript execution has two depths, and bots split cleanly between them (mis à jour le 25 octobre 2026) -
jsseo.dev/findings/javascript-execution-has-two-depths - searchVIU - Schema markup and AI put to the test (mis à jour le 15 octobre 2026 ; test mené le 30 octobre 2025) -
www.searchviu.com/en/guides/schema-markup-ai - Forge - Can AI crawlers run JavaScript? What ChatGPT-User really sees on your page (24 septembre 2026) -
www.forgeaibotlog.com/articles/can-ai-crawlers-execute-javascript - Ahrefs - We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved. (11 mai 2026) -
ahrefs.com/blog/schema-ai-citations - Cloudflare - Cloudflare just changed how AI crawlers scrape the Internet-at-large (communiqué, 1er juillet 2025) -
www.cloudflare.com/press/press-releases/2025/cloudflare-just-changed-how-ai-crawlers-scrape-the-internet-at-large - Cloudflare - Bénéficiez du meilleur des deux mondes : préservez votre référencement tout en refusant l’entraînement des IA (15 septembre 2026) -
blog.cloudflare.com/fr-fr/accountable-mixed-use-ai-crawlers - Légifrance - Code de la propriété intellectuelle, article L. 122-5-3 (version en vigueur depuis le 26 novembre 2021) -
www.legifrance.gouv.fr/codes/article_lc/LEGIARTI000044363192 - Légifrance - Code de la propriété intellectuelle, article R. 122-28 (version en vigueur depuis le 25 juin 2022) -
www.legifrance.gouv.fr/codes/article_lc/LEGIARTI000045960687 - CSPLA (ministère de la Culture) - Rapport de mission relative à la mise en œuvre du règlement européen établissant des règles harmonisées sur l’intelligence artificielle (« template »), présenté au CSPLA (décembre 2024) -
www.culture.gouv.fr/Media/medias-creation-rapide/cspla_rapport_ia_template_dec_.2024.pdf - Commission européenne - Code de bonnes pratiques pour l’IA à usage général (10 juillet 2025) -
digital-strategy.ec.europa.eu/en/policies/contents-code-gpai