
JavaScript SEO hat heute ein zweites Publikum. Der Googlebot rendert deine Skripte, wenn auch mit Grenzen, die du kennen solltest. ChatGPT-User, Claude-User und PerplexityBot riefen in den Logs, die wir gefunden haben, keine Skripte ab. So kann eine Seite, deren Text erst entsteht, wenn ein Skript läuft, bei Google ranken und für diese drei Bots trotzdem leer aussehen.
Die Beweislage ist zeitgebunden, uneinheitlich und in Bewegung: Bei OpenAIs Such-Crawler OAI-SearchBot zeigen inzwischen die Logs von drei Website-Betreibern, dass er JavaScript ausführt. Eines davon belegt es mit einem Endpunkt, den nur laufendes JavaScript aufrufen kann (Oktober 2026). Die günstigste Lösung bleibt in jedem Fall dieselbe: Bring den Text in die erste HTML-Antwort.
Das Wichtigste in Kürze
- JavaScript SEO sorgt dafür, dass Texte, Links und Tags aus Skripten gecrawlt, gerendert und indexiert werden, und inzwischen auch dafür, dass KI-Bots ohne Skriptausführung sie im HTML finden.
- Der Googlebot rendert JavaScript in einem Headless Chromium und ruft laut Googles Crawler-Beitrag vom März 2026 höchstens 2 MB pro URL ab, HTTP-Antwort-Header eingeschlossen; ein Render-Timeout nennen weder dieser Beitrag noch Googles JavaScript-Leitfaden.
- ChatGPT-User, Claude-User und PerplexityBot riefen in den unabhängigen Tests von 2026 keine Skripte ab; OAI-SearchBot führte 2026 auf einzelnen Websites JavaScript aus, in einem Log vom Oktober rund 30 Minuten nach dem HTML-Abruf.
- Als Link in Übersichten mit KI und im KI-Modus (engl. „AI Mode“) erscheint eine Seite nur, wenn sie indexiert und für ein Snippet geeignet ist. In Deutschland starteten beide 2025: die Übersicht mit KI im März, der KI-Modus am 8. Oktober.
- Seiten, die ranken oder zitiert werden sollen, brauchen Server-Side Rendering oder Static Site Generation; Client-Side Rendering reicht für Dashboards und Bereiche hinter dem Login.
Was JavaScript SEO 2026 bedeutet
JavaScript SEO ist der Teil des technischen SEO, der dafür sorgt, dass Texte, Links und Tags, die deine Skripte erzeugen, von Suchmaschinen gecrawlt, gerendert und indexiert werden können. Zehn Jahre lang lief das auf eine einzige Frage hinaus: Kann Google die Seite rendern? Heute kommt eine zweite dazu, denn ein Teil der Leser, die deine Seiten abrufen, führt überhaupt kein Skript aus.
Nimm eine Produktseite, auf der ein Skript Preis und technische Daten erst nach dem Laden einfügt. Google kann sie rendern und den Preis indexieren. ChatGPT sieht beim Abruf derselben URL unter Umständen nur eine leere Hülle und beschreibt die Seite dann ohne Preis. Warum das wichtig ist, erklärt unser Beitrag zur KI-Sichtbarkeit.
In der Bot-Tabelle weiter unten ist jede Zeile gekennzeichnet. Herstellerdoku heißt: Das Unternehmen sagt es selbst. Unabhängiger Test heißt: Jemand anderes hat es gemessen, mit Datum. Getestet markiert das Einzige, was wir selbst ausprobiert haben. Wo sich Quellen widersprechen, sagen wir das, statt uns für eine Seite zu entscheiden.
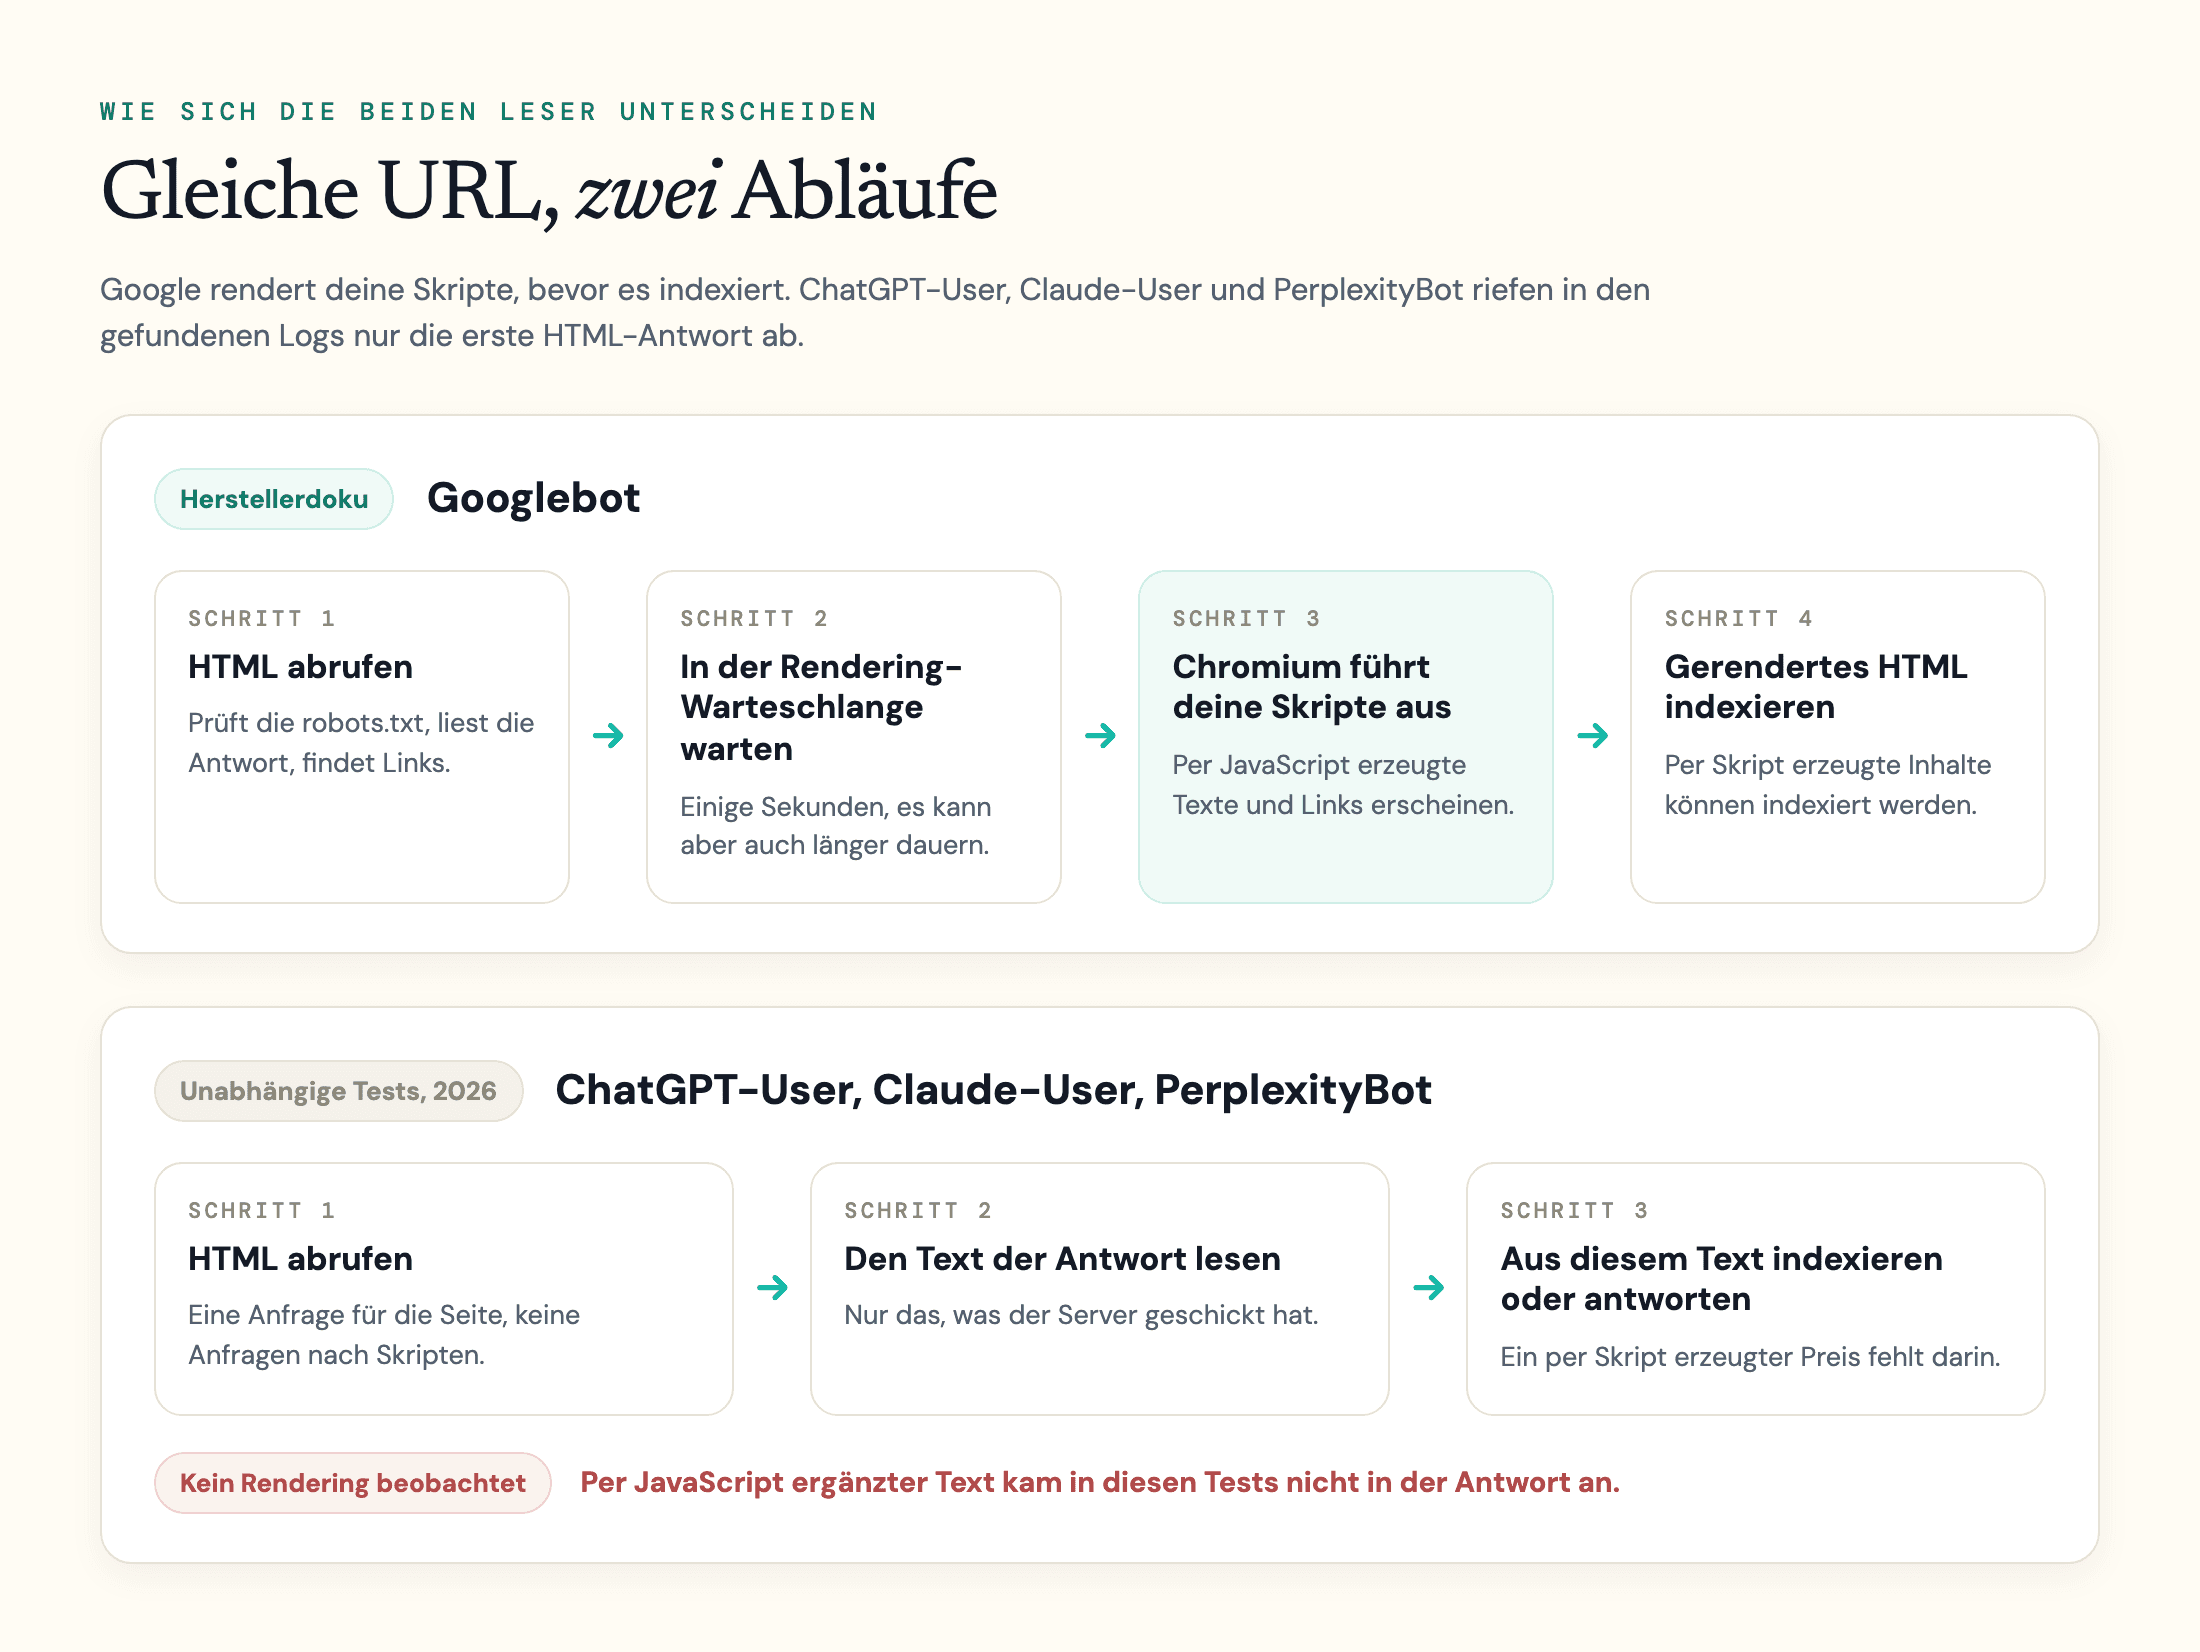
Wie Google JavaScript crawlt, rendert und indexiert
Suchmaschinen, die JavaScript rendern, arbeiten in einer festen Reihenfolge: Crawling, Rendering, Indexierung. Bei Google ruft der Googlebot die URL ab, liest das HTML und stellt die Seite in die Rendering-Warteschlange. Laut Googles Leitfaden zu JavaScript-SEO landen dort alle Seiten mit dem HTTP-Statuscode 200, es sei denn, ein robots-meta-Tag oder ein Header verbietet die Indexierung. Bei anderen Statuscodes, etwa einem 404, wird das Rendering womöglich übersprungen.
Eine Obergrenze für die Wartezeit nennt Google nicht. Im selben Leitfaden heißt es nur: „Die Seite verbleibt möglicherweise nur einige Sekunden in dieser Warteschlange, es kann jedoch auch länger dauern.“ Danach führt ein Headless Chromium (bei Google „monitorlose Variante von Chromium“) die Skripte aus, und Google liest im gerenderten HTML neue Links und den Inhalt für den Index.
Bevor du weiterliest: Öffne den Quelltext (view-source) deiner wichtigsten Seite und such nach einem Satz aus dem Fließtext. Fehlt er, betrifft dich der Rest dieses Artikels.
Die 2-MB-Grenze
Laut Googles Crawler-Beitrag vom März 2026 ruft der Googlebot von jeder einzelnen URL (außer PDFs) höchstens 2 MB ab, die HTTP-Antwort-Header eingeschlossen, und hört dann auf. Was hinter dieser Grenze liegt, wird weder abgerufen noch gerendert noch indexiert. Jedes Skript und jedes Stylesheet hat einen eigenen 2-MB-Zähler: Ein Bundle über 2 MB wird abgeschnitten, auch wenn das HTML winzig ist. Die 15 MB, die du vielleicht kennst, waren die Grenze aus Googles Beitrag von 2022. Der Beitrag von 2026 nennt für den Googlebot 2 MB; die 15 MB bleiben der Standard für andere Google-Crawler ohne eigene Grenze.
Kein veröffentlichtes Render-Timeout
Mit „einige Sekunden“ meint Google die Warteschlange, nicht die Zeit, die deine Skripte laufen dürfen. Weder der Leitfaden noch der Crawler-Beitrag nennt ein Render-Timeout. Die Faustregel „Google bricht nach 1 bis 5 Sekunden ab“, die unter SEOs kursiert, lässt sich auf keiner der beiden Seiten belegen. Für Nutzer zahlt sich Tempo ohnehin aus.
Rendering ohne Gedächtnis
Der Crawler-Beitrag sagt: Googles Rendering-Dienst löscht Local Storage und Sitzungsdaten zwischen den Anfragen. Inhalte, die von einem gespeicherten Wert abhängen, sieht der Googlebot möglicherweise nicht.
Servertempo und Crawling-Frequenz
Langsame Server kosten dich Crawling-Kapazität, noch bevor gerendert wird. Wenn dein Server Mühe hat, die Bytes auszuliefern, halten sich Googles Crawler laut Crawler-Beitrag automatisch zurück, und die Crawling-Frequenz sinkt. Der Rat dort: das HTML schlank halten und schweres CSS und JavaScript in externe Dateien auslagern. So bleibt das HTML zugleich unter der Grenze.
Dynamic Rendering ist eine Behelfslösung
Dynamic Rendering heißt: Suchmaschinen-Crawler bekommen eine vorgerenderte HTML-Fassung, Nutzer die clientseitige App. Google nennt es mittlerweile eine Behelfslösung und keine langfristige Lösung und empfiehlt stattdessen serverseitiges Rendering, statisches Rendering oder Hydration. Als Cloaking wertet der Googlebot Dynamic Rendering normalerweise nicht, solange die Inhalte ähnlich sind. Wer Crawlern völlig andere Inhalte ausliefert, riskiert genau das.
Einen Satz aus Googles Leitfaden solltest du dir merken: Serverseitiges Rendering oder Prerendering sei trotzdem eine sehr gute Option, „da deine Website dadurch für Nutzer und Crawler schneller wird und nicht alle Bots JavaScript ausführen können“.
Welche KI-Crawler führen JavaScript aus?
In den uns bekannten Logs holten ChatGPT-User, Claude-User und PerplexityBot das HTML, das dein Server schickt, und keine Skripte; ein Test legt allerdings nahe, dass per Skript geschriebene Inhalte Perplexity trotzdem erreichen können (siehe Tabelle). Die Suchmaschinen-Crawler Googlebot und Applebot rendern Seiten, Bingbot tut es selektiv. OpenAIs Such-Crawler OAI-SearchBot rendert mittlerweile auf einzelnen Websites, und mehrere Assistenten außerhalb der USA taten es im einzigen Test, der sie gemessen hat.
Unterscheide zuerst die Bot-Arten, denn sie verhalten sich nicht gleich. Trainings-Crawler sammeln Daten für Modelle, Such-Crawler bauen den Index auf, aus dem ein Assistent schöpft. Abruf-Bots (engl. „user fetcher“) laden eine URL in dem Moment, in dem ein Mensch danach fragt. Unsere Liste der KI-Crawler nennt jeden Bot und seine Aufgabe. Von einem Abruf-Bot wie ChatGPT-User hängt ab, ob ein in den Chat kopierter Link richtig gelesen wird.
| Bot | Aufgabe | Führt dein JavaScript aus? | Belege |
|---|---|---|---|
| Googlebot | Indexierung für die Suche | Ja | Herstellerdoku: Googles Crawler-Beitrag, März 2026. Damit eine Seite als unterstützender Link in Übersichten mit KI oder im KI-Modus erscheint, muss sie indexiert und für die Anzeige in der Google Suche mit einem Snippet geeignet sein (Google, Dezember 2025). In Deutschland startete die Übersicht mit KI im März 2025, der KI-Modus am 8. Oktober 2025 |
| Applebot | Apple-Suche | Ja | Herstellerdoku: Laut Apple kann Applebot Inhalte in einem Browser rendern. Unabhängiger Test: 3.133 Skriptabrufe bei 4.838 Seitenaufrufen (Forge, September 2026) |
| Bingbot | Bing-Index | Selektiv | Herstellerdoku: Laut Bing kann Bingbot JavaScript grundsätzlich rendern, aber nicht in großem Umfang; Bing empfiehlt Dynamic Rendering (Oktober 2018). Unabhängiger Test: Skriptabrufe bei etwa einem von 800 Seitenaufrufen (Forge, September 2026) |
| Gemini (URL in die App kopiert) | Abruf-Bot | Umstritten | Unabhängiger Test: nur rohes HTML bei Search Engine World (Juni 2026) und Forge (September 2026). searchVIU (Oktober 2025) sah Gemini einen per Skript geschriebenen Preis ausgeben. Laut Vercel (Dezember 2024) nutzt Geminis Crawler die Infrastruktur des Googlebots; das ist ein anderer Weg als eine kopierte URL |
| OAI-SearchBot | Such-Crawler von ChatGPT | Ja, auf einzelnen Websites, zeitversetzt | Unabhängiger Test: bis zum 24. September: 10 Skriptabrufe bei 1.738 Seitenanfragen, dabei eine Seite wie von einem Browser geladen (Forge). Logs von Website-Betreibern zeigen Rendering: Crawl Lab (20. bis 27. Juli 2026: 33,3 % der Anfragen mit dem Next.js-Parameter ?_rsc=), ein Bericht vom 30. September (ab 25. September) und Genezio (22. Oktober 2026), das aus OpenAIs IP-Bereichen einen Aufruf eines Endpunkts protokollierte, den nur ausgeführtes JavaScript erreicht. Die Auswertung eines Mitgründers zum selben Test (Log vom 8. bis 22. Oktober) setzt die Skriptabrufe, verteilt über viele IP-Adressen, im Median 32 Minuten nach dem HTML-Abruf an. Alle drei prüften die IPs gegen OpenAIs Listen. Der Beacon-Test von JS SEO Lab (80 Tage bis zum 6. August 2026) protokollierte dagegen keinen Beacon von OAI-SearchBot. OpenAI hat nichts angekündigt |
| GPTBot | Trainings-Crawler von OpenAI | Umstritten | Unabhängiger Test: bis zum 24. September: 37 Seitenanfragen, keine Skriptabrufe (Forge). Der Bericht vom 30. September meldet Rendering ab 25. September; Crawl Lab sah im Juli keine ?_rsc=-Anfragen von GPTBot, und im Oktober-Log eines Genezio-Mitgründers lud GPTBot Skripte und Stylesheets, ohne Beleg, dass sie liefen. JS SEO Lab protokollierte sieben Beacon-Aufrufe von GPTBot aus einem Inline-Skript, von zwei Adressen auf OpenAIs Liste, und keinen aus einer React-Komponente. Keine Ankündigung von OpenAI |
| ChatGPT-User | Abruf-Bot | Nein | Unabhängiger Test: 37.045 Seitenaufrufe, 0 Skriptabrufe (Forge). Der ChatGPT-Assistent gab in den Tests von Search Engine World und Forge den Wert aus dem HTML wieder, und Forge ordnete den Abruf ChatGPT-User zu |
| ClaudeBot und Claude-User | Trainings-Crawler und Abruf-Bot | Nein | Unabhängiger Test: Claude-User 10.028 Seitenaufrufe, ClaudeBot 915 Seitenanfragen, keine Skriptabrufe (Forge). Herstellerdoku, nur für das API-Tool: Laut Anthropic unterstützt sein Web-Fetch-Tool keine mit JavaScript gerenderten Websites |
| PerplexityBot | Such-Crawler von Perplexity | Nein laut Logs, ein Test widerspricht | Unabhängiger Test: 3.193 Seitenanfragen, 0 Skriptabrufe (Forge). searchVIU sah Perplexity nach der Indexierung einen per Skript geschriebenen Preis ausgeben; der Test zeigt nicht, wie der Inhalt in den Index kam |
| DeepSeek, Qwen, Kimi, ERNIE, Mistral | Abruf-Bot | Ja, in einem Test | Unabhängiger Test: Jeder nannte die Zahl, die nur ein Skript schreiben konnte, bei einem Prompt pro Assistent (Search Engine World, Juni 2026). Meta AI und Copilot nannten im selben Test den Wert aus dem HTML |
| Grok | Abruf-Bot | Ausgeführt, dann ignoriert | Unabhängiger Test: Das Skript lief auf einem Knoten, die Antwort zitierte aber den Wert aus dem HTML (Search Engine World) |
Wie viel Gewicht die Belege haben
Lies die „Nein“-Zeilen als Beobachtungen, nicht als Ankündigungen. Die Crawler-Seiten von OpenAI und Perplexity sagen zu JavaScript (Stand: 9. November 2026) nichts, weder in die eine noch in die andere Richtung, und Anthropics Aussage betrifft sein API-Tool, nicht ClaudeBot.
Die Tests haben ihre Grenzen. Search Engine World ist eine SEO-Publikation, Forge entwickelt ein Plugin für Bot-Logs, searchVIU verkauft SEO-Monitoring, Vercel ist ein Hosting-Anbieter, Genezio verkauft Analysen zur KI-Sichtbarkeit, und Crawl Lab bietet einen kostenlosen Log-Analyzer an. Wir verkaufen selbst eine verwandte Prüfung (den Content Analyzer, siehe unten); gewichte unsere Lesart entsprechend. Jeder Test ist zudem eine Momentaufnahme: eine Website, einmal pro Assistent abgefragt, das 30-Tage-Log einer Nachrichtenseite, eine frische Testseite. Forges Bot-Tabelle zählt Anfragen nach dem Namen im User-Agent, ohne sie mit den veröffentlichten IP-Bereichen abzugleichen. Wir selbst haben keinen dieser Bots getestet.
Die Aussage „KI-Crawler führen kein JavaScript aus“ geht auf eine Analyse von Vercel und MERJ vom Dezember 2024 zurück. Keiner der gemessenen Crawler von OpenAI, Anthropic, Meta, ByteDance oder Perplexity renderte dort JavaScript; Gemini nutzte die Infrastruktur des Googlebots, Applebot renderte über einen Browser. Heute ist das nicht mehr die einzige Studie, und die neueren bestätigen den Befund für ChatGPT und Claude, mit den Vorbehalten aus der Tabelle zu Perplexity, Gemini und OpenAIs Crawlern.
Andere Logs weisen allerdings in eine andere Richtung, zumindest bei OpenAIs Such-Crawler. Ein Entwickler sah auf seinen eigenen Next.js-Websites ab dem 25. September Prefetch-Anfragen von OAI-SearchBot und GPTBot, die nur entstehen, wenn eine Seite gerendert wird; Crawl Lab hatte dasselbe Muster bei OAI-SearchBot schon im Juli protokolliert. Den stärksten Beleg liefert Genezio im Oktober 2026: Ein Skript auf den eigenen Seiten rief einen Endpunkt auf, auf den kein Link zeigt, und genau diesen Aufruf löste OAI-SearchBot aus OpenAIs veröffentlichten IP-Bereichen aus. Die Auswertung eines Mitgründers zum selben Test datiert das Rendering auf rund eine halbe Stunde nach dem HTML-Abruf. Jede dieser Auswertungen stammt von den Servern eines einzelnen Website-Betreibers, und Genezio verkauft selbst Analysen zur KI-Sichtbarkeit. OpenAI hat dazu bis zum 9. November 2026 nichts angekündigt. Geh deshalb davon aus, dass OAI-SearchBot manche Seiten mit Verzögerung rendert, behandle GPTBot als offene Frage und teste selbst nach.
Vielleicht begegnet dir auch eine „69 Prozent“-Statistik zu KI-Crawlern, die kein JavaScript ausführen können. Laut Forge werden dafür nur Namen auf einer Liste von 23 Crawlern gezählt, gemessen wird nichts.
Ein konkretes Beispiel steht in Forges Log: In 30 Tagen las ChatGPT-User eine Seite mit tagesaktuellen Spritpreisen 157-mal, Claude-User 80-mal. Da ein Skript die Preise erst nachträglich einfügte, kam bei keinem dieser 237 Abrufe ein einziger Preis an.
Ein Skript abzurufen beweist noch nicht, dass es läuft. Laut Vercels Daten entfielen bei ChatGPTs Crawlern 11,50 % der Anfragen auf Skriptdateien, bei Claudes Crawlern 23,84 %, ausgeführt wurden sie nie. Ein Monat ohne einen einzigen Skriptabruf passt zu „keine Ausführung“, doch Caching oder ein separater Rendering-Dienst können Abrufe verbergen. Mehr Gewicht haben daher Tests mit einem Marker, den nur ein Skript setzen kann.
Browser-Agenten sind ein Sonderfall
Laut Forge führen Agenten, die einen echten Browser steuern, Skripte aus, etwa die von OpenAI, Claude in Chrome und Perplexitys Comet. Im Server-Log sieht ihr Besuch aus wie der eines Menschen mit Chrome. Wie du dich auf sie einstellst, erklärt unser Artikel zur agentenfähigen Website.
Am schwersten einzuordnen ist die Bingbot-Zeile. Bingbot rendert selektiv, und Microsofts letzte ausführliche Aussage, die wir gefunden haben, stammt vom Oktober 2018 und nennt keine Regel dafür, welche Seiten er rendert. Wenn du auf ChatGPT setzt, lies unseren Beitrag dazu, wie die ChatGPT-Suche funktioniert und aus welchem Index sie schöpft.
Unterm Strich: Google und Apple können deine Skripte ausführen, OpenAIs Such-Crawler auf manchen Websites mit Verzögerung. Bei ChatGPT-User, Claude-User und PerplexityBot zeigte kein Log eine Skriptausführung. Text, den nur ein Skript schreibt, kommt bei ihnen nicht verlässlich an.
So testest du, was ein Bot sieht
Vergleiche das HTML, das dein Server zurückgibt, mit dem DOM. Der DOM ist der Elementbaum, den der Browser aus diesem HTML erzeugt, und genau ihn verändern Skripte. Der Unterschied zwischen beiden ist das, was Bots ohne Rendering entgeht. In einem SEO-Audit reicht diese Prüfung einmal pro Seitenvorlage.
-
Rohes HTML abrufen. Ruf die Seite so ab, wie ein Bot es tut, und speichere die Antwort, ohne etwas auszuführen. Ein gefälschter User-Agent testet nur, wie dein eigener Server und deine Firewall reagieren. Dass der echte Bot durchkommt, beweist er nicht, und ein Abruf-Bot kann eine Kopie aus dem Cache bekommen. Ein sauberes Ergebnis ist damit nur eine Mindestbedingung, kein Beweis.
curl -s -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://example.com/seite > raw.html -
Den gerenderten DOM erfassen. Vergleiche in den Chrome DevTools die Quelltextansicht (das HTML, das dein Server geschickt hat) mit dem Tab „Elemente“ (dem aktuellen DOM). Für Googles Sicht rät der Leitfaden: „verwende den Test für Rich-Suchergebnisse oder das URL-Prüftool und sieh dir den gerenderten HTML-Code an“. Fehlt der Inhalt dort, kann Google ihn laut Leitfaden nicht indexieren.
-
Vergleichen, was zählt. Zieh zuerst die JSON-LD-Blöcke aus dem rohen HTML und entferne dann Skripte und Styles, bevor du Fließtext und Links zählst. Vergleiche anschließend Title, Canonical-Tag, robots-meta-Tag, H1, Links, JSON-LD und den Haupttext mit der gerenderten Fassung.
-
Die Firewall ausschließen. Ein 403 oder eine Challenge-Seite sieht in deinen Tools aus wie ein Rendering-Fehler, ist aber ein Problem bei der Auslieferung. Eine CDN- oder Firewall-Regel kann KI-Crawler abweisen, obwohl die robots.txt sie erlaubt, wie unser GPTBot-Leitfaden zeigt. Prüf die Statuscodes in deinen CDN-Logs, bevor du die App umbaust.
-
Die Server-Logs lesen. Ein rendernder Bot ruft meist erst die Seite ab, danach ihre Skripte und Stylesheets und löst Ajax- oder API-Aufrufe aus. Ein Abruf-Bot holt die Seite und geht. Nach genau diesem Unterschied hat Forge die Bots in der Tabelle oben sortiert, und dafür brauchst du kein Spezialwerkzeug. Manche Renderer kommen allerdings später wieder: In einem Log vom Oktober 2026 holte OAI-SearchBot die Skripte erst nach etwa 30 Minuten, von anderen IP-Adressen. Logs sind deshalb nur ein Indiz, zumal Caching oder Inline-Skripte ein Rendering verbergen können; ein eindeutiger Marker, den nur ein Skript schreiben kann, ist der stärkere Test. Gleiche die Anfragen mit den IP-Bereichen ab, die der Anbieter veröffentlicht, denn ein User-Agent allein beweist nichts.
Getestet am 4. Oktober 2026: Wir haben die Schritte 1 bis 3 an einer Produktseite durchgespielt, die auf drei Arten gebaut war, jeweils als Testseite auf einem lokalen Webserver. Die erste ist eine clientseitig gerenderte Hülle, die zweite serverseitig gerendertes HTML, die dritte serverseitig gerendertes HTML, dem ein Skript eine Zeile hinzufügt. Jede Zelle zeigt erst die rohe Antwort, dann den gerenderten DOM in Chromium.
| Was wir gemessen haben | Clientseitige Hülle | Serverseitig gerendert | Serverseitig plus Skript |
|---|---|---|---|
| Wörter im Fließtext | 0, dann 60 | 60, dann 60 | 60, dann 65 |
| Seitentitel | „Loading“, dann der Produkttitel | Produkttitel, dann derselbe | Produkttitel, dann derselbe |
| H1 im Markup | Keine, dann vorhanden | Vorhanden, dann vorhanden | Vorhanden, dann vorhanden |
| Canonical-Tag | Keins, dann vorhanden | Vorhanden, dann vorhanden | Vorhanden, dann vorhanden |
| JSON-LD-Block | Keiner, dann vorhanden | Vorhanden, dann vorhanden | Vorhanden, dann vorhanden |
Links in <a href>-Tags | 0, dann 1 (ein Klick-Handler ist kein Link) | 2, dann 2 | 2, dann 2 |
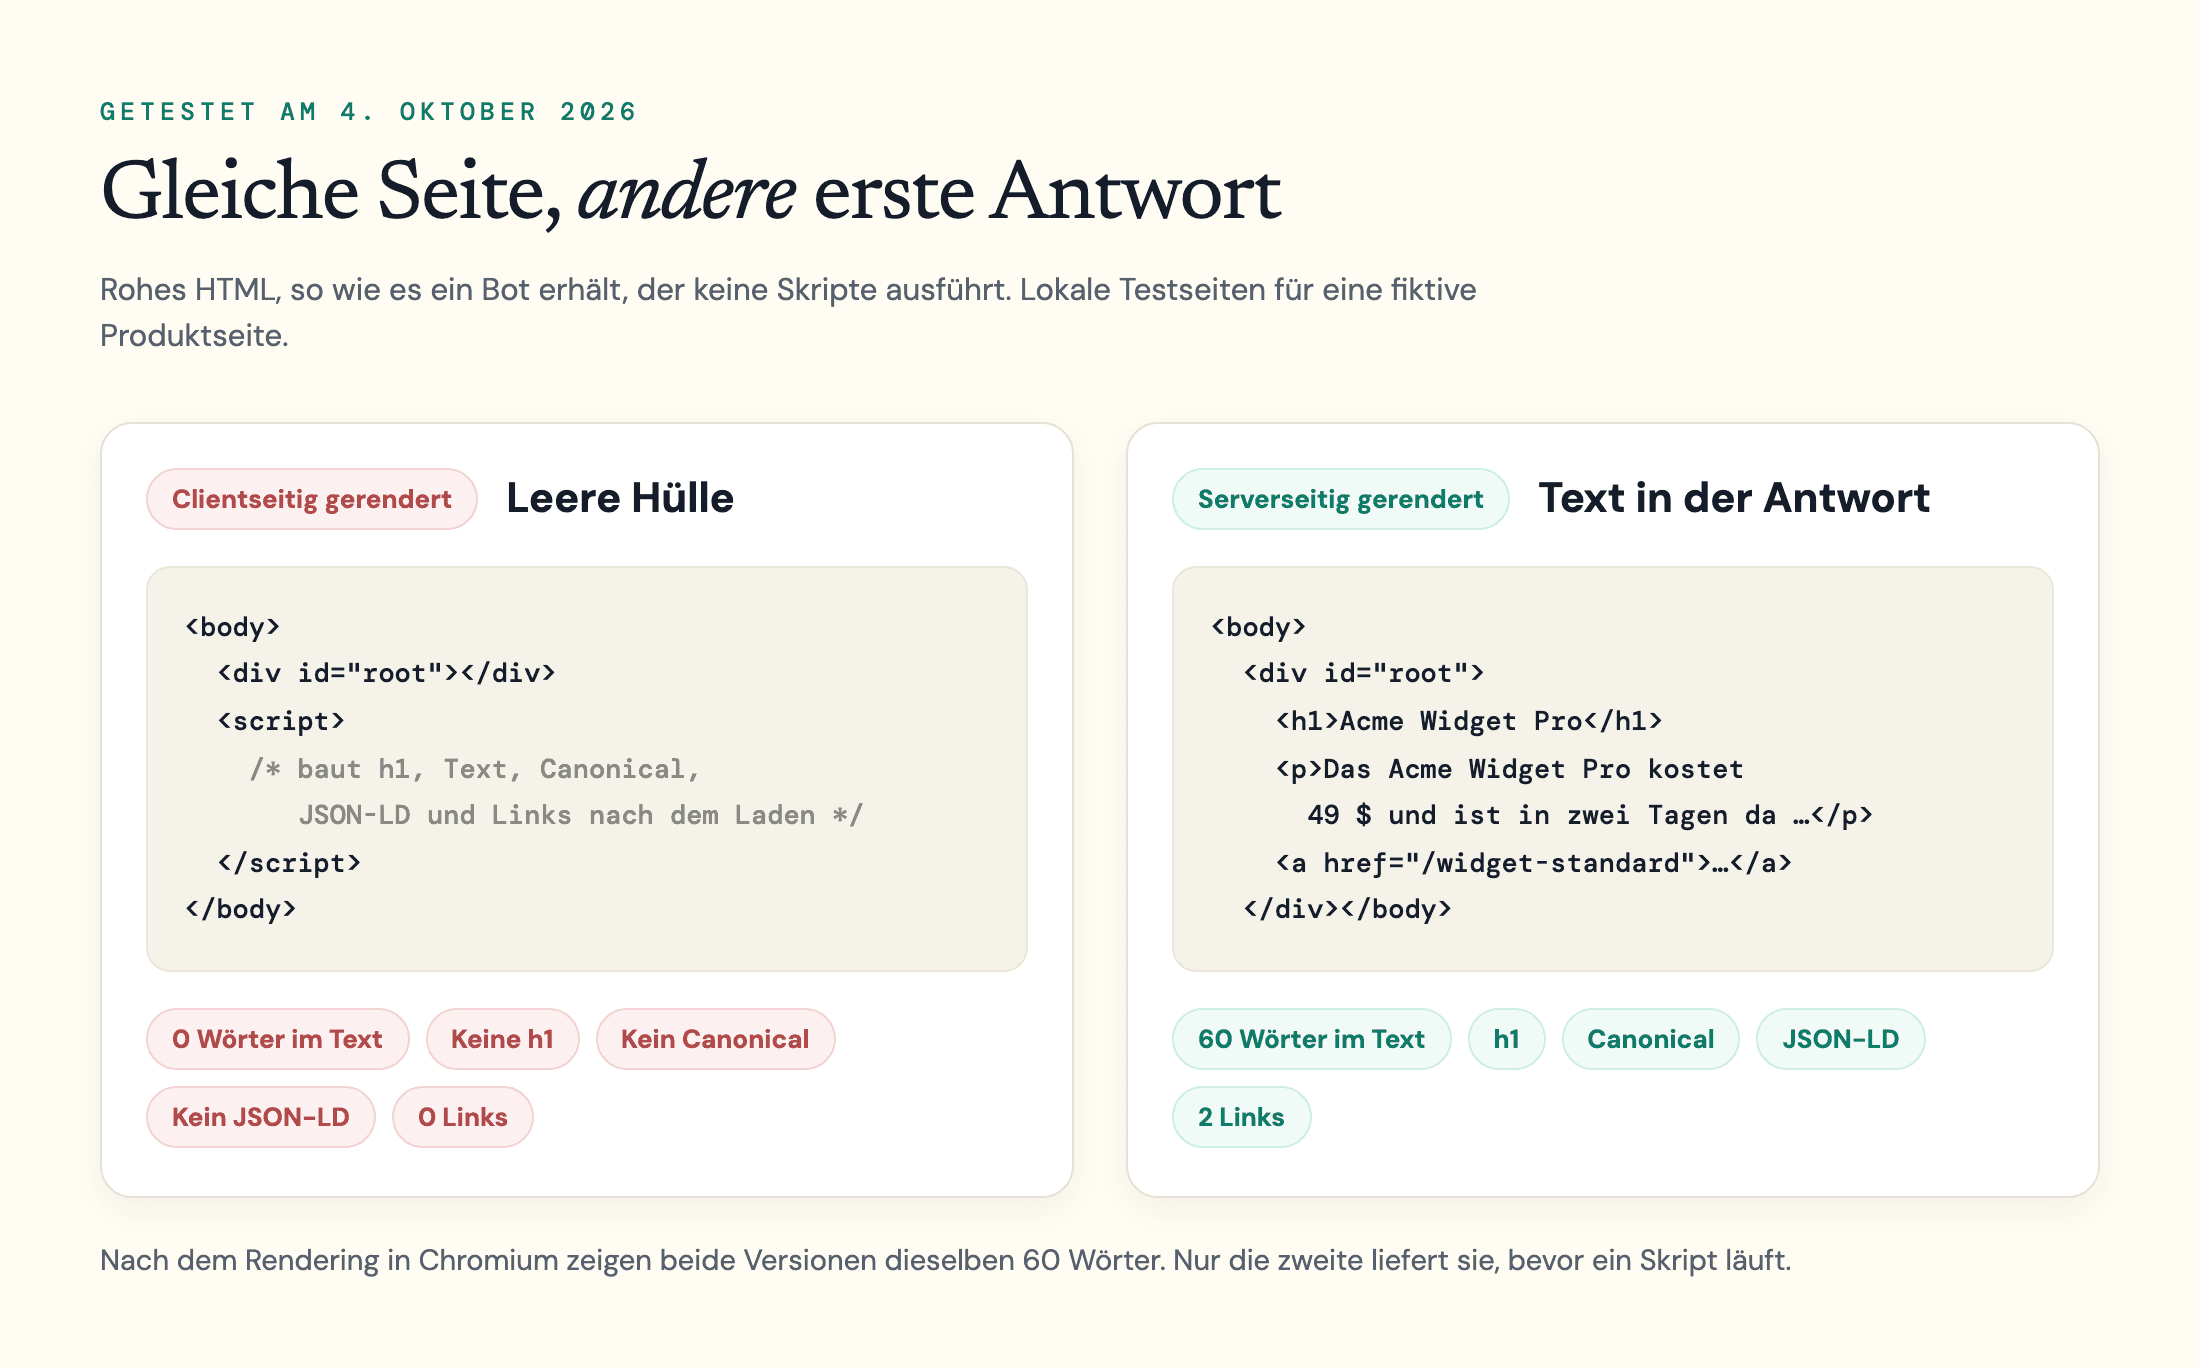
Getestet wird hier, was im HTML steht, also das, was ein Bot ohne Skriptausführung liest. Einen echten Crawler testet das nicht. Google könnte die gerenderte Fassung der Hülle indexieren, wenn es die veröffentlichte Seite abruft und rendert, während ein Abruf-Bot wie ChatGPT-User die leere Fassung bekäme.
Eine Prüfung führt in die Irre: Wer im rohen Quelltext der clientseitig gerenderten Seite nach <h1 sucht, findet einen Treffer, weil der Text des Skripts selbst das Tag enthält. Entferne die Skripte, bevor du zählst.
Der Content Analyzer von geotoolbox, enthalten in unseren kostenpflichtigen Abos, führt diesen Vergleich an einer Live-URL durch: Er rendert die Seite mit und ohne JavaScript und vergleicht die Wortzahlen, sodass eine Hülle wie unsere Testseite oben (0 gegen 60 Wörter) als Lücke auffällt. Außerdem prüft er den Zugriff mit den User-Agents der großen KI-Bots, mit derselben Einschränkung wie in Schritt 1. Der kostenlose Agent Readiness Scanner stellt Live-Anfragen mit mehreren User-Agents von KI-Crawlern, und der kostenlose AI Crawler Checker prüft nur die robots.txt-Ebene.
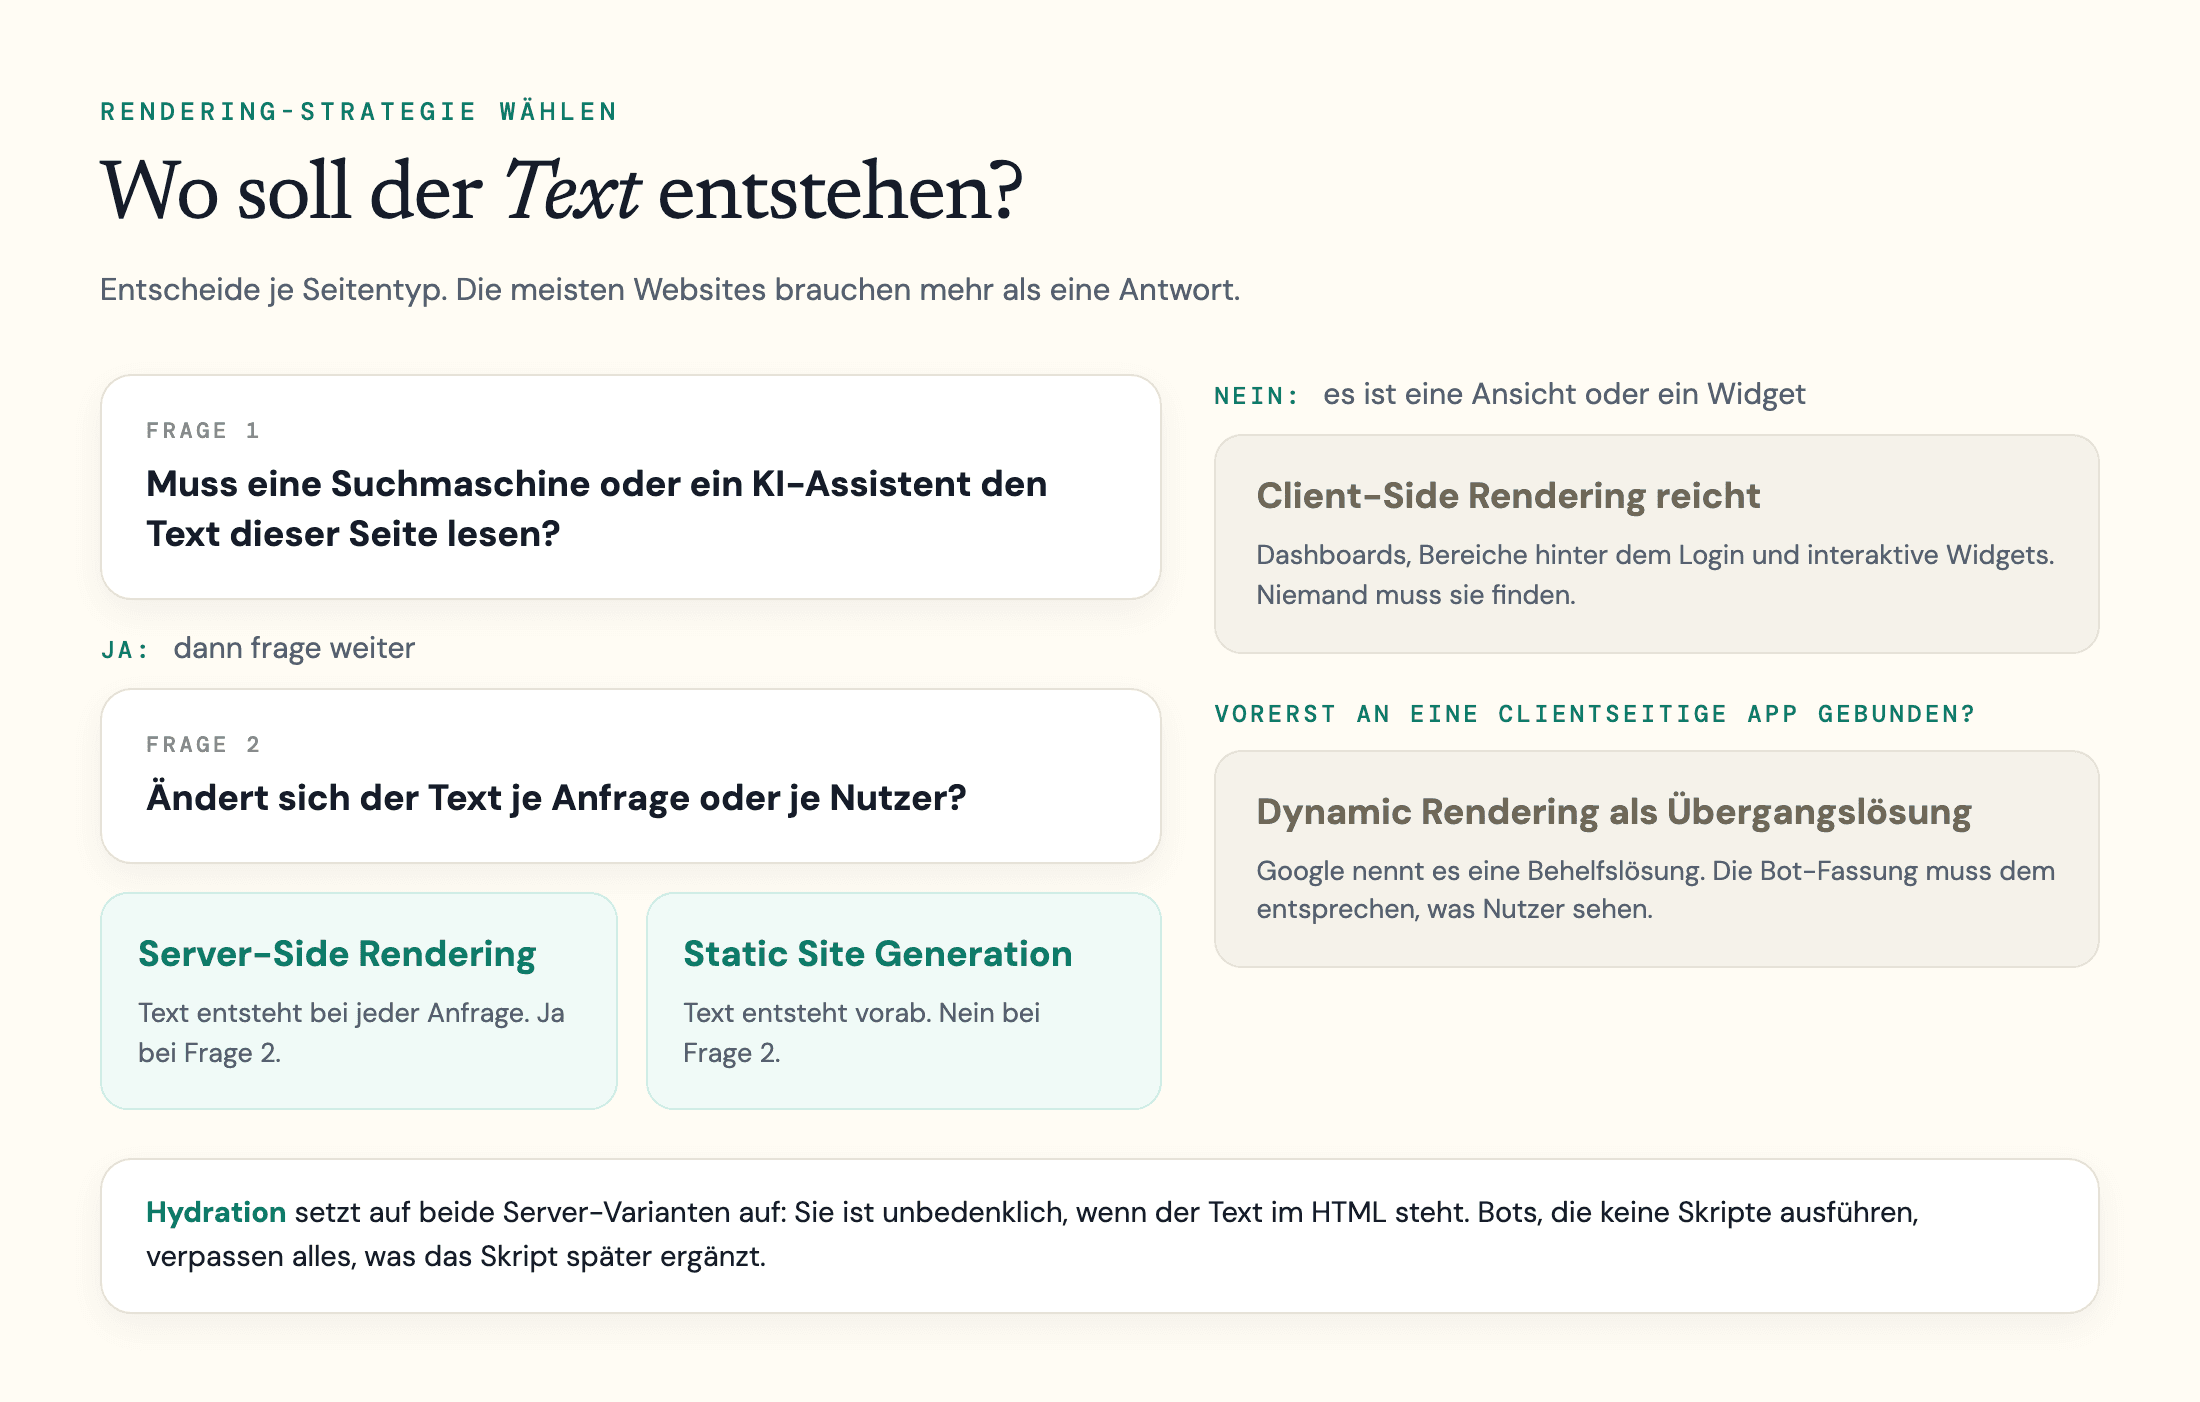
CSR, SSR, SSG und Prerendering: Welche Strategie passt?
Wo gerendert wird, entscheidest du danach, was die Seite leisten muss. Soll sie indexiert oder zitiert werden, gehört ihr Text in die erste HTML-Antwort.
| Strategie | Text in der ersten HTML-Antwort? | Abruf-Bots ohne Skriptausführung | Geeignet für | |
|---|---|---|---|---|
| Client-Side Rendering (CSR) | Nein, eine leere Hülle | Rendert sie nach der Warteschlange | Sehen eine leere Hülle | Bereiche hinter dem Login, Dashboards, Widgets |
| Server-Side Rendering (SSR) | Ja, bei jeder Anfrage erzeugt | Unproblematisch | Unproblematisch | Seiten, die sich je Anfrage ändern und ranken oder zitiert werden sollen |
| Static Site Generation (SSG) | Ja, vorab erzeugt | Unproblematisch | Unproblematisch | Artikel, Dokumentation und Produktseiten, die sich planmäßig ändern |
| SSR mit Hydration | Ja, danach macht ein Skript die Seite interaktiv | Unproblematisch | Sehen den Servertext; was das Skript ergänzt, entgeht ihnen | Interaktive Seiten, deren Kerntext im HTML steht |
| Dynamic Rendering | Nur für Bots | Funktioniert, Google nennt es aber eine Behelfslösung | Unproblematisch, wenn der Dienst sie bedient | Übergangslösung während einer Migration |
Hydration ist unbedenklich, wenn der Absatz, der die Suchanfrage beantwortet, schon im Server-HTML steht. Was Bots ohne Rendering entgeht, ist die Zeile, die ein Skript später ergänzt, etwa ein Lagerbestand oder ein Live-Preis. Daher stammen die fünf zusätzlichen Wörter unserer Testseite „serverseitig plus Skript“.
Dynamic Rendering bringt eine zusätzliche Pflicht mit: Die Bot-Fassung muss dem entsprechen, was Nutzer sehen. Googles Maßstab ist, ob die Inhalte ähnlich sind.
Die meisten JavaScript-Frameworks lassen dich das pro Route entscheiden. Behalte CSR für das Dashboard und nimm SSR oder SSG für jede Seite, die eine Suchmaschine oder ein Assistent lesen soll.
Häufige JavaScript-SEO-Fehler und wie du sie behebst
Diese Fehler bringen den Googlebot, die Abruf-Bots ohne Skriptausführung oder beide ins Stolpern, und jede Lösung ist zugleich eine Best Practice für JavaScript SEO.
Für einen Bot, der keine Skripte ausführt, zählt eine Korrektur erst, wenn das Ergebnis im Quelltext (view-source) steht. Statuscodes, Header und Firewall-Regeln brauchen eigene Prüfungen.
Links, die keine Links sind
Der Googlebot findet neue URLs im href-Attribut von HTML-Links. Laut Googles Leitfaden ist es in Ordnung, Links per JavaScript einzufügen, solange sie den Best Practices für crawlbare Links folgen. Ein Button mit onclick-Handler oder ein Router, der die Ansicht ohne echte URL austauscht, bietet Crawlern keinen Link, dem sie folgen können. Für clientseitiges Routing empfiehlt derselbe Leitfaden die History API, denn Fragmente können verhindern, dass der Googlebot deine URLs ausliest. Eine Sitemap, die jede echte URL aufführt, fängt Links auf, die ein Router versteckt; das Format erklärt unser Leitfaden zur XML-Sitemap.
Tags, die erst nach dem Rendering existieren
Google erlaubt es, Title, Meta-Description und Canonical per JavaScript zu setzen, nennt HTML aber den besten Ort für das Canonical: „Die kanonische URL lässt sich am besten mit HTML festlegen.“ Setzt das HTML bereits eines, darf ein Skript nur dieselbe URL wiederholen; lässt das HTML es weg, kann ein Skript es ergänzen, und die Seite sollte nur ein einziges rel=canonical tragen. Wie widersprüchliche Signale die Wahl der URL bei Google beeinflussen, erklärt unser Leitfaden zu Canonical-Tags. Ein Bot ohne Skriptausführung sieht die rohen Werte; bei unserer Hüllen-Testseite hieß das: Titel „Loading“, kein Canonical.
Bei noindex ist es umgekehrt. Laut Google werden „das Rendering und die JavaScript-Ausführung möglicherweise übersprungen“, sobald der Googlebot auf ein noindex-Tag stößt. Ein Skript, das noindex später entfernt, läuft also womöglich nie. Wenn die Seite in den Index soll, lass noindex aus dem ursprünglichen HTML heraus.
Next.js hat eine verwandte Eigenheit: Auf Routen mit gestreamten Metadaten landen die Tags im <body>, und zwar für alle Crawler, die nicht auf seiner Liste der HTML-limitierten Bots stehen. Wie du das prüfst, steht in unserem Beitrag zu Meta-Tags für SEO.
Soft 404 in Single-Page-Apps
Eine Single-Page-App, die jede Route mit Status 200 beantwortet, macht aus fehlenden Seiten Soft-404-Fehler. Googles Leitfaden bietet zwei Lösungen per Skript an: eine JavaScript-Weiterleitung zu einer URL, die einen echten 404 zurückgibt, oder ein per JavaScript eingefügtes noindex auf Fehlerseiten. Beide setzen voraus, dass Skripte laufen; ein Abruf-Bot ohne Skriptausführung sieht in beiden Fällen den Status 200 und die leere Hülle. Wo es geht, lass den Server einen echten 404 liefern.
Blockierte Skripte und zu große Bundles
Der Googlebot liest zuerst die robots.txt, und laut Leitfaden wird „JavaScript aus blockierten Dateien oder auf blockierten Seiten nicht gerendert“. Eine Regel, die deinen Skriptordner oder deinen API-Pfad sperrt, kann Google eine ungerenderte Hülle vorsetzen. Das zweite Problem ist die Größe. Halte jedes Bundle unter der oben beschriebenen Grenze und setze Title, Canonical und die wichtigsten strukturierten Daten weit nach oben ins HTML, wie Googles Crawler-Beitrag rät.
Inhalte, die auf einen Klick oder Scroll warten
Die Google Suche interagiert laut ihrem Leitfaden zu Lazy Loading nicht mit deiner Seite. Inhalte, die erst nach einem Klick oder beim Scrollen nachgeladen werden, sieht sie nicht. Googles Lösung: alle relevanten Inhalte laden, sobald sie in den sichtbaren Bereich kommen, zum Beispiel mit der IntersectionObserver API, und für unendliches Scrollen nummerierte Seiten mit eigenen URLs anbieten. Für Tabs und „Mehr laden“-Buttons gilt dieselbe Logik: Muss jemand klicken oder scrollen, damit der Text geladen oder eingefügt wird, geh davon aus, dass Bots ihn nie sehen.
Consent-Banner und CMPs
Auch dein Consent-Tool entscheidet mit, was ein Bot sieht: Ein per JavaScript eingeblendetes Banner bekommt ein Bot ohne Skriptausführung zwar nie zu sehen, Inhalte, die erst nach der Einwilligung laden, aber auch nicht. Cookiebot lässt Suchmaschinen-Crawler laut eigenem Support ohne Banner auf die Seite, als hätten sie allen Cookies zugestimmt. Usercentrics macht das mit seiner Bot-Erkennung, wenn du sie in den CMP-Einstellungen einschaltest. Auf deren Liste stehen Googlebot und Co., aber keiner der KI-Abruf-Bots. consentmanager blendet die Einwilligungsebene für Crawler bewusst nicht aus und markiert sie mit data-nosnippet. Borlabs Cookie erkennt seit Version 3.5 (3. November 2026) auch ChatGPT-User, Claude-User und Perplexity-User als Bots und behandelt sie nach der Einstellung „Cookies für Bots/Crawler“. Prüf daher, was dein CMP jedem Bot ausliefert, lass den Seitentext nicht von der Einwilligung abhängen und teste das rohe HTML mit den User-Agents der KI-Bots. Wie sich das auf KI-Abruf-Bots ohne Skriptausführung auswirkt, haben wir nicht getestet.
Strukturierte Daten per Skript
Laut Googles Leitfaden kannst du JSON-LD mit JavaScript erzeugen und einfügen, solltest das Ergebnis aber testen. Bei Assistenten sieht es anders aus. In searchVIUs Test vom Oktober 2025 gab keiner der getesteten Assistenten einen Preis wieder, der nur im JSON-LD stand, ob statisch oder per Skript eingefügt. Das ist ein einzelner Test, und er betrifft JSON-LD in beiden Varianten, nicht nur das per Skript eingefügte. Schreib die wichtigsten Fakten als sichtbaren Text ins HTML und liefere das JSON-LD ebenfalls im HTML aus, damit Google und jeder Parser ohne Skriptausführung es direkt lesen können.
Was Schema-Markup für die KI-Suche leistet und was nicht, erklärt unser Leitfaden zu Schema-Markup für die KI-Suche.
Firewalls und Challenge-Seiten
Eine Firewall, die Besucher per JavaScript beweisen lässt, dass sie Menschen sind, zeigt einem Bot ohne Rendering laut Forge die Challenge, nicht deine Seite. Bei Forges eigener Testseite wurden Claude und Perplexity von etwas blockiert, das dem Server vorgeschaltet war, bis Forge eine Kopie der Seite verschob; was genau, verrät Forge nicht.
Was du zuerst beheben solltest
Schadet JavaScript deinem SEO? Bei Google meist nicht, solange die Seite sauber gerendert wird, korrekte Statuscodes liefert und unter der Größengrenze bleibt. Für die KI-Suche ist Text, den nur JavaScript erzeugt, ein Risiko beim Abruf, besonders bei direkten Abruf-Bots, die nicht rendern, wie ChatGPT-User und Claude-User in den Tests oben. Wie viel davon über Suchindizes in eine Antwort gelangt, ist von Fall zu Fall verschieden. OpenAIs Such-Crawler rendert inzwischen manche Seiten, in einem Log vom Oktober 2026 rund eine halbe Stunde nach dem Abruf.
Geh in dieser Reihenfolge vor, denn jeder Schritt erleichtert den nächsten:
- Bring den Text, der deine Zielanfragen beantwortet, deine Links und dein JSON-LD in die erste HTML-Antwort.
- Liefere korrekte Statuscodes und sorg dafür, dass deine Firewall die Bots durchlässt, die du haben willst.
- Gleiche Title, Canonical und robots-Tags zwischen rohem HTML und gerendertem DOM ab.
- Verkleinere die Bundles und setz die wichtigen Tags an den Anfang des Dokuments.
- Wiederhole den Vergleich von rohem und gerendertem HTML auf deinen zehn wichtigsten Seiten und schau einen Monat später in deine Logs.
Lass deine wichtigsten Seiten durch den Content Analyzer von geotoolbox laufen, um zu sehen, worin sich die Fassungen mit und ohne JavaScript unterscheiden. Den Rest der Kette gehst du mit unserem Audit der KI-Sichtbarkeit durch. Das Verhalten der Bots hat sich zwischen den Tests oben innerhalb weniger Monate verändert. Ein datiertes Protokoll dessen, was du getestet hast, ist darum mehr wert als jedes einzelne Ergebnis hier.
Häufige Fragen
Was ist JavaScript SEO?
JavaScript SEO sorgt dafür, dass Inhalte, die JavaScript erzeugt, für Suchmaschinen und KI-Crawler sichtbar sind. Dabei geht es darum, ob Seiten gecrawlt, gerendert und indexiert werden können und ob Text, Links und Tags auch für Bots, die keine Skripte ausführen, im HTML stehen.
Ist React immer noch schlecht für SEO?
Entscheidend ist, wo React rendert, nicht React selbst. Eine React-App, die auf dem Server gerendert oder vorab gebaut wird, liefert ihren Text in der ersten HTML-Antwort und verhält sich wie jede andere Website. Eine App, die nur im Browser rendert, kann bei Google funktionieren, sobald Google sie gerendert hat, wirkt auf Abruf-Bots ohne Skriptausführung aber leer.
Können ChatGPT, Claude und Perplexity JavaScript lesen?
In den Tests, die wir gefunden haben, riefen ChatGPT-User, Claude-User und PerplexityBot im 30-Tage-Log einer Nachrichtenseite keine Skripte ab. Im Test von Search Engine World gaben ChatGPT, Claude und Perplexity den Wert aus dem HTML wieder (Forges Perplexity-Test lieferte kein Ergebnis). Die Ausnahme ist OpenAIs Such-Crawler OAI-SearchBot: Die Logs von drei Website-Betreibern aus dem Zeitraum Juli bis Oktober 2026 zeigen, dass er JavaScript ausführt; in einem davon ist der Aufruf eines Endpunkts dokumentiert, den nur laufendes JavaScript erreicht (Genezio). Für GPTBot, OpenAIs Trainings-Crawler, widersprechen sich die Belege. Die Bot-Seiten von OpenAI und Perplexity sagen zu JavaScript nichts (Stand: 9. November 2026). Alle Ergebnisse hier beschreiben gemessenes Verhalten, das sich ändern kann.
Warum zeigt meine Next.js-Seite „Gefunden – zurzeit nicht indexiert“?
Das Rendering ist selten der einzige Verdächtige. In einem Thread auf r/nextjs schreibt der Verfasser, die meisten dieser Fälle seien auf Weiterleitungen wie 308, auf Canonicals und auf fehlende Sitemap- oder robots-Dateien zurückgegangen, nicht auf den Inhalt. Das ist ein Bericht aus der Community, keine Aussage von Google. Schließ zuerst Weiterleitungen und Canonicals aus und vergleiche dann rohes und gerendertes HTML wie oben beschrieben.
Quellen
- Anthropic – Web fetch tool, API-Dokumentation (undatiert, gelesen am 9. November 2026) –
platform.claude.com/docs/en/agents-and-tools/tool-use/web-fetch-tool - Apple – About Applebot (veröffentlicht am 4. September 2026) –
support.apple.com/en-us/119829 - Bing Webmaster Blog – bingbot Series: JavaScript, Dynamic Rendering, and Cloaking. Oh My! (31. Oktober 2018) –
blogs.bing.com/webmaster/2018/10/bingbot-Series-JavaScript,-Dynamic-Rendering,-and-Cloaking-Oh-My - Borlabs – Borlabs Cookie Changelog, Version 3.5 (3. November 2026) –
borlabs.io/borlabs-cookie/changelog - consentmanager – How consentmanager handles search engine crawlers (undatiert, gelesen am 9. November 2026) –
consentmanager.net/en/help/developer-reference/how-consentmanager-handles-search-engine-crawlers - Cookiebot – Does using Cookiebot affect my website's performance, SEO ranking and indexation of content? (aktualisiert am 18. August 2026) –
support.cookiebot.com/hc/en-us/articles/360005114894 - Crawl Lab – OAI-SearchBot (undatiert; Log vom 20. bis 27. Juli 2026) –
crawl-lab.com/en/crawlers/oai-searchbot - DEV Community, hisashispace – Traffic from ChatGPT jumped! Is it because its crawlers now run JavaScript? (30. September 2026) –
dev.to/hisashispace/traffic-from-chatgpt-jumped-is-it-because-its-crawlers-now-run-javascript-5961 - Forge AI Bot Log – Can AI crawlers run JavaScript? (veröffentlicht am 24. September 2026; 30-Tage-Log bis 24. September) –
forgeaibotlog.com/articles/can-ai-crawlers-execute-javascript - Genezio, Bogdan Vlad (Mitgründer und CTO) – OpenAI's Search Crawler Runs JavaScript. Here's the Proof. (22. Oktober 2026) –
genezio.com/research/openai-crawler-runs-javascript - Bogdan Ripa (Mitgründer von Genezio) – An analysis of OpenAI's bots (22. Oktober 2026; Log vom 8. bis 22. Oktober) –
bogdanripa.substack.com/p/an-analysis-of-openais-bots - Google Search Central Blog – Googlebot and the 15 MB thing (28. Juni 2022) –
developers.google.com/search/blog/2022/06/googlebot-15mb - Google Search Central – KI-Funktionen und deine Website (zuletzt aktualisiert am 31. Dezember 2025) –
developers.google.com/search/docs/appearance/ai-features?hl=de - Google Search Central – Probleme mit Lazy-Loading-Inhalten von Websites beheben (zuletzt aktualisiert am 18. Dezember 2025) –
developers.google.com/search/docs/crawling-indexing/javascript/lazy-loading?hl=de - Google Search Central – Dynamisches Rendering als Behelfslösung (zuletzt aktualisiert am 18. Dezember 2025) –
developers.google.com/search/docs/crawling-indexing/javascript/dynamic-rendering?hl=de - Google Search Central – Grundlagen von JavaScript-SEO (zuletzt aktualisiert am 4. März 2026) –
developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics?hl=de - Google Search Central Blog – Inside Googlebot: demystifying crawling, fetching, and the bytes we process (31. März 2026, korrigiert am 29. Oktober 2026) –
developers.google.com/search/blog/2026/03/crawler-blog-post - Google Blog Deutschland – Google Suche 101: Das steckt hinter Übersicht mit KI (25. März 2025) –
blog.google/intl/de-de/produkte/suchen-entdecken/google-suche-101-uebersicht-mit-ki - Google Blog Deutschland – Der KI-Modus startet in Deutschland, Österreich und der Schweiz (8. Oktober 2025) –
blog.google/intl/de-de/produkte/suchen-entdecken/ki-modus-startet-in-dach - Reddit r/nextjs – Why Google refuses to index many Next.js sites (Thread 1qs38nw, gelesen am 9. November 2026) –
reddit.com/r/nextjs/comments/1qs38nw - JS SEO Lab, Jakub Sawa – JavaScript execution has two depths, and bots split cleanly between them (6. August 2026, aktualisiert am 25. Oktober 2026) –
jsseo.dev/findings/javascript-execution-has-two-depths - Search Engine World, Andre Alpar – Do AI assistants actually render your JavaScript when grounding? (9. Juni 2026, aktualisiert am 2. Juli 2026) –
searchengineworld.com/do-ai-assistants-actually-render-your-javascript-when-grounding-we-put-it-to-the-test - searchVIU – Schema Markup und KI im Test (deutsche Fassung des Ratgebers vom 2. Dezember 2025, aktualisiert am 15. Oktober 2026; Test vom 30. Oktober 2025) –
searchviu.com/de/ratgeber/schema-markup-ki - Usercentrics – Bot detection, Dokumentation (undatiert, gelesen am 9. November 2026) –
usercentrics.com/docs/web/features/bot-detection - Vercel mit MERJ – The rise of the AI crawler (17. Dezember 2024) –
vercel.com/blog/the-rise-of-the-ai-crawler