
Wie funktioniert ChatGPT eigentlich? Lässt man das Marketing beiseite, ist die Antwort seltsamer und gleichzeitig einfacher, als die meisten Erklärungen zugeben. ChatGPT denkt nicht. Das Modell dahinter hat keine Datenbank, in der es deine Website nachschlägt, und die meiste Zeit durchsucht es auch gar nicht das Web. Es führt eine einzige Operation aus, ein paar hundert Mal pro Antwort: das nächste Token vorherzusagen. Genau das erklärt dieser Beitrag in klarer Sprache, geschrieben für Menschen, die Inhalte veröffentlichen, nicht für Modellentwickler. Und zwar samt dem Teil, den die meisten technischen Erklärungen weglassen: was jeder Schritt für deine KI-Sichtbarkeit bedeutet, und was nicht.
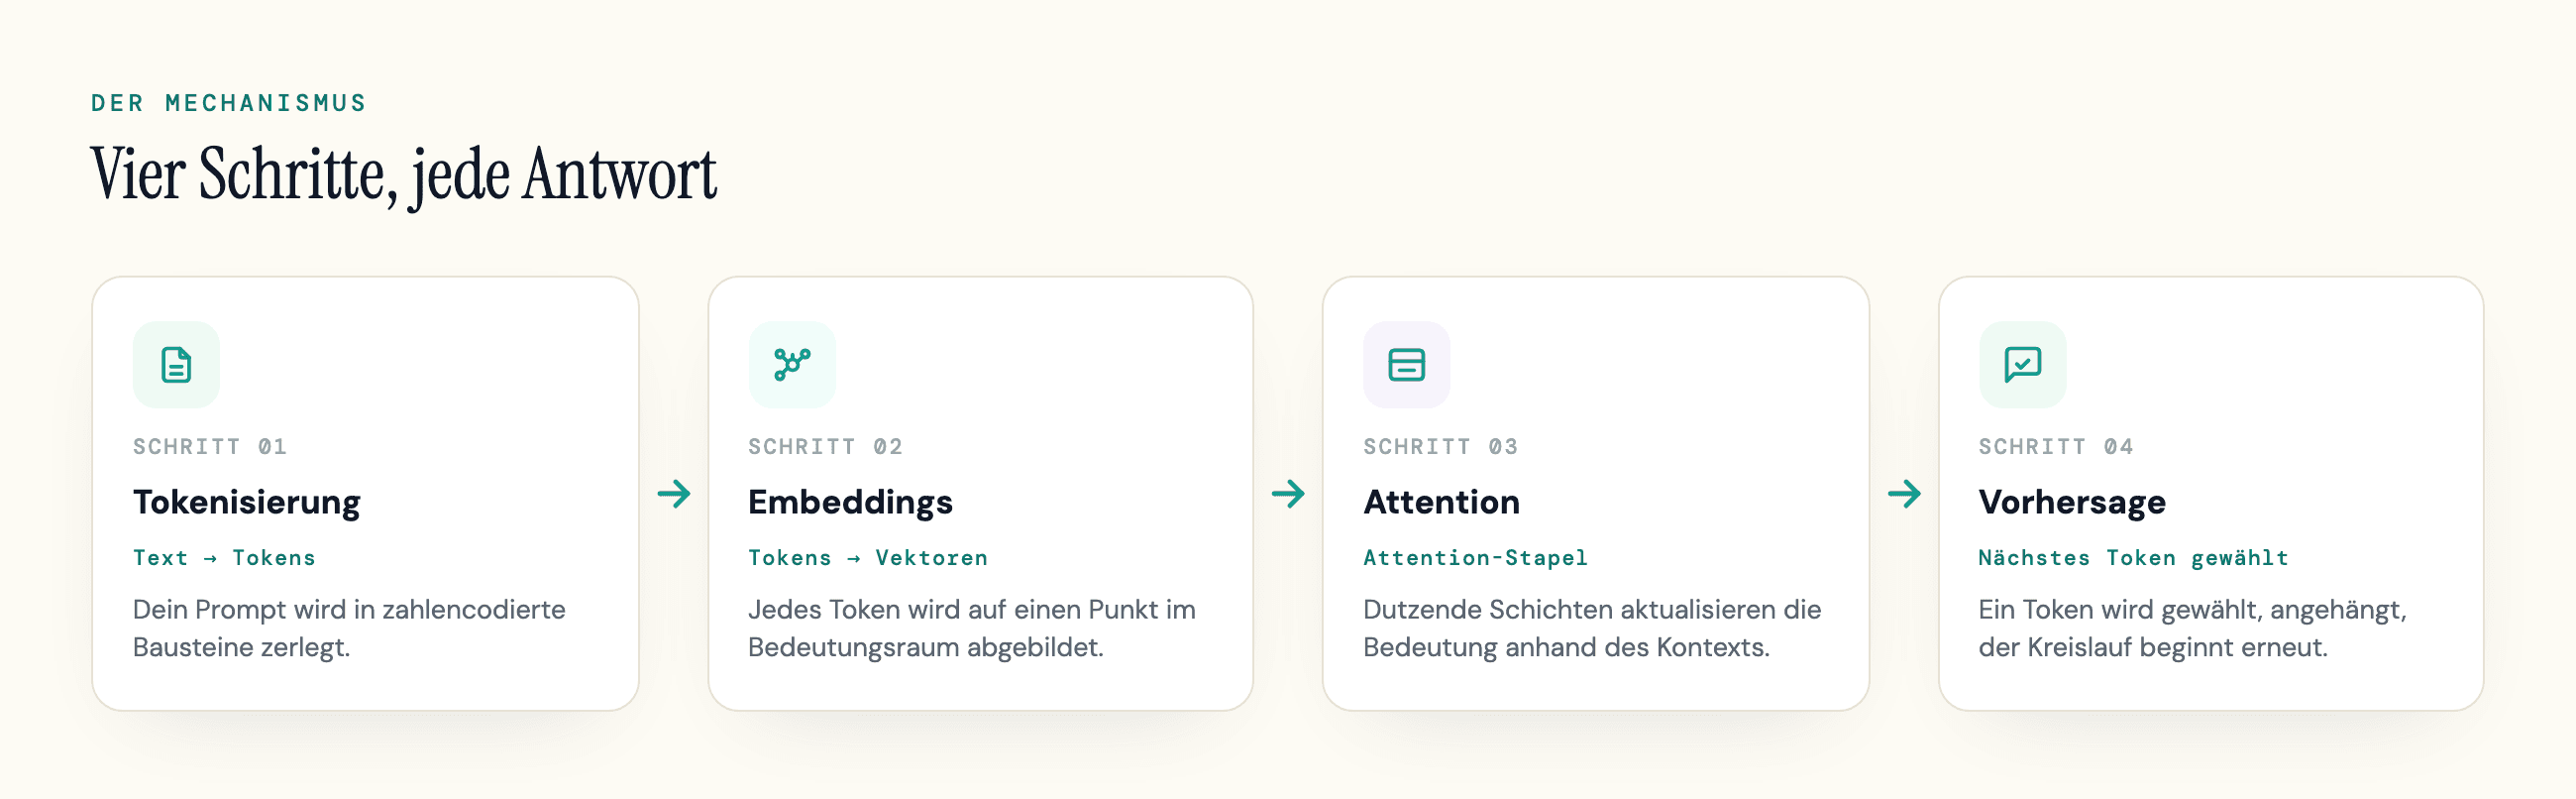
Das Wichtigste in Kürze
- ChatGPT erzeugt jede Antwort, indem es eine einzige Operation, die Vorhersage des nächsten Tokens, ein paar hundert Mal wiederholt: Es „denkt“ nicht und fragt keine Datenbank zu deiner Marke ab.
- Die Transformer-Architektur stammt aus dem Paper „Attention Is All You Need“ (2017); GPT-3 hatte 175 Milliarden Parameter und 96 Schichten, Zahlen, die aktuelle Modelle nicht mehr veröffentlichen.
- ChatGPT schöpft aus zwei getrennten Quellen: eingefrorenem Trainingswissen und Live-Websuche über OAI-SearchBot und ChatGPT-User (GPTBot dient nur dem Training, seit Kurzem kommt mit OAI-AdsBot ein vierter, werberelevanter Crawler dazu).
- Keine Einstellung, kein Tag und keine Auktion platziert eine Marke in der generierten KI-Antwort: Die Anzeigen, die OpenAI seit Februar 2026 zeigt und seit Ende August 2026 auch in Deutschland ausspielt, laufen in einem sichtbar getrennten Block, nie im Text selbst.
- Die beiden einzigen heute überprüfbaren Hebel sind, ob deine Seiten für die Crawler von ChatGPT erreichbar sind, und was das Modell über deine Marke tatsächlich sagt, gemessen über viele Durchläufe.
ChatGPT in 30 Sekunden erklärt: Es sagt nur das nächste Token vorher
ChatGPT beantwortet im Kern eine einzige kleine Frage, wieder und wieder: Welches Token folgt auf den bisherigen Text am wahrscheinlichsten? Es bewertet jedes mögliche Token, wählt eines aus (nicht immer das mit dem höchsten Wert, dazu gleich mehr), hängt es an und stellt die Frage erneut. Jede Antwort, die ChatGPT schreibt, ist genau dieser Kreislauf, ein paar hundert Mal ausgeführt. Im Basismodell gibt es keinen separaten Schritt, in dem geprüft wird, was wahr ist, oder in dem es über deine Frage nachdenkt, wie ein Mensch es tun würde. (Wenn ChatGPT eine Websuche oder ein Tool nutzt, baut das Produkt diese zusätzlichen Schritte um das Modell herum, dazu später mehr.)
Viele nennen es „Autovervollständigung“, und das ist ein guter Ausgangspunkt, solange man nicht dabei stehenbleibt. Stephen Wolfram beschreibt es in seiner vielzitierten allgemeinverständlichen Erklärung als das Erzeugen einer „vernünftigen Fortsetzung“ des bisherigen Texts.
Der Haken: Das „nur“ in „nur Autovervollständigung“ leistet erstaunlich viel im Hintergrund. Um das nächste Wort in „die Hauptstadt von Frankreich ist“ vorherzusagen, braucht es einen echten Fakt. Um „wenn ich den Tisch umstoße, wird die Traube darauf“ zu vervollständigen, braucht es ein grobes Modell davon, wie sich die physische Welt verhält. Ab einer gewissen Größenordnung wirkt gute Wortvorhersage wie Verstehen, weshalb die Debatte, ob diese Modelle etwas „verstehen“, keine saubere Antwort hat.
Wer Inhalte veröffentlicht, braucht für die entscheidende Erkenntnis noch gar keine Mathematik. Du überzeugst kein denkendes Gegenüber, und du bearbeitest keinen Datenbankeintrag. Du verschiebst die Statistik darüber, wie sich Texte zu deinem Thema typischerweise fortsetzen. Behalte das im Kopf, denn es erklärt fast alles, was die Maschine richtig und falsch macht.
| Was viele über ChatGPT annehmen | Was tatsächlich passiert |
|---|---|
| Denkt über deine Frage nach und versteht sie | Sagt das nächste Token anhand gelernter Muster vorher, eines nach dem anderen |
| Schlägt deine Marke in einer Live-Datenbank nach | Erzeugt Text aus eingefrorenen numerischen Gewichten, festgelegt im Training |
| Durchsucht bei jeder Antwort das Web | Nur wenn eine Websuche läuft; sonst wird nichts abgerufen |
| Erinnert sich zwischen Chats an dich | Startet jeden Chat leer, außer eine separate Memory-Funktion speichert Fakten |
| Liest deine Seite wie ein Mensch | Liest Token-IDs und Vektoren, nicht deinen Text Buchstabe für Buchstabe |
Von deinem Prompt zu Tokens: Die Tokenisierung
Bevor das Modell irgendetwas tut, zerlegt ein separates Programm, der Tokenizer, deinen Text in Tokens und ersetzt jedes durch eine Zahl. Ein Token ist ein Textbaustein, im Englischen meist rund vier Zeichen oder drei Viertel eines Worts; andere Sprachen kosten oft mehr Tokens pro Wort. Häufige Wörter sind ein einzelnes Token, seltenere Wörter und weniger geläufige Markennamen werden in mehrere Teile zerlegt. Das Modell arbeitet größtenteils mit diesen ganzzahligen IDs statt mit einer Buchstabe-für-Buchstabe-Ansicht deines Texts, weshalb Aufgaben auf Buchstabenebene für ChatGPT so schwierig sind. Multimodale Modelle wandeln auch Bilder und Audio in eigene numerische Darstellungen um, wenn auch mit einer anderen Pipeline als bei Text.
Das ist die Wurzel von ChatGPTs bekanntem Problem, die Rs in „strawberry“ zu zählen: Das Wort kommt als mehrere Subwort-Tokens an, von denen keines ein einzelner Buchstabe ist, sodass Buchstabenzählen zu einer Gedächtnisaufgabe wird statt zu etwas, das sich einfach ablesen lässt. Dieselbe Mechanik erklärt verstümmelte Markennamen und falsch wiedergegebene lange Zahlen. Die ganze Geschichte, samt der Wörter, an denen aktuelle Modelle noch scheitern, steht in unserem eigenen Beitrag zu Tokens; hier reicht es zu wissen, dass Tokens die Grundeinheit sind, auf der alles Weitere aufbaut.
Deutsch zahlt hier einen eigenen Aufpreis. Zusammengesetzte Wörter wie „Krankenversicherungsunternehmen“ oder „Datenschutzbeauftragte“ zerlegt der Tokenizer in mehrere Teile, und auch jenseits der Komposita braucht deutscher Text für dieselbe Aussage in der Regel mehr Tokens als englischer. Ein konkreter Multiplikator lässt sich ohne einen benannten Tokenizer und ein aktuelles Datum nicht seriös beziffern, aber das Muster ist real: Wer auf Deutsch schreibt, füttert das Modell faktisch mit mehr Tokens für dieselbe Aussage, was bei sehr langen Prompts oder API-Nutzung auch spürbar mehr kostet.
Keyword-Dichte überträgt sich hier nicht
Die alte Angewohnheit, eine Formulierung zu wiederholen, um Relevanz zu signalisieren, funktioniert so nicht mehr. Das Modell zählt in diesem Moment nicht, wie oft „bestes CRM für Zahnärzte“ auf deiner Seite vorkommt; an dieser Stelle bewertet es deine Seite überhaupt nicht. Es hat Muster gelernt, lange bevor deine Frage gestellt wurde, und die Dichte auf einer einzelnen Seite gehört nicht zu den Stellschrauben, die diese Muster geformt haben. Der Live-Abruf, weiter unten in diesem Beitrag, ist eine andere Geschichte: Dort muss ein ganz normaler Suchindex deine Seite trotzdem erst einmal finden.
Aus Tokens werden Vektoren: Embeddings und Bedeutung
Eine Token-ID ist immer noch nur eine Zahl, die für einen Textbaustein steht. Der nächste Schritt ist der, an dem Bedeutung ins Spiel kommt. Jedes Token wird auf ein Embedding abgebildet, eine lange Liste von Zahlen, die man sich als Punkt im Raum vorstellen kann, nur dass dieser Raum Tausende Dimensionen statt drei hat. Tokens mit ähnlicher Bedeutung landen nah beieinander. „Katze“ und „Hund“ liegen nah zusammen, weil sie in ähnlichen Sätzen auftauchen. „Katze“ und „Tabellenkalkulation“ liegen weit auseinander. Bedeutung ist für ein Modell Geometrie.
Diese Positionen werden nicht von Hand vergeben. Sie starten zufällig und verschieben sich, während das neuronale Netz beim Training Milliarden Beispiele liest. Wörter, die immer wieder im selben Umfeld auftauchen, rücken zusammen, bis die Anordnung des Raums etwas Reales darüber einfängt, wie Sprache benutzt wird. Das Modell bekommt nie eine Definition von „Katze“. Es bekommt das Umfeld, in dem „Katze“ immer wieder vorkommt, und das reicht offenbar aus, um das Wort einzuordnen. Ausführlicher beschreibt ein eigener Beitrag, wie Vektor-Embeddings Bedeutung transportieren; hier reicht die grobe Form.
An dieser Stelle berührt die Mechanik zum ersten Mal deine KI-Sichtbarkeit, und es lohnt sich, präzise statt mystisch zu bleiben. Deine Marke ist kein einzelner Punkt in diesem Raum. Ihr Name teilt sich oft auf mehrere Tokens auf, und was das Modell aufbaut, ist eine Assoziation zwischen diesen Tokens, deiner Kategorie und den Wörtern, die typischerweise um sie herum stehen. Wenn dein Name in den Texten, aus denen das Modell gelernt hat, konsistent zusammen mit deiner Kategorie auftaucht, wird diese Assoziation stärker. Das ist kein Tag, den du setzt, und kein Schalter, den du umlegst. Es ist das langsame Ergebnis davon, zutreffend und konsistent in der Art von Text beschrieben zu werden, aus der Modelle lernen. Die Grenze gehört allerdings klar benannt: Niemand kann das Modell öffnen und dir diese Assoziation zeigen oder belegen, dass sie sich bewegt hat. Es ist eine Schlussfolgerung daraus, wie Training funktioniert, und das Einzige, was sich tatsächlich beobachten lässt, sind die Antworten, die das Modell gibt, über viele Durchläufe gesammelt.
Wie das Modell Kontext liest: Der Attention-Mechanismus
Ein Punkt im Raum ist eine brauchbare Annäherung an das, was ein Wort für sich genommen bedeutet, aber Wörter verändern ihre Bedeutung mit ihrem Umfeld. „Bank“ neben „Fluss“ ist nicht dasselbe wie „Bank“ neben „Konto“. Der Durchbruch, der moderne Modelle möglich gemacht hat, das Paper Attention Is All You Need von 2017, hat die gesamte Architektur um einen Schritt namens Self-Attention herum gebaut, der die Bedeutung jedes Tokens anhand der umgebenden Tokens aktualisiert, bevor überhaupt eine Vorhersage stattfindet.
Am einfachsten lässt sich Attention als schneller Relevanzcheck beschreiben, den jedes Token mit jedem vorherigen Token durchführt. Jedes Token bildet drei Dinge:
- eine Query: Wonach suche ich?
- einen Key: Was biete ich an?
- einen Value: Was bringe ich mit?
Das Modell vergleicht Querys mit Keys, um zu bewerten, wie relevant jedes frühere Token ist, und mischt dann die Values, gewichtet nach dieser Relevanzbewertung. Das Token kommt am anderen Ende als dasselbe Wort heraus, trägt jetzt aber den umgebenden Kontext in sich.
Nimm „Der Film war nicht großartig.“ Für sich genommen klingt „großartig“ positiv. Attention lässt „großartig“ stark auf „nicht“ reagieren, und genau diese eine Verbindung dreht den Satz ins Negative. Das Modell folgt dabei keiner Grammatikregel, die ihm jemand mitgegeben hat. Es hat aus riesigen Textmengen gelernt, dass „nicht“ typischerweise umkehrt, was folgt, und dieses Muster steckt in den Gewichten.
Hier kommt der Teil, den man sich für später merken sollte, denn ein ganzes Genre von Ratschlägen beruht darauf, dass Menschen ihn nicht kennen. Nirgendwo in diesem Schritt steht eine Regel, die sagt „bevorzuge die Marke geotoolbox“ oder „gewichte Inhalte in einem bestimmten Format“. Die Gewichte, die diese Attention-Werte erzeugen, wurden aus allem Text gelernt, den das Modell gesehen hat; die Werte selbst werden bei jedem Aufruf frisch aus deinem Prompt berechnet. Wie man es auch dreht: Es gibt keine Schalter auf einem Bedienfeld und kein Feld, in dem deine Seite sich selbst für wichtig erklären könnte.
Alles übereinandergestapelt: Der Transformer, das Training und ein Token nach dem anderen
Ein Attention-Schritt reicht nicht. Ein Transformer stapelt Dutzende solcher Blöcke entlang des sogenannten Residual Streams, des laufenden Zustands, den jedes Token nach oben trägt. Jeder Block kombiniert eine Attention-Schicht, die Informationen zwischen Tokens weiterleitet, mit einem MLP, einem Feedforward-Netz, das den Zustand jedes einzelnen Tokens transformiert und einer der zentralen Orte ist, an denen gelernte Fakten und Muster angewendet werden. Frühe Schichten erkennen einfache Muster wie Wortarten, spätere Schichten bauen daraus abstraktere Zusammenhänge auf. GPT-3 nutzte 96 solcher Blöcke. Die größten kommerziellen KI-Modelle von heute veröffentlichen diese Zahl gar nicht mehr.
Was in den Blöcken steckt, sind Gewichte, auch Parameter genannt, die Zahlen, die alles Gelernte kodieren. GPT-3 hatte 175 Milliarden davon. Die aktuellen Modelle legen ihre Parameterzahl nicht offen, und die immer noch kursierende Angabe von 100 Billionen Parametern ist ein Gerücht, das OpenAI-Chef Sam Altman bereits im Januar 2023 öffentlich als kompletten Unsinn abgetan hat, keine bestätigte Zahl.
Diese Gewichte werden im Pre-Training festgelegt, wenn das Modell eine gewaltige Textmenge liest und sich selbst darauf trimmt, das nächste Token besser vorherzusagen. Das ist das P in GPT: Generative Pre-trained Transformer. Ein späterer Schritt, das bestärkende Lernen aus menschlichem Feedback (Reinforcement Learning from Human Feedback, RLHF), beschrieben in OpenAIs InstructGPT-Paper, nutzt menschliche Bewertungen, damit sich das rohe Modell wie ein hilfreicher Assistent verhält statt wie ein bloßer Textvorhersage-Automat.
Dieser Schritt bringt dem Modell mehr bei als gute Manieren: Er formt um, was das Modell überhaupt sagt, sodass der fertige Assistent kein reiner Spiegel seiner Trainingstexte mehr ist.
Warum suggestive Prompts nutzlose Tests sind
Bestärkendes Lernen aus menschlichem Feedback kann Assistenten in Richtung angenehmer Antworten drängen, was sich bei suggestiven Prompts als reine Schmeichelei zeigt. Fragst du „Ist meine Marke nicht das beste Tool dafür?“, bekommst du womöglich ein Ja. Das macht einen suggestiven Prompt zu einem wertlosen KI-Sichtbarkeitstest: Formuliere deine Checks neutral, und vertraue darauf, wie oft eine Antwort sich über viele Durchläufe wiederholt, statt darauf, wie schmeichelhaft ein einzelner Lauf ausfällt.
Nichts davon ist ChatGPT-exklusiv. Die heutigen Modelle, ob OpenAIs GPT-5-Reihe, Anthropics Claude oder Googles Gemini, beruhen alle auf derselben Transformer-Idee. Die neueren „Reasoning“- oder „Thinking“-Modi ändern den Kernkreislauf nicht; sie investieren mehr Rechenzeit, bevor die sichtbare Antwort erscheint, oft über verborgene Zwischenschritte und manchmal über zusätzliche Tool-Aufrufe oder Abrufrunden. Im Kern bleibt es Next-Token-Vorhersage. Eine andere Maschine steckt nicht dahinter. Wenn Menschen fragen, wie große Sprachmodelle (Large Language Models, LLMs) allgemein funktionieren, ist das die Antwort für fast alle von ihnen. Wie sich ChatGPT in der Praxis von seinen Konkurrenten unterscheidet, zeigen Grok vs. ChatGPT, Gemini vs. ChatGPT und Claude vs. ChatGPT.
Nachdem der Text den ganzen Stapel durchlaufen hat, erzeugt das Modell für jedes mögliche nächste Token einen Score (Logit), wandelt diese Scores in Wahrscheinlichkeiten um, und eine Decoding-Regel, etwa Temperature oder Top-P, wählt eines aus. Dann hängt es dieses Token an die Eingabe an und läuft für das nächste erneut. Ein Token nach dem anderen, und für jedes neue Wort durchläuft das Modell seine volle Tiefe. Deshalb braucht eine lange Antwort echte Rechenzeit, und deshalb erscheint sie Wort für Wort auf deinem Bildschirm.
Warum ChatGPT sich Dinge ausdenkt: Halluzination
Sobald klar ist, dass das Modell immer nur nach einem wahrscheinlichen nächsten Token greift, hört Halluzination auf, ein Fehler zu sein, und wird zu einem Merkmal des Designs. Frag es, welchen Sport Lionel Messi spielt, und es antwortet „Fußball“, weil „Messi“ und „Fußball“ in unzähligen Trainingsbeispielen zusammen auftauchten. Frag es nach dem Namen von Messis Haustier aus Kindertagen, etwas, das es nie zuverlässig gesehen hat, und es hört trotzdem nicht auf. Es greift weiter nach einem plausiblen nächsten Wort, und heraus kommt ein Haustiername, der reine Erfindung sein kann. Die internen Wahrscheinlichkeiten sind bei der Haustierfrage deutlich flacher als bei der Sportfrage, aber nichts im Ablauf zwingt das Modell, innezuhalten und das zu sagen.
OpenAI schreibt in seinem eigenen Hilfeartikel zur Frage, ob ChatGPT die Wahrheit sagt, sinngemäß dasselbe: Das System ist darauf ausgelegt, plausible Fortsetzungen zu liefern, nicht verifizierte Fakten, und kann mit voller Überzeugung falsch liegen. Genau diese Selbstsicherheit ist der gefährliche Teil. Ein Mensch, der etwas nicht weiß, relativiert das meist. Das Modell liefert eine erfundene Statistik oder eine gefälschte Quellenangabe im selben ruhigen Tonfall, den es auch für Dinge nutzt, die es richtig hat. Noch direkter steht es in OpenAIs eigener europäischer Datenschutzerklärung: Die wahrscheinlichsten nächsten Wörter seien in manchen Fällen nicht die sachlich zutreffendsten, und deshalb solle man sich auf die sachliche Richtigkeit der Modellausgaben nicht verlassen. Dahinter steckt dieselbe Mechanik wie bei KI-Halluzinationen über alle Modelle hinweg, kein Fehler, der nur ChatGPT betrifft.
Für eine Marke ist das die Quelle der schlimmsten Erfahrungen. ChatGPT wird gelegentlich etwas Falsches über dich, deine Preise oder dein Produkt behaupten, und zwar mit voller Überzeugung, und es gibt keine Adresse, an die du eine Korrektur schicken könntest. Der einzige Hebel, den du hast, folgt direkt aus der Mechanik. Das Modell greift nach einer wahrscheinlichen Fortsetzung angesichts des Texts, den es aufgenommen hat, also besteht die Arbeit darin, die korrekte Version zur wahrscheinlichsten zu machen: klare, konsistente, aktuelle Informationen über dich, wiederholt überall dort, wo diese Systeme lesen. Beim Live-Abruf kann eine korrigierte Seite die Antwort ändern, sobald Crawler und Index sie erfassen, wobei das Timing je nach Engine und Anfrage variiert. Beim Training geht es langsam und ohne Garantie, denn du kannst das Modell nicht selbst neu trainieren lassen. Es ist der einzige Hebel, kein Schalter.
Woher ChatGPT sein Wissen hat: Training versus Live-Abruf
Das ist die Unterscheidung, die bei Publishern mehr Verwirrung ausräumt als jede andere. ChatGPT schöpft aus zwei völlig getrennten Informationsquellen, und die könnten sich unterschiedlicher kaum verhalten. Es hilft, drei Dinge auseinanderzuhalten: Das Training legt die Gewichte fest, langsam und dann eingefroren; das laufende Gespräch steuert eine Antwort über das, was gerade im Kontextfenster steht, ohne auch nur ein Gewicht zu ändern; und der Abruf entscheidet, welche externen Seiten überhaupt erst in dieses Kontextfenster gelangen.
Die erste Quelle ist das parametrische Wissen, die Muster, die während des Trainings in den Gewichten eingefroren wurden. Es antwortet immer dann, wenn keine Tools aktiv sind: gewaltig, aber systembedingt veraltet, festgelegt auf einen Trainings-Cutoff, ohne eine Kopie deiner Seite, nur ein statistisches Echo von Text, der ihr ähnelte.
Die zweite Quelle ist der Live-Abruf, der nur dann passiert, wenn das Modell eine Websuche ausführt, etwas, das neuere Versionen inzwischen bei vielen Fragen von sich aus tun, nicht nur, wenn du einen Schalter umlegst. Dabei ruft es aktuelle Webseiten ab, liest sie und fasst sie zusammen, ein Vorgang, der als Retrieval-Augmented Generation bekannt ist. Deshalb verhalten sich Quellenangaben zwischen den Modi so unterschiedlich: Mit aktiviertem Abruf kann das Modell auf echte, gerade erst abgerufene Seiten verweisen; ohne Abruf wird jede Quellenangabe wie jedes andere Token generiert und kann komplett erfunden sein. Alles, was in wie KI-Suche wirklich funktioniert beschrieben wird, spielt sich auf dieser zweiten Spur ab.
| Frage | Trainingskorpus (parametrisch) | Live-Abruf (Browsing/Suche) |
|---|---|---|
| Was ist es | Im Training eingefrorene Muster in den Gewichten | Aktuelle Webseiten, zum Antwortzeitpunkt abgerufen |
| Wann wird es genutzt | Immer, und die einzige Quelle, wenn keine Suche läuft | Nur wenn das Modell eine Websuche ausführt |
| Wie aktuell | Veraltet, festgelegt auf den Trainings-Cutoff | So aktuell wie die gerade abgerufene Seite |
| Wie du es beeinflusst | Vor dem Cutoff zutreffend und breit beschrieben werden | Jetzt für den Crawler erreichbar und klar strukturiert sein |
| Welcher Crawler öffnet die Tür | GPTBot (Training) | OAI-SearchBot (Index) und ChatGPT-User (Live-Abruf) |
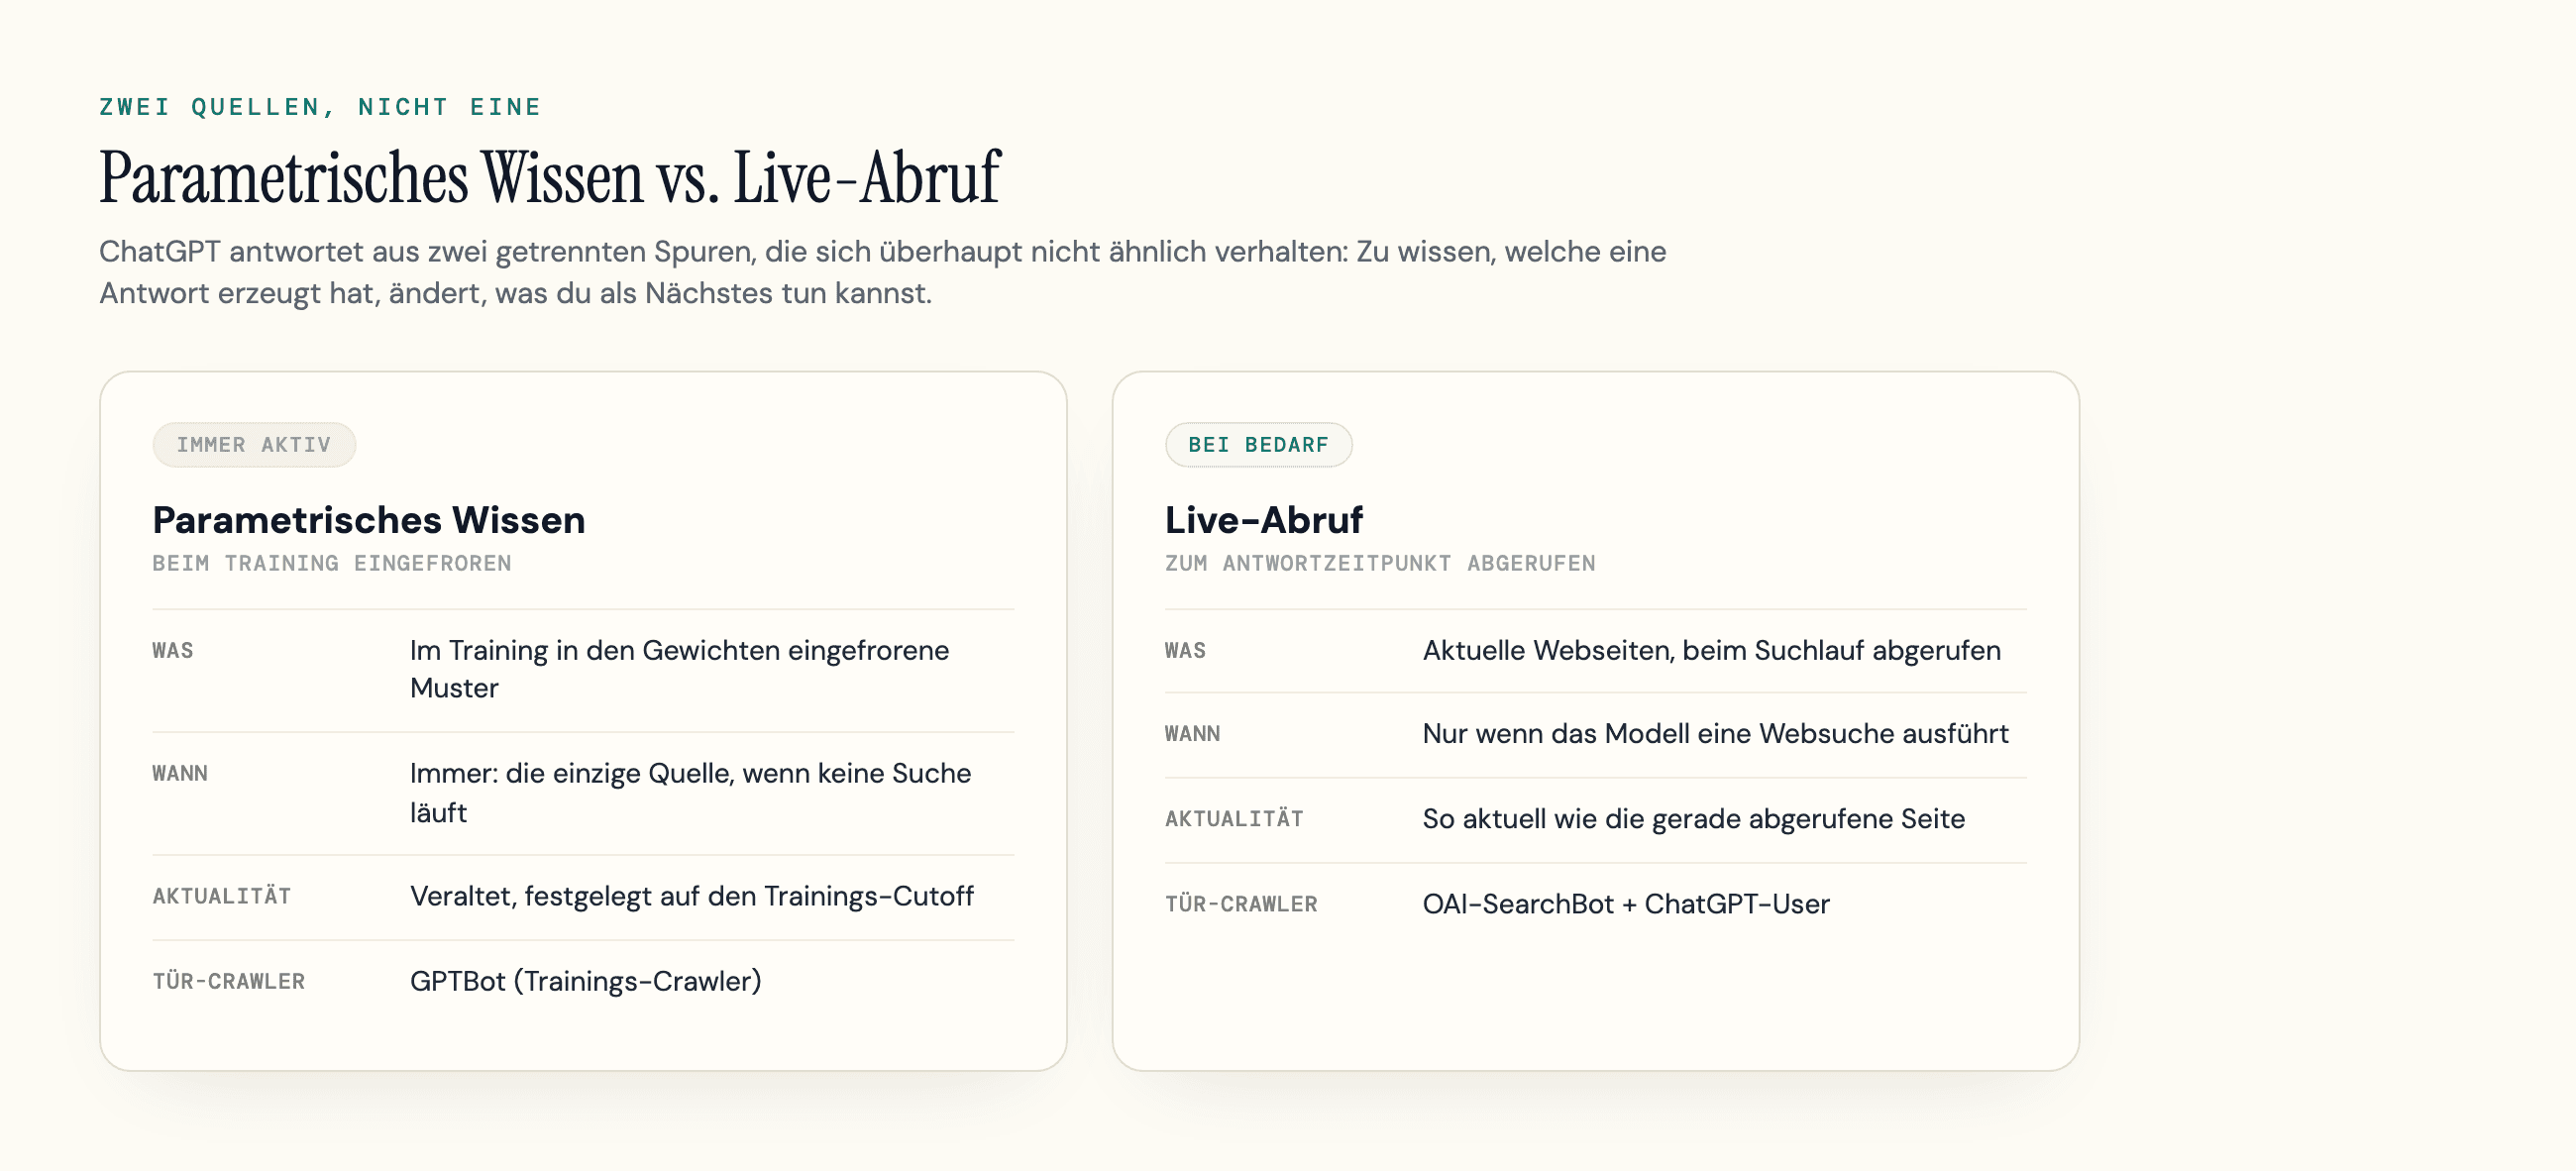
Zwei Türen also, und sie lassen sich mit unterschiedlichen Schlüsseln öffnen. In den Trainingskorpus zu gelangen ist langsam und liegt größtenteils außerhalb deiner Kontrolle. Die Abruf-Tür kannst du tatsächlich prüfen, denn sie hängt davon ab, ob die Suchcrawler von ChatGPT deine Seiten überhaupt erreichen können, allen voran OAI-SearchBot, der Seiten für die ChatGPT-Suche indexiert, und ChatGPT-User, der eine Seite live abruft, wenn die Frage eines Nutzers das auslöst. (GPTBot ist der separate Trainings-Crawler, nicht das Such-Tor, ein Unterschied, den man kennen sollte, bevor man den falschen blockiert.) Was der Crawler tatsächlich bekommt, ist ebenfalls wichtig: In Crawler-Log-Studien haben sich mehrere KI-Bots eher wie reine HTML-Parser als wie vollständige Browser verhalten, sodass alles, was erst nach dem Ausführen von JavaScript erscheint, leichter übersehen wird, wobei das je nach Bot variiert und es sich lohnt, es zu prüfen. Ein Hinweis noch: ChatGPTs Suche ist kein einfacher Wrapper um eine einzelne Suchmaschine, nimm also nicht an, dass dein Google-Ranking eins zu eins dorthin übertragen wird.
Seit dem Start der Anzeigen betreibt OpenAI einen vierten Crawler: OAI-AdsBot prüft nach Angaben von OpenAI die Sicherheit von Seiten, die als Anzeige eingereicht wurden. Für die organische Suche spielt er keine Rolle, entscheidend bleiben OAI-SearchBot und ChatGPT-User, aber wer in Deutschland ChatGPT Ads schaltet, wird ihn im eigenen Server-Log wiederfinden.
Was das wirklich für deine KI-Sichtbarkeit bedeutet
Jetzt zur eigentlichen Erkenntnis, und die beginnt mit einer Subtraktion. Weil nirgendwo in den Gewichten eine Regel zu deiner Marke steht, verkauft dir jeder Ratschlag, der verspricht, „für den Attention-Mechanismus zu optimieren“ oder Inhalte so zu formatieren, dass das Modell ihnen „Aufmerksamkeit schenkt“, den Zugang zu einem Bedienfeld, das es nicht gibt. Es ist unfalsifizierbar: Es gibt nichts auf der anderen Seite, das man drücken könnte.
Dasselbe gilt für die Hoffnung, man könne sich einkaufen. OpenAI hat am 9. Februar 2026 in den USA damit begonnen, gekennzeichnete Anzeigen in ChatGPT zu testen, im weiteren Jahresverlauf einen Self-Service-Ads-Manager eröffnet (OpenAI beschreibt den Auswahlmechanismus selbst als eine nach Relevanz gewichtete Zweitpreisauktion) und das Angebot Ende August 2026 auf 31 europäische Märkte einschließlich Deutschland ausgeweitet; seit dem 31. August 2026 können auch deutsche Unternehmen die Anzeigen über den Self-Service-Ads-Manager selbst buchen. Entscheidend ist aber, wo diese Anzeigen landen: in einem gekennzeichneten Block unterhalb der Antwort, sichtbar von ihr abgesetzt, niemals in ihr. OpenAIs eigene Dokumentation formuliert es sinngemäß so: Anzeigen könnten unter einer Antwort erscheinen, seien sichtbar von ChatGPTs Antwort getrennt, und Werbetreibende hätten keinerlei Möglichkeit, die Antworten von ChatGPT zu formen, zu ranken oder zu verändern. Stand September 2026 gibt es weiterhin keine Auktion, über die eine Marke in den generierten Text selbst gelangt. Am nächsten kommt dem bislang „Sponsored Agents“, seit dem 16. September 2026 in den USA im Test: Nach einem Klick auf eine Anzeige kann man ein eigenes, klar gekennzeichnetes Gespräch mit dem gesponserten Agenten eines Unternehmens starten, ausdrücklich getrennt von der eigentlichen ChatGPT-Antwort und vom ursprünglichen Chat. Die Antwort selbst kommt weiterhin aus den Gewichten und, manchmal, aus einem Live-Abruf, und für beides kann man nicht bezahlen.
Für Deutschland kommt ein Detail dazu, das in den US-Erklärungen fehlt: Personalisierte Anzeigen sind im Europäischen Wirtschaftsraum und in der Schweiz zunächst gar nicht verfügbar. Wer in Deutschland im Free- oder Go-Tarif Anzeigen sieht, bekommt sie auf Basis des aktuellen Chatverlaufs, der groben Region und der Tageszeit ausgespielt, nicht auf Basis früherer Unterhaltungen. Plus, Pro, Business, Enterprise und Edu bleiben vollständig werbefrei.
Was bleibt, ist weniger aufregend und dafür sehr viel realer, und es teilt sich sauber in das, was du prüfen kannst, und das, was du nur anstreben kannst. Zwei Hebel sind heute überprüfbar: ob die Abruf-Crawler deine Seiten erreichen können, und was die Modelle tatsächlich über dich sagen, wenn du es über viele Durchläufe verfolgst, statt einem einzelnen Screenshot zu vertrauen, der zufällig gut ausgefallen ist, denn Sampling macht jede Einzelantwort zur Anekdote. Die anderen beiden Hebel geben nur die Richtung vor, verankert darin, wie Training funktioniert, aber für deine Marke direkt unmöglich zu messen: zutreffend und konsistent über die Quellen hinweg beschrieben zu werden, aus denen diese Modelle lernen, und deine Fakten so aktuell zu halten, dass die wahrscheinlichste Fortsetzung über dich auch stimmt. Wer dir sagt, diese letzten beiden seien messbar, verkauft eine Sicherheit, die die Mechanik nicht bietet.
Auch in Deutschland ist das längst keine Theorie mehr: Für „wie funktioniert chatgpt“ selbst zeigt Google eine zusammenfassende AI Overview (auf Deutsch: „Übersicht mit KI“), Stand September 2026 gespeist unter anderem aus SWR, YouTube und Wikipedia, und AI Overviews laufen in Deutschland bereits seit dem 26. März 2025. Wer als deutsches Unternehmen sichtbar sein will, wenn Google oder ChatGPT eine solche Zusammenfassung erzeugen, misst sich also nicht mehr nur an zehn blauen Links, sondern daran, ob die eigene Seite überhaupt als Quelle infrage kommt.
Nach unserer Erfahrung beim Bau von Tools für genau dieses Problem sind die Marken, die verlässlich in KI-Antworten auftauchen, nicht die, die einem imaginären Attention-Regler hinterherjagen. Es sind die, die leicht erreichbar, konsistent beschrieben und korrekt genug wiedergegeben sind, dass die beste Schätzung des Modells über sie auch die richtige ist. Formatierung spielt weiterhin eine Rolle, nur nicht so, wie es die Blackbox-Ratschläge behaupten: Eine Seite so zu strukturieren, dass ein Abrufsystem eine saubere Antwort daraus ziehen kann, ist real und testbar, und genau darum geht es größtenteils in wie du für KI-Suche optimierst.
Lernt ChatGPT zwischen zwei Chats etwas über meine Marke?
Nein. Ein Gespräch mit ChatGPT bringt dem aktuellen Modell nichts über deine Marke bei: Seine Gewichte sind eingefroren, und das Kontextfenster, aus dem es liest, wird am Ende des Chats verworfen. Die „Memory“-Funktion ist eine Notiz pro Nutzerkonto, kein Training. Es bringt also nichts, dem Modell im Chat erklären zu wollen, wer du bist; die einzigen beiden Wege hinein sind der Trainingskorpus und der Live-Abruf, beide oben beschrieben.
Davon getrennt ist die datenschutzrechtliche Frage, die in Deutschland fast immer mitschwingt: Ob deine Eingaben in ein künftiges Training einfließen, entscheidet nicht das Modell, sondern eine Einstellung: „Das Modell für alle verbessern“ in den Datenkontrollen, plus der temporäre Chat für Unterhaltungen, die gar nicht erst im Verlauf landen. Verantwortlicher im Sinne der DSGVO ist für Nutzer im EWR die OpenAI Ireland Limited in Dublin, so schreibt es OpenAI selbst in seiner europäischen Datenschutzerklärung. Federführend ist damit nach dem One-Stop-Shop-Prinzip (Art. 56 DSGVO) die irische Data Protection Commission, nicht die Bundesbeauftragte für den Datenschutz und die Informationsfreiheit (BfDI), die für private Unternehmen wie OpenAI gar nicht zuständig ist. Eine Beschwerde nach Art. 77 DSGVO reichst du trotzdem bei der Landesdatenschutzbehörde deines Bundeslandes ein.
Was dir die Mechanik am Ende lässt
Alles, was ChatGPT gut macht, und alles, was es falsch macht, die flüssigen Absätze genauso wie die selbstbewussten Erfindungen, kommt aus derselben einen, wiederholten Schätzung. Der Wert, das zu wissen, liegt darin, was es ausschließt: Es gibt keinen versteckten Regler zum Einstellen, keinen Markeneintrag zum Bearbeiten, nichts zu kaufen.
Was dir bleibt, ist konkreter als all das. Du kannst nicht in die Gewichte greifen, aber du kannst entscheiden, ob die Crawler hinter ChatGPT deine Seiten überhaupt erreichen dürfen. Unser kostenloser AI Readiness Check liest deine robots.txt und dein Seiten-Setup und zeigt dir, was diese Crawler gerade aussperrt. Zu wissen, wie die Maschine liest, ist die eine Hälfte. Ob sie dich überhaupt lesen darf, ist die Hälfte, die du in zwei Minuten prüfen kannst.
Häufige Fragen
Wie kommt ChatGPT an seine Informationen?
Aus zwei getrennten Quellen. Meistens greift es auf parametrisches Wissen zurück, die Muster, die während des Trainings in seinen Gewichten eingefroren wurden, breit, aber festgelegt auf einen Cutoff-Zeitpunkt. Führt es eine Websuche aus, ruft es zusätzlich aktuelle Webseiten ab und fasst sie zusammen. Eine Live-Datenbank zu einzelnen Websites hat es nicht; ohne Abruf kommt alles aus dem, was es während des Trainings aufgenommen hat.
Weiß ChatGPT alles, auch über meine Website?
Nein. Es „kennt“ nur Muster aus Texten, die in seinen Trainingsdaten steckten, plus alles, was es live abruft, wenn der Abruf aktiv ist. Wurde deine Seite in den Quellen, aus denen es gelernt hat, zutreffend und häufig beschrieben, kann es Fragen zu dir gut beantworten. War das nicht der Fall, antwortet es trotzdem, indem es die wahrscheinlichsten Wörter rät, und genau so entstehen selbstbewusste, aber falsche Behauptungen über eine Marke.
Warum gibt ChatGPT jedes Mal eine andere Antwort?
Weil es aus einer Wahrscheinlichkeitsverteilung über mögliche nächste Tokens zieht, statt immer das einzelne wahrscheinlichste zu nehmen. Decoding-Einstellungen wie Temperature und Top-P steuern, wie viel Zufall erlaubt ist; APIs legen sie offen, die ChatGPT-App zeigt ihre eigenen Werte nicht an. Ein Teil der Variation, die du siehst, kommt außerdem von wechselndem Abrufverhalten, Modell-Routing und stillen Produkt-Updates, nicht nur vom Sampling. Für alle, die KI-Sichtbarkeit testen, heißt das in der Praxis: Ein einzelner Durchlauf ist eine Anekdote, keine Messung; du musst über die Zeit hinweg wiederholt Stichproben ziehen.
Merkt sich ChatGPT mich zwischen Chats?
Nicht standardmäßig. Das zugrunde liegende Modell ist zustandslos, und seine Gewichte ändern sich nicht dadurch, dass du mit ihm gesprochen hast. Innerhalb eines einzelnen Gesprächs arbeitet es mit dem Kontextfenster, das es jedes Mal frisch liest und am Ende des Chats vergisst. Die separate „Memory“-Funktion von ChatGPT speichert explizit genannte Fakten und spielt sie in künftige Chats ein, aber das ist ein zusätzlicher Datensatz. Das Modell aktualisiert sich dadurch nicht selbst.
Ist ChatGPT einfach nur Autovervollständigung?
Wörtlich genommen: ja. Es sagt aus dem bisherigen Text das nächste Token vorher, dieselbe Art von Aufgabe wie die Textvorschläge auf deinem Handy. Der Unterschied ist der Maßstab. Das über das gesamte Internet gut hinzubekommen, zwingt das Modell dazu, Fakten, Grammatik und grobe Weltmodelle mitzulernen, sodass das Ergebnis deutlich mehr kann, als das Wort „Autovervollständigung“ nahelegt, auch wenn die Mechanik wirklich so simpel ist.
Durchsucht ChatGPT bei jeder Antwort das Internet?
Nur wenn es eine Websuche ausführt, was neuere Versionen inzwischen bei vielen Fragen automatisch tun, nicht nur nach manuellem Umschalten. Ohne das antwortet das Modell aus eingefrorenem Trainingswissen und geht nicht online. Läuft die Suche, ruft es Live-Seiten ab und kann sie zitieren, und beide Modi verhalten sich unterschiedlich genug, dass es sich lohnt zu wissen, welcher hinter der Quellenangabe steckt, die du gerade siehst.
Ist ChatGPT kostenlos oder kostenpflichtig?
Beides, je nach Tarif. Der kostenlose Free-Tarif arbeitet mit demselben Mechanismus, den dieser Beitrag beschreibt, zeigt in Deutschland seit Ende August 2026 aber sichtbar gekennzeichnete Anzeigen unterhalb der Antworten; dasselbe gilt für den günstigen Go-Tarif. Plus, Pro, Business, Enterprise und Edu sind werbefrei und kommen mit höheren Nutzungsgrenzen. Für Preise, Limits und die Frage, welcher Tarif sich für dich lohnt, steht die vollständige Aufstellung in unserem Beitrag zu den ChatGPT-Kosten.
Quellen
- Vaswani et al. (2017): Attention Is All You Need (das Transformer-Paper) -
arxiv.org/abs/1706.03762 - Ouyang et al. (2022): Training language models to follow instructions with human feedback (RLHF / InstructGPT) -
arxiv.org/abs/2203.02155 - Stephen Wolfram: What Is ChatGPT Doing and Why Does It Work? -
writings.stephenwolfram.com/2023/02/what-is-chatgpt-doing-and-why-does-it-work - OpenAI Help: Does ChatGPT tell the truth? -
help.openai.com/en/articles/8313428-does-chatgpt-tell-the-truth - OpenAI: Ads in ChatGPT, expansion to Europe (August 2026) -
openai.com/index/chatgpt-ads-expands-across-europe - OpenAI: EU Privacy Policy -
openai.com/policies/eu-privacy-policy - OpenAI Developers: Bots and crawlers reference -
developers.openai.com/api/docs/bots - Wikipedia: GPT-3 (175 Milliarden Parameter, 96 Schichten) -
en.wikipedia.org/wiki/GPT-3 - The Verge: Sam Altman zum 100-Billionen-Parameter-Gerücht (Januar 2023) -
theverge.com/2023/1/18/23560328/openai-gpt4-rumor-release-sam-altman-interview - Google: AI Overviews in Deutschland (März 2025) -
blog.google/intl/de-de/produkte/suchen-entdecken/uebersicht-mit-ki-start