
Un audit SEO explique pourquoi les moteurs de recherche n’explorent pas, n’indexent pas ou ne classent pas les pages qui comptent pour vous, et ce qu’il faut corriger en premier. En 2026, il doit aussi répondre à une question plus récente : les moteurs d’IA comme ChatGPT, Perplexity et les Aperçus IA de Google peuvent-ils atteindre ces pages et les citer ?
La plupart des audits butent sur une question : par quoi commencer ? Un crawler remonte des centaines d’alertes, et personne ne décide lesquelles méritent d’être traitées. La parade : auditer dans l’ordre des dépendances, de l’accès à la citation, et classer chaque constat selon son impact sur l’activité.
Ce qu’il faut retenir
- En 2026, un audit SEO vérifie dans l’ordre si Google, Bing et les moteurs d’IA peuvent atteindre, explorer, indexer, classer puis citer vos pages : 9 étapes, de l’exploration au suivi des citations dans les réponses d’IA.
- Si le temps manque, commencez par les étapes 2 et 4 : un robot d’IA bloqué dans le robots.txt ou au niveau du CDN, ou un gabarit rangé dans un mauvais statut d’indexation, peut annuler tout le reste.
- Regroupez les constats par gabarit, classez-les selon la formule impact par page × pages concernées × confiance ÷ effort (chaque facteur de 1 à 3), et notez aussi ce que vous choisissez de laisser tel quel.
- Selon KB-COM (page modifiée le 30 septembre 2026), un audit express coûte de 500 à 900 € et un audit complet de 1 500 à 3 000 € : un repère publié par une agence qui vend des audits, pas un prix de marché.
- Les Aperçus IA et le Mode IA sont en ligne en France depuis le 22 juillet 2026 : le rapport de la Search Console sur les performances dans l’IA générative mesure l’étape 9 côté Google, en complément d’un jeu de prompts fixe.
Qu’est-ce qu’un audit SEO ?
Un audit SEO est un examen méthodique qui vérifie si les moteurs de recherche et les moteurs d’IA peuvent atteindre, explorer, indexer, classer et citer vos pages, et ce qui les en empêche. Il couvre le SEO technique, l’optimisation des pages, le contenu, les liens et, désormais, la visibilité dans les IA.
L’audit technique SEO en est la version resserrée : exploration, indexation, rendu et performances, rien d’autre. Dans les deux cas, le livrable est une liste de corrections classées en fonction d’un objectif business, et non un score de santé du site.
Certains audits vendus ne sont guère plus qu’un export de crawler habillé d’un logo. Un vrai audit s’appuie sur un outil pour repérer les problèmes potentiels, puis sur le jugement pour décider lesquels font réellement perdre du trafic.
Presque tous les audits passent en revue les mêmes couches, et plusieurs concernent désormais les moteurs d’IA, pas seulement Google.
| Couche | Ce que vous vérifiez | Outil gratuit pour commencer | Signal d’alerte |
|---|---|---|---|
| Exploration et indexation | Codes de réponse, robots.txt, sitemap XML, balises canoniques, statut d’indexation | Google Search Console, un crawler de bureau | Des gabarits importants rangés dans les statuts « non indexée » |
| Accès des robots d’IA | Quels robots d’IA votre robots.txt et votre CDN laissent passer | Les logs du serveur ou du CDN, un testeur de robots d’IA | Les robots de recherche de ChatGPT ou de Perplexity bloqués par erreur |
| Rendu | Si le texte et les liens clés figurent dans le HTML brut | Code source de la page comparé au DOM rendu | Le texte principal n’apparaît qu’après l’exécution du JavaScript |
| Performances | Core Web Vitals mesurés chez de vrais utilisateurs | PageSpeed Insights, rapport Core Web Vitals | Un gabarit qui échoue à un Core Web Vital sur mobile |
| On-page | Balises title, méta-descriptions, titres, données structurées, contrôles d’extrait | Un crawler de bureau, le test des résultats enrichis | Des balises title en double sur tout un gabarit |
| Contenu | Pages pauvres en contenu, dupliquées, en perte de vitesse ou en cannibalisation | Les données de performances de la Search Console | Deux pages de même intention qui alternent dans les résultats sur une même requête |
| Liens | Maillage interne, pages orphelines, backlinks par rapport à vos concurrents | Un crawler, le rapport sur les liens de la Search Console | Des pages stratégiques vers lesquelles pointent peu de liens internes |
| Visibilité IA | Si les réponses des IA vous mentionnent et vous citent | Un jeu de prompts fixe, le rapport sur les performances dans l’IA générative de la Search Console | Des concurrents cités sur vos questions clés, et pas vous |
Nous avons lu 15 pages françaises consacrées à l’audit SEO (guides, pages de prix, listes d’outils) le 14 octobre 2026. Aucune ne nomme GPTBot, OAI-SearchBot, Claude-SearchBot ni PerplexityBot, et aucune ne cite le rapport d’IA générative de la Search Console. Une seule, Invox, consacre une courte rubrique aux IA génératives, avec des critères généraux et sans mesure des citations ; une fiche d’outil d’Abondance évoque les « robots IA » dans l’analyse de logs.
La visibilité IA ne se mesure pas comme les positions : elle mérite sa propre étape, pas une note de bas de page dans le volet technique.
Avant de commencer : cadrer l’audit SEO
Partez d’un objectif et d’un symptôme plutôt que d’un crawl. « Trouver les problèmes SEO » débouche sur un tableur que personne ne dépouille jusqu’au bout. « Comprendre pourquoi les fiches produits ont perdu la moitié de leurs impressions en août » donne une courte liste de causes à tester.
La Search Console révèle en général de quel symptôme il s’agit :
- Des impressions sans clics : vérifiez d’abord la position et la répartition des requêtes, puis l’extrait, l’intention de recherche ou les changements liés aux Aperçus IA
- Des pages qui sortent de l’index : un problème d’indexation ou de balise canonique
- Une chute brutale du trafic organique sur tout le site : une mise à jour, une panne technique ou une action manuelle, selon la date
Pour ce dernier cas, le guide de Google sur le débogage des baisses de trafic dans la recherche distingue les mises à jour d’algorithme, les problèmes techniques, les actions manuelles et la saisonnalité. Comparez la date de la chute avec la liste des mises à jour de classement de Google, puis ouvrez le rapport sur les actions manuelles de la Search Console avant toute autre piste. Cet ordre peut vous éviter de passer des jours à corriger ce qui n’était pas en cause.
Ces outils gratuits couvrent l’essentiel d’un audit :
- La Google Search Console, pour l’indexation, les performances et le rapport sur l’IA générative
- Bing Webmaster Tools, pour Bing, les citations de Copilot et un second index de comparaison (notre guide de Bing Webmaster Tools détaille la configuration)
- PageSpeed Insights, pour les données de terrain des Core Web Vitals
- Un crawler de bureau : le Screaming Frog SEO Spider explore gratuitement 500 URL, mais le rendu JavaScript relève de la licence payante (245 € par an, prix affiché depuis la France)
Les crawlers et les outils de backlinks payants font gagner en volume et en historique, mais les questions restent les mêmes. Pour d’autres options, notre liste d'outils SEO gratuits les classe par usage.
Les entreprises locales ajoutent une vérification : la fiche d’établissement Google, puis la cohérence du nom, de l’adresse et du téléphone dans les annuaires. La visibilité dans le pack local relève d’un autre système que le classement organique.
Comment faire un audit SEO en 9 étapes
Servez-vous de ces 9 étapes comme d’une checklist d’audit SEO, dans l’ordre des dépendances. Une page doit être récupérée avant d’être rendue, rendue avant que Google l’indexe, et indexée avant de pouvoir se classer ou être citée comme lien de soutien. Les bases du SEO JavaScript décrites par Google suivent la même séquence : exploration, rendu, indexation.
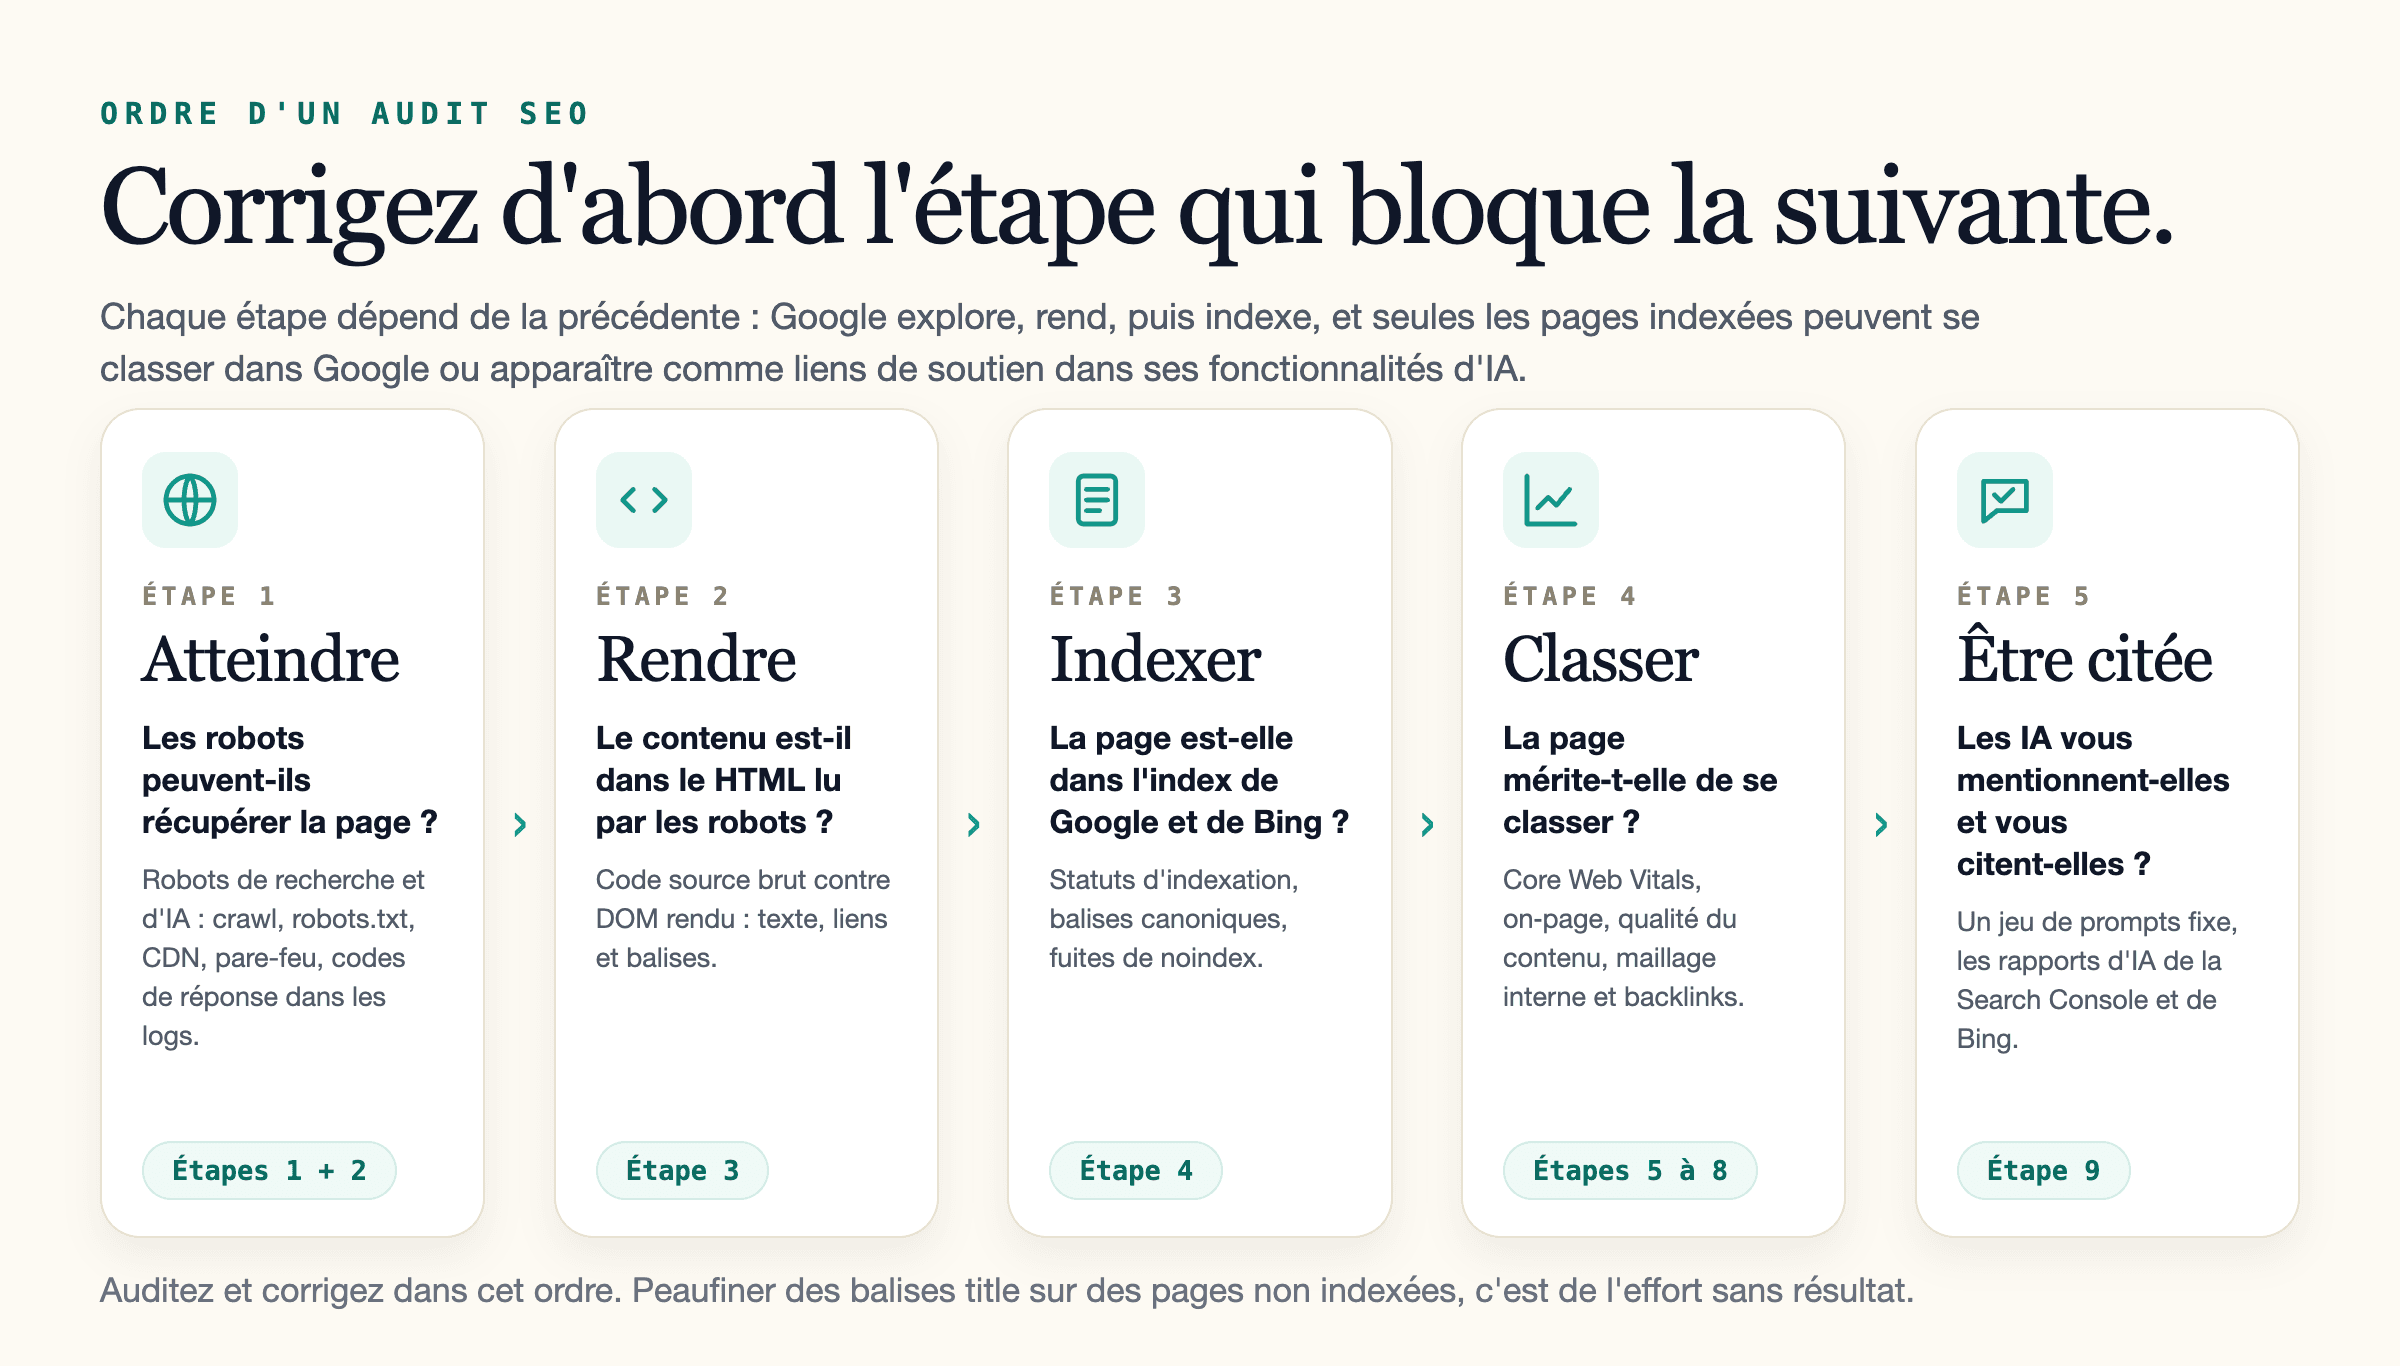
Étape 1 : explorer le site et échantillonner par gabarit
Commencez par un échantillon. Sur un site construit à partir de gabarits (templates), une page par gabarit révèle la plupart des défauts de structure plus vite qu’un crawl complet : une page catégorie, une fiche produit, un article de blog, une page locale. Si le gabarit est cassé, toutes les pages bâties dessus le sont.
Lancez ensuite un crawl de tout le site pour mesurer jusqu’où chaque problème s’étend. Utilisez un user-agent de smartphone, puisque Google indexe la version mobile de vos contenus, respectez le robots.txt et activez le rendu JavaScript si le site en dépend. Comparez alors trois listes d’URL :
- ce que le crawler a trouvé en suivant les liens
- ce que votre sitemap XML déclare comme devant exister
- un échantillon de ce que la Search Console donne pour indexé (ses listes d’exemples s’arrêtent à 1 000 URL : confirmez les URL clés avec l’outil d’inspection d’URL)
Les écarts entre ces listes sont vos premiers constats. Les URL du sitemap que le crawler n’a jamais atteintes sont des pages orphelines probables, ou des liens que votre crawler n’a pas su suivre. Celles que le crawler a trouvées mais qui manquent au sitemap appellent une décision : ajoutez les pages canoniques que vous voulez indexer, et ne redirigez que les chemins qui ont bel et bien changé d’adresse.
Relevez, par gabarit, les réponses 4xx et 5xx, les chaînes de redirection de plus d’un saut et la profondeur de clic jusqu’à vos pages stratégiques. Vérifiez que les versions http, https, www et sans www de la page d’accueil redirigent toutes vers l’unique version HTTPS que vous voulez indexer.
Le rapport « Statistiques sur l’exploration » de la Search Console montre les réponses que Googlebot a réellement reçues et les éventuels problèmes de disponibilité de l’hôte : il met au jour des erreurs serveur ou de pare-feu que votre propre crawler ne voit jamais.
Étape 2 : vérifier que les robots d’IA peuvent accéder au site
Les entreprises d’IA exploitent des robots distincts pour la recherche et pour l’entraînement, et un robots.txt écrit pour bloquer « l’IA » bloque souvent le robot qui vous aurait cité. Une seule ligne peut vous retirer des réponses de recherche d’un moteur.
Passez le robots.txt en revue groupe par groupe, pour les user-agents ci-dessous. La liste complète, robots déclenchés par l’utilisateur compris, figure dans notre guide des robots d’IA.
| User-agent | Entreprise | Ce qu’il fait | Si vous le bloquez |
|---|---|---|---|
| Googlebot | Explore pour la Recherche, Aperçus IA et Mode IA compris | Vos pages ne sont plus explorées pour la Recherche Google, fonctionnalités d’IA comprises | |
| Google-Extended | Un jeton de contrôle pour l’entraînement et l’ancrage de Gemini, pas un robot distinct | Aucun effet sur la Recherche Google ; vous refusez l’entraînement de Gemini et l’ancrage dans les applications Gemini et sur Vertex AI | |
| Bingbot | Microsoft | Explore pour Bing, un socle que partage la recherche de Copilot | Bing cesse d’explorer vos pages, ce qui peut réduire votre visibilité dans Bing et dans la recherche de Copilot |
| OAI-SearchBot | OpenAI | Fait apparaître les sites dans les résultats de la recherche de ChatGPT | Vous sortez des réponses de la recherche de ChatGPT, tout en pouvant encore y figurer comme lien de navigation |
| GPTBot | OpenAI | Collecte du contenu pour entraîner les modèles d’OpenAI | Refus de l’entraînement uniquement ; la recherche se règle à part |
| Claude-SearchBot | Anthropic | Améliore les résultats de recherche de Claude | Peut réduire votre visibilité dans les réponses de recherche de Claude |
| PerplexityBot | Perplexity | Fait apparaître les sites dans les résultats de Perplexity, avec un lien vers eux, sans servir à l’entraînement des modèles | Vous pouvez sortir des résultats de Perplexity |
La documentation de Google sur ses robots d’exploration est explicite : Google-Extended « n’a aucune incidence sur l’inclusion d’un site dans la recherche Google ». Le bloquer pour échapper aux Aperçus IA ne sert donc à rien (l’étape 6 présente le réglage qui y parvient). OpenAI traite OAI-SearchBot et GPTBot comme deux réglages indépendants, et Anthropic sépare Claude-SearchBot de ClaudeBot, son robot d’entraînement.
Reste la couche qui échappe au robots.txt. Un CDN ou un pare-feu peut bloquer un robot que votre robots.txt autorise. Cloudflare range désormais les robots d’IA en classes Recherche, Agent et Entraînement, et depuis sa mise à jour du 15 septembre 2026, les réglages « Block » et « Block on pages with ads » s’appliquent aussi aux robots à usage mixte comme Googlebot, Bingbot et Applebot, recherche comprise.
Le réglage qui refuse l’entraînement tout en gardant la recherche s’appelle « Disallow AI Training ». Cloudflare le propose aux nouveaux domaines financés par la publicité dès l’inscription, avec le blocage des agents sur les pages publicitaires, et indique que les blocages « Training » existants migrent vers lui. Microsoft vise début 2027 pour que Bing respecte cette préférence via le robots.txt, selon le même billet.
Lisez les codes de réponse que les robots ont effectivement reçus. Filtrez les logs du serveur ou du CDN par user-agent, puis vérifiez que les requêtes proviennent des plages d’IP publiées par chaque entreprise : un user-agent se falsifie très facilement.
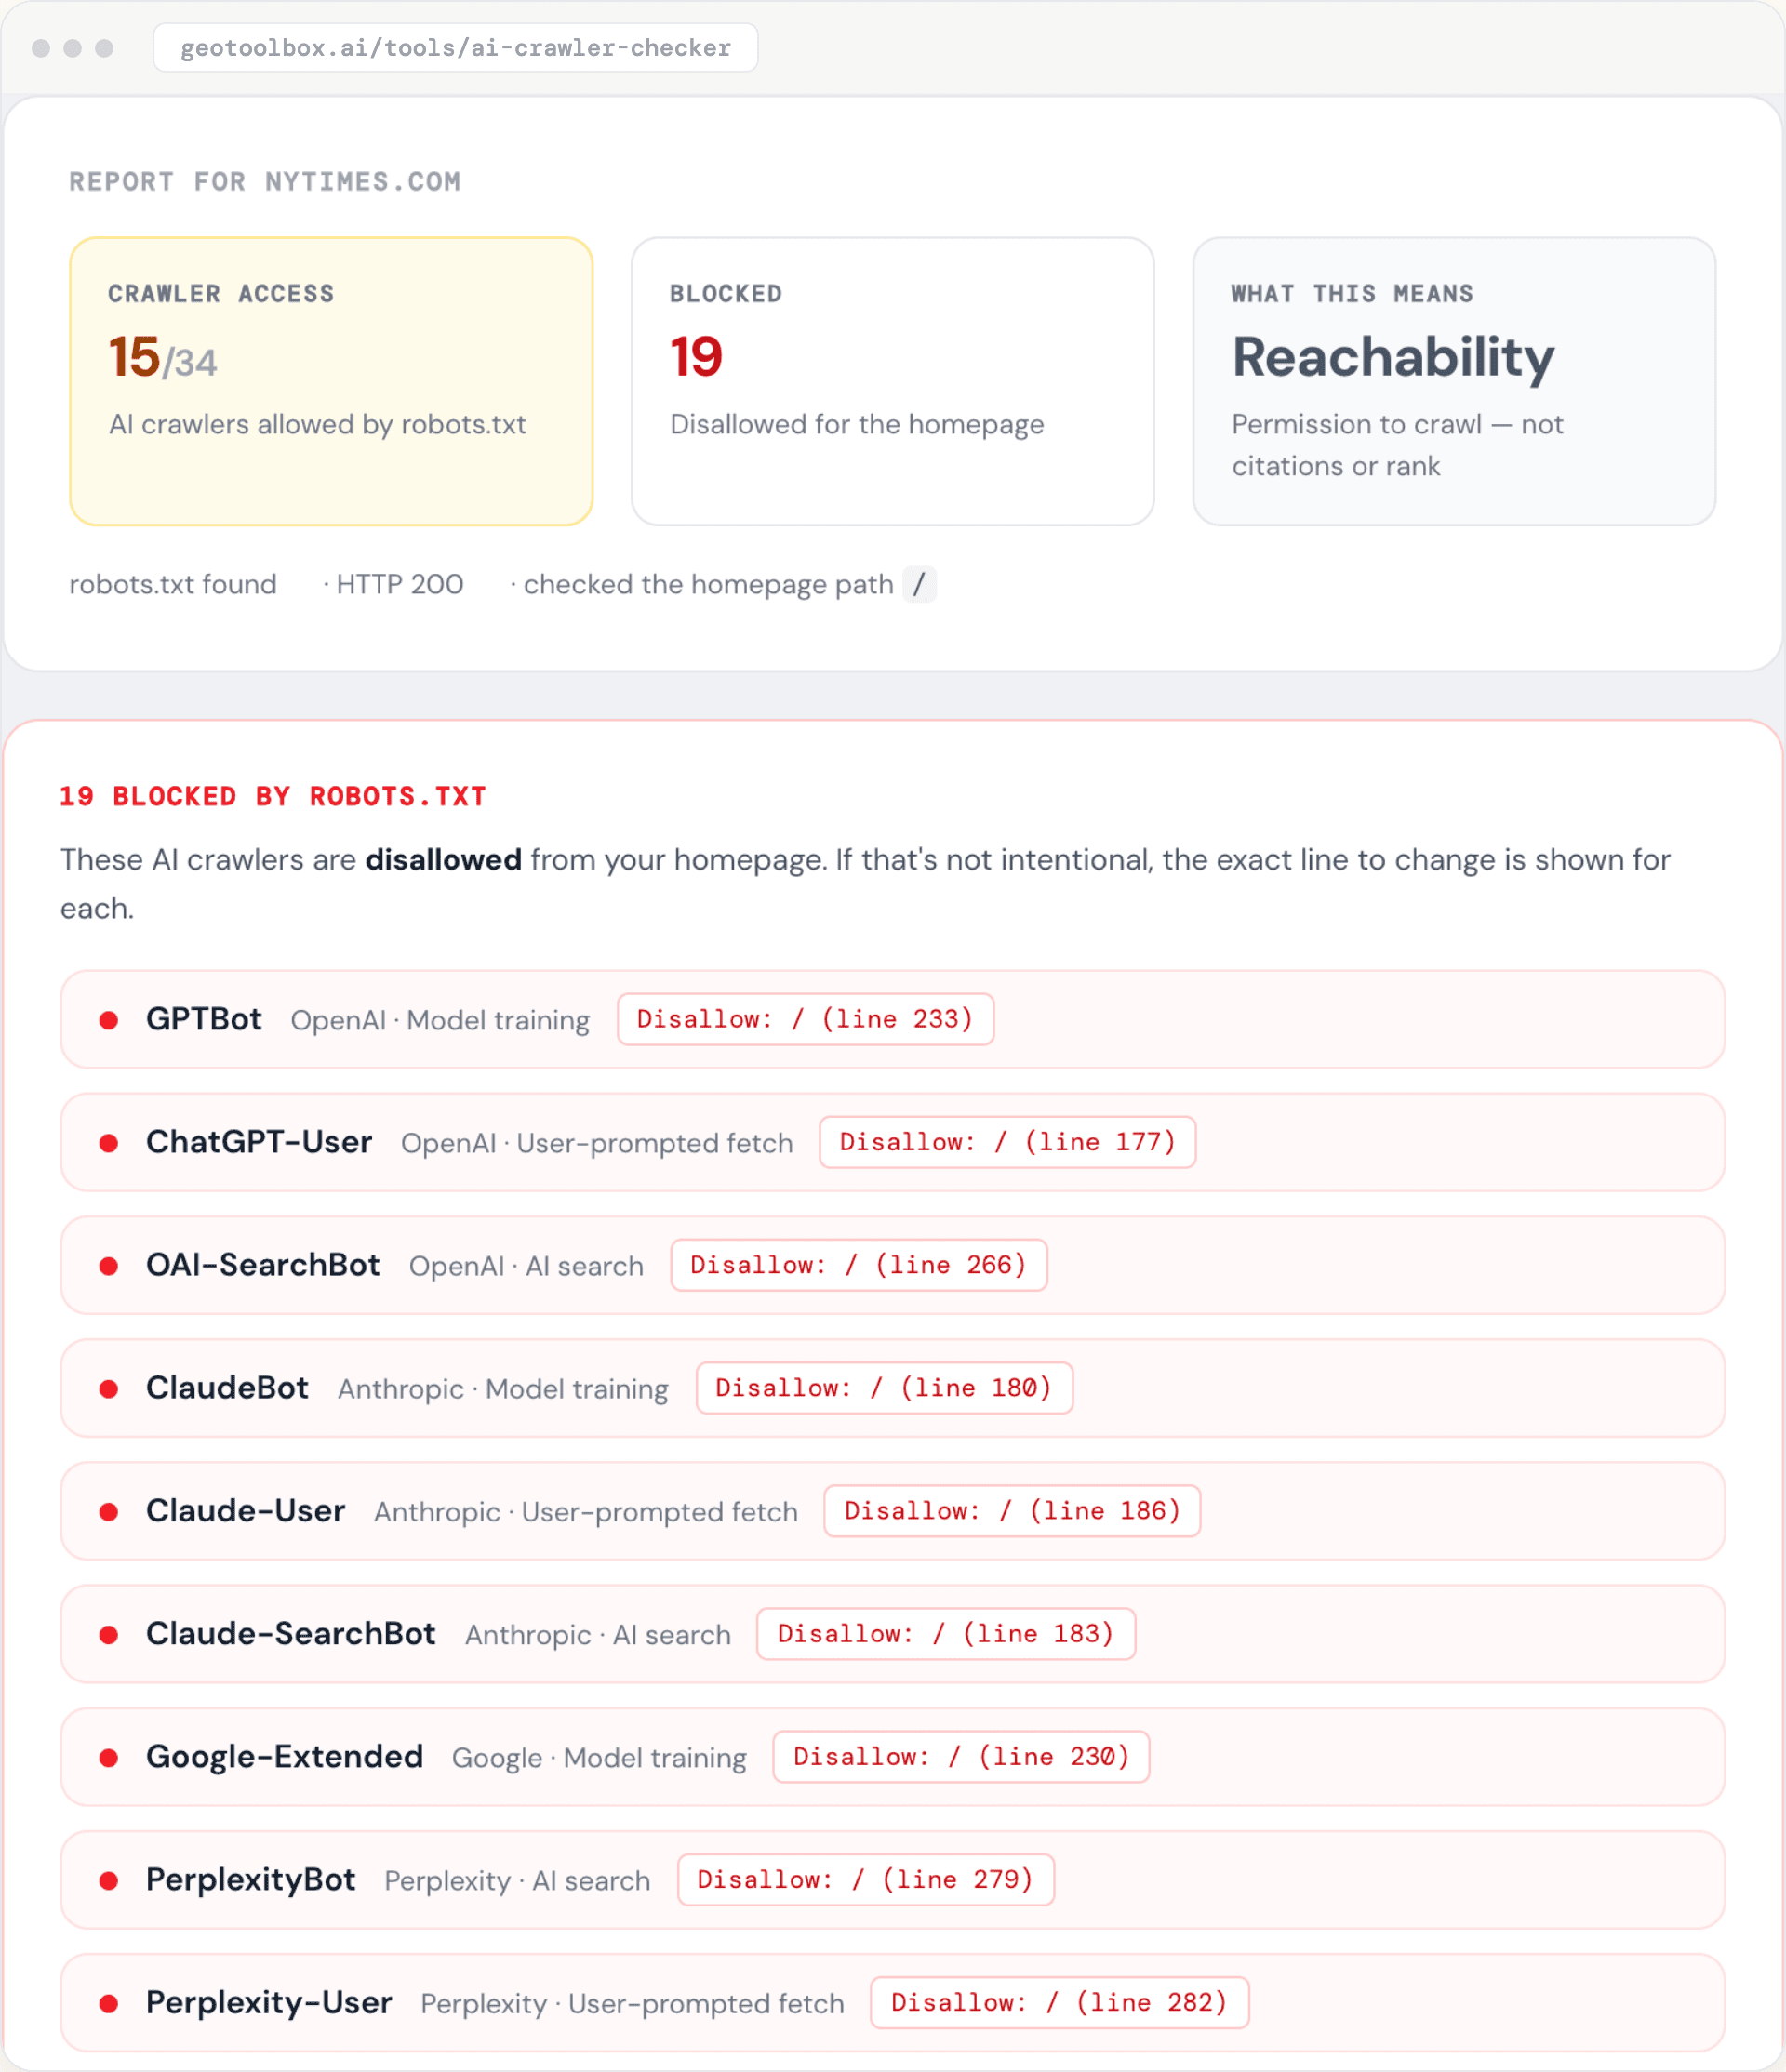
Pour un premier passage rapide, l'AI Crawler Checker gratuit de geotoolbox lit votre robots.txt pour 34 user-agents d’IA documentés (robots de recherche, robots d’entraînement et agents déclenchés par un utilisateur) et affiche la ligne exacte qui bloque.
Il ne teste que le chemin de la page d’accueil : vérifiez à la main chaque chemin de gabarit. Il lit par ailleurs l’autorisation inscrite dans le robots.txt, et non ce que votre CDN sert réellement. Notre guide de GPTBot traite de la décision d’autoriser ou de bloquer ce robot. Un fichier llms.txt est facultatif et ne contrôle aucun accès ; il ne remplace jamais du HTML explorable, comme l’explique notre guide du llms.txt.
Étape 3 : comparer le HTML brut et la page rendue
Google exécute le JavaScript avant d’indexer une page : un contenu construit par des scripts peut tout de même se positionner. Beaucoup d’assistants d’IA, eux, ne l’exécutent pas. Dans le test de Search Engine World, où l’on collait des URL dans les assistants, ChatGPT, Claude et Gemini n’ont rapporté que le HTML brut ; l’assistant de Mistral a, lui, exécuté le JavaScript.
La situation évolue vite, et notre guide du SEO JavaScript la suit robot par robot. Les logs serveur d’un développeur indiquent que les robots d’OpenAI ont commencé à exécuter le JavaScript le 25 septembre 2026, ce qu’OpenAI n’a pas confirmé.
Considérez le HTML brut comme ce qu’un assistant d’IA autre que les Aperçus IA et le Mode IA de Google est susceptible de voir. Ouvrez le code source une fois par gabarit et cherchez :
- le texte principal et le H1
- la balise canonique et la balise meta robots
- les liens internes vers vos pages importantes
- les prix, caractéristiques ou autres faits que vous voulez voir cités
Si l’un de ces éléments n’apparaît que dans le DOM rendu, ce gabarit dépend du JavaScript pour un contenu dont une réponse d’IA a besoin. Côté Google, le test de l’URL active dans l’outil d’inspection d’URL de la Search Console affiche le HTML rendu (voir l’étape 4).
La correction est la même quels que soient les robots qui exécutent le JavaScript : rendu côté serveur, génération statique ou prérendu pour le contenu qui compte.
Étape 4 : contrôler l’indexation dans la Google Search Console
Ouvrez le rapport sur l’indexation des pages et lisez les motifs qui se cachent derrière les totaux. Presque tous les sites comptent des URL non indexées, et beaucoup d’entre elles n’ont pas vocation à être indexées. La question est de savoir si un gabarit dont vous avez besoin se retrouve dans un statut que vous n’aviez pas voulu.
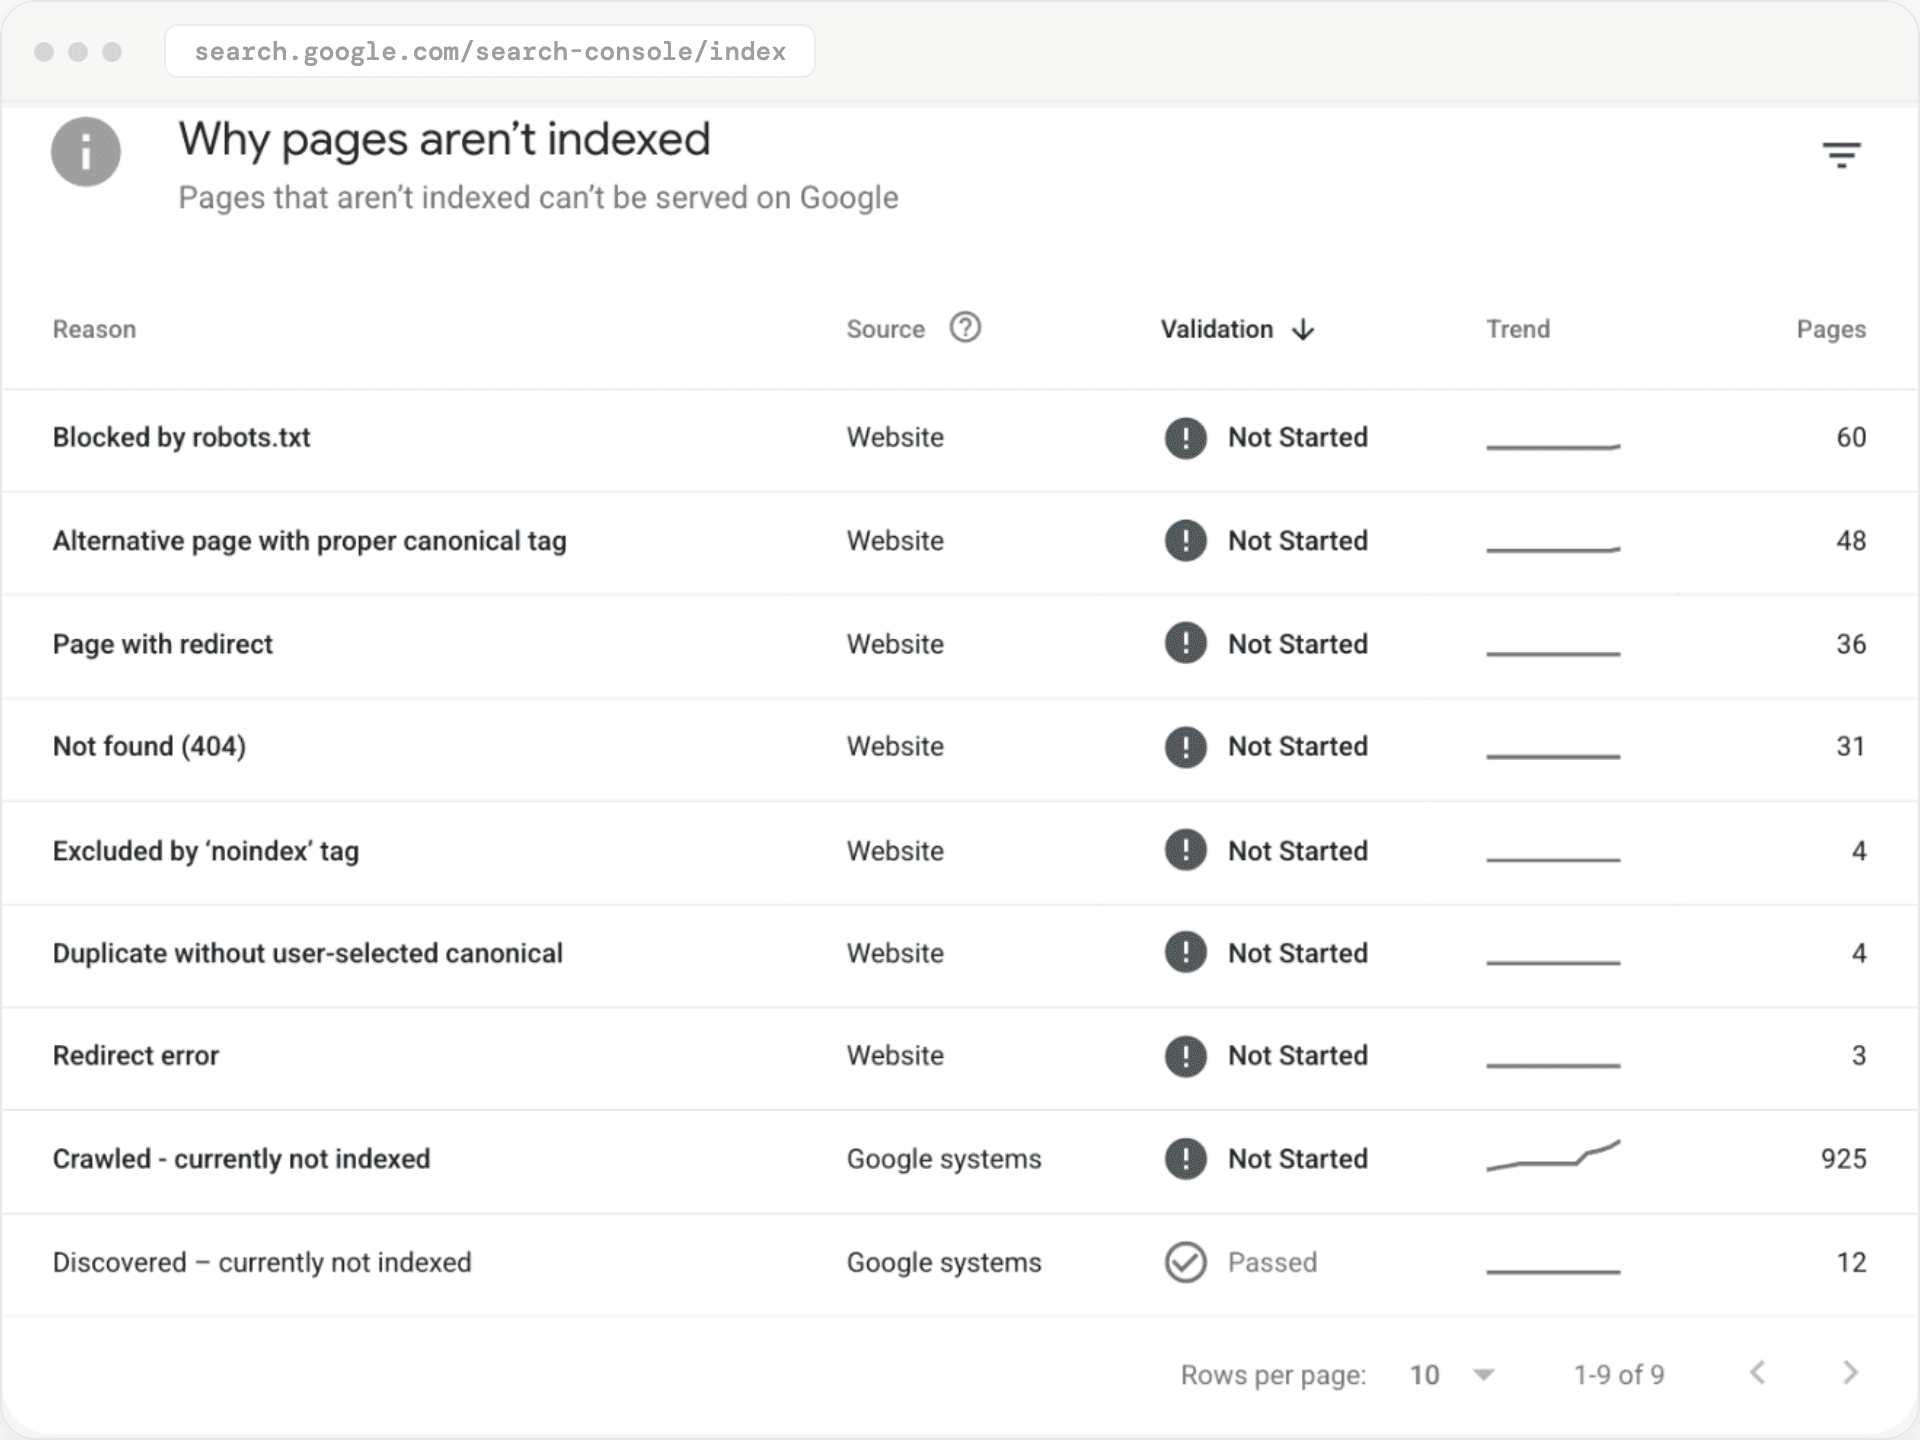
La documentation du rapport sur l’indexation des pages définit chaque statut. Voici ceux qui masquent le plus souvent un vrai problème :
- Explorée, actuellement non indexée : Google a exploré la page sans l’indexer. Selon lui, « elle sera peut-être indexée à l’avenir ; il n’est pas nécessaire de renvoyer cette URL pour l’exploration ». Renvoyer l’URL n’est pas la solution. Un gabarit entier dans ce statut mérite une enquête : vérifiez les dates d’exploration, le contenu rendu et le choix de la canonique avant de conclure à un problème de qualité ou de duplication.
- Détectée, actuellement non indexée : Google connaît l’URL mais a reporté l’exploration, en règle générale parce que l’explorer à ce moment-là risquait de surcharger le site. Sur un grand site, cela renvoie au budget d’exploration (crawl budget), à la vitesse du serveur ou à un excès d’URL sans valeur.
- « Page en double : Google a choisi une autre URL canonique que l’utilisateur » signifie que votre balise canonique désigne une URL et que Google en a indexé une autre. C’est le statut de canonique qui mérite le plus d’attention.
- Pages exclues par une balise noindex (statut « URL marquée "noindex" » dans l’aide de la Search Console) : normal sur les pages utilitaires, désastreux sur des pages catégories après une mise en production depuis la préprod.
D’autres statuts sont normaux dès lors qu’ils sont voulus. « Autre page avec balise canonique correcte » signifie qu’une URL alternative pointe vers une canonique indexée, et « Page avec redirection » que l’ancienne URL redirige : vérifiez que les destinations sont les bonnes, puis passez à la suite.
Les erreurs serveur (5xx) et les erreurs liées à des redirections, elles, ne relèvent jamais de ce groupe. Un blocage par le fichier robots.txt n’y entre que si quelqu’un a voulu cette règle : Google rappelle lui-même que les URL bloquées par robots.txt le sont « probablement intentionnellement ». Notre guide des balises canoniques détaille les statuts de duplication.
Servez-vous de l'outil d’inspection d’URL sur un exemple par statut à problème. Le résultat indexé montre l’URL canonique sélectionnée par Google, et le test de l’URL active affiche le HTML rendu : un statut vague devient une cause concrète.
Sur les sites multilingues, vérifiez que les balises hreflang sont réciproques (chaque version renvoie vers les autres), et que la version mobile porte le même contenu et les mêmes données structurées que la version bureau.
Refaites le même passage dans Bing Webmaster Tools. Les consignes de Bing précisent que ses expériences de recherche et celles de Copilot reposent sur le même socle d’exploration, d’indexation et de classement : une page que Google indexe et que Bing ignore risque de manquer aussi dans les réponses de recherche de Copilot.
Étape 5 : contrôler les Core Web Vitals avec les données de terrain
Auditez les Core Web Vitals à partir de données de terrain, mesurées chez de vrais utilisateurs. Les seuils que Google publie sur web.dev sont un Largest Contentful Paint (LCP) de 2,5 secondes au plus, une Interaction to Next Paint (INP) de 200 millisecondes ou moins et un Cumulative Layout Shift (CLS) de 0,1 ou moins, mesurés au 75e centile des chargements de page.
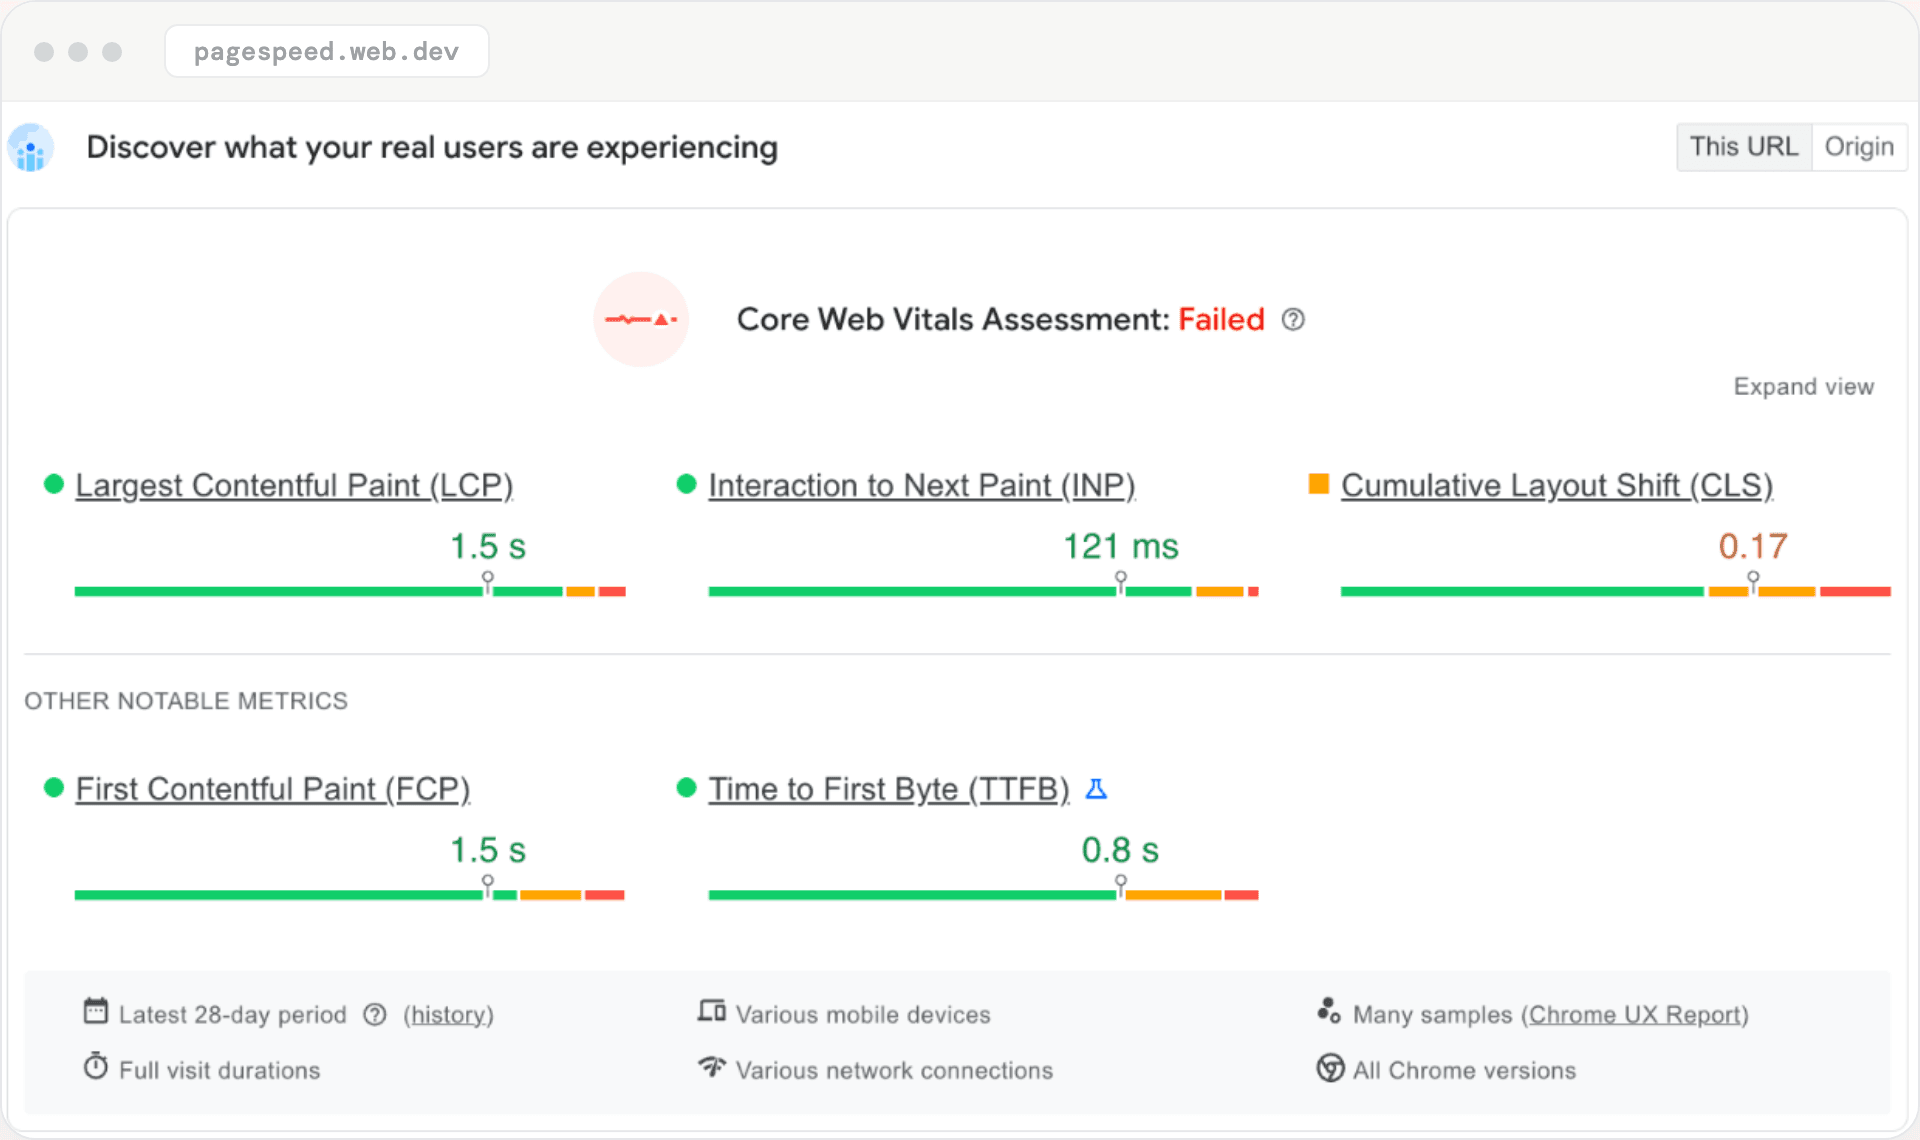
PageSpeed Insights affiche ces données de terrain en haut du rapport quand Chrome a recueilli assez de données pour l’URL ou l’origine. Le rapport Core Web Vitals de la Search Console regroupe les mêmes données par URL similaires, ce qui correspond bien aux gabarits. Un score de laboratoire isolé en dit moins que « le gabarit produit échoue à l’INP sur mobile ».
Certains points des vieilles checklists d’audit ne sont plus d’actualité :
- Le First Input Delay a disparu. L’INP a remplacé le FID parmi les Core Web Vitals le 12 mars 2024 : un audit qui suit encore le FID s’appuie sur une métrique abandonnée.
- Le test d’optimisation mobile aussi. Google a retiré le test d’optimisation mobile (Mobile-Friendly Test) et le rapport « Ergonomie mobile » le 1er décembre 2023. Vérifiez le rendu mobile avec Lighthouse ou sur un vrai appareil.
Relativisez le poids de la vitesse : accélérer une page que Google n’a pas indexée ne la sauvera pas.
Étape 6 : auditer les éléments on-page et les contrôles d’extrait
Les contrôles on-page produisent les listes les plus longues pour les gains les plus minces : auditez-les par gabarit. Un title manquant sur un article de blog est une coquille. Un gabarit produit qui écrit la même balise title sur des milliers de pages est un vrai constat d’audit.
Vérifiez, par gabarit :
- Balises title : uniques, descriptives, avec le terme recherché placé au début
- Méta-descriptions : présentes et précises, même si Google réécrit souvent l’extrait
- Titres : un H1 clair, en phase avec l’objet de la page
- Données structurées : valides dans le test des résultats enrichis et conformes à ce que la page affiche
- Texte alternatif des images : descriptif sur les images porteuses de sens, et alt="" vide sur les images décoratives
Les contrôles d’extrait ont aujourd’hui une portée plus large. La documentation de Google sur la balise meta robots précise que la règle nosnippet s’applique aux Aperçus IA et au Mode IA et « empêche également l’utilisation du contenu en tant qu’entrée directe pour les Aperçus IA et le Mode IA ».
Un nosnippet laissé sur un gabarit par une ancienne relecture juridique peut tenir ces pages à l’écart des réponses d’IA, et un max-snippet serré limite la part de la page qu’elles peuvent exploiter. Il en va de même pour data-nosnippet posé autour de tout un bloc de contenu. Notre guide des balises meta pour le SEO recense celles que Google et Bing Copilot lisent, et ce que ChatGPT et Perplexity documentent à la place.
La Search Console propose aussi un contrôle de l’IA générative dans la Recherche, sous Paramètres > IA générative dans la Recherche. Ce réglage détermine si la propriété figure dans les Aperçus IA, le Mode IA et les fonctionnalités d’IA générative de Google Discover. D’après l’annonce de Google France du 22 juillet 2026, il est disponible en France : vérifiez que quelqu’un a choisi son réglage actuel en connaissance de cause.
Tout cela est légitime quand c’est une décision. Notre guide pour désactiver les Aperçus IA explique quand des sites choisissent de s’en retirer. Dans un audit, le constat à faire est un contrôle d’extrait que plus personne ne se rappelle avoir posé.
Les données structurées appellent le même réalisme. Elles aident les moteurs à lire la page et la rendent éligible aux résultats enrichis, mais le balisage Schema pour la recherche IA ne garantit pas les citations. Vérifiez qu’il est exact et conforme à la page : un balisage superflu ou non étayé ne vous vaudra pas de citations à lui seul.
Étape 7 : examiner la qualité du contenu et la cannibalisation
Exportez les données de performances de la Search Console par page sur les 12 derniers mois et placez-les à côté de votre crawl. Conservez cet export : c’est la base de référence à l’aune de laquelle vous jugerez vos corrections. Chaque URL indexable reçoit alors l’une des cinq décisions suivantes : conserver, mettre à jour, fusionner, rediriger ou supprimer.
Les cas de figure à repérer :
- Le déclin : des pages dont les clics baissent régulièrement alors que la demande sur leurs requêtes ne bouge pas ; la comparaison de dates de la Search Console, triée par écart de clics, les fait remonter vite
- La cannibalisation : deux URL de même intention qui alternent dans les résultats sur une même requête, sans qu’aucune ne s’y installe durablement
- Les pages pauvres en contenu et le contenu dupliqué : des pages quasi identiques (localités, étiquettes, filtres) qui diluent le site, ou une même page accessible à plusieurs adresses
Associez chaque page stratégique à la requête principale sur laquelle elle doit se classer, puis comparez vos mots-clés à ceux des sites qui vous devancent. Les requêtes sur lesquelles ils se positionnent sans que vous ayez de page sont des lacunes de contenu.
Vérifiez les signaux de confiance au passage. Les questions de Google sur le contenu utile demandent si une page présente des sources claires et des informations sur l’auteur ou le site, comme une page d’auteur ou une page « À propos ». Ce sont les signaux visibles de l’expérience, de l’expertise, de l’autorité et de la fiabilité (E-E-A-T).
Élaguez avec prudence. Supprimer sans redirection une page qui reçoit des liens ou du trafic référent transforme une page faible en page cassée. Fusionner des articles qui se recoupent en une seule page plus solide, avec une redirection 301 depuis l’article absorbé, est la plupart du temps la meilleure option.
Étape 8 : contrôler le maillage interne et les backlinks
Commencez par le maillage interne, la partie que vous maîtrisez entièrement. À partir du crawl, listez les pages orphelines, les liens internes cassés et toute page stratégique enfouie profondément dans le parcours de clics, puis vérifiez que les ancres décrivent la page cible.
Pour les backlinks, comparez vos domaines référents à ceux des quelques sites qui vous devancent, et recensez les liens utiles que vous avez perdus. Cet écart n’est qu’une hypothèse parmi d’autres pour expliquer un plafond de classement, à peser après la pertinence et l’éligibilité technique. Vérifiez également si certaines de vos URL en 404 reçoivent encore des backlinks : rétablissez le contenu, ou redirigez vers une page qui le remplace vraiment.
Traitez les scores de « liens toxiques » comme une estimation de tri propre à chaque fournisseur d’outils, et non comme un verdict de Google. La documentation de Google sur le désaveu de liens cadre l’outil autour d’une action manuelle pour liens artificiels, ou du risque d’en recevoir une à cause de liens payants ou d’autres systèmes de liens. Sa version française précise que « cet outil n’a pas d’utilité pour la majorité des sites », et sa version anglaise le qualifie de fonctionnalité avancée qui, mal utilisée, peut nuire aux performances du site dans la recherche Google. Sans action manuelle ni historique de liens achetés, pas de fichier de désaveu, en règle générale.
Étape 9 : vérifier si les réponses d’IA vous citent
La dernière étape mesure le résultat que toutes les précédentes protègent. Écrivez un jeu fixe de quelques dizaines de prompts que vos acheteurs poseraient vraiment, puis lancez-les dans les Aperçus IA et le Mode IA de Google, ChatGPT, Perplexity, Gemini et Copilot.
Notez pour chaque exécution le moteur, la date et le lieu, et refaites le jeu à des jours différents, car les réponses varient. Consignez séparément si vous êtes mentionné et si l’une de vos pages est citée comme source.
Deux rapports officiels facilitent aujourd’hui cette mesure :
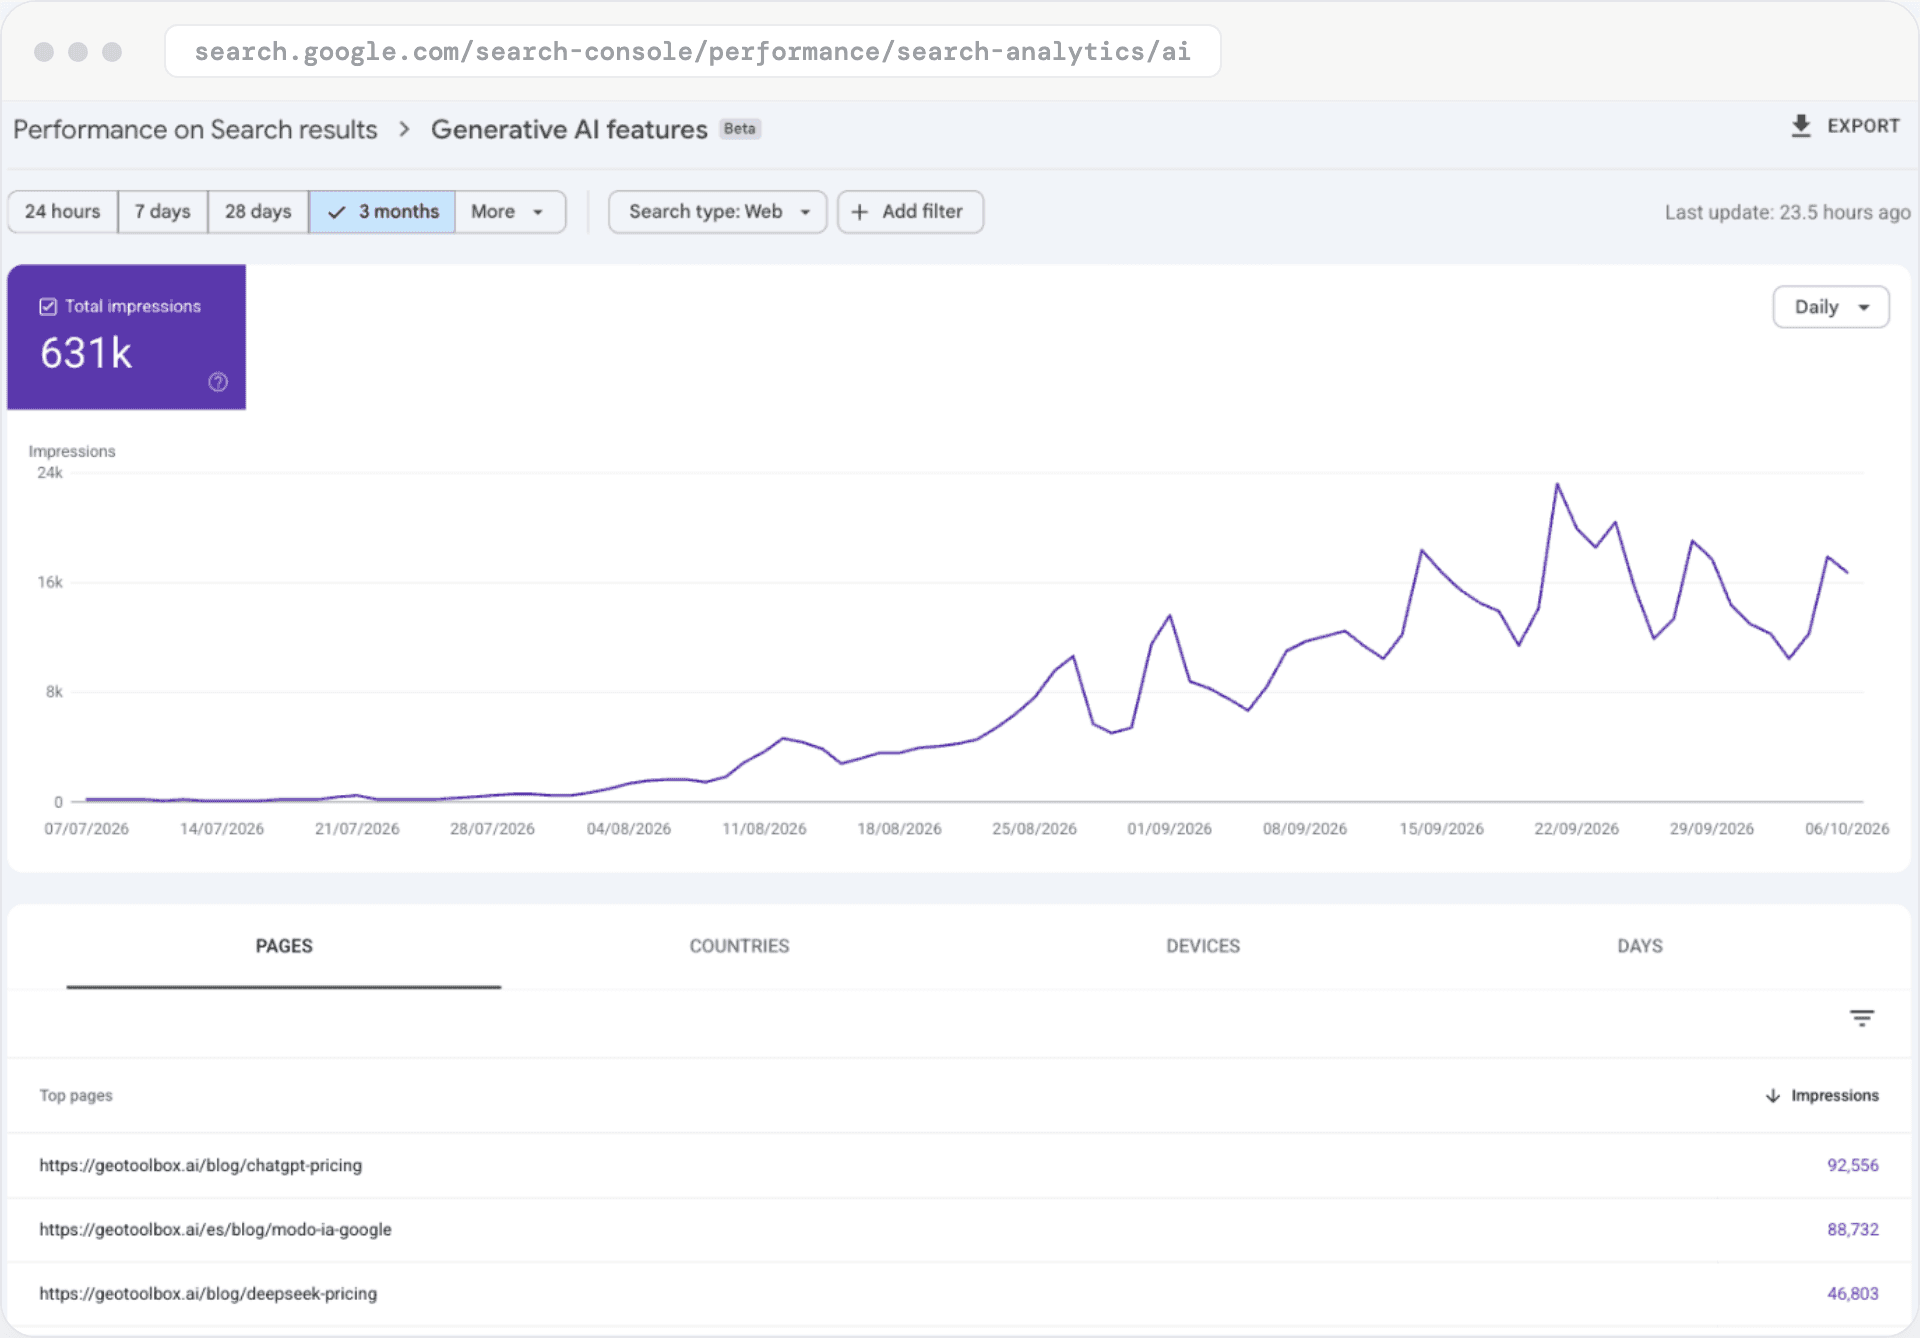
- Le rapport de la Search Console sur les performances dans l’IA générative, étiqueté bêta dans notre capture, compte les impressions issues des Aperçus IA et du Mode IA. Google indique l’avoir déployé pour tous les sites à partir du 31 août 2026. En France, les Aperçus IA et le Mode IA sont en ligne depuis le 22 juillet 2026, selon l’annonce de Google France : ce rapport fournit une mesure de première main pour un site français.
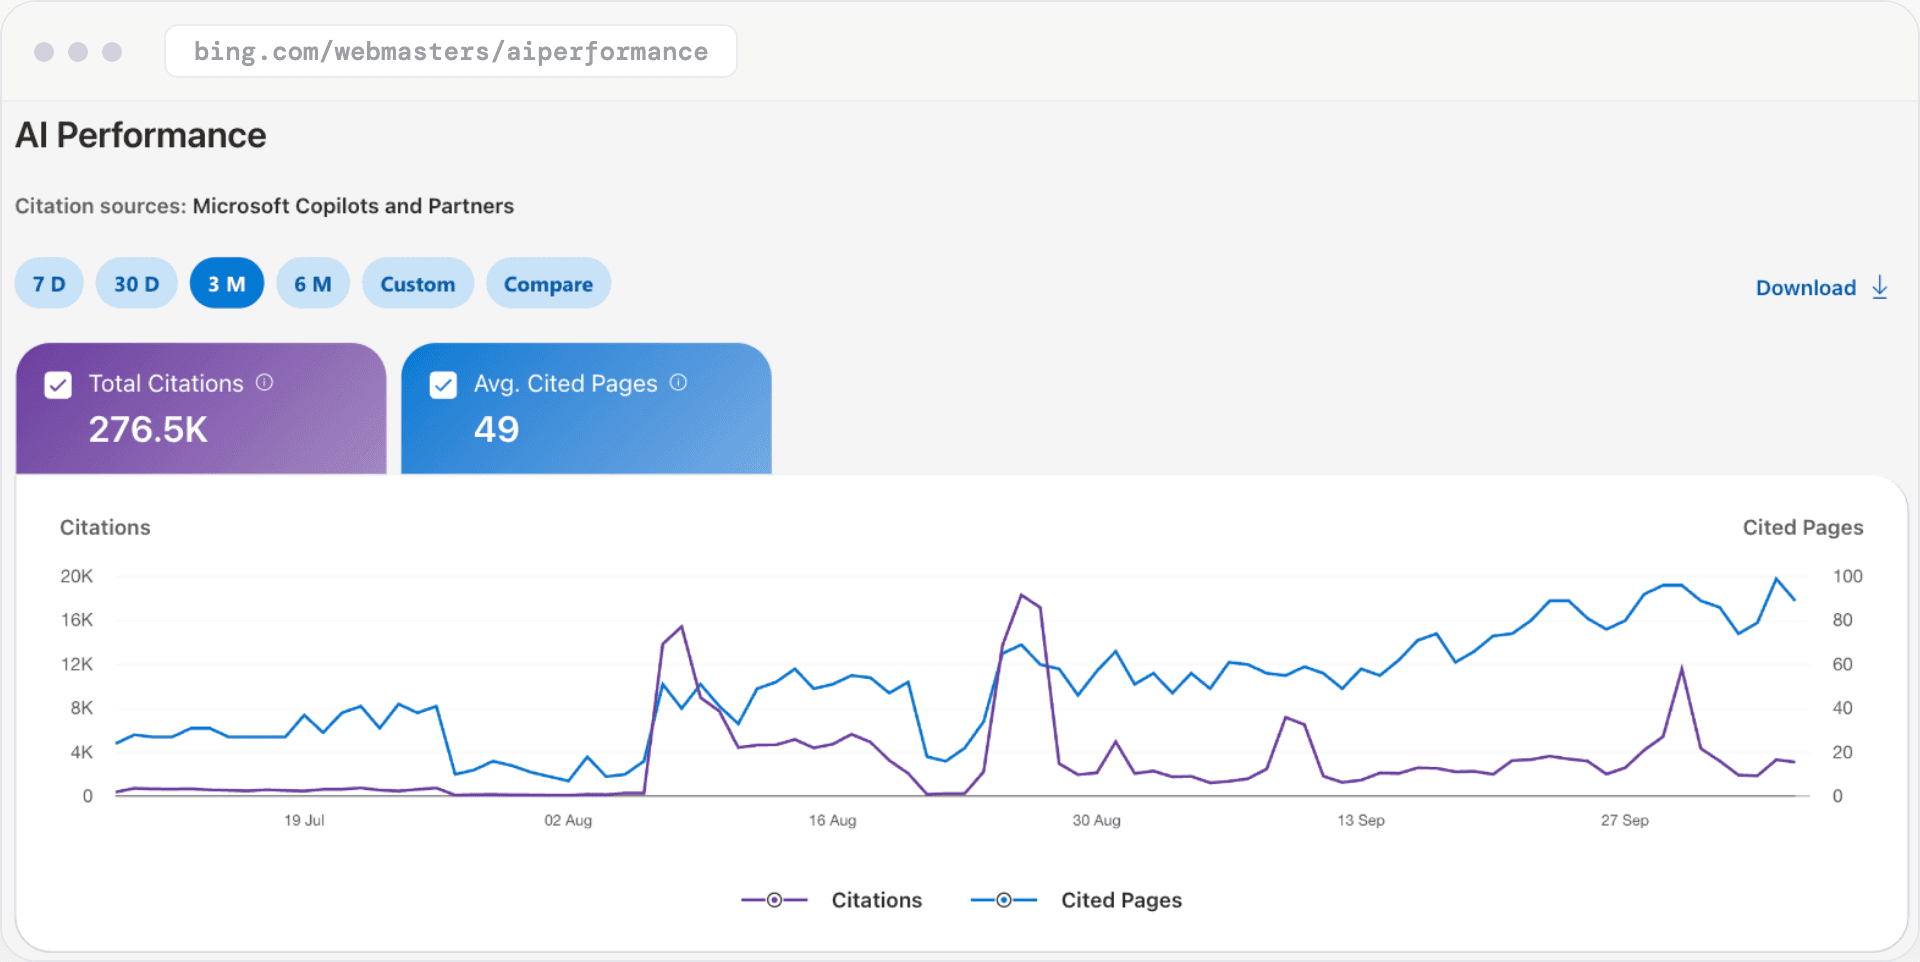
- Le rapport AI Performance de Bing Webmaster Tools, lancé en préversion publique en février 2026 puis enrichi en juin et en octobre 2026, compte les citations de vos pages dans Microsoft Copilot, les résumés IA de Bing et certaines intégrations partenaires, et montre les requêtes d’ancrage (grounding queries) derrière ces citations. À notre relevé du 14 octobre 2026, il est toujours en préversion.
Ne prenez pas les visites venues des IA dans votre outil d’analytics pour de la visibilité dans les IA. Une réponse peut vous citer sans envoyer personne, ou envoyer des clics à un concurrent cité à vos côtés. Prenez avec la même prudence les scores de visibilité des fournisseurs d’outils : confrontez chaque score à des réponses que vous avez vous-même obtenues.
Cette étape mérite sa propre méthode, que notre audit de visibilité IA détaille. Pour Google en particulier, un suivi des Aperçus IA enregistre si vous apparaissez sur vos prompts dans la durée, ce qui transforme un contrôle ponctuel en base de référence.
Pour automatiser cette mesure, le tracker payant de geotoolbox exécute votre jeu de prompts sur ChatGPT, Perplexity, Gemini, Claude, les Aperçus IA, le Mode IA, Copilot et Grok, le nombre de moteurs dépendant de l’offre.
Comment prioriser les résultats de l’audit
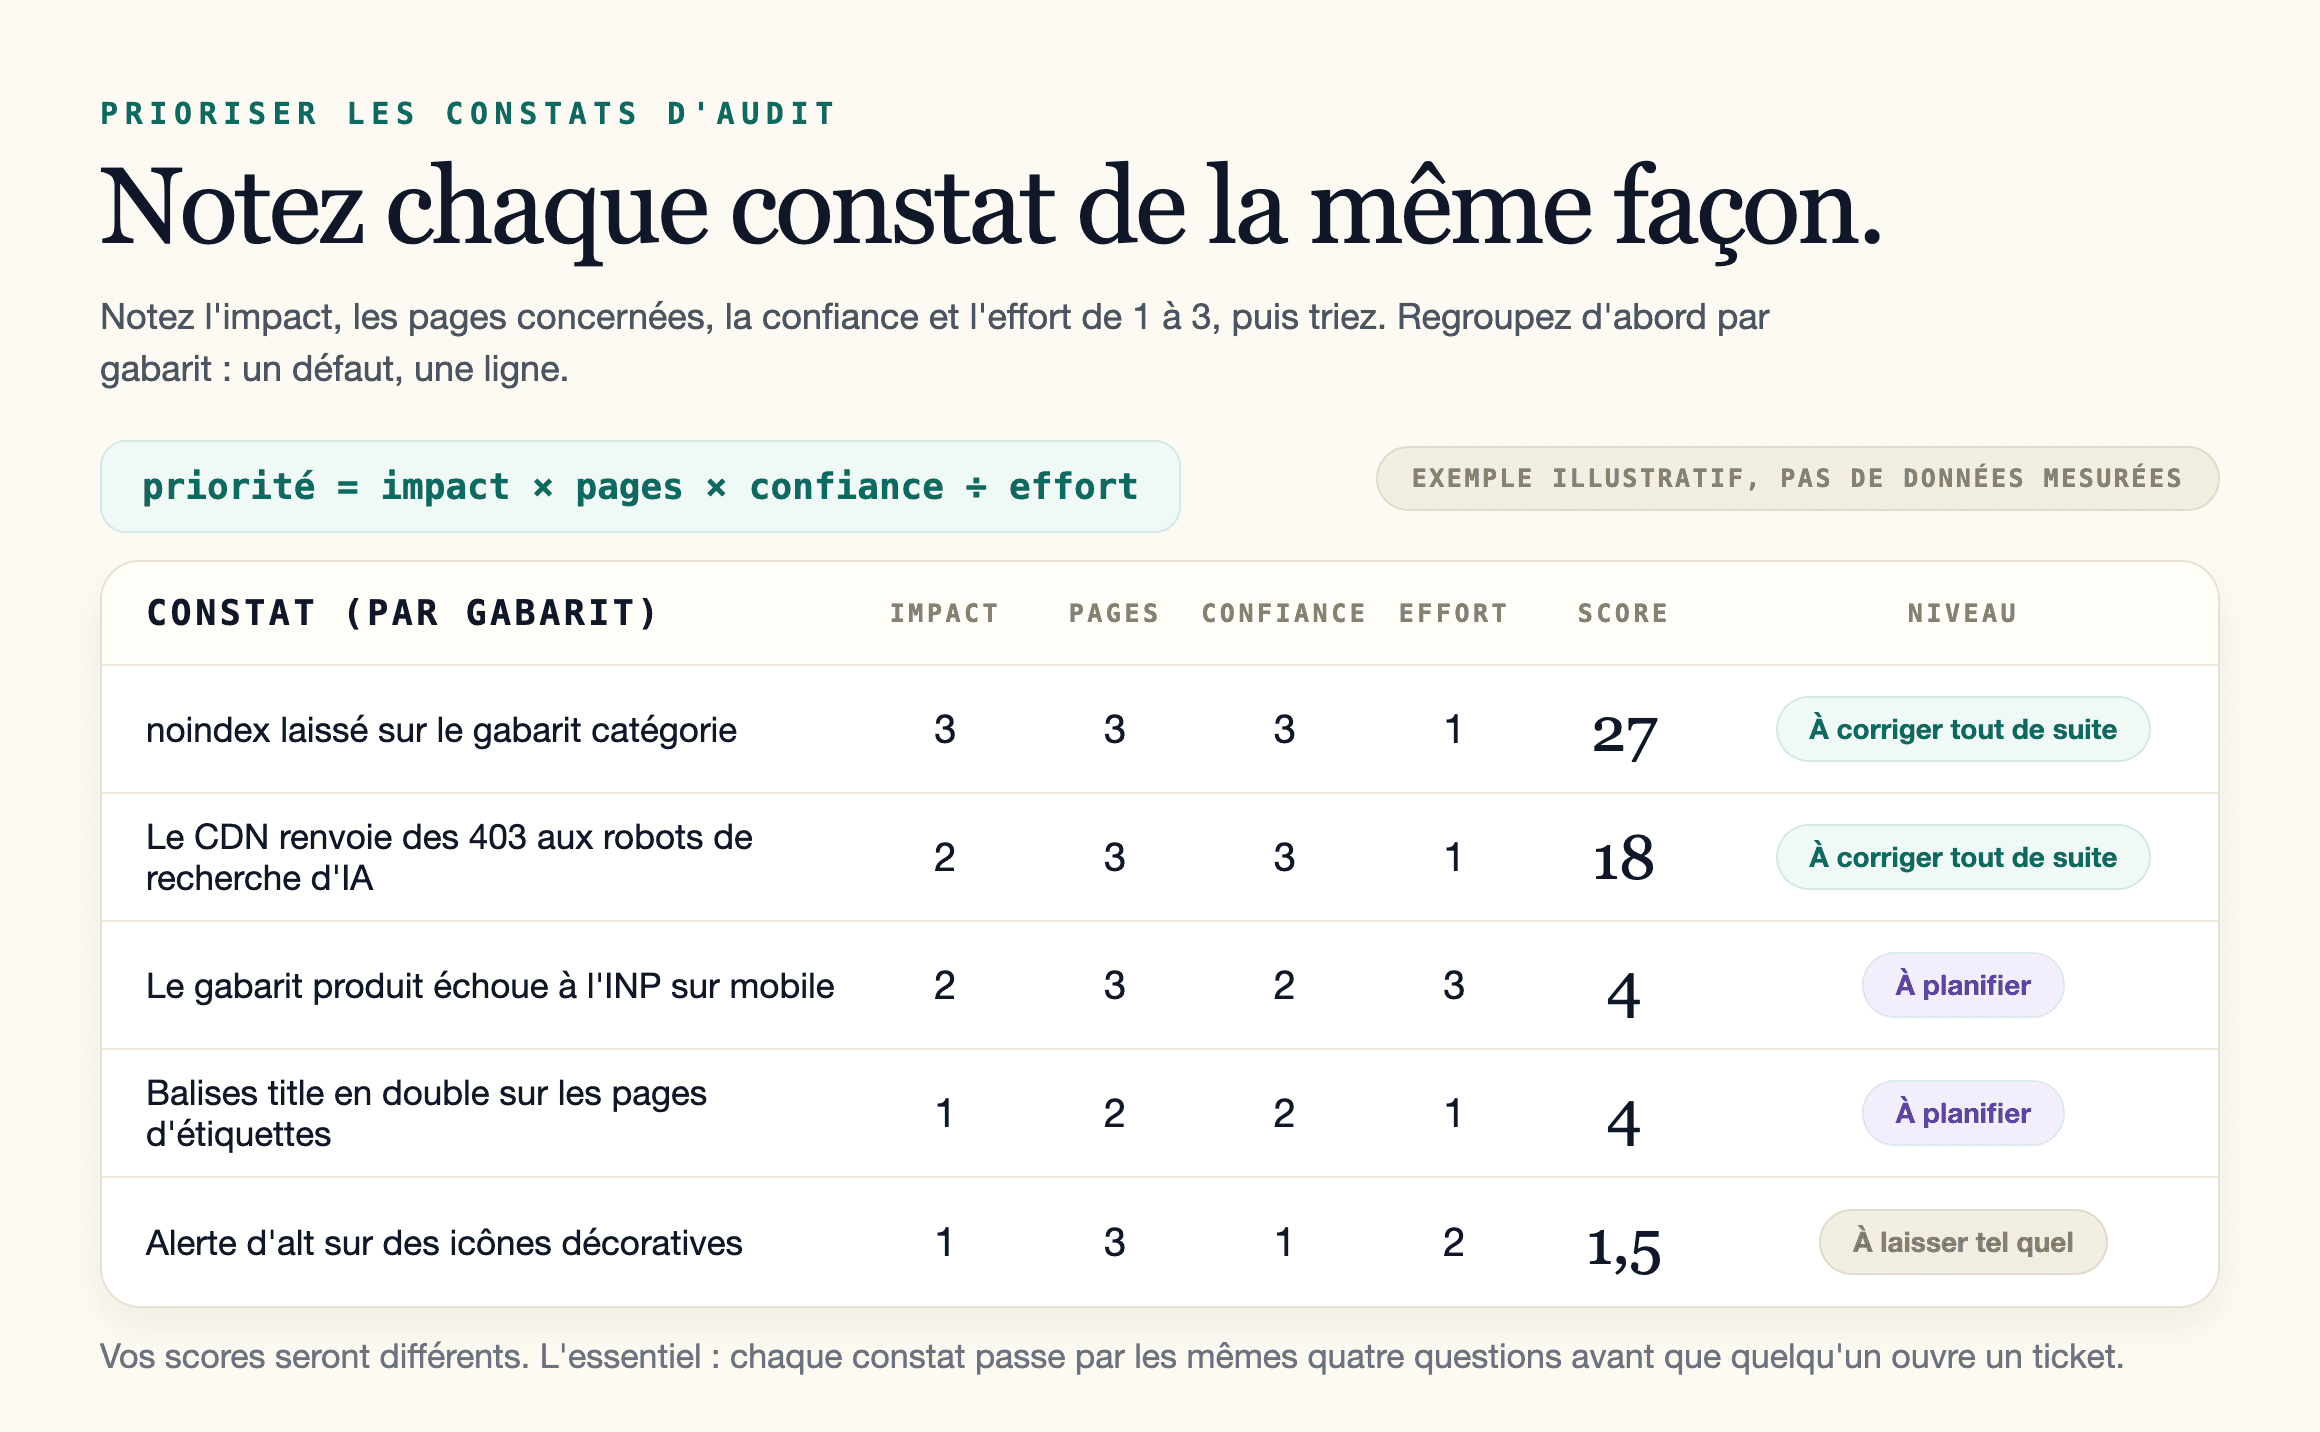
Un constat mérite sa place dans la liste selon ce que rapporte chaque page concernée, le nombre de pages qui le partagent, votre degré de certitude sur sa cause et l’effort qu’il demande. Notez chaque constat sur ces quatre critères, puis triez.
Une version simple : priorité = impact par page × pages concernées × confiance ÷ effort, chaque facteur noté de 1 à 3. Un noindex oublié sur le gabarit catégorie, avec impact, pages et confiance à 3 et un effort à 1, obtient 27 et se corrige tout de suite.
Un avertissement d’outil sur le texte alternatif d’icônes décoratives qui ont déjà un alt="" vide obtient 1 × 3 × 1 ÷ 2, soit 1,5, et on n’y touche pas. L’échelle exacte importe moins que la règle : noter tous les constats de la même façon. La liste cesse alors d’être un sujet de dispute.
Regroupez les constats par gabarit avant de les noter. Une canonique manquante sur des milliers d’URL est en général un seul défaut de gabarit et un seul ticket. Ce regroupement transforme l’export d’un crawler en une liste qu’un développeur peut traiter jusqu’au bout.
La plupart des outils signalent bien plus de problèmes qu’il n’y en a de réels : séparez les alertes généralement fondées de celles qui relèvent du bruit.
| Généralement un vrai problème | Généralement du bruit |
|---|---|
| Un gabarit stratégique qui renvoie des 5xx ou des boucles de redirection | « Nombre de mots faible » sur des pages courtes qui répondent à la requête (Google dit n’avoir aucun nombre de mots préféré) |
noindex ou mauvaise canonique sur des pages qui devraient se classer | noindex sur les pages panier, connexion, recherche interne et remerciement |
| Robots de recherche d’IA bloqués dans le robots.txt ou au niveau du CDN | alt="" vide sur des images décoratives |
| Contenu principal ou liens présents seulement après l’exécution du JavaScript | Erreurs de validation HTML hors du <head> qui ne cassent pas le rendu |
| Un gabarit qui échoue aux Core Web Vitals dans les données de terrain | Un score de vitesse de laboratoire sous un objectif arbitraire |
| Deux pages de même intention en concurrence sur une requête à forte valeur | Méta-descriptions de quelques caractères au-dessus de la limite d’un outil |
Le « généralement » a son importance : un élément de bruit devient réel dès qu’il touche une page qui rapporte. Une exception mérite d’être connue : Google indique qu’un élément non valide dans le head lui fait ignorer tous les éléments qui le suivent, balises canonique et robots comprises.
Découpez enfin la liste en niveaux : à corriger tout de suite, à planifier et à laisser tel quel. Ce dernier niveau fait partie du livrable : noter ce que vous avez choisi d’ignorer, et pourquoi, évite de voir la même alerte revenir chaque trimestre.
Que doit contenir un rapport d’audit SEO ?
Un rapport d’audit SEO sert à faire mettre en production les corrections : écrivez-le pour ceux qui les valident et pour ceux qui les développent.
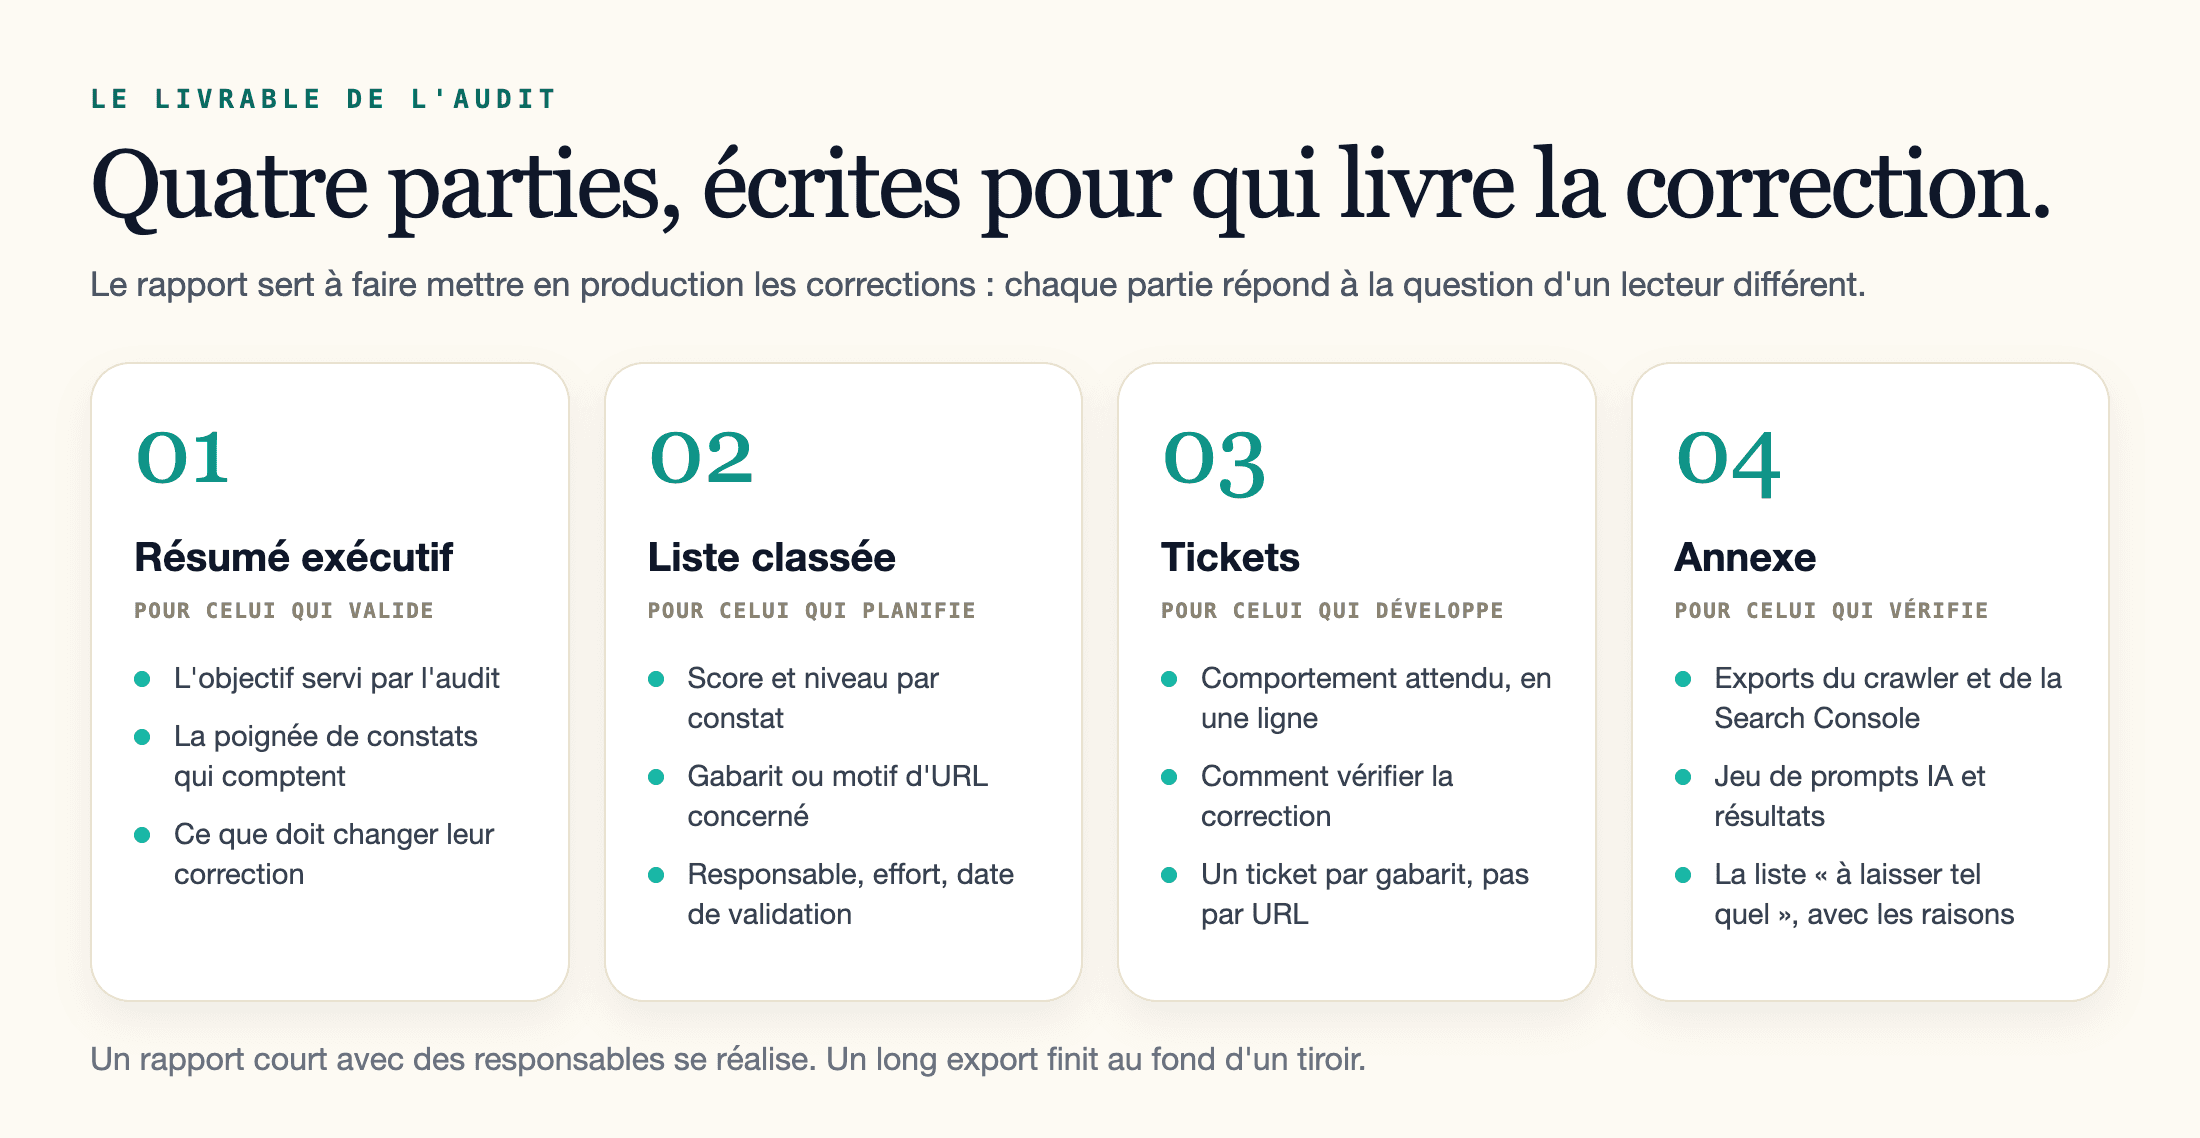
Le rapport comprend ces parties :
- Le résumé exécutif : l’objectif, la poignée de constats qui comptent le plus, et ce que leur correction doit changer
- La liste de corrections classée : chaque constat avec son score, le gabarit ou le motif d’URL concerné, un responsable et une estimation d’effort
- Les tickets : pour chaque correction, le comportement attendu et la façon de le vérifier, par exemple « les pages catégories renvoient une canonique auto-référencée ; à contrôler avec l’outil d’inspection d’URL »
- L’annexe : les exports bruts du crawler et de la Search Console, le jeu de prompts et ses résultats, ainsi que la liste de ce que l’on laisse tel quel
Ajoutez à chaque correction une date de validation, le jour où vous vérifierez qu’elle a fonctionné. Si vous rendez compte à vos clients chaque mois, notre modèle de rapport SEO montre comment reporter les corrections de l’audit dans le rapport mensuel pour que l’avancement reste visible.
Combien de temps dure un audit SEO, et combien coûte-t-il ?
Le crawl est la partie rapide : un petit site se crawle en quelques minutes. Le temps passe à lire les données, vérifier les causes et rédiger les tickets, soit des jours pour un petit site et des semaines pour un grand site, un site très dépendant du JavaScript ou une migration. Les résultats se font attendre plus longtemps encore : la plupart des corrections ne produisent d’effet qu’après le nouveau passage des moteurs sur les pages concernées.
Le prix d’un audit SEO suit les mêmes facteurs : nombre d’URL et de gabarits, complexité du rendu, nombre de marchés et de langues, et périmètre du livrable (constats seuls ou plan de mise en œuvre compris).
En France, deux pages d’agences mises à jour en septembre 2026 donnent des repères. KB-COM (page modifiée le 30 septembre 2026) relève sur le marché français 500 à 900 € pour un audit express, 1 500 à 3 000 € pour un audit complet et souvent plus de 4 000 € pour un site e-commerce ou un gros site, avec un consultant entre 400 et 800 € par jour. Atypicom (page modifiée le 9 septembre 2026, qui cite Deux.io, février 2026) donne 300 à 800 € pour un audit automatisé de base, 1 500 à 3 500 € pour une PME et 4 000 à 10 000 € pour un site e-commerce ou un gros site. Ni l’une ni l’autre ne précise, pour ces fourchettes, si les montants sont HT ou TTC.
Côté américain, WebFX a interrogé 250 entreprises et indique que 43 % ont payé de 101 à 750 $ pour un audit. Pour le travail SEO ponctuel en général, le sondage d’Ahrefs auprès de 439 prestataires SEO montre que, parmi ceux qui facturent au projet, 50,6 % demandent 2 000 $ ou moins.
Aucune de ces sources n’est neutre : KB-COM et Atypicom vendent eux-mêmes des prestations SEO, WebFX est une agence, et l’article d’Ahrefs, mis à jour le 15 août 2024, porte sur l’ensemble des projets SEO, pas sur les seuls audits. Prenez ces chiffres comme des repères, pas comme un prix de marché.
Un audit moins cher peut convenir. Demandez un exemple de rapport avant de payer, et vérifiez qu’il exploite vos données de la Search Console et qu’il classe les corrections.
À quelle fréquence faire un audit SEO ?
Faites un audit SEO complet une fois par an, un contrôle technique léger chaque mois, et un audit hors calendrier chaque fois que le site change en profondeur. Il n’existe pas de cadence officielle, et les régressions viennent bien plus des changements apportés au site que du temps qui passe.
Le contrôle mensuel est court : statuts d’indexation des gabarits clés, Core Web Vitals, codes de réponse des robots d’IA dans les logs et jeu de prompts IA. Tout ce qui a bougé mérite un examen plus poussé.
Déclenchez un audit complet après l’un de ces événements :
- une migration, un changement de domaine ou une refonte
- un changement de CMS, de framework ou d’hébergement
- une chute du trafic sur tout le site qui ne coïncide pas avec une mise à jour de Google (le guide de débogage de Google rappelle qu’une baisse liée à une mise à jour ne signifie pas forcément un problème de contenu)
- de nouvelles règles de robots ou de pare-feu sur votre CDN
Pour les migrations, le guide de Google sur les déplacements de site demande de préparer une table de correspondance des URL, de rediriger les anciennes URL vers les nouvelles et de suivre le trafic sur les deux. Lancez l’audit avant la migration pour établir cette table, puis une seconde fois après pour confirmer que les redirections ont tenu.
Foire aux questions
Peut-on faire un audit SEO avec ChatGPT ?
En partie. ChatGPT peut analyser les exports que vous lui donnez, expliquer un statut de la Search Console ou rédiger des tickets à partir d’une liste de constats. Il ne peut ni crawler votre site à grande échelle ni voir vos données de la Search Console tant que vous ne les collez pas : il aide à réaliser un audit, mais ne remplace ni le crawler ni les données de première main.
Quelle différence entre un audit SEO et un audit de site web ?
Un « audit de site » ou « audit de site web » désigne en général le crawl automatisé que lance un outil d’audit : liens cassés, redirections, balises manquantes. L’audit SEO l’inclut mais y ajoute le jugement : données d’indexation de la Search Console, analyse du contenu et des liens, visibilité dans les IA et plan priorisé rattaché à un objectif.
Le SEO est-il mort avec l’IA ?
Non. Les consignes de Google sur les fonctionnalités d’IA indiquent qu’une page doit être « indexée et affichable dans la recherche Google avec un extrait » pour apparaître comme lien de soutien dans les Aperçus IA ou le Mode IA, et les autres moteurs d’IA citent surtout des pages que leurs propres robots ou un index partenaire peuvent atteindre. Les bases que contrôle un audit sont ce qui garde une page éligible.
Par où commencer ?
Si vous n’avez qu’un après-midi pour un audit SEO, commencez par les étapes 2 et 4. Ce sont des contrôles d’éligibilité rapides : un problème d’indexation ou un robot bloqué peut discrètement défaire tout le reste, et les deux se repèrent en quelques minutes. Choisissez la suite selon le symptôme identifié au cadrage.
Pour vérifier rapidement les autorisations d’accès, notre score de préparation IA gratuit (outil en anglais) récupère côté serveur votre robots.txt et votre sitemap, puis note cinq fondamentaux, dont le fait que le robots.txt laisse entrer les robots d’IA. Là encore, pour l’accès des robots, l’outil se fie au robots.txt et non aux réponses réelles de votre CDN : le contrôle des logs de l’étape 2 reste nécessaire. Revenez ensuite à la Search Console pour le reste de la liste.
Sources
- Google Search Central - Déboguer les baisses de trafic dans la recherche Google (mis à jour le 10 décembre 2025) -
developers.google.com/search/docs/monitor-debug/debugging-search-traffic-drops - Screaming Frog - SEO Spider (consulté le 14 octobre 2026) -
www.screamingfrog.co.uk/seo-spider - Google Search Central - Comprendre les bases du SEO JavaScript (mis à jour le 4 mars 2026) -
developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics - Google Search Central - Bonnes pratiques pour les sites mobiles et l’indexation mobile first (mis à jour le 10 décembre 2025) -
developers.google.com/search/docs/crawling-indexing/mobile/mobile-sites-mobile-first-indexing - Aide de la Search Console - Rapport « Statistiques sur l’exploration » -
support.google.com/webmasters/answer/9679690 - Google Search Central - Robots d’exploration courants de Google, Google-Extended (mis à jour le 14 juillet 2026) -
developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers - Microsoft Bing - Consignes de Bing pour les webmasters (consulté le 9 octobre 2026) -
www.bing.com/webmasters/help/webmaster-guidelines-30fba23a - OpenAI - Vue d’ensemble des robots d’exploration d’OpenAI (consulté le 9 octobre 2026) -
developers.openai.com/api/docs/bots - Anthropic - Does Anthropic crawl data from the web, and how can site owners block the crawler? (consulté le 9 octobre 2026) -
support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler - Perplexity - Robots d’exploration de Perplexity (consulté le 9 octobre 2026) -
docs.perplexity.ai/docs/resources/perplexity-crawlers - Cloudflare Docs - Block AI Bots, classes Search, Agent et Training (mis à jour le 1er juillet 2026) -
developers.cloudflare.com/bots/additional-configurations/block-ai-bots - Blog Cloudflare - Have it both ways: stay discoverable in search while disallowing AI training (15 septembre 2026) -
blog.cloudflare.com/accountable-mixed-use-ai-crawlers - Search Engine World - Do AI assistants actually render your JavaScript when grounding? We put it to the test (consulté le 14 octobre 2026) -
www.searchengineworld.com/do-ai-assistants-actually-render-your-javascript-when-grounding-we-put-it-to-the-test - DEV Community (hisashi) - Traffic from ChatGPT jumped! Is it because its crawlers now run JavaScript? (30 septembre 2026) -
dev.to/hisashispace/traffic-from-chatgpt-jumped-is-it-because-its-crawlers-now-run-javascript-5961 - Aide de la Search Console - Rapport sur l’indexation des pages (consulté le 14 octobre 2026) -
support.google.com/webmasters/answer/7440203 - Aide de la Search Console - Outil d’inspection d’URL (consulté le 9 octobre 2026) -
support.google.com/webmasters/answer/9012289 - web.dev - Web Vitals (mis à jour le 31 octobre 2024) -
web.dev/articles/vitals - Blog Google Search Central - Introduction de l’INP dans les Core Web Vitals (mai 2023 ; l’INP a remplacé le FID en mars 2024) -
developers.google.com/search/blog/2023/05/introducing-inp - Blog Google Search Central - The role of page experience in creating helpful content (19 avril 2023 ; rapport Ergonomie mobile et test d’optimisation mobile retirés le 1er décembre 2023) -
developers.google.com/search/blog/2023/04/page-experience-in-search - Google Search Central - Balise meta robots, data-nosnippet et en-tête X-Robots-Tag (mis à jour le 24 mars 2026) -
developers.google.com/search/docs/crawling-indexing/robots-meta-tag - Aide de la Search Console - Contrôle de l’IA générative dans la Recherche (consulté le 14 octobre 2026) -
support.google.com/webmasters/answer/16908024 - Google France - Lancement des Aperçus IA et du Mode IA dans la Recherche Google en France (22 juillet 2026) -
blog.google/intl/fr-fr/nouveautes-produits/explorez-obtenez-des-reponses/recherche-ia-apercus-mode - Google Search Central - Créer du contenu utile, fiable et conçu pour les internautes (mis à jour le 5 octobre 2026) -
developers.google.com/search/docs/fundamentals/creating-helpful-content - Aide de la Search Console - Désavouer des liens vers votre site (consulté le 14 octobre 2026) -
support.google.com/webmasters/answer/2648487 - Aide de la Search Console - Rapport sur les performances dans l’IA générative (Recherche) (consulté le 14 octobre 2026) -
support.google.com/webmasters/answer/16984139 - Blog Bing Webmaster - Introducing AI Performance in Bing Webmaster Tools, Public Preview (10 février 2026) -
blogs.bing.com/webmaster/2026/2/Introducing-AI-Performance-in-Bing-Webmaster-Tools-Public-Preview - Google Search Central - Utiliser des métadonnées de page valides (mis à jour le 10 décembre 2025) -
developers.google.com/search/docs/crawling-indexing/valid-page-metadata - KB-COM - Prix d’un audit SEO en 2026 (page modifiée le 30 septembre 2026) -
kb-com.fr/blog/prix-audit-seo - Atypicom - Prix du SEO (page modifiée le 9 septembre 2026) -
www.atypicom.fr/seo/prix-seo - WebFX - SEO Audit Pricing: How Much Does an SEO Audit Cost in 2026? (consulté le 9 octobre 2026) -
www.webfx.com/seo/pricing/how-much-does-seo-audit-cost - Ahrefs - SEO Pricing: How Much Does SEO Cost? 439 People Polled (mis à jour le 15 août 2024) -
ahrefs.com/blog/seo-pricing - Google Search Central - Déplacements de site avec changement d’URL (mis à jour le 20 août 2026) -
developers.google.com/search/docs/crawling-indexing/site-move-with-url-changes - Google Search Central - Les fonctionnalités d’IA et votre site Web (mis à jour le 10 décembre 2025) -
developers.google.com/search/docs/appearance/ai-features - Invox - Audit technique SEO : pourquoi et comment le réaliser (lu le 14 octobre 2026) -
invox.fr/ressources/seo/audit-technique-seo